Алгоритмы поиска
Введено| English | Значение |
|---|---|
| linear search/ˈlɪnɪə sɜːtʃ/ | линейный поиск |
| binary search/ˈbaɪnəri sɜːtʃ/ | бинарный поиск |
Двадцать вопросов для миллиона имен
- Телефонный справочник содержит миллион имен. Проверяя их по одному, вы ожидаете сделать полмиллиона сравнений до того, как найдете нужное.
- Откройте его посередине, решите, в какой половине находится имя, и отбросьте другую половину. Повторяйте. Вы найдете любое имя за двадцать сравнений.
- Полмиллиона против двадцати — это не маленькая экономия; это разница между программой, которая работает, и той, которую нельзя использовать. И это стоит одного: список должен быть уже отсортирован.
- Этот урок посвящен линейному поиску и бинарному поиску, тому, как они работают, и тому, как выбрать подходящий.
Линейный поиск
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1                     // not found
- Он идет от начала, сравнивая каждый элемент с целевым значением, и останавливается, когда находит совпадение или достигает конца.
- Он работает с любым списком, отсортированным или нет, и с любой структурой, которую можно перебирать последовательно.
- Худший случай: целевой элемент находится в конце или отсутствует, поэтому все $n$ элементов сравниваются, что составляет $O(n)$. В среднем — около половины.
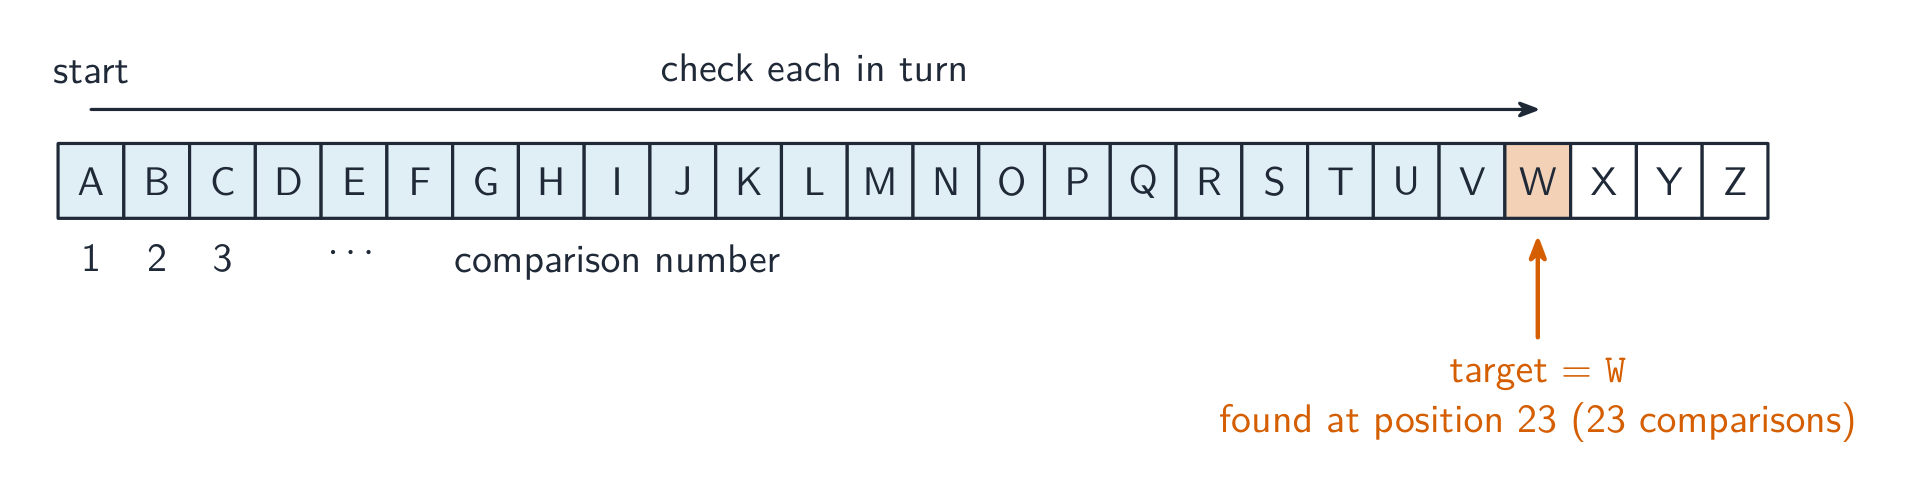
По одной, начиная с начала
Линейный поиск:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Линейный поиск не требует предварительной подготовки и работает с любым списком, в худшем случае — O(n).
Линейный поиск является лучшим выбором, когда данные:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
При отсутствии порядка для использования (или при очень маленьком списке) линейный поиск избегает затрат на предварительную сортировку.
Бинарный поиск
low ← 1 ;  high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE high ← MiddleIndex - 1
ENDWHILE
RETURN -1
- Он требует, чтобы данные были отсортированы. Сравните средний элемент с целевым значением: если они совпадают, остановитесь; если целевое значение больше, отбросьте нижнюю половину; иначе отбросьте верхнюю половину.
- Каждое сравнение удваивает диапазон, который ещё нужно искать, поэтому количество сравнений равно $O(\log_2 n)$.
- Именно поэтому для миллиона элементов требуется около двадцати сравнений: $2^{20}$ чуть больше миллиона.
Алгоритмы поиска
бинарный поиск сокращает диапазон наполовину на каждом шаге
Линейный поиск проверяет каждый элемент; бинарный делит отсортированный список пополам — значительно меньше сравнений.
Сложность по времени в худшем случае для бинарного поиска составляет:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Уменьшение диапазона вдвое на каждом шаге дает логарифмическое количество сравнений.
Примерно сколько сравнений требуется бинарному поиску для одного миллиона отсортированных элементов?
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
$\log_2(1\,000\,000) \approx 20$ — около 20 сравнений.
Бинарный поиск можно использовать на любом списке, отсортированном или нет.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Он определяет, какую половину отбросить, сравнивая со средним элементом, что имеет смысл только если данные упорядочены.
Бинарный поиск является $O(\log n)$, потому что каждое сравнение уменьшает диапазон, который ещё нужно искать.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Двадцать делений пополам снижают миллион до единицы, поэтому $2^{20}$, будучи чуть больше миллиона, — это число, которое следует запомнить.
Разобранный пример: трассировка бинарного поиска
- Отсортированный список: 2, 5, 8, 12, 16, 23, 38, 56, 72, 91. Выполните трассировку поиска числа 23.
lowравен 1,highравен 10, значитmidравен 5, хранящий значение 16. 16 меньше 23, поэтому отбрасываем нижнюю половину:lowстановится равным 6.lowравно 6,highравно 10, значитmidравно 8, хранящее значение 56. 56 больше 23, поэтомуhighстановится равным 7.lowравно 6,highравно 7, значитmidравно 6, хранящее значение 23. Найдено, за три сравнения, тогда как линейный поиск потребовал бы шесть.- Покажите
low,high,midи значение на каждом шаге. Большая часть баллов начисляется за трассировку, а не за финальный ответ.
В отсортированном списке 2, 5, 8, 12, 16, 23, 38, 56, 72, 91, сколько сравнений потребуется бинарному поиску для нахождения 23?
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
mid 5 содержит 16 (слишком мало), mid 8 содержит 56 (слишком много), mid 6 содержит 23. Линейный поиск занял бы шесть операций.
Выбор между ними
| линейный | бинарный | |
|---|---|---|
| данные должны быть отсортированы | нет | да |
| сравнений, худший случай | $n$ | $\log_2 n$ |
| миллион элементов | до 1,000,000 | около 20 |
| подходит для | неотсортированных или малых списков, связных списков | больших отсортированных массивов, при многократном поиске |
- Сортировка сначала стоит дороже, чем один линейный поиск, поэтому бинарный поиск оправдан только тогда, когда список уже отсортирован или будет искаться много раз.
- Бинарный поиск также требует прямого доступа к среднему элементу, что есть у массива, но нет у связного списка.
Решенный пример: обоснуйте выбор
- Программа ищет неотсортированный список из 50 записей один раз. Линейный поиск: сортировка списка сначала обошлась бы дороже, чем 50 сравнений, необходимых для поиска.
- Программа ищет отсортированный массив из миллиона записей тысячи раз в секунду. Бинарный поиск: данные уже отсортированы, и каждое поиск занимает около 20 сравнений вместо миллиона.
- Программа ищет в связном списке. Линейный поиск: бинарный поиск требует прыжка прямо к среднему элементу, а связный список можно пройти только от начала.
- Назовите алгоритм, затем свойство данных, которое его определяет.
Соотнесите каждый вид поиска с его ключевыми фактами.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Бинарный поиск значительно быстрее (O(log n)), но только на отсортированных данных; линейный поиск работает везде за O(n).
Когда линейный поиск является лучшим выбором? Выберите все подходящие варианты.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Последний случай — именно там, где бинарный поиск побеждает. Сортировка сначала обходится дороже, чем один линейный поиск, поэтому она выгодна только при множестве поисков.
Стоимость поддержания файла в отсортированном состоянии
- Бинарный поиск доступен только для отсортированного списка, и сама сортировка не бесплатна. Вопрос, требующий вас обосновать выбор, фактически просит оценить стоимость.
- Если данные часто ищутся и редко изменяются, отсортируйте их один раз, и каждое последующее поиск будет стоить $\log_2 n$. Это относится к словарю или таблице lookup.
- Если данные постоянно меняются, каждое вставка должно сохранять порядок, что требует сдвига последующих элементов. Тогда линейный поиск по неотсортированным данным может оказаться дешевле в общей сложности.
- Цифры делают аргумент конкретным: миллион записей требует до миллиона сравнений линейным методом, но только 20 бинарным поиском, поскольку $2^{20} > 10^6$.
- Поэтому отмеченный ответ называет обе половины: как часто он ищется и как часто он изменяется.
Расставьте обоснования выбора алгоритма поиска по порядку.
Сложность 3/5 · 200 монет + небольшой бонус за первое завершение сегодня
В вопросе «обоснуйте» нужна компромиссная оценка, а не выбор победителя. Бинарный поиск на постоянно меняющемся списке может потребовать в сумме больше усилий, чем линейный.
Потерянные баллы
- Бинарный поиск требует отсортированных данных. Утверждение «это быстрее» без этого условия не оценивается.
- На каждом шаге диапазон уменьшается вдвое, именно поэтому $\log_2 n$. Назовите причину, а не просто обозначение.
- Оба поиска должны уметь сообщать об отсутствии элемента, для этого и служит
-1, и условие цикла. - Бинарному поиску нужен произвольный доступ, поэтому он неприменим к связному списку, даже если список отсортирован.
Вы поняли
- Линейный поиск сравнивает каждый элемент с начала, работает с любым списком и является $O(n)$
- Бинарный поиск требует отсортированных данных с произвольным доступом, сравнивает средний элемент и уменьшает диапазон вдвое на каждом шаге, что дает $O(\log_2 n)$: около 20 сравнений для миллиона элементов
- проследите бинарный поиск, показывая
low,high,midи значение на каждом шаге - выберите из данных: несортированный, маленький или связный список означает линейный; большой, отсортированный и часто используемый для поиска означает бинарный