Machine learning types and training
Введено| English | Значение |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | машинное обучение |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | Обратное распространение ошибки |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | Обучение с учителем |
| classification/ˌklæsɪfɪˈkeɪʃn/ | Классификация |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | Обучение без учителя |
| clusters/ˈklʌstəz/ | Кластеры |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | Обучение с подкреплением |
| agent/ˈeɪdʒənt/ | Агент |
| reward/rɪˈwɔːd/ | Награда |
| policy/ˈpɒlɪsi/ | Стратегия |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | Градиентный спуск |
| loss function/lɒs ˈfʌŋkʃn/ | функция потерь |
| epoch/ˈiːpɒk/ | эпоха обучения |
Программа, которая научилась открытию, которое ни один человек никогда не играл
- AlphaGo Zero получил только правила го и ничего больше. Никаких человеческих партий, никаких дебютных книг, никаких советов. Она играла сама с собой, начиная со случайных ходов.
- За три дня она превзошла версию, которая побеждала чемпиона мира. По пути она заново открыла столетия человеческой дебютной теории, а затем отбросила её части как менее эффективные.
- Она обучалась по одному числу после каждой партии: победа или поражение. Это совершенно другой тип обучения, чем показ миллионов размеченных фотографий.
- Этот урок посвящён трём парадигмам машинного обучения, данным, необходимым каждой из них, и тому, как веса сети фактически изменяются методом обратного распространения ошибки.
Обучение с учителем
- Обучение с учителем тренируется на данных, содержащих метки: фотографии с тегами «кошка» или «собака», письма, помеченные как спам или нет, дома с ценами продажи.
- Модель изучает отображение от входа к метке, а затем получает входы, которых она никогда раньше не видела, и просит её предсказать метку.
- Оно делится на классификацию, где выход — это категория, и регрессию, где выход — число.
- Его стоимость — это метки: кто-то должен их создавать, что для миллиона изображений требует огромного количества ручного труда.
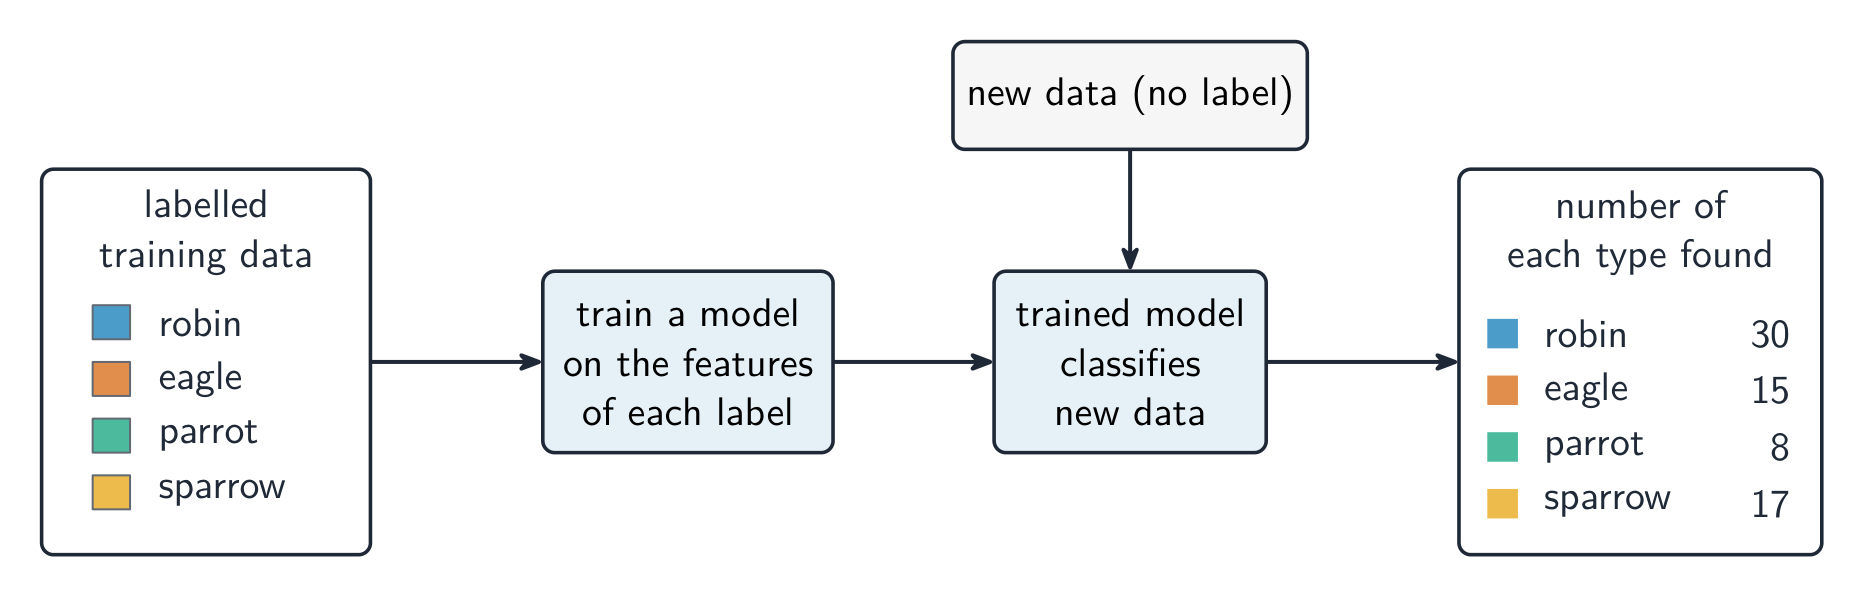
Размеченные примеры на входе, модель на выходе, затем неразмеченные входы
Supervised learning uses:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Supervised learning trains on labelled examples (e.g. images tagged cat/dog).
Обучение без учителя
- Обучение без учителя получает данные без меток и просит найти в них структуру.
- Наиболее распространенное применение — кластеризация: группировка в кластеры похожих объектов, таких как клиенты, покупающие одинаковые товары, без предварительного решения о том, какими должны быть группы.
- Это ее сила и слабость: она может открыть группировку, о которой никто не подозревал, но не сможет объяснить вам, что эта группировка означает.
Unsupervised learning is used to:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
With no labels, unsupervised learning discovers patterns/clusters in the data.
Обучение с подкреплением
- Обучение с подкреплением имеет агента, действующего в среде. Каждое действие меняет состояние и возвращает вознаграждение, которое может отсутствовать долгое время.
- Агент изучает политику, стратегию выбора действий, которая максимизирует его общее вознаграждение со временем. Он учится методом проб и ошибок, вообще без размеченных примеров.
- Оно подходит для задач, являющихся последовательностью решений, где правильный ход раскрывается только конечным результатом: игры, управление роботами, беспилотные автомобили. Это именно случай AlphaGo Zero.
In reinforcement learning, the agent learns by:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
The agent tries actions, receives rewards, and learns a policy that maximises long-term reward.
In reinforcement learning the agent learns a ____ that maximises its total reward over time.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
It learns by trial and error from rewards, with no labelled examples at all, which is why it suits sequences of decisions.
Разобранный пример: выберите парадигму
- Десять тысяч медицинских снимков, каждый из которых помечен врачом как содержащий опухоль или нет, используются для обучения системы выявлять новые снимки. Надзорное обучение: данные имеют метки, а задача состоит в том, чтобы научиться отображению входа на метку, конкретно — классификации.
- Магазин хочет знать, падают ли его клиенты в естественные группы, не решая группы заранее. Без учителя: меток не существует, задача — найти структуру, конкретно кластеризацию.
- Робот-рука должна научиться помещать компоненты, оцениваемые только по успеху каждой попытки. С подкреплением: агент, последовательность действий и вознаграждение вместо метки.
- Назовите парадигму, затем обоснуйте на основе данных: размеченные, неразмеченные или сигнал вознаграждения.
AI learning type lab
Classify AI examples by the type of learning or concern involved.
Match each ML paradigm to its data.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Supervised = labels; unsupervised = no labels; reinforcement = reward feedback.
Match each situation to the machine-learning paradigm it needs.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
Labels, no labels, or a reward. The data decides the paradigm, not the difficulty of the task.
Обучение обратным распространением ошибки
- Обучение означает корректировку весов, чтобы выходы сети совпадали с целевыми значениями. Метод — обратное распространение ошибки с спуском по градиенту.
- Прямой проход: подайте вход через сеть и получите выход. Вычислите ошибку с помощью функции потерь, которая измеряет, насколько выход отличается от цели.
- Обратный проход: распространите эту ошибку назад через слои, чтобы найти градиент каждого веса, то есть, сколько этот вес внес вклад в ошибку.
- Обновление: измените каждый вес на маленький шаг против его градиента. Размер шага — это скорость обучения (learning rate).
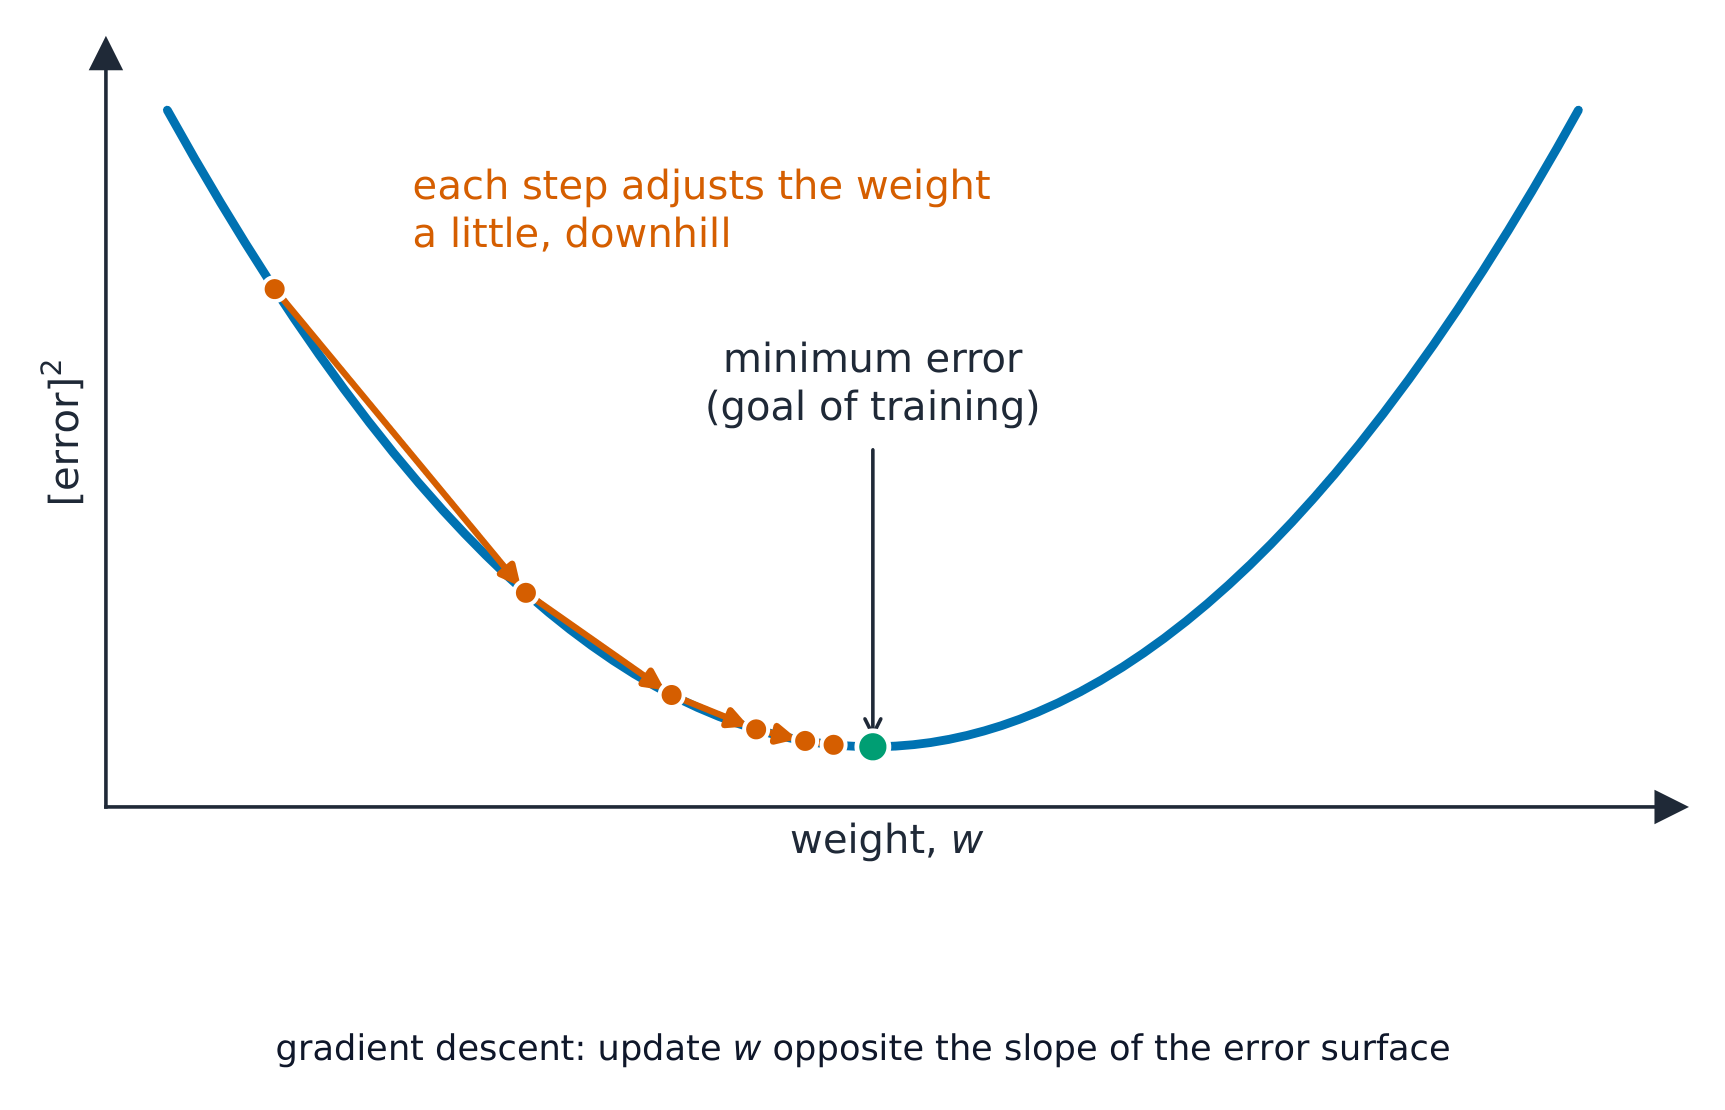
Вниз по склону, маленьким шагом за шагом
Backpropagation trains a network by:
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
The error flows from the output back through the network (chain rule) so every weight's gradient is found, then weights step downhill.
Put one round of backpropagation training in order.
Сложность 3/5 · 200 монет + небольшой бонус за первое завершение сегодня
Forward, error, backward, update, repeated over many epochs until the error stops falling.
Эпохи и почему важно значение скорости обучения
- Один полный проход по всему обучающему набору данных — это эпоха. Обучение повторяется на протяжении многих эпох, пока ошибка не перестать снижаться.
- Слишком большая скорость обучения приводит к пролетанию через минимум, и ошибка начинает скакать; слишком маленькая делает обучение неоправданно долгим.
- После обучения использование модели — это только прямой проход, поэтому обученная сеть отвечает мгновенно, хотя само обучение заняло дни.
In gradient descent the learning rate sets how big a step each weight update takes — too large overshoots the minimum, too small makes training slow.
Сложность 1/5 · 100 монет + небольшой бонус за первое завершение сегодня
Backpropagation finds each weight's gradient; the learning rate scales how far down that gradient the weight moves.
Which statements about training are correct? Select все that apply.
Сложность 2/5 · 140 монет + небольшой бонус за первое завершение сегодня
The learning rate is the size of each weight update. That is why training can take days while a prediction takes milliseconds.
Потерянные баллы
- Обоснуйте парадигму на основе данных: наличие меток означает обучаемость с учителем, отсутствие меток — без учителя, наличие сигнала вознаграждения — обучение с подкреплением.
- В обучении с подкреплением нет меток. Называть вознаграждение меткой — это классическая путаница.
- Обратное распространение ошибки — это прямой проход, вычисление ошибки, обратный проход, обновление весов, повторяемое многократно. Утверждение «только оно корректирует веса» — это лишь половина ответа.
- Скорость обучения — это размер каждого шага, а не скорость самого процесса обучения или количество эпох.
Вы поняли
- Надзорное обучение изучает отображение входа на метку из помеченных данных для классификации или регрессии · ненадзорное обучение обнаруживает структуру, такую как кластеры, в непомеченных данных · обучение с подкреплением имеет агента, осваивающего стратегию через вознаграждения методом проб и ошибок
- Выбирайте парадигму исходя из того, что предоставляют данные, а не от сложности задачи.
- Обратное распространение ошибки: прямой проход, ошибка из функции потерь, обратный проход, дающий градиент для каждого веса, затем обновление размера которого задается скоростью обучения.
- Обучение повторяется на протяжении многих эпох; использование обученной модели — это один прямой проход.