Эта страница требует современного браузера (с поддержкой SharedArrayBuffer). Пожалуйста, обновите Chrome, Edge, Firefox или Safari до последней версии.
Python выполняет ваш код строка за строкой. Каждая строка является оператором. Программа — это просто список операторов, которые выполняются сверху вниз.
Функция print() выводит текст на экран. Это называется выводом. Текст внутри кавычек является строкой.
print("Hello, world!")
print("I am learning Python")
Каждый print() начинает новую строку.
Кавычки могут быть "double" или 'single' — оба варианта создают строку.
Программа ничего не делает, пока вы её не запустите.
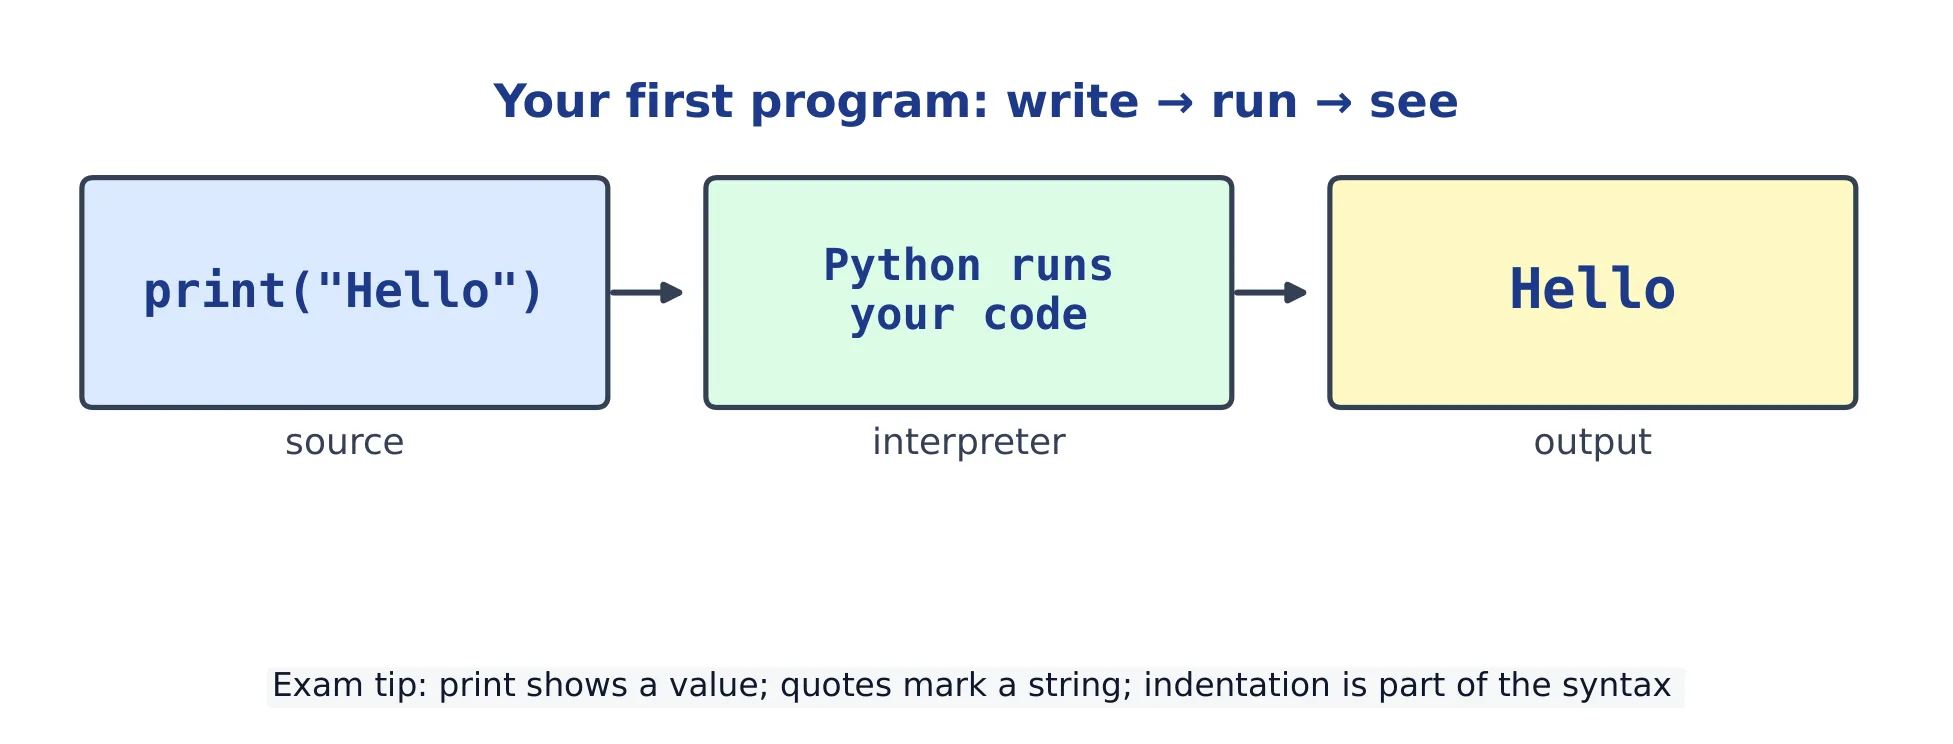
Исходный код выполняется через интерпретатор для получения вывода
1.2
Комментарии и стиль кода
Комментарий начинается со знака #. Python игнорирует всё после символа # в этой строке. Комментарии объясняют ваш код людям; они не изменяют поведение кода.
# This line is a note for humans
print("Hi")        # you can also comment at the end of a line
Хороший стиль делает код легким для чтения:
Используйте понятные имена, которые указывают на смысл значения.
Размещайте каждое утверждение на отдельной строке.
Не добавляйте пробелы в начале обычной строки. В Python отступы (отступы) имеют специальное значение, поэтому неверный пробел вызывает ошибку.
1.3
Ввод, обработка, вывод
Многие программы следуют простому плану: ввод → обработка → вывод. Вы получаете данные, выполняете с ними действия, затем показываете результат.
Функция input() считывает текст, который вводит пользователь. Она всегда возвращает строку.
name = input("What is your name? ")
print("Hello, " + name)
input() ожидает, пока пользователь введет данные и нажмет Enter.
Сохраните введенный текст в переменной, чтобы использовать его позже.
Поскольку input() возвращает строку, преобразуйте ее с помощью int(...) перед использованием, если вам нужно число.
Распространенные ошибки
Забытые кавычки: print(Hello) ищет переменную с именем Hello и вызывает NameError. Текст требует кавычек: print("Hello").
Случайный пробел в начале строки: Python читает отступы как структуру, поэтому вызывает IndentationError.
Предположение, что input() возвращает число. Она всегда возвращает строку, поэтому оберните её в int(...) перед выполнением любых математических операций.
Переменная — это имя для значения. Создайте её с помощью =, которое называется присваиванием. Имя ставится слева; значение — справа.
age = 17
name = "Mei"
price = 9.99
print(age, name, price)
Теперь age хранит 17. Используйте имя везде, где требуется значение, и измените его позже:
age = 17
age = age + 1   # age is now 18
print(age)
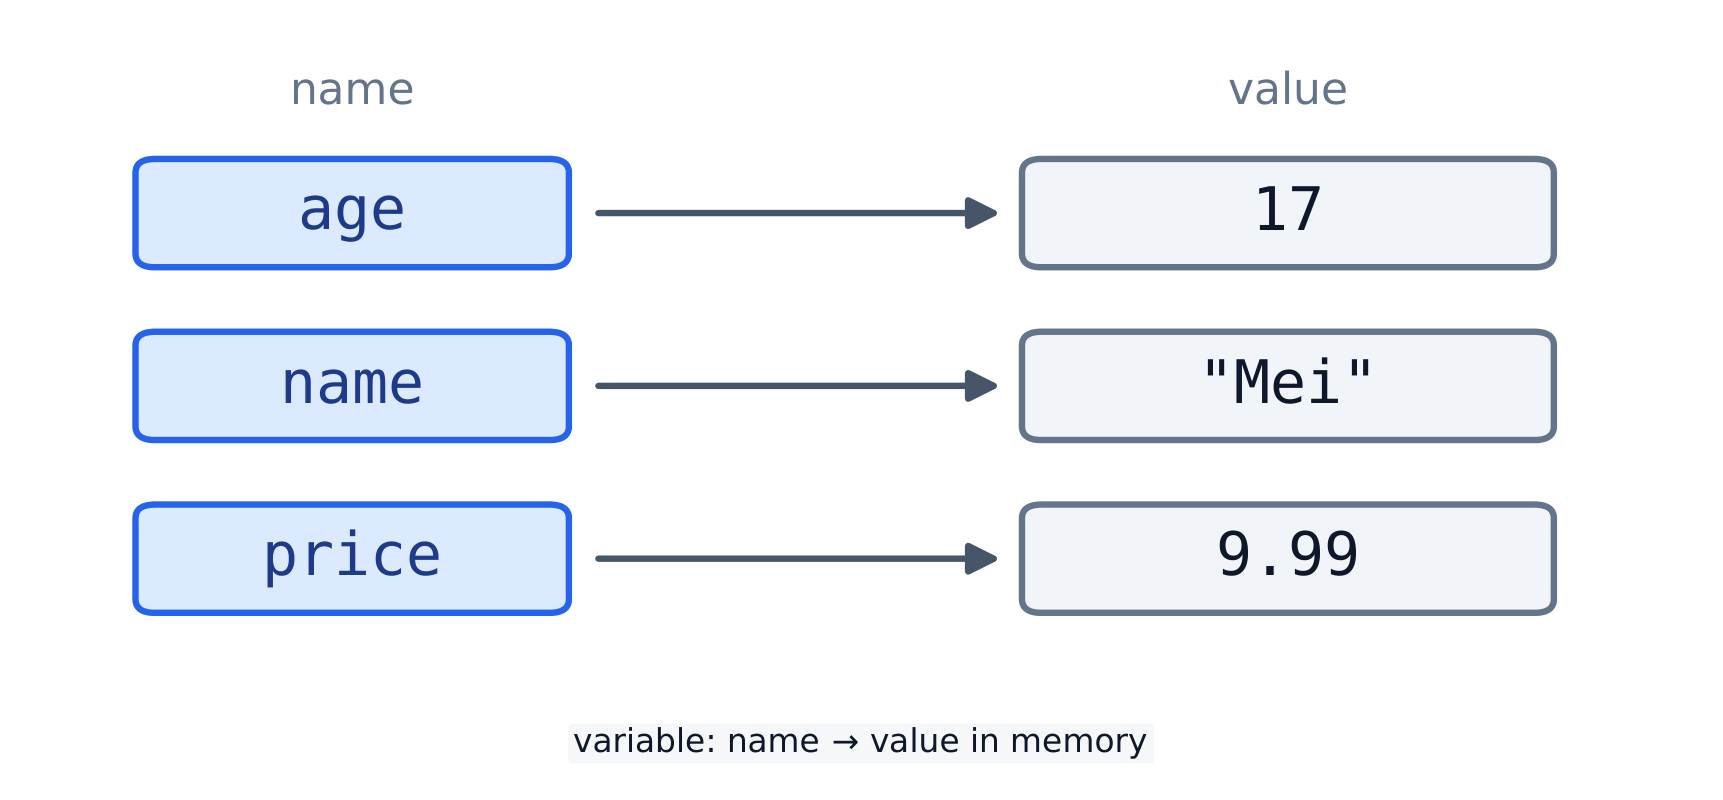
Каждое имя переменной указывает на значение в памяти
Знак = не означает «равно». Он означает «сохранить правую часть под левым именем».
Чтобы проверить равенство двух значений, используйте == (см. ниже).
2.2
Числа: int & float
В Python два основных типа чисел. Целое число (int) — это целое число, например 17. Число с плавающей точкой (float) имеет десятичную точку, например 9.99.
Эти операторы работают с числами:
Оператор
Значение
Пример
Результат
+
сложение
3 + 2
5
-
вычитание
3 - 2
1
*
умножение
3 * 2
6
/
деление (всегда float)
7 / 2
3.5
//
целочисленное деление
7 // 2
3
%
остаток (modulo)
7 % 2
1
**
возведение в степень
2 ** 3
8
/ всегда возвращает float, поэтому 4 / 2 является 2.0.
// и % идут вместе: 17 // 5 является 3, а 17 % 5 является 2.
2.3
Выражения и преобразование типов
Выражение — это всё, что имеет значение, например 3 + 4 * 2. Python использует стандартный порядок действий математики (* и / выполняются до + и -); добавьте скобки, чтобы упорядочить действия.
input() возвращает строку, поэтому преобразуйте её перед выполнением математики. Изменение значения из одного типа в другой называется преобразованием типов:
age = int("17")        # text "17" -> number 17
price = float("9.99")  # text -> 9.99
label = str(17)        # number -> text "17"
print(age, price, label)
int("abc") вызывает ошибку, поэтому преобразовывайте только текст, похожий на число.
Смешивание типов также вызывает ошибку: "age: " + 17 — это ошибка; напишите "age: " + str(17).
2.4
Булевы значения и сравнение
Булево значение — это одно из двух значений: True или False. Сравнение возвращает булево значение.
Программа выбирает, что делать с if. Она выполняет отступленный блок только тогда, когда условие истинно. Строка if заканчивается двоеточием.
score = 72
if score >= 60:
    print("pass")
# pass
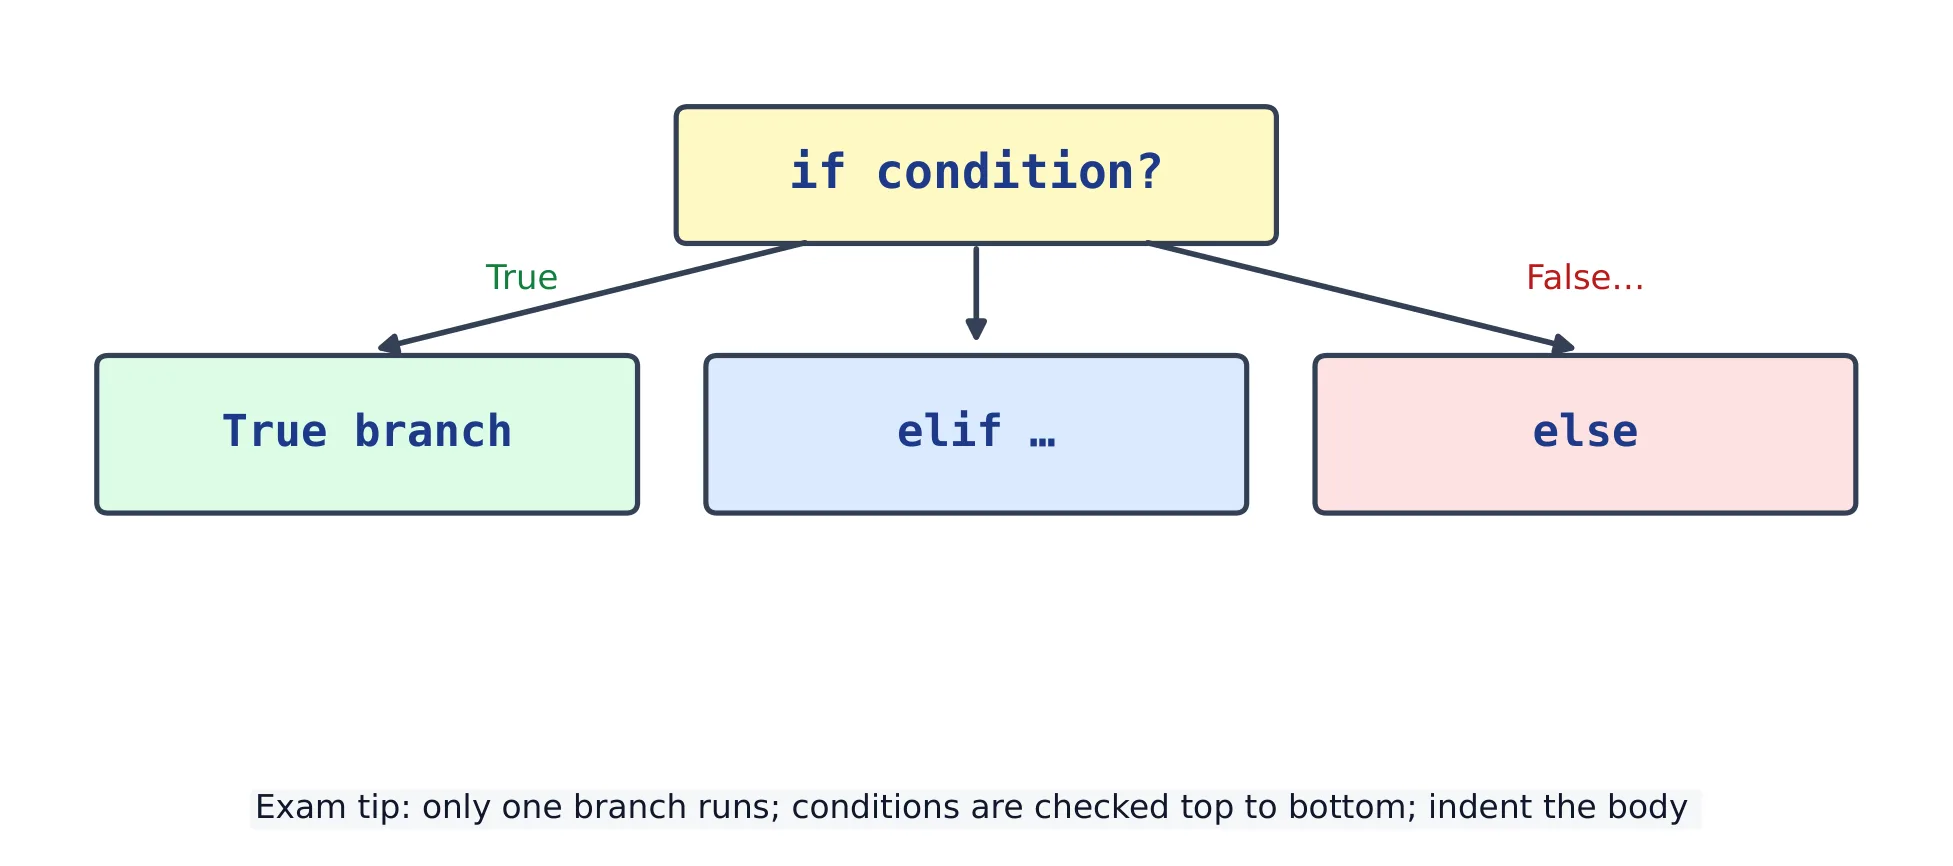
Добавьте elif (else-if) для дополнительных случаев и else для «всего остального». Python выполняет только первый истинный блок, а затем пропускает остальные.
score = 72
if score >= 80:
    print("A")
elif score >= 60:
    print("B")
else:
    print("fail")
# B
Сравнивайте значения с помощью == (равно), != (не равно), <, >, <=, >=.
Результат сравнения — логическое значение: либо True, либо False.
if / elif / else: выполняется только один блок
4.2
Комбинирование условий
Объединяйте условия с помощью and, or, not. Оператор and требует истинности обеих сторон; оператор or требует истинности хотя бы одной стороны; оператор not инвертирует логическое значение.
age = 16
has_ticket = True
if age >= 18 and has_ticket:
    print("entry allowed")
else:
    print("entry refused")
# entry refused
Используйте скобки для ясности порядка: (a or b) and c.
temp = 30
if temp > 25 and not temp > 35:
    print("warm but ok")
# warm but ok
Распространенные ошибки
Пишите elif, а не else if.
Каждая строка if / elif / else заканчивается двоеточием :, а её тело должно быть отступлено.
if x = 5: вызывает ошибку — используйте == для сравнения.
else не принимает условие; только if и elif это делают.
grid = [[1, 2], [3, 4]]
for row in grid:
    for value in row:
        print(value, end=" ")
print()               # 1 2 3 4
6.4
Генераторы списков
Генератор списка создает новый список в одну строку: [expression for item in sequence].
squares = [x * x for x in range(5)]
print(squares)        # [0, 1, 4, 9, 16]
Добавьте if, чтобы оставить только некоторые элементы.
evens = [n for n in range(10) if n % 2 == 0]
print(evens)          # [0, 2, 4, 6, 8]
6.5
Кортежи и множества
Кортеж — это фиксированная последовательность в круглых скобках. Его нельзя изменить после создания — используйте его для связанных значений и распакуйте в имена.
point = (3, 4)
x, y = point            # unpacking
print(x, y)             # 3 4
Функция, которая должна вернуть два результата, возвращает кортеж:
Присвойте значение ключу, чтобы добавить его или изменить существующий.
student = {"name": "Mei"}
student["score"] = 88      # add a new key
student["score"] = 90      # update the value
print(student)             # {'name': 'Mei', 'score': 90}
Проверка и обход
Используйте in для проверки наличия ключа. Обходите ключи или .items(), чтобы получить и ключ, и значение.
student = {"name": "Mei", "score": 90}
print("score" in student)  # True
for key, value in student.items():
    print(key, "=", value)
# name = Mei
# score = 90
.get(key, default) возвращает значение по умолчанию, если ключ отсутствует — без ошибки.
Код может сломаться тремя способами. Синтаксическая ошибка нарушает правила Python, поэтому код никогда не выполняется. Ошибка времени выполнения происходит во время работы, например деление на ноль. Логическая ошибка выполняется, но даёт неверный результат.
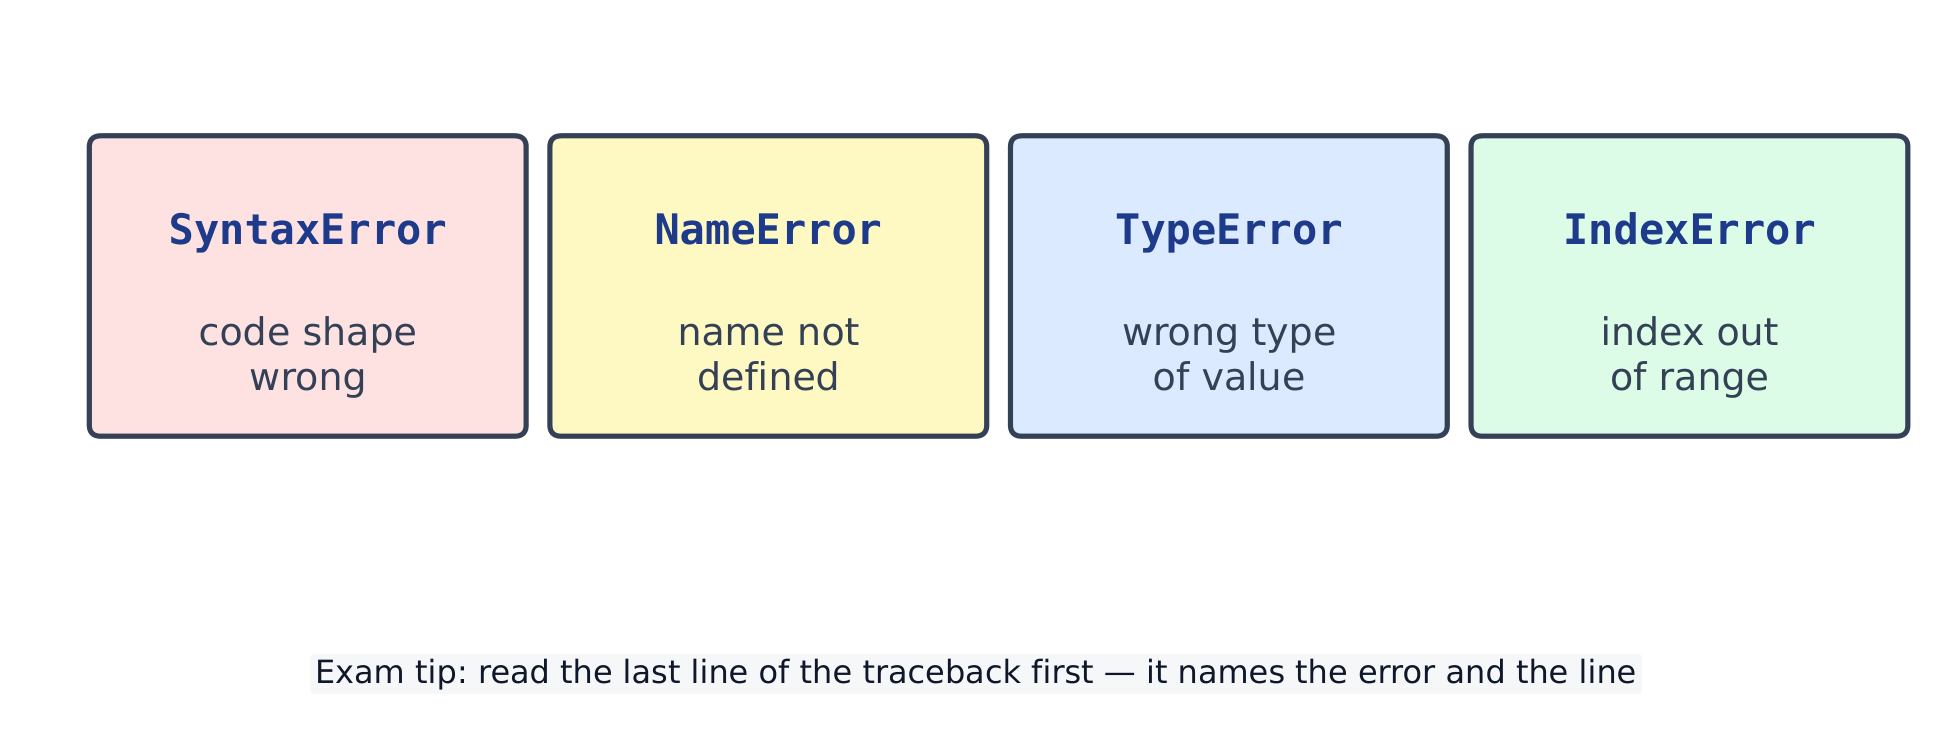
Распространённые ошибки Python: Syntax, Name, Type, Index
# A runtime error, caught so this block still finishes:
try:
    print(10 / 0)
except ZeroDivisionError:
    print("cannot divide by zero")
# cannot divide by zero
Python выводит трассировку (traceback), показывающую место ошибки. Читайте её снизу вверх.
9.2
try / except / raise
Поместите рискованный код в try; если он выдаст ошибку, except перехватит исключение вместо сбоя программы.
def set_age(age):
    if age < 0:
        raise ValueError("age cannot be negative")
    return age

try:
    set_age(-1)
except ValueError as err:
    print("error:", err)
# error: age cannot be negative
9.3
Тестирование и надёжность
Тест проверяет, что код даёт правильный ответ. Проверяйте обычные случаи и граничные случаи — пустой ввод, ноль, очень большие значения.
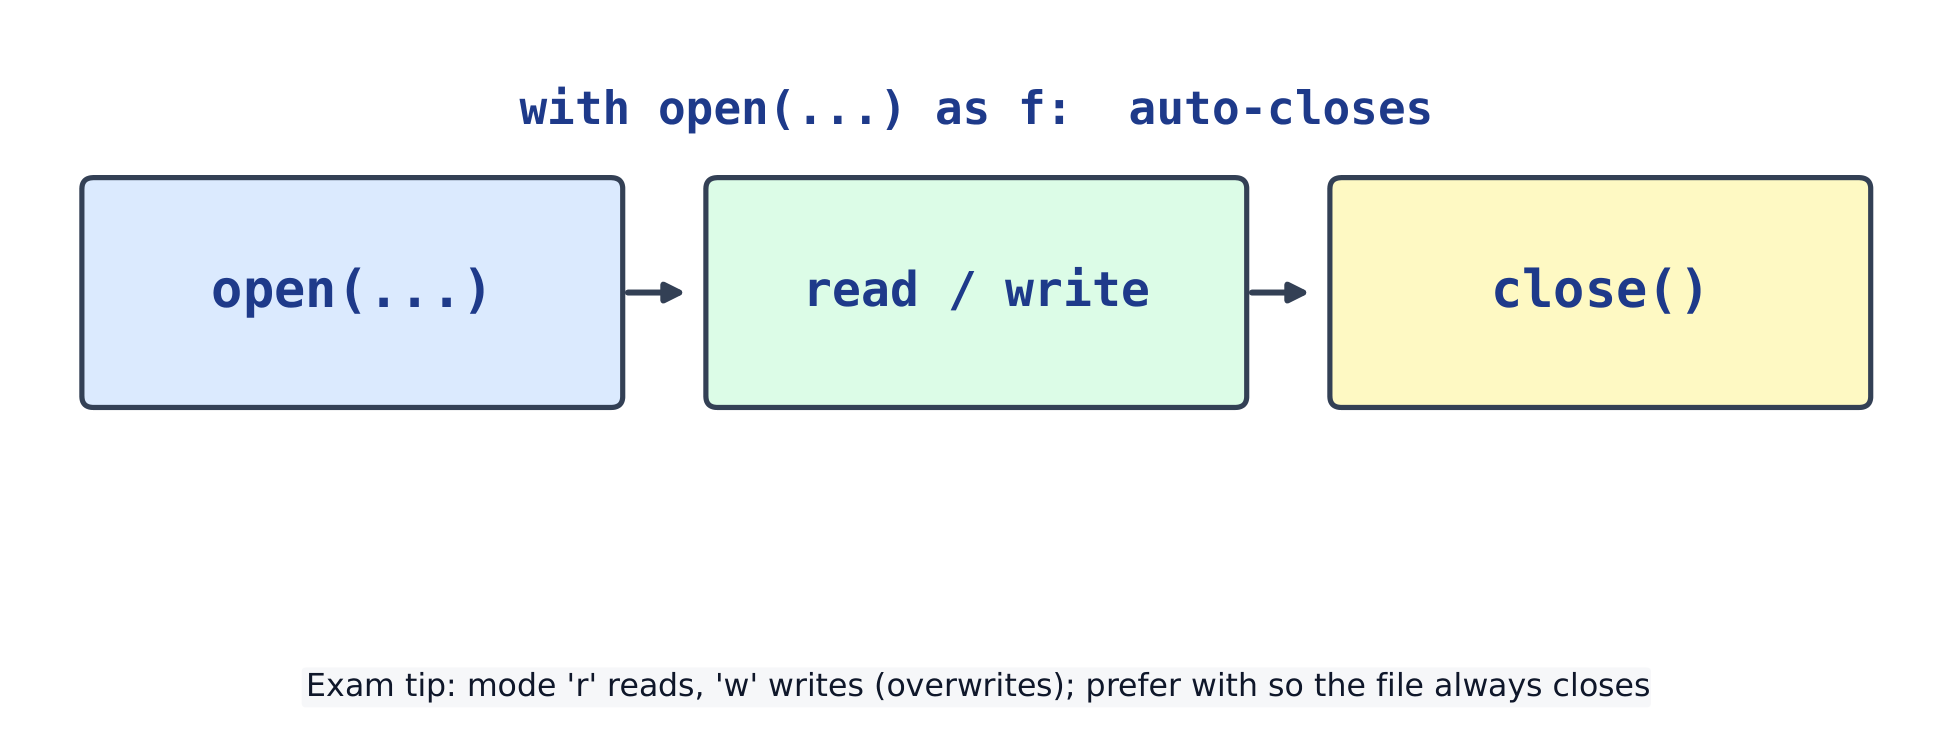
Текстовый файл хранит текст на диске. Откройте его с помощью open(name, mode), где режим указывает на чтение или запись. Всегда используйте with, который закроет файл за вас.
Запись
Режим "w" создаёт новый файл и стирает любой старый.
with open("notes.txt", "w") as f:
    f.write("first line\n")
    f.write("second line\n")
print("saved")            # saved
Чтение
Режим "r" (по умолчанию) читает. .read() возвращает весь файл как одну строку.
with open("notes.txt", "w") as f:
    f.write("hello\nworld\n")
with open("notes.txt") as f:
    print(f.read().strip())   # hello / world
Построчно
Цикл по файлу получает по одной строке. .strip() удаляет символ переноса в конце.
with open("data.txt", "w") as f:
    f.write("Mei,88\nSam,71\n")
with open("data.txt") as f:
    for line in f:
        name, score = line.strip().split(",")
        print(name, "scored", score)
# Mei scored 88
# Sam scored 71
Добавление (append)
Режим "a" добавляет данные — он дописывает в конец, не стирая содержимое.
with open("log.txt", "w") as f:
    f.write("line 1\n")
with open("log.txt", "a") as f:
    f.write("line 2\n")
with open("log.txt") as f:
    print(f.read().strip())   # line 1 / line 2
Режим
Значение
"r"
чтение (по умолчанию)
"w"
запись (стирание перед началом)
"a"
добавление (дописать в конец)
Распространенные ошибки
Всегда закрывайте файл или используйте with open(...) as f:, который закроет его автоматически.
read() возвращает весь файл как одну строку, и каждая строка всё ещё заканчивается \n.
Открытие режима "w" сначала стирает файл; используйте "a", чтобы добавить данные в конец.
Алгоритм — это чёткий набор шагов, решающих задачу. Декомпозиция означает разделение большой задачи на меньшие части, которые можно решать по очереди.
# Algorithm: find the largest number in a list
def largest(nums):
    best = nums[0]
    for n in nums:
        if n > best:
            best = n
    return best

print(largest([3, 9, 2, 7]))   # 9
Абстракция означает игнорирование деталей: вы используете largest(...), не перечитывая, как она работает.
11.2
Псевдокод и блок-схемы
Псевдокод — это структурированный plain English для алгоритма, написанный до реального кода. Он не выполняется.
SET best TO first number
FOR Each number n
    IF n > best
      THEN
        SET best TO n
OUTPUT best
Блок-схема рисует тот же план: прямоугольник для каждого шага, ромб для каждого решения и стрелки для порядка.
11.3
Рекурсия и стек вызовов
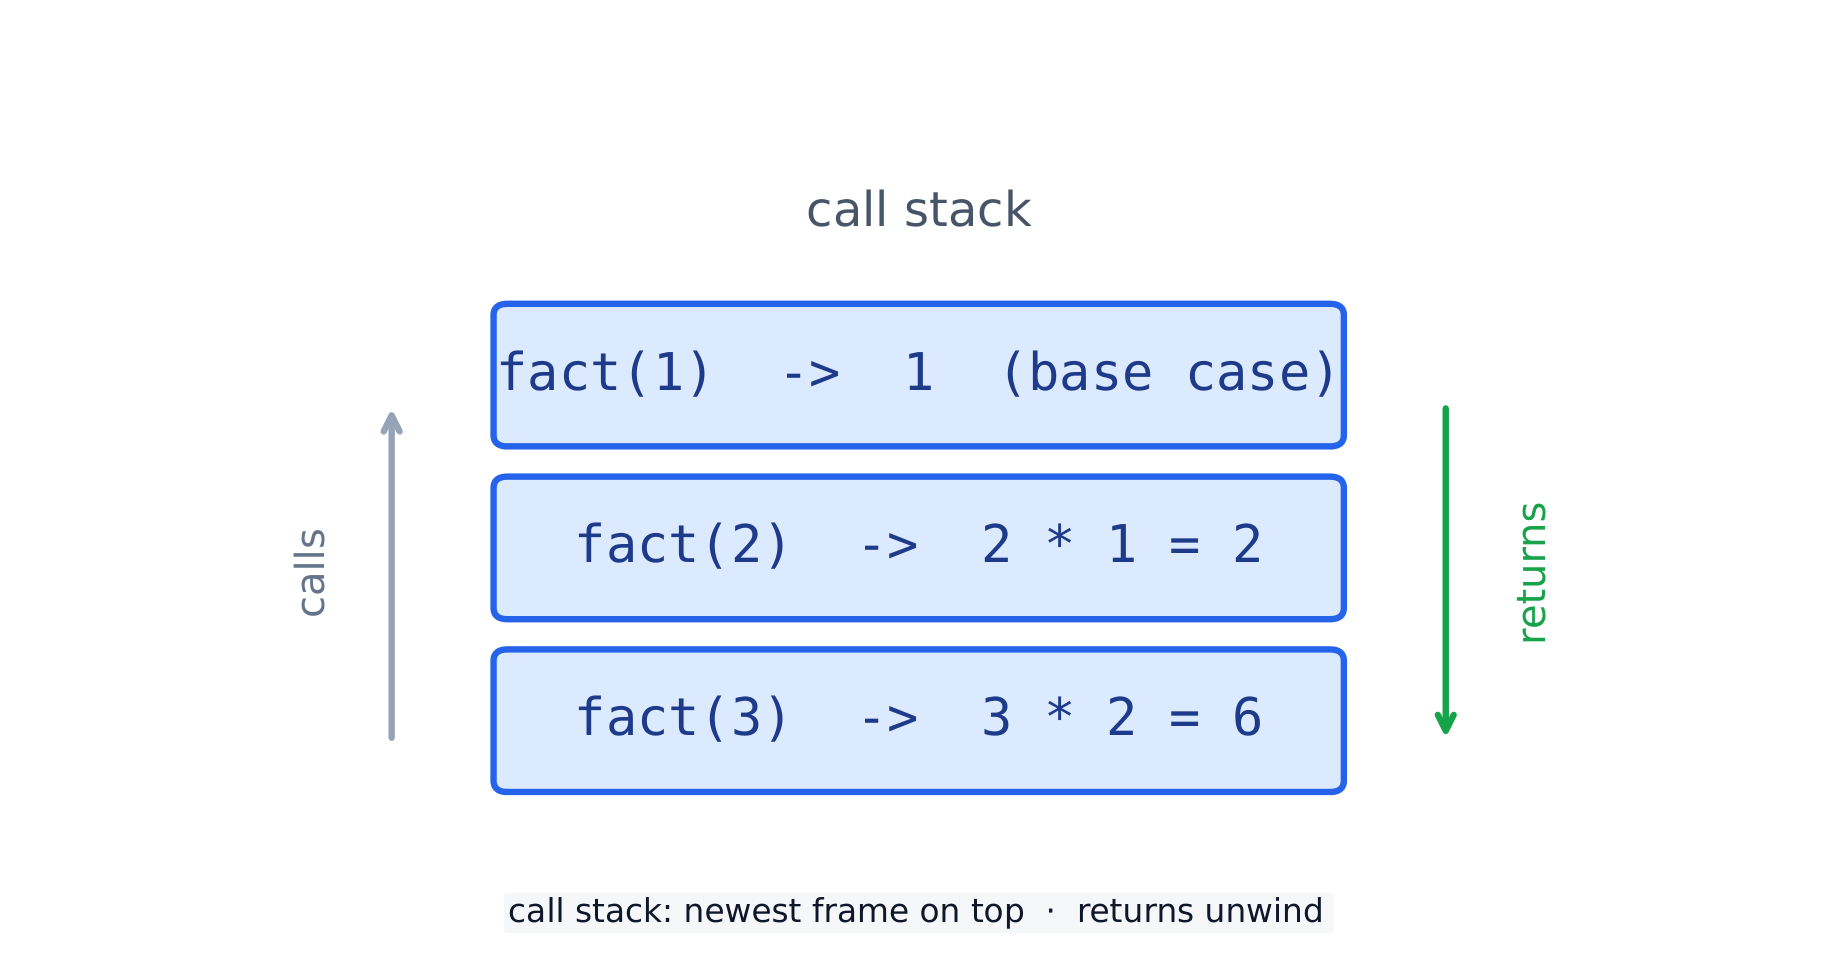
Рекурсия — это когда функция вызывает саму себя. Ей нужен базовый случай (простой входной параметр, дающий мгновенный возврат) и рекурсивный случай (вызов себя с меньшим входным параметром).
Стек вызовов для factorial(3): каждый вызов ожидает, затем результаты возвращаются в обратном порядке
def fact(n):
    return 1 if n <= 1 else n * fact(n - 1)

print(fact(5))     # 120
Каждый приостановленный вызов находится в стеке вызовов до тех пор, пока вызов над ним не вернётся.
Распространенные ошибки
Рекурсия требует базового случая, иначе она будет вызывать себя бесконечно и исчерпает стек вызовов.
Псевдокод предназначен для планирования — он не должен выполняться, но каждый шаг должен быть однозначным.
Разбейте большую задачу на маленькие названные шаги до написания любого кода.
Абстрактный тип данных (ADT) описывает данные и операции над ними отдельно от способа их реализации. Вы используете его через операции, а не через внутреннее хранение.
# A stack ADT, built on a list
s = []
s.append(1)        # add
s.append(2)
print(s.pop())     # 2  (remove the most recent)
12.2
Стек
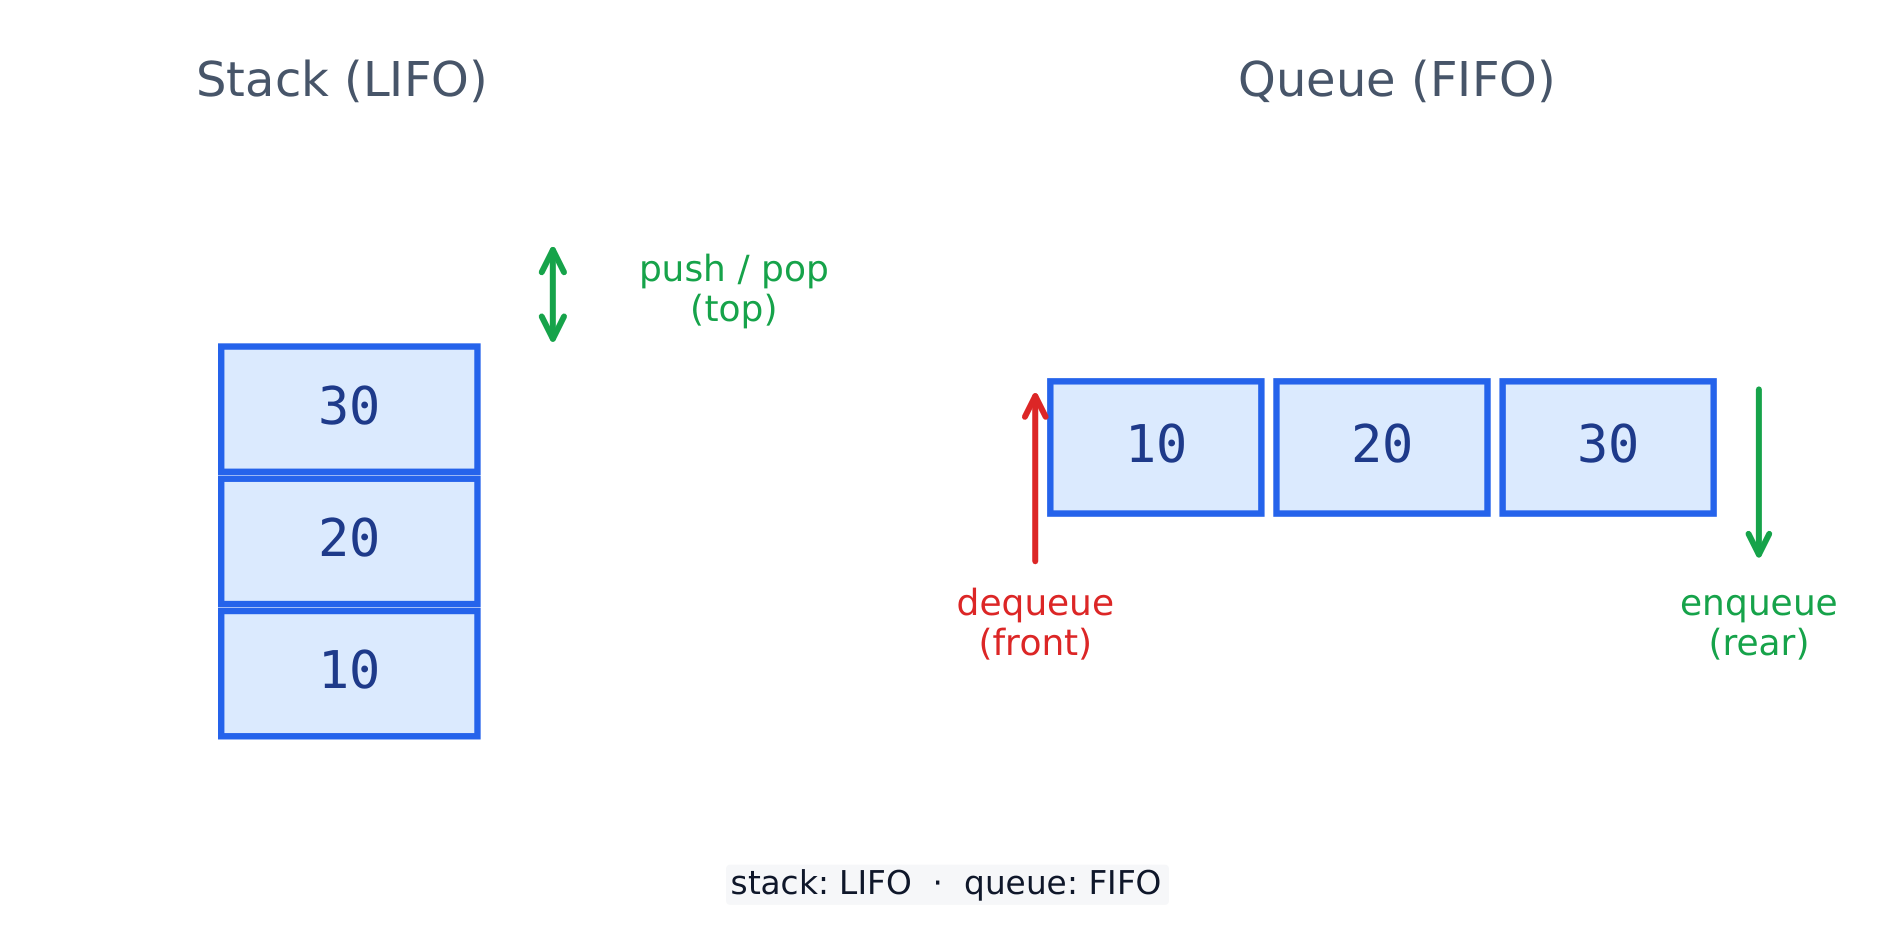
Стек — это LIFO (последним пришёл — первым ушёл). Вы кладёте элементы на верх (push) и извлекаете с вершины (pop).
Стек удаляет сверху (LIFO); очередь удаляет спереди (FIFO)
stack = []
stack.append("a")
stack.append("b")
print(stack.pop())   # b
print(stack.pop())   # a
12.3
Очередь
Очередь — это FIFO (первым пришёл — первым ушёл). Вы добавляете элемент в конец (enqueue) и извлекаете спереди (dequeue).
queue = []
queue.append("a")     # enqueue
queue.append("b")
print(queue.pop(0))   # a  (dequeue the front)
print(queue.pop(0))   # b
12.4
Связные списки
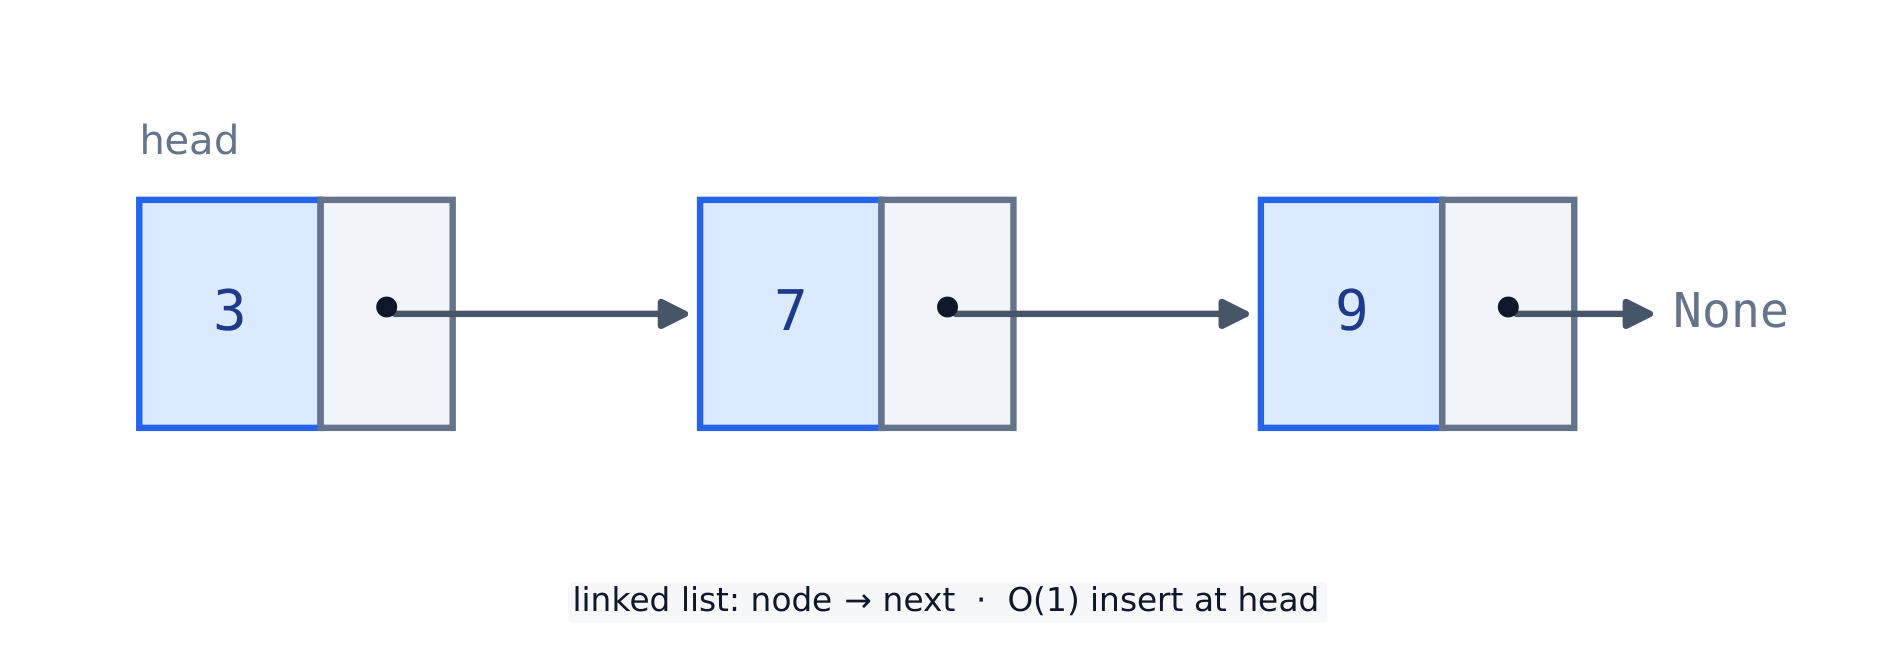
Связный список — это цепочка узлов. Каждый узел хранит данные и указатель на следующий узел; последний указывает на None.
Связный список: каждый узел хранит данные и указатель на следующий, заканчивается None
n3 = {"data": 3, "next": None}
n2 = {"data": 2, "next": n3}
n1 = {"data": 1, "next": n2}
node = n1
while node is not None:      # traverse to the end
    print(node["data"])
    node = node["next"]
# 1 2 3
12.5
Хэш-таблицы
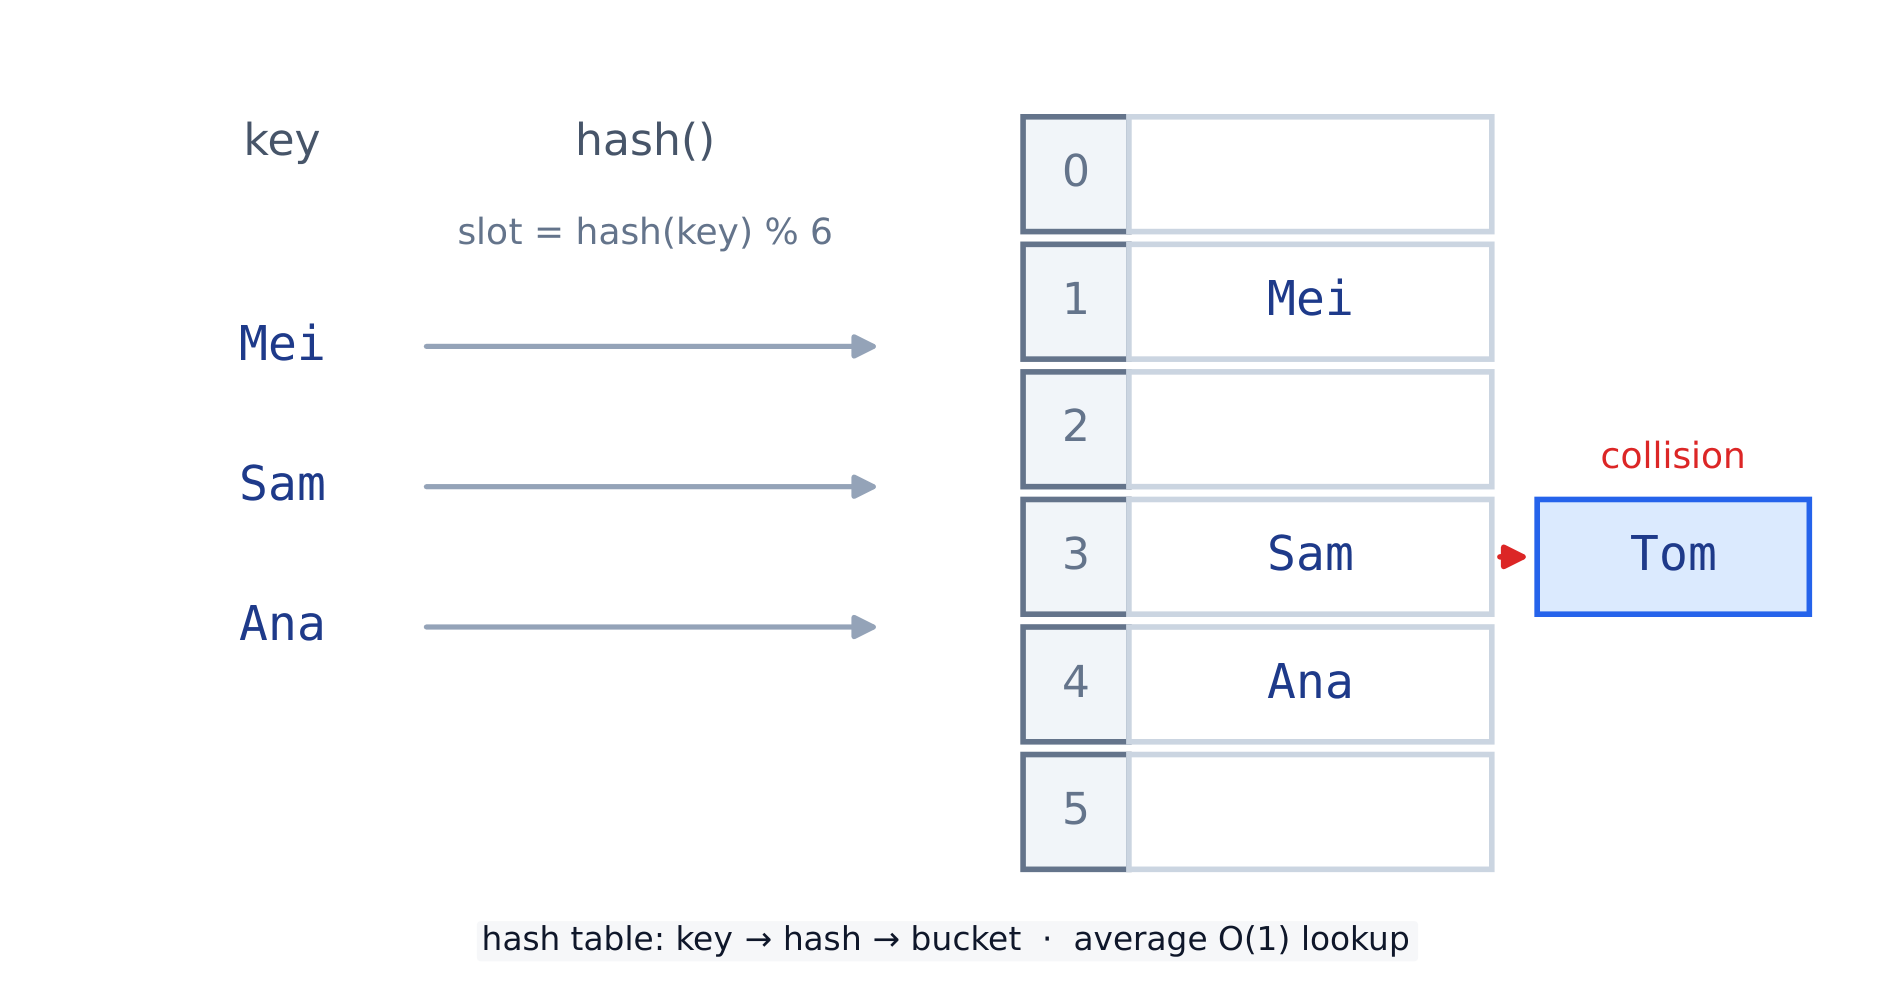
Хэш-таблица отображает ключ в ячейку с помощью хэш-функции. Два ключа могут попасть в одну ячейку — коллизия. Словари Python dict являются хэш-таблицами, поэтому поиск быстрый.
Функция хеширования сопоставляет каждому ключу слот; два ключа могут попасть в один слот (коллизия)
Поиск находит, где находится значение. Линейный поиск проверяет каждый элемент по очереди, поэтому он работает с любым списком.
def linear_search(items, target):
    for i in range(len(items)):
        if items[i] == target:
            return i
    return -1     # not found

print(linear_search([4, 8, 2, 9], 2))   # 2
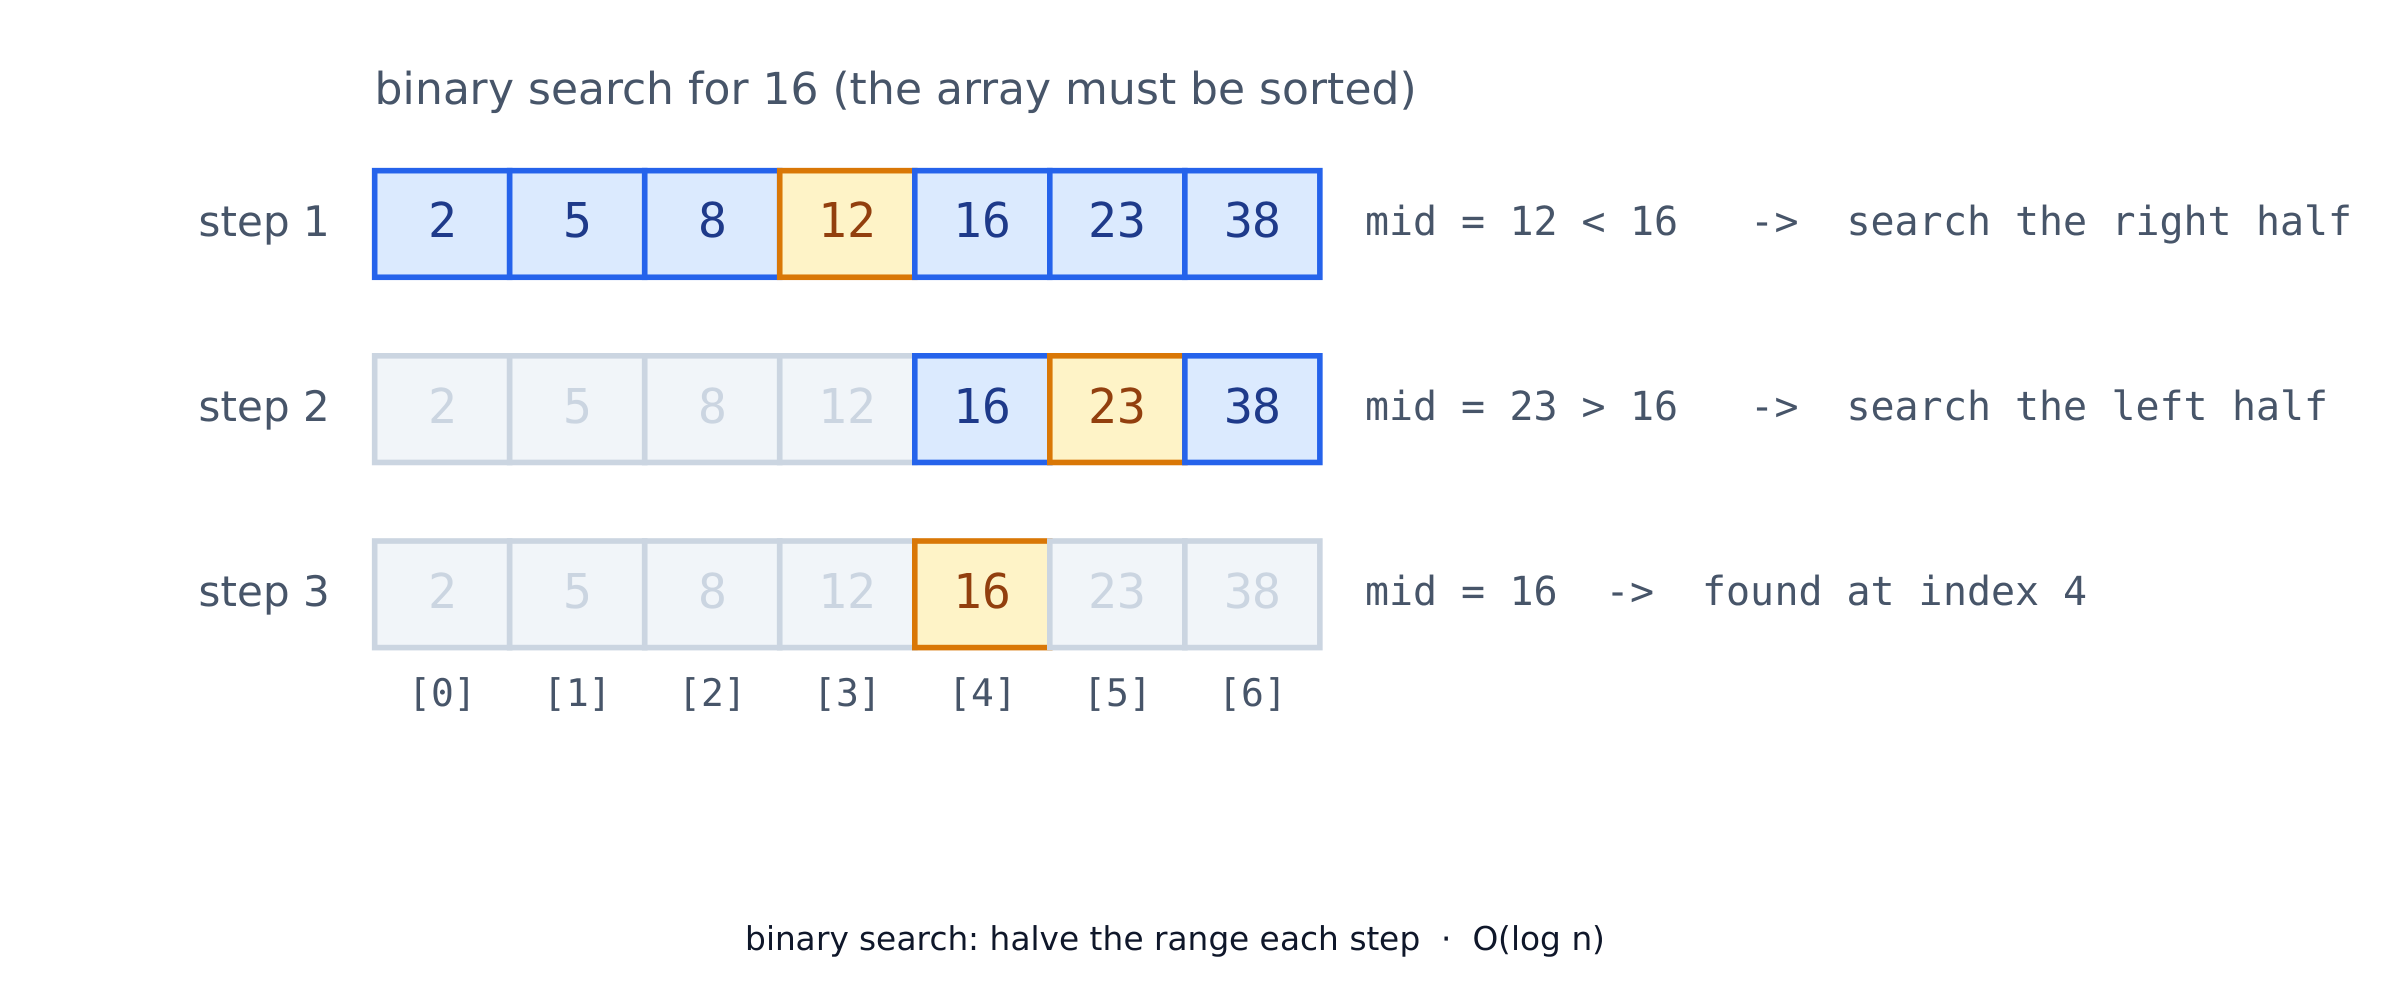
Бинарный поиск намного быстрее, но требует отсортированного списка. На каждом шаге он уменьшает диапазон вдвое.
def binary_search(items, target):
    lo, hi = 0, len(items) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if items[mid] == target:
            return mid
        elif items[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

print(binary_search([1, 3, 5, 7, 9], 7))   # 3
Бинарный поиск уменьшает диапазон вдвое на каждом шаге — O(log n) для отсортированного списка
13.2
Сортировка (пузырьковая и вставками)
Сортировка — это упорядочивание элементов. Пузырьковая сортировка многократно меняет местами соседние элементы, находящиеся не на своих местах.
def bubble_sort(a):
    a = a[:]                          # work on a copy
    for i in range(len(a)):
        for j in range(len(a) - 1 - i):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
    return a

print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
Сортировка вставками формирует отсортированную часть по одному элементу за раз, сдвигая каждый новый элемент на нужное место:
def insertion_sort(a):
    a = a[:]                           # work on a copy
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:   # shift bigger values right
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key                 # drop key into the gap
    return a

print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
В реальном коде используйте встроенную функцию Python sorted():
print(sorted([5, 2, 4, 1])) # [1, 2, 4, 5]
13.3
Эффективность алгоритмов
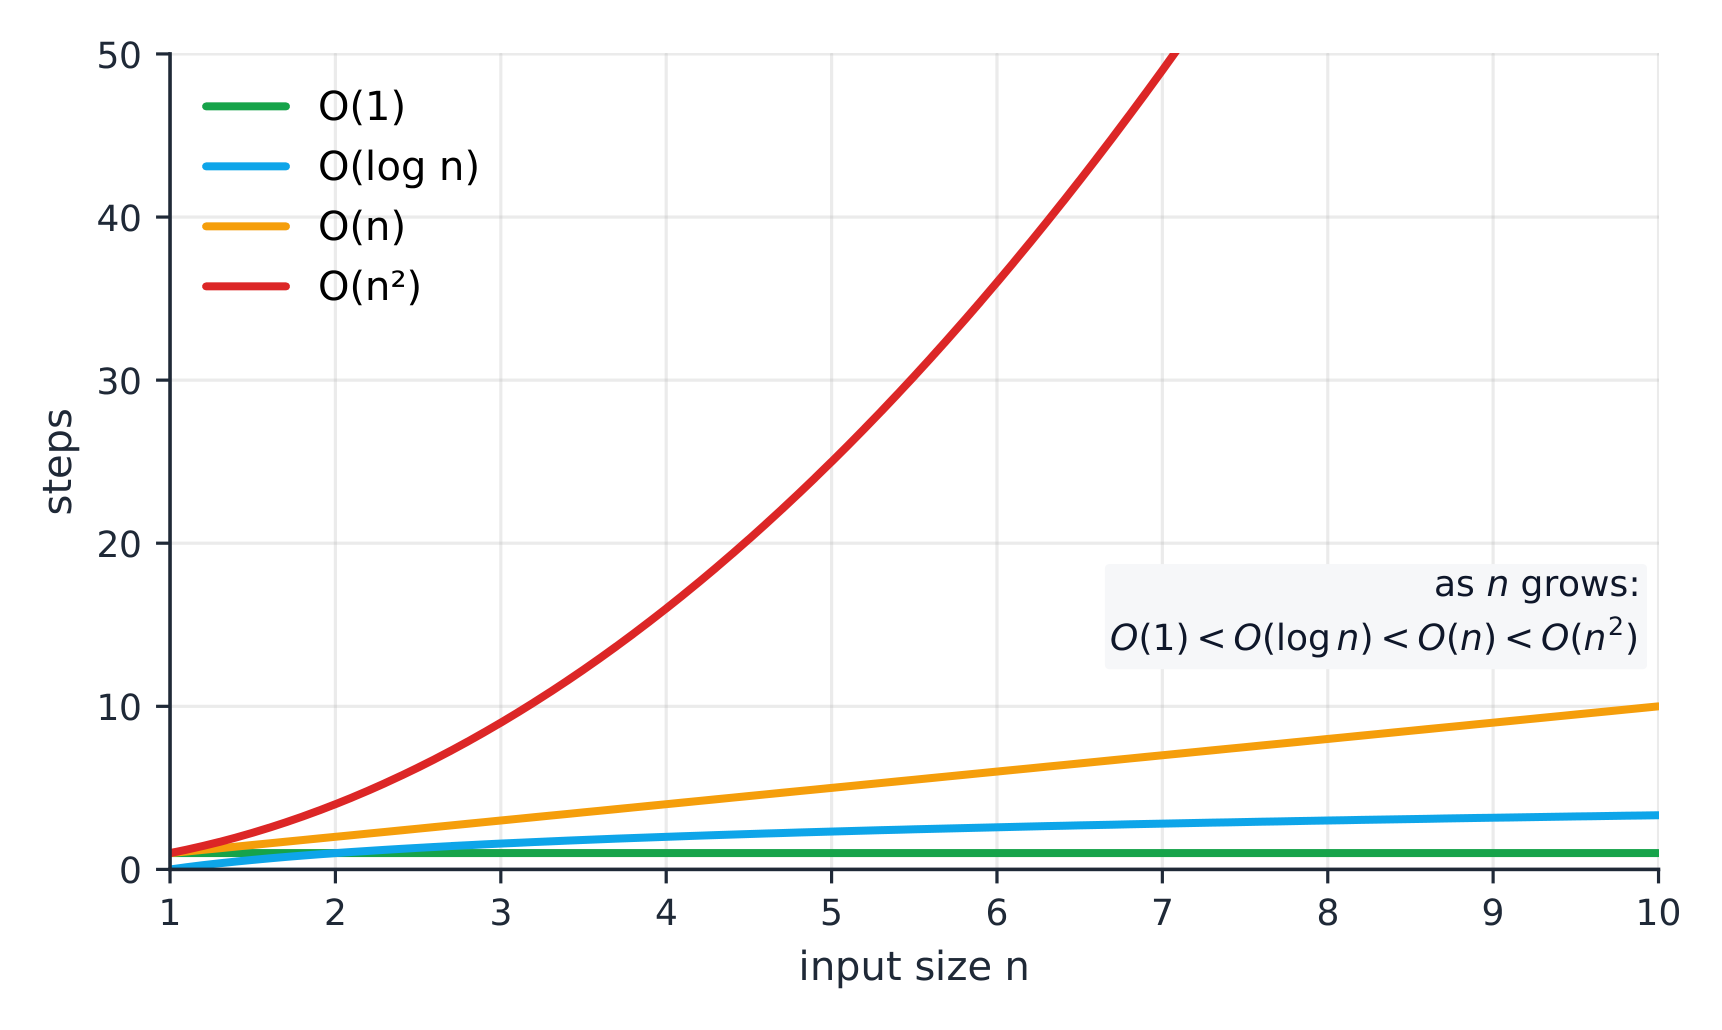
Эффективность показывает, как растёт объём работы при увеличении входных данных. Мы описываем её с помощью Big-OO.
Как количество шагов растёт с размером входных данных для типичных сложностей
Big-O
Название
Пример
$O(1)$
константная
обращение к ключу словаря
$O(\log n)$
логарифмическая
бинарный поиск
$O(n)$
линейная
линейный поиск
$O(n^2)$
квадратичная
пузырьковая сортировка
def steps(n):           # how many steps a linear scan takes
    count = 0
    for i in range(n):
        count = count + 1
    return count

print(steps(100))       # 100  -> O(n)
13.4
Случайность и моделирование
Модуль random генерирует случайные числа. Используйте seed (семя), чтобы результаты были воспроизводимы. Моделирование выполняет множество случайных испытаний для оценки ответа.
import random
random.seed(0)
rolls = [random.randint(1, 6) for _ in range(1000)]
print(rolls.count(6))   # about 1/6 of 1000
Распространенные ошибки
Бинарный поиск работает только с отсортированным списком.
Big-O показывает, как время РАСТЁТ, а не точное время; метод O(n²) может быть быстрее O(n) лишь на очень малых входах.
Пузырьковая сортировка имеет сложность O(n²) — подходит для обучения, но медленна на больших списках.
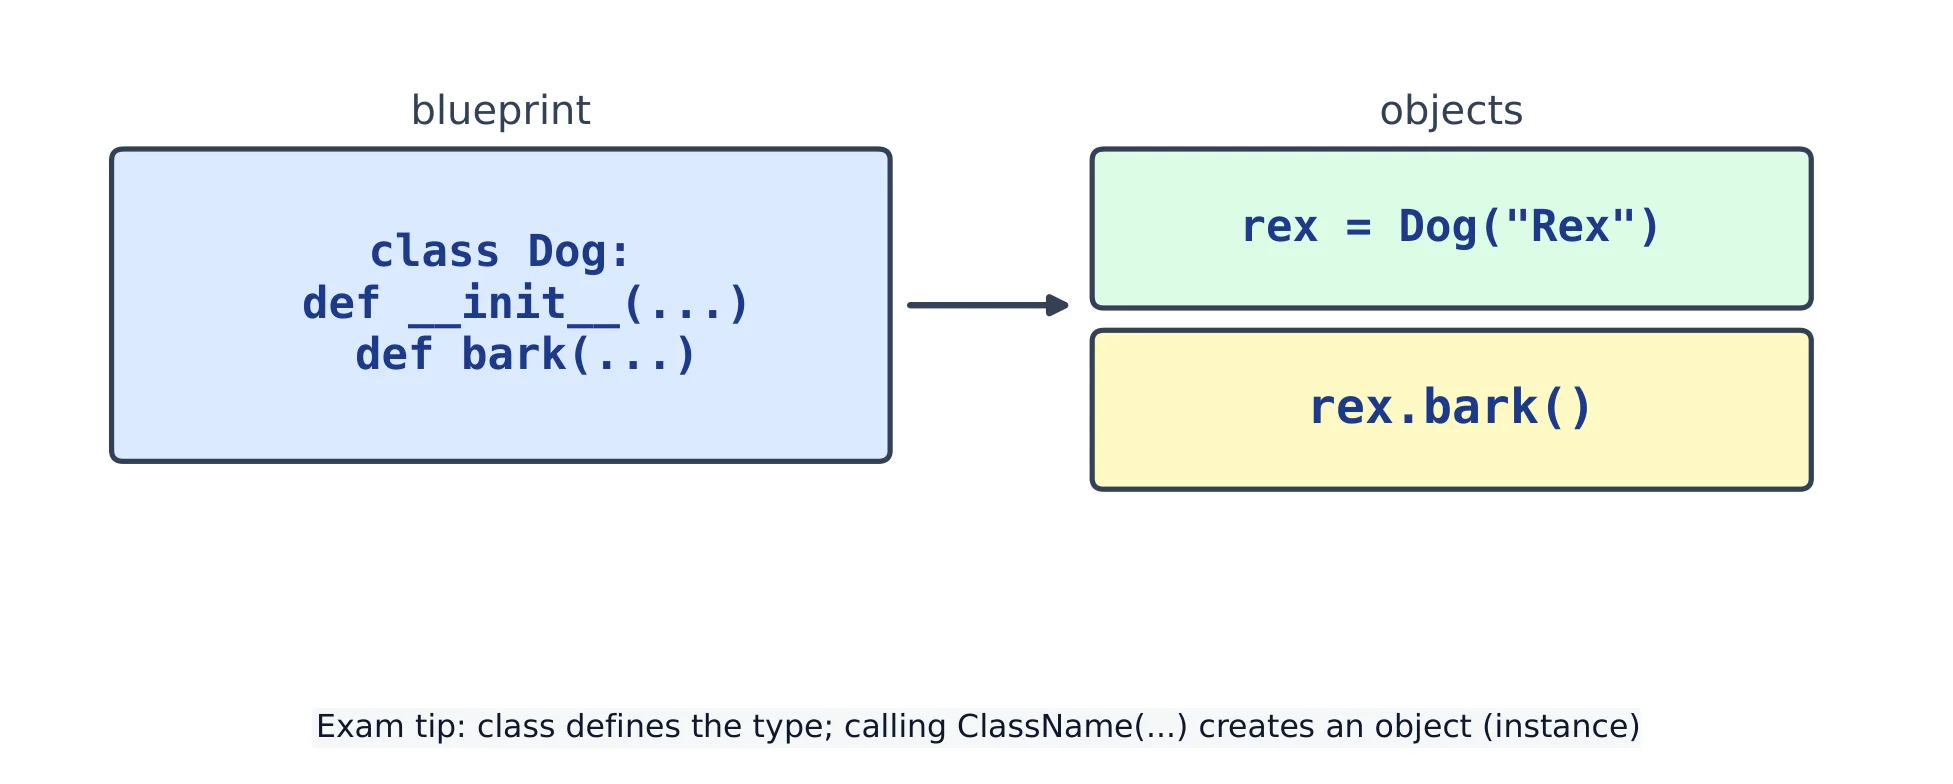
Класс — это чертеж. Объект — это конкретный экземпляр, созданный по нему. __init__ — конструктор, который настраивает каждый объект; self — сам объект.
class Dog:
    def __init__(self, name):
        self.name = name            # an attribute
    def speak(self):
        return self.name + " says woof"

d = Dog("Rex")
print(d.speak())     # Rex says woof
name — атрибут (данные объекта); speak — метод (действие).
Добавьте __str__ для управления тем, что отображает print(obj):
class Dog:
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return f"Dog named {self.name}"

print(Dog("Rex"))    # Dog named Rex
Класс — это чертеж; вызов класса создаёт объект
14.2
Наследование, инкапсуляция и полиморфизм
Наследование позволяет подклассу переиспользовать код суперкласса. Используйте super() для вызова родителя; переопределите метод, чтобы изменить его поведение.
class Animal:
    def speak(self):
        return "some sound"

class Cat(Animal):
    def speak(self):                # override
        return "meow"

print(Cat().speak())   # meow
Инкапсуляция объединяет данные и методы, предоставляя предназначенный интерфейс. В Python ведущее нижнее подчёркивание обозначает предполагаемое непубличное (часто называемое приватным) имя по конвенции; оно не препятствует обращению извне. Двойное ведущее нижнее подчёркивание изменяет имена для предотвращения случайных коллизий в наследовании, а не для обеспечения безопасности.
class Account:
    def __init__(self):
        self._balance = 0           # non-public by convention
    def deposit(self, n):
        self._balance += n
    def balance(self):
        return self._balance

a = Account()
a.deposit(50)
print(a.balance())     # 50
Полиморфизм означает одно имя — множество поведений; правильный speak выполняется для каждого объекта.
class Cat:
    def speak(self):
        return "meow"

class Cow:
    def speak(self):
        return "moo"

for animal in [Cat(), Cow()]:
    print(animal.speak())   # meow, then moo
14.3
Парадигмы программирования
Парадигма — это стиль написания программ. Процедурный код — это последовательность шагов и функций. Объектно-ориентированный код группирует данные и методы в объекты. Декларативный код говорит что вы хотите получить, а не как (списковое включение или SQL).
def total(nums):           # procedural
    t = 0
    for n in nums:
        t += n
    return t
print(total([1, 2, 3]))    # 6

print(sum([1, 2, 3]))      # 6  (declarative: same result)
Распространенные ошибки
Каждый метод должен иметь self в качестве первого параметра.
__init__ настраивает новый объект и запускается автоматически при его создании.
Два объекта одного класса имеют отдельные атрибуты; изменение одного не влияет на другой.
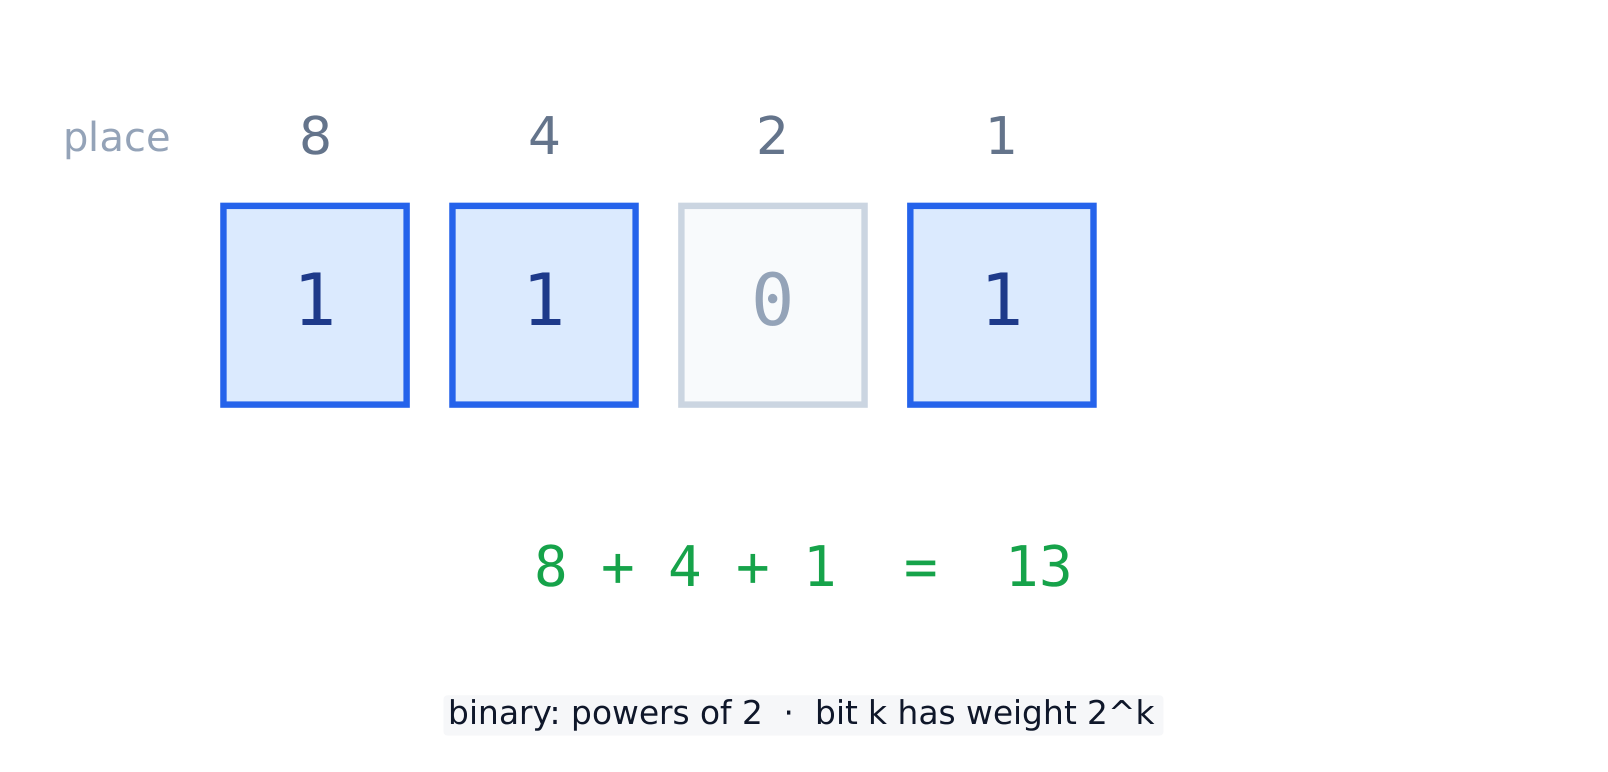
Бит — это единичный 0 или 1. Двоичная система счисления с основанием 2: каждое разрядное значение вдвое больше значения справа (1, 2, 4, 8, …). Десятеричная система (основание 10) — это наши обычные числа.
8 бит образуют байт. Фиксированная ширина может вызвать переполнение (переход через границу) при слишком большом числе.
x = 250
x = (x + 10) % 256     # one byte wraps at 256
print(x)               # 4
Шестнадцатеричная система (основание 16) — компактный способ записи двоичных чисел: одна шестнадцатеричная цифра соответствует ровно четырем битам. Python записывает шестнадцатеричные числа с помощью 0x:
Сжатие делает данные меньше. Безпотерянное сжатие сохраняет каждый бит, позволяя точно восстановить исходные данные. Потерянное сжатие отбрасывает детали — результат меньше, но не точен — и используется для фотографий и музыки.
Длиннокодовая кодировка (RLE) — простой метод безпотерянного сжатия: серия повторов хранится как счётчик плюс значение.
def rle(text):
    out = ""
    i = 0
    while i < len(text):
        run = 1
        while i + run < len(text) and text[i + run] == text[i]:
            run += 1
        out += str(run) + text[i]
        i += run
    return out

print(rle("AAAABBBCCD"))   # 4A3B2C1D
Распространенные ошибки
n битов кодируют 2**n различных значений, от 0 до 2**n - 1.
Потерянное сжатие отбрасывает детали и необратимо; безпотерянное можно вернуть в исходное состояние точно.
Информатика — это решение задач с помощью компьютеров: ввод, обработка, вывод. Качественное ПО создаётся в цикле проектирования — планирование, написание, тестирование, улучшение — который повторяется многократно.
Разбейте проблему на части, реализуйте небольшой фрагмент, протестируйте его, затем добавляйте остальное.
Программисты работают в командах и переиспользуют чужой код.
16.2
Интернет
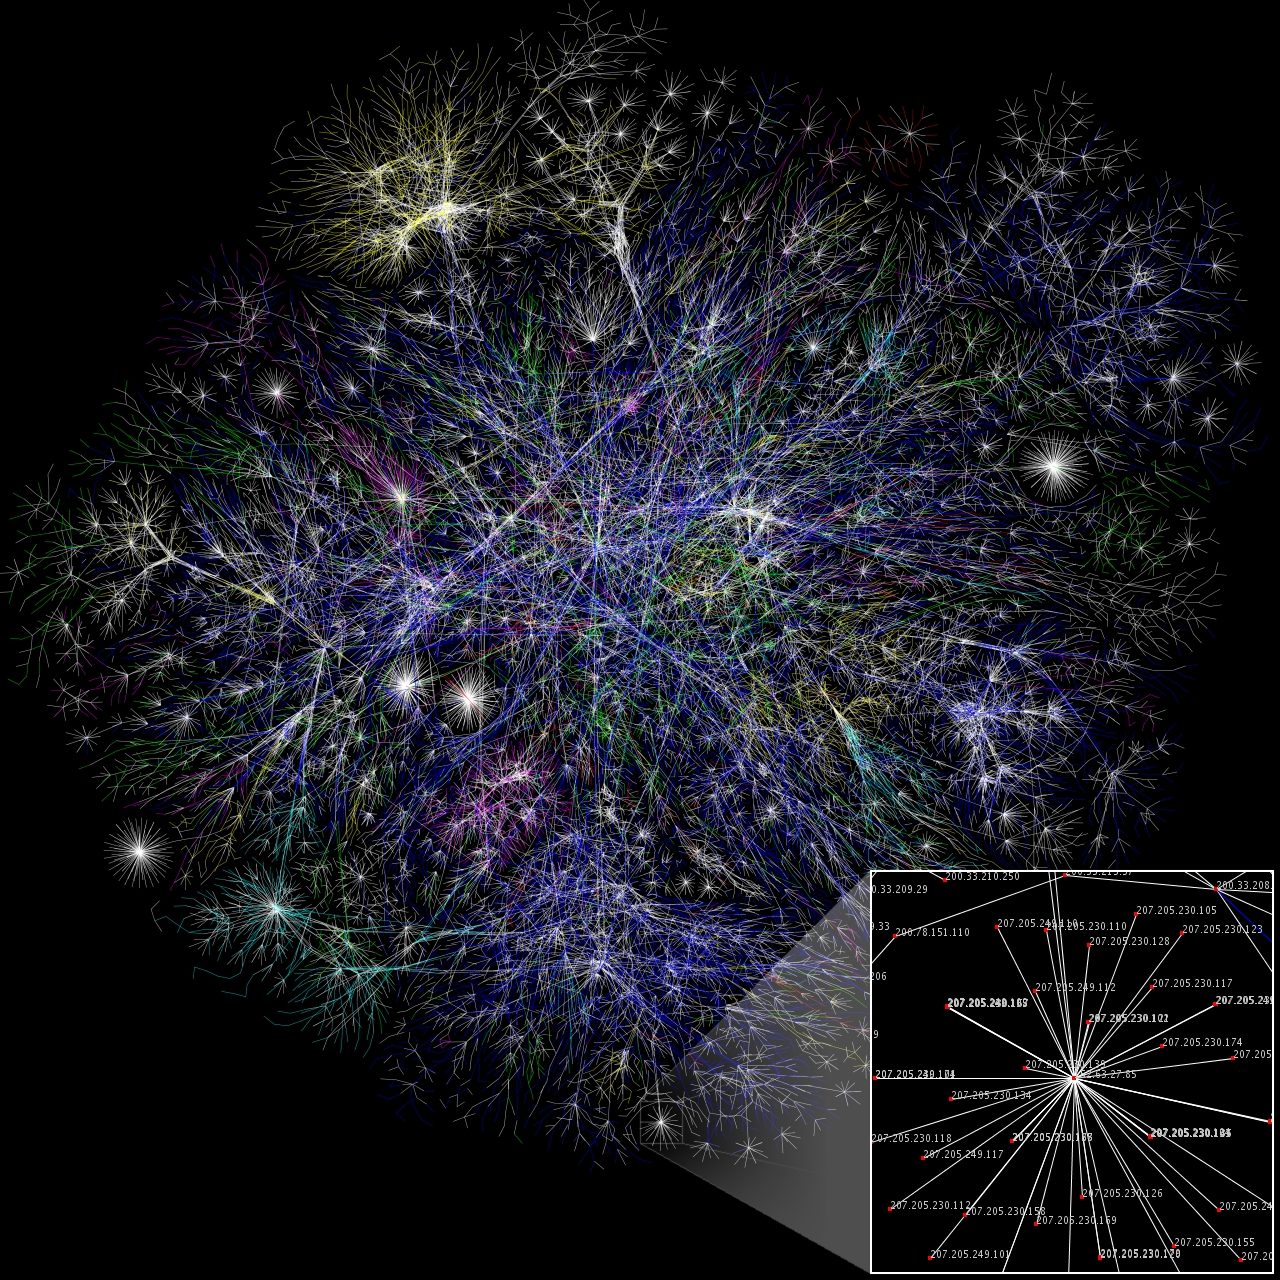
Интернет — это сеть сетей. Данные разбиваются на пакеты, которые передаются отдельно и собираются обратно на другом конце. Общие правила, называемые протоколами (например, TCP/IP), обеспечивают эту работу. Если один путь выходит из строя, пакеты идут другим маршрутом — это избыточность, обеспечивающая отказоустойчивость.
Карта Интернета: каждая линия — это путь между двумя сетями
Слой
Задача
HTTP
запрос и отправка веб-страниц
TCP
надёжная доставка, по порядку
IP
адресация и маршрутизация
16.3
Параллельные и распределённые вычисления
Последовательный код выполняет одно действие за другим. Параллельные вычисления выполняют несколько действий одновременно на нескольких ядрах, что может ускорить работу. Распределённые вычисления разбивают задачу между множеством компьютеров, например, в облаке.
Не всё можно выполнить параллельно: некоторые действия должны ждать получения предыдущего результата.
16.4
Влияние вычислений
Вычисления несут как преимущества, так и недостатки. Цифровое неравенство означает, что не все имеют равный доступ к технологиям. Программное обеспечение может переносить предвзятость из данных, на которых оно обучается. Уважайте интеллектуальную собственность (лицензии) и защищайте персональные данные и конфиденциальность людей.
Распространенные ошибки
Интернет и Всемирная паутина (World Wide Web) — это не одно и то же: Web — это сервис, работающий поверх Интернета.
Больше ядер процессора помогает только тогда, когда задачу можно разделить на части, выполняемые одновременно.
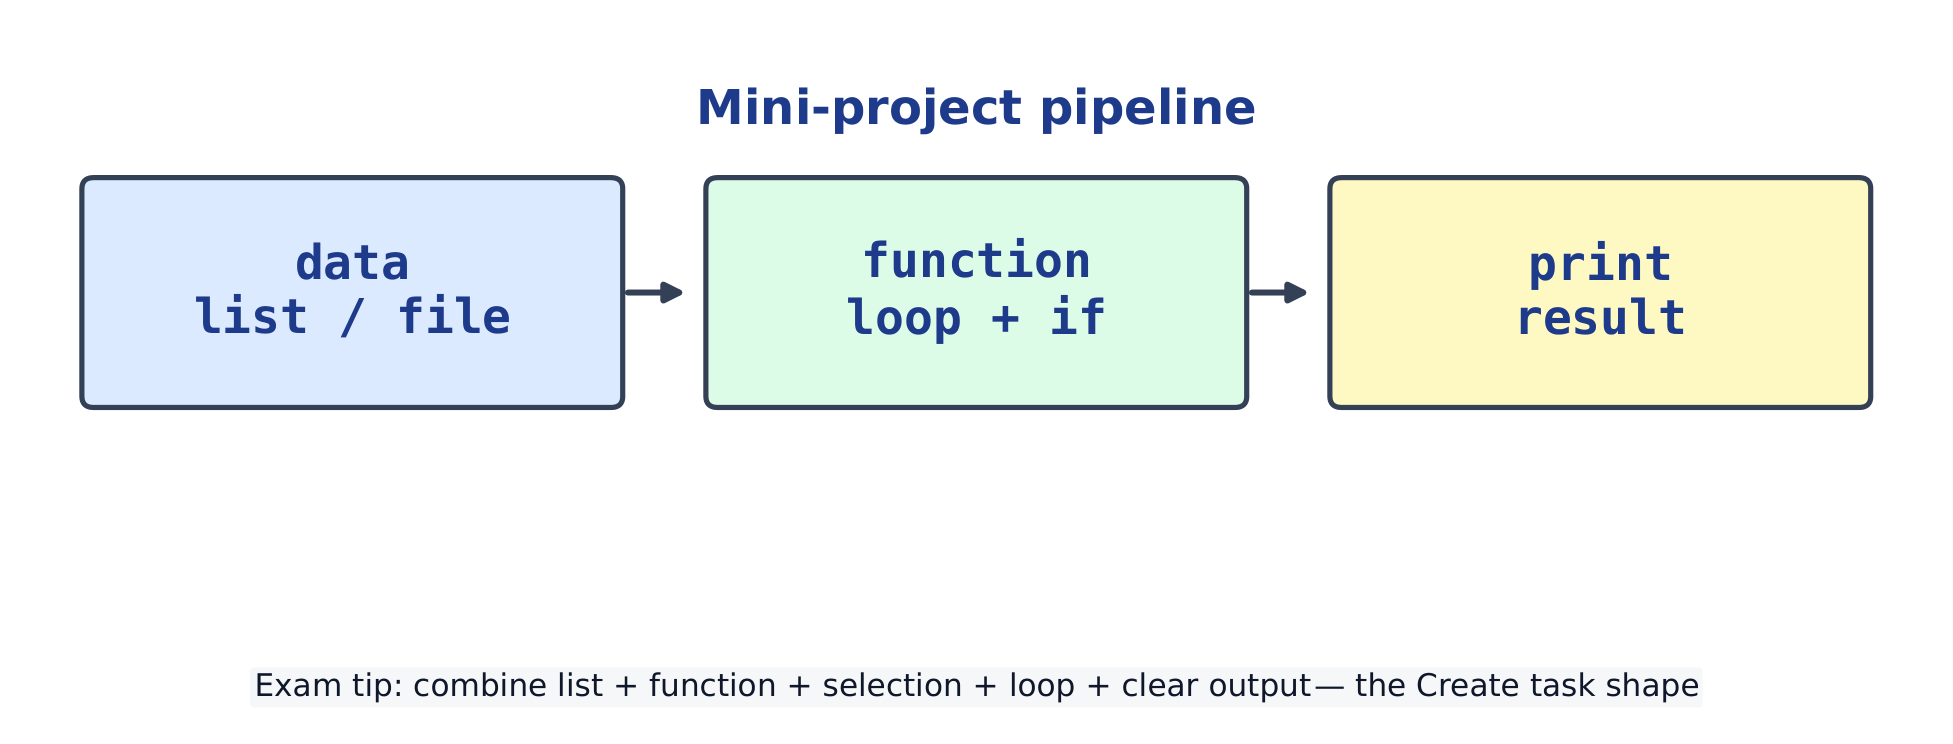
Мини-проект объединяет ранее изученные идеи: данные в списке, функция с выбором внутри цикла и вывод на экран. Это также структура задания AP Create Performance Task.
def count_passes(marks, pass_mark=60):
    passes = 0
    for m in marks:                 # iteration
        if m >= pass_mark:          # selection
            passes += 1
    return passes

print(count_passes([88, 50, 95, 60]))   # 3
Проект: фильтрация в новый список
def merit(marks):
    return [m for m in marks if m >= 80]

print(merit([88, 71, 95, 60]))     # [88, 95]
Задание AP Create требует список, параметризованную процедуру, использующую выбор и итерацию, а также ввод/вывод. Каждый из проектов выше имеет именно такую структуру — создавайте небольшие компоненты, затем объединяйте их.
Распространенные ошибки
Разбивайте создание кода на мелкие шаги и тестируйте каждую часть перед переходом к следующей — не пишите весь код сразу.
Сначала прочитайте задание целиком, затем спланируйте входные данные → обработку → выходные данные перед написанием кода.
Мини-проект: данные → функция → печатный результат