Códigos de caracteres — ASCII e Unicode
Introduzido| English | Significado |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | Unicode |
| character set/ˈkærɪktə set/ | conjunto de caracteres |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | codificação |
| code point/kəʊd pɔɪnt/ | ponto de código |
| UTF-8/ˌjuː tiː ˈef eɪt/ | codificação UTF-8 |
O e-mail que chegou como gibberish
- Ao longo dos anos 1990, uma mensagem digitada em Varsóvia e lida em Tóquio frequentemente chegava como um muro de nonsense. Ambos os computadores armazenavam oito bits por caractere. Eles simplesmente discordavam sobre o que os 128 padrões superiores significavam.
- A tabela de caracteres da Polônia colocou letras polonesas lá. A do Japão colocou seus próprios caracteres lá. Nada foi corrompido no trânsito: os bytes chegaram intactos e foram lidos contra uma tabela diferente.
- A solução foi parar de ter tabelas por país e dar a todo caractere em todo script um número, para sempre. Isso é Unicode unicode, e é por que o emoji que você envia chega como a mesma imagem.
- Esta lição é como texto se torna números: conjuntos de caracteres conjunto de caracteres, ASCII, Unicode, e as codificações que os armazenam.
Um conjunto de caracteres dá a cada caractere um número
- Um computador não armazena letras, apenas números. Um conjunto de caracteres conjunto de caracteres é o conjunto de caracteres que um computador pode representar, cada um com seu próprio código binário.
- O número para um caractere é seu code point code point.
Aé 65,aé 97,0o dígito é 48. - O code point não é o significado do caractere; é um rótulo acordado. Texto é legível apenas porque ambas as máquinas usam o mesmo conjunto de caracteres.
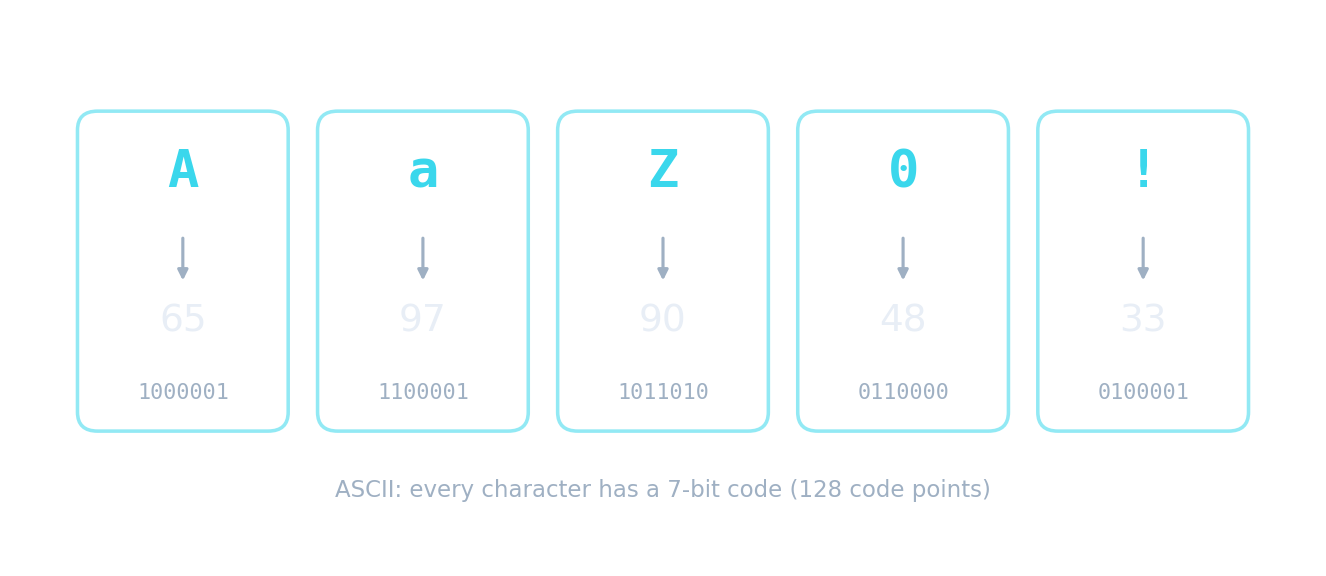
A letra é a imagem; o byte é o número
Um caractere é armazenado como um número
Cada caractere tem um código numérico — 'A' é 65. Inverta os bits para ver esse código em binário e hexadecimal, exatamente como o computador o armazena.
Um conjunto de caracteres como ASCII define:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Um conjunto de caracteres mapeia cada caractere a um número (seu ponto de código), que é o que o computador realmente armazena.
ASCII
- ASCII (American Standard Code for Information Interchange) usa 7 bits, fornecendo $2^7 = 128$ pontos de código: as letras latinas básicas, dígitos, pontuação e 32 códigos de controle como retorno de carro.
- Extended ASCII usa 8 bits, fornecendo 256 pontos de código. Os primeiros 128 são idênticos ao ASCII; os últimos 128 variam por região, o que exatamente causou aquele erro no e-mail.
- Você nunca será solicitado a memorizar um código, mas será avaliado nas contagens: 7 bits, 128; 8 bits, 256.
Quantos pontos de código diferentes o ASCII de 7 bits tem?
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
7 bits dão $2^7 = 128$ pontos de código.
Quantos pontos de código diferentes o ASCII expandido tem?
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Oito bits fornecem $2^{8} = 256$. Os $128$ inferiores correspondem a ASCII plain de 7 bits; os superiores $128$ variam por região.
Unicode
- Unicode é um conjunto de caracteres universal: um ponto de código para quase todos os caracteres em todos os sistemas de escrita vivos ou extintos, além de símbolos e emojis, mais de 149,000 deles.
- O ponto de código é separado de como ele é armazenado. Uma codificação 编码 converte um ponto de código em bytes.
- UTF-8 UTF-8编码 usa de 1 a 4 bytes por caractere e é compatível com ASCII: os primeiros 128 pontos de código ocupam um byte, idêntico ao ASCII. UTF-16 usa 2 ou 4 bytes; UTF-32 usa um fixo de 4.
O que é verdadeiro sobre UTF-8?
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
UTF-8 é uma codificação Unicode de comprimento variável (1–4 bytes); seus primeiros 128 pontos de código correspondem ao ASCII, então texto ASCII simples é UTF-8 válido.
Qual é a relação entre Unicode e UTF-8?
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
O conjunto atribui os números; a codificação decide quantos bytes cada número ocupa. UTF-16 e UTF-32 são outras codificações do mesmo conjunto.
Exemplo resolvido: comparar ASCII e Unicode
- Dê uma vantagem e uma desvantagem de usar Unicode em vez de ASCII. [2]
- Vantagem: Unicode representa muito mais caracteres, então texto em qualquer alfabeto, chinês, árabe, grego e emoji pode ser armazenado, e um único documento pode misturar idiomas; os arquivos são portáteis porque não há página de código por país sobre a qual discordar.
- Desvantagem: para texto apenas em inglês, um arquivo Unicode geralmente é maior, porque um caractere pode ocupar mais de um byte.
- Ambas as partes são necessárias. "Ele tem mais caracteres" sozinho vale apenas uma das duas marcas.
Uma vantagem chave do Unicode sobre ASCII é que ele:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Unicode cobre quase todos os sistemas de escrita além de símbolos e emojis — muito além do conjunto básico de inglês do ASCII.
Para texto em inglês apenas, um arquivo Unicode geralmente é maior que o mesmo texto em ASCII.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
As codificações Unicode podem usar mais bytes por caractere, então texto em inglês simples geralmente é maior que em ASCII de 7 bits — a troca pela cobertura universal.
Quais são as vantagens do Unicode sobre ASCII? Selecione todos os que se aplicam.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Tamanho é a troca, não um benefício: para inglês simples um arquivo Unicode geralmente é maior.
Exemplo resolvido: o tamanho de um arquivo de texto
- Uma mensagem de 500 caracteres está armazenada em Extended ASCII. Qual é o tamanho do arquivo em bytes?
- Extended ASCII usa 8 bits, um byte, por caractere, então $500 \times 1 = 500$ bytes, ou $500 \times 8 = 4000$ bits.
- A mesma mensagem em UTF-32? Quatro bytes por caractere, então 2000 bytes.
- Mostre os bits por caractere, multiplique, depois converta uma única vez. Misturar bits e bytes pela metade é o erro comum de perda de nota.
Uma mensagem de 500 caracteres é armazenada em ASCII expandido. Quantos bytes ela precisa (ignorar qualquer cabeçalho)?
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Oito bits, um byte, por caractere: $500 \times 1 = 500$ bytes ou $4000$ bits. Em UTF-32 o mesmo texto precisa de $2000$ bytes.
Lendo um caractere em binário e hexadecimal
- Como um ponto de código é apenas um número, ele converte como qualquer outro.
Aé 65, que é0100 0001em binário e41em hexadecimal. - Dois padrões úteis: os dígitos
0a9começam em 48, e minúsculo é 32 a mais que maiúsculo, entãoa(97) éA(65) mais 32. Essa diferença é um único bit. - Uma questão que dá
A= 65 e pedeEquer $65 + 4 = 69$, não uma tabela memorizada.
O código ASCII para A é 65. Qual é o código ASCII para E?
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
As letras são consecutivas, então E é quatro depois de A. Nada precisa ser memorizado além de um valor âncora.
Marcas que escapam
- ASCII é 7 bits e 128 pontos de código; Extended ASCII é 8 bits e 256. Não escreva 8 bits para ASCII puro.
- Unicode é um conjunto de caracteres; UTF-8 é uma codificação dele. Eles não são dois conjuntos rivais.
- UTF-8 é de comprimento variável, 1 a 4 bytes, nem sempre um byte e nem sempre quatro.
- A desvantagem do Unicode é o tamanho do arquivo para inglês puro, não "é mais lento" ou "é mais difícil de ler".
Entendeu?
- Um conjunto de caracteres atribui a cada caractere um ponto de código; texto são números mais um acordo sobre como lê-los
- ASCII: 7 bits, 128 pontos de código, apenas inglês · Extended ASCII: 8 bits, 256, a metade superior varia por região
- Unicode: um ponto de código para cada alfabeto e emoji, armazenado por uma codificação; UTF-8 é de 1 a 4 bytes e compatível com ASCII
- Unicode ganha caracteres, portabilidade e idiomas mistos; custa tamanho de arquivo em texto apenas em inglês