| English | 의미 |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 머신러닝 |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 역전파 |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 監督學習 |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 분류 |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 비监督學習 |
| clusters/ˈklʌstəz/ | 클러스터링 |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 강화学習 |
| agent/ˈeɪdʒənt/ | 에이전트 |
| reward/rɪˈwɔːd/ | 보상 |
| policy/ˈpɒlɪsi/ | 정책 |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 경사 하강법 |
| loss function/lɒs ˈfʌŋkʃn/ | 손실 함수 |
| epoch/ˈiːpɒk/ | 에포크 |
인간이 한 번도 시도하지 않은 개시법을 스스로 배운 프로그램
- 알파고 제로는 바둑의 규칙만 주어졌을 뿐 다른 것은什么都没有; 인간 대국, 개시법 책, 조언 등 모두 없었습니다. 무작위 수로 시작해 자신과 대전을 반복했습니다.
- 3일 만에 세계 챔피언을 이긴 버전을 초월했습니다.在这个过程中它重新发现了人类几个世纪以来的开局理论,并将其中的部分作为次优方案剔除。
- 각 경기 후 한 개의 숫자(승 또는 패)만으로 학습했습니다. 이는 백만 장의 레이블이 붙은 사진을 보여주는 것과는 완전히 다른 유형의 학습입니다.
- 이 강의에서는 머신러닝의 세 가지 패러다임, 각자가 필요로 하는 데이터의 종류, 그리고 네트워크의 가중치가 역전파를 통해 실제로 어떻게 변경되는지를 다룹니다.
지도 학습
- 지도 학습은 레이블이 포함된 데이터를 기반으로 학습합니다: '고양이' 또는 '강아지' 태그가 달린 사진, 스팸인지 아닌지 표시된 이메일, 판매 가격이 명시된 주택 등.
- 모델은 입력부터 레이블까지의 매핑을 학습한 후, 본적 없는 새로운 입력을 주어 레이블을 생성하도록 요청받습니다.
- 출력 결과가 범주인 분류와, 출력 결과가 숫자인 회귀로 나뉩니다.
- 그 비용은 레이블 생성에 있습니다: 백만 장의 이미지를 위해 이를 만들어내는 것은 막대한 인력 작업이 필요합니다.

레이블이 있는 예제 입력 → 모델 출력 → 이후 레이블 없는 입력
监督学习使用:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
监督学习在带有标签的示例上进行训练(例如标记为猫/狗的图像)。
비지도 학습
- 비지도 학습은 레이블이 없는 데이터를 주어在其中找出结构。
- 가장 흔한 용도는 클러스터링입니다: 미리 그룹을 정의하지 않고 유사한 항목들을 클러스터로 묶어내며, 예를 들어 유사한 물건을 구매하는 고객을 묶는 경우입니다.
- 그것이 바로 이 방법의 강점이자 약점입니다:誰も 예상하지 못한 그룹을 발견할 수 있지만, 그 그룹이 의미하는 바는 알려줄 수 없습니다.
비监督学习用于:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
라벨이 없을 때, 비监督学习는 데이터에서 패턴이나 클러스터를 발견합니다.
강화 학습
- 강화 학습에서는 에이전트가 환경 속에서 행동합니다. 각 행동은 상태를 변경하고 보상(reward) 을 반환하며, 이 보상이 오랫동안 0일 수도 있습니다.
- 에이전트는 정책(policy) 을 학습하는데, 이는 행동을 선택하는 전략으로 시간에 따른 총 보상을 극대화합니다. 레이블이 달린 예시 없이 실패를 통한 학습(trial and error) 방식으로 배워냅니다.
- 이는 올바른 선이 최종 결과로만 드러나는 결정의 연속에 적합한 문제(게임, 로봇 제어, 자율주행 자동차 등)에 적합합니다. 이것이 바로 AlphaGo Zero의 경우입니다.
강화학습에서 에이전트는 다음을 통해 학습합니다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
에이전트가 행동을 시도하고 보상을 받으며, 장기적인 보상을 극대화하는 정책(policy)을 학습합니다.
강화학습에서 에이전트는 시간이 지남에 따라 총 보상을 극대화하는 ____를 학습합니다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
라벨이 있는 예제 없이 보상을 통해 실패와 성공을 반복하며 학습하므로, 일련의 의사결정에 적합합니다.
풀이 예제: 패러다임 선택하기
- Ten thousand medical scans, each labelled by a doctor as showing a tumour or not, are used to train a system to flag new scans. Supervised: the data has labels and the task is to learn input to label, specifically a classification.
- 매장은 고객들이 미리 정해진 범위가 아닌 자연스러운 그룹으로 나뉘는지 알고 싶습니다. Unsupervised(비 supervised learning): 레이블이 없으며, 구조를 찾아내는 clustering(클러스터링) 작업을 수행합니다.
- 로봇 팔이 부품을 배치해야 하는데, 시도의 성공 여부만으로 평가받습니다. Reinforcement(강화 학습): 에이전트, 행동의 연속, 그리고 레이블 대신 보상을 사용합니다.
- 패러다임을 명시하고, 데이터(레이블 있음, 레이블 없음, 또는 보상 신호)에 근거하여 정당성을 설명하십시오.
AI 학습 유형 실험실
涉及的 learning type or concern 에 따라 AI 예를 분류하십시오.
각 ML 패러다임을 그에 해당하는 데이터와 매칭하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
监督学习 = 라벨; 비监督学习 = 라벨 없음; 강화학습 = 보상 피드백.
각 상황을它所需要的机器学习范式와 매칭하십시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
라벨, 무라벨 또는 보상. 데이터가 패러다임을 결정하며, 과제의 난이도가 결정하는 것이 아니다.
역전파(backpropagation)를 통한 학습
- 학습이란 네트워크의 출력이 목표값과 일치하도록 가중치(weights) 를 조정하는 것입니다. 이 방법은 경사 하강법(gradient descent) 과 함께 적용되는 역전파(backpropagation) 기법입니다.
- 전진 전파(forward pass) : 입력을 네트워크에 전달하여 출력을 얻습니다. 손실 함수(loss function) 를 사용하여 오차를 계산하는데, 이는 출력과 목표값 사이의 차이를 측정합니다.
- 후진 전파(backward pass) : 그 오차를 계층을 거슬러 올라가 전파하여 각 가중치의 기울기(gradient), 즉 해당 가중치가 오차에 얼마나 기여했는지를 찾습니다.
- 업데이트: 기울기의 반대 방향으로 각 가중치를 작은 단계만큼 변경합니다. 이 단계 크기를 학습률(learning rate) 이라고 합니다.
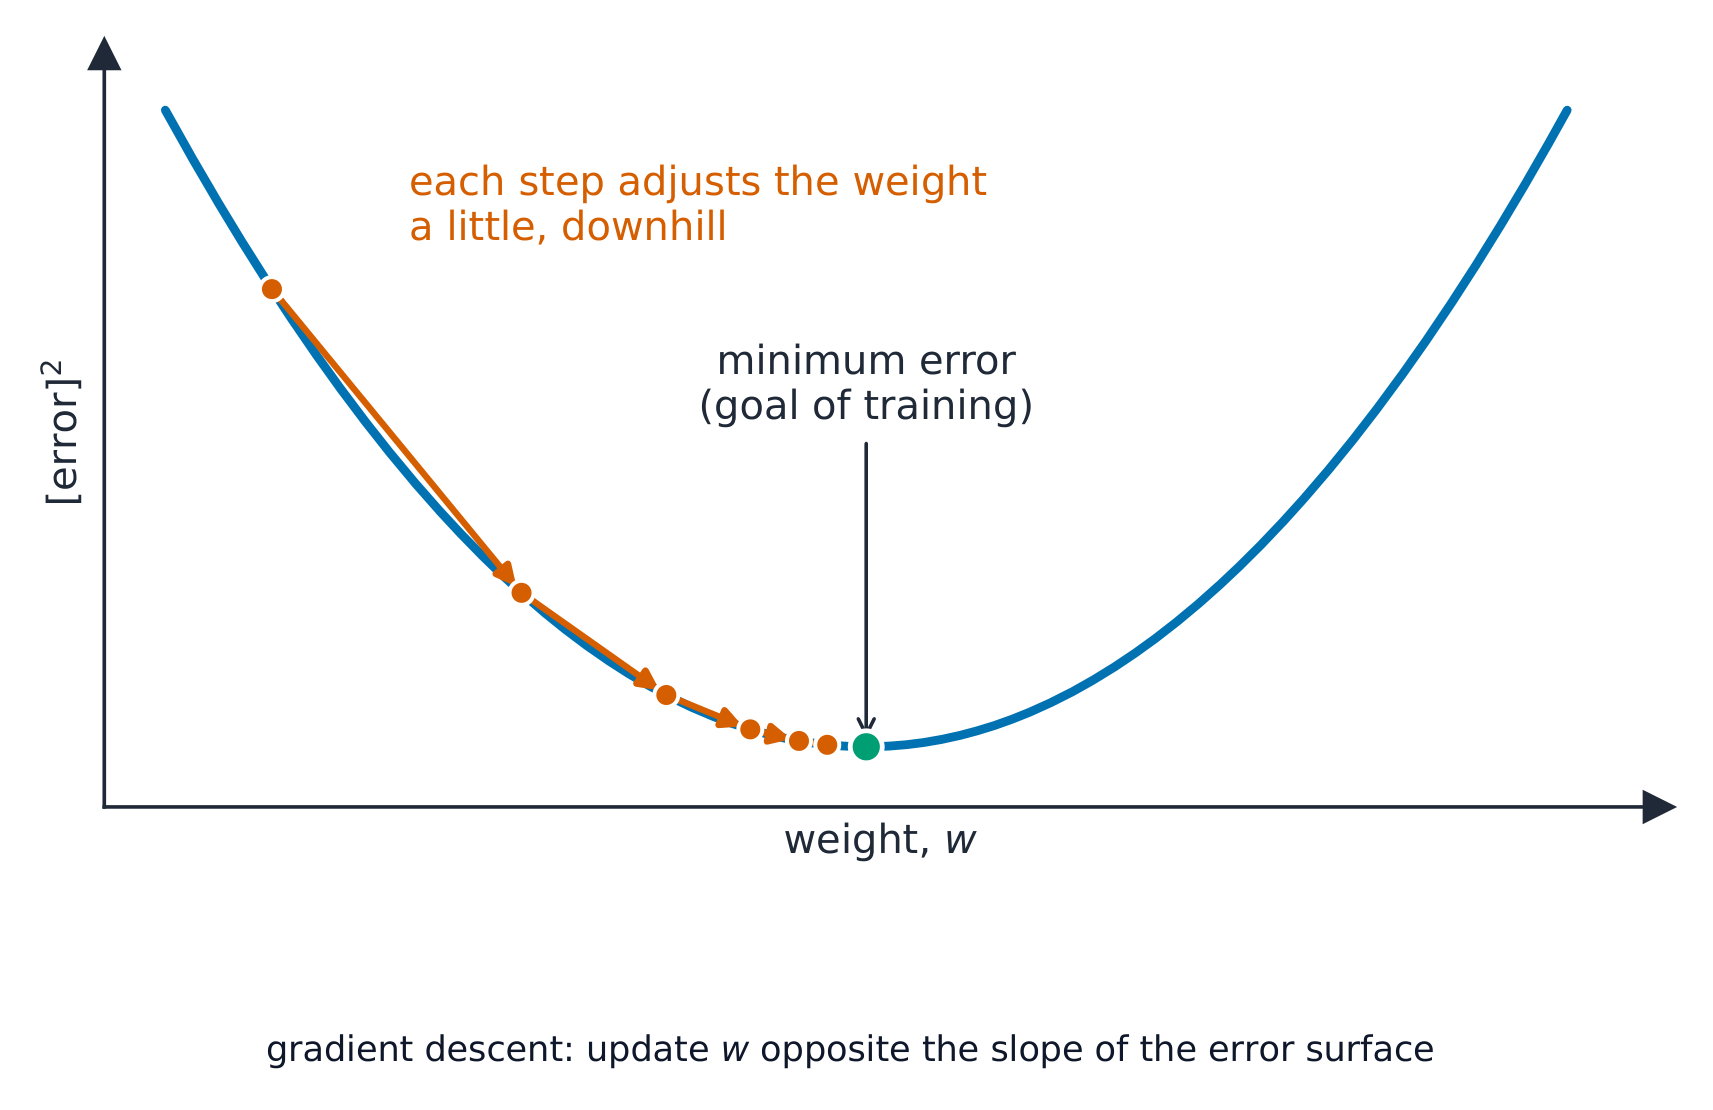
바닥으로 내려가는 것, 한 번에 작은 걸음씩
역전파(Backpropagation)는 다음을 통해 네트워크를 학습시킨다:
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
오차가 출력에서 시작되어 네트워크 전체를 거슬러 올라가(연쇄 법칙) 각 가중치의 기울기가 구해지고, 가중치는 경사 하강法으로 이동함.
한 번의 역전파 학습 과정을 순서대로 나열하시오.
난이도 3/5 · 200 코인 + 오늘 첫 완료 시 소액 보너스
전방, 오차 계산, 후방, 업데이트를 여러 에포크에 걸쳐 반복하여 오차가 더 이상 감소하지 않을 때까지 진행함.
에포크와 학습률의 중요성
- 전체 훈련 데이터셋을 한 번 순회하는 것을 **에포크(epoch)**라고 합니다. 오차가 더 이상 감소하지 않을 때까지 여러 에포크에 걸쳐 반복적으로 훈련합니다.
- 학습률이 너무 크면 최소점을 넘어서 오차가 크게 변동하고, 너무 작으면 필요한 시간보다 훨씬 오래 걸립니다.
- 훈련이 완료된 후 모델 사용은 **전방_pass(forward pass)**만 수행하면 되므로, 훈련에 수일이 걸렸더라도 trained 네트워크는 즉시 답변을 생성할 수 있습니다.
경사 하강법에서 학습률은 각 가중치 업데이트 시 취할 스텝 크기를 결정한다—너무 크면 최소값을 넘어서고, 너무 작으면 학습이 느려진다.
난이도 1/5 · 100 코인 + 오늘 첫 완료 시 소액 보너스
역전파는 각 가중치의 기울기를 구하고, 학습률은 해당 기울기 방향으로 가중치가 이동하는 거리를 조절한다.
학습에 대한 다음 중 올바른 설명은 무엇인가? 모두 선택하시오.
난이도 2/5 · 140 코인 + 오늘 첫 완료 시 소액 보너스
학습률은 각 가중치 업데이트의 크기이다. 그래서 학습에는 며칠이 걸리지만 예측은 밀리초 단위로 완료된다.
놓칠 수 있는 점
- 데이터를 통해 패러다임을 정당화하세요: 라벨이 있으면的监督 learning, 라벨이 없으면 unsupervised learning, 보상이 있는 reinforcement learning입니다.
- 강화 학습에는 라벨이 없습니다. 보상을 라벨로 부르는 것은 고전적인 혼동입니다.
- 역전파(backpropagation)는 전방_pass, 오차 계산, 후방_pass, 가중치 업데이트가 반복되는 과정입니다. "가중치를 조정한다"고만 설명하는 것은 반의 정답에 불과합니다.
- **학습률(learning rate)**은 각 단계의 크기이지, 훈련 속도나 에포크 수를 의미하지 않습니다.
이해했습니다
- 监督 learning은 라벨이 있는 데이터에서 입력부터 라벨까지 학습하여 분류(classification) 또는 회귀(regression)를 수행합니다. · unsupervised learning은 라벨이 없는 데이터에서 **클러스터(clusters)**와 같은 구조를.finds · 강화 학습은 **보상(rewards)**을 통해 시오error를 반복하며 **에이전트(agent)**가 **정책(policy)**을 학습합니다.
- 과제의 난이도가 아닌, 데이터가 제공하는 것에서 패러다임을 선택하세요.
- 역전파(backpropagation): 전방_pass, **손실 함수(loss function)**에서算出的 오차, 각 가중치의 기울기(gradient)를 제공하기 위한 후방_pass, 그리고 **학습률(learning rate)**에 의해 결정된 크기의 업데이트를 수행합니다.
- 훈련은 여러 에포크에 걸쳐 반복되며, trained 모델을 사용하는 것은 단일 전방_pass입니다.