語彙
| English | 意味 |
|---|---|
| non-parametric/nɒn ˌpærəˈmetrɪk/ | 非パラメトリック |
| rank/ræŋk/ | 順位 |
| sign test/saɪn test/ | 符号検定 |
| median/ˈmiːdiːən/ | 中央値 |
| binomial/baɪˈnəʊmɪəl/ | 二項分布 |
| outlier/ˈaʊtlaɪə/ | 外れ値 |
| Wilcoxon signed-rank test/ˈwɪlkɒksn saɪnd ræŋk test/ | ウィルコクソン記号順位検定 |
| rank-sum test/ræŋk sʌm test/ | 順位和検定 |
データが正規分布でない場合
- 多くの検定はデータが正規分布に従うことを仮定する。しかし、反応時間、順位付け、歪んだデータなどはしばそうではない。
- 非参数検定 は下位分布について仮定しない — 正確な値ではなく順序と順位に基づいて機能する。
探索
非参数検定の選び方
データの状況に合う順位検定を選択せよ。
実践
非参数検定の特徴は、データが次のような分布に従うという前提を置かないことである:
難易度 1/5 · 100 コイン + 今日初回完了時に小ボーナス付与
非参数検定は、基盤となる正規分布を仮定せずに行える。
符号検定
- 提案された中央値を検定するには、値がそれより上にある数と下にある数を数える。
- 帰無仮説の下で、その数は $p = \tfrac12$ で表される二項分布に従う — よって偏った内訳は中央値に反する証拠となる。
Example
なぜ頑健か。 符号検定は方向性(上/下)のみを用いるため、単一の外れ値でも歪まれない — 平均とは異なり。
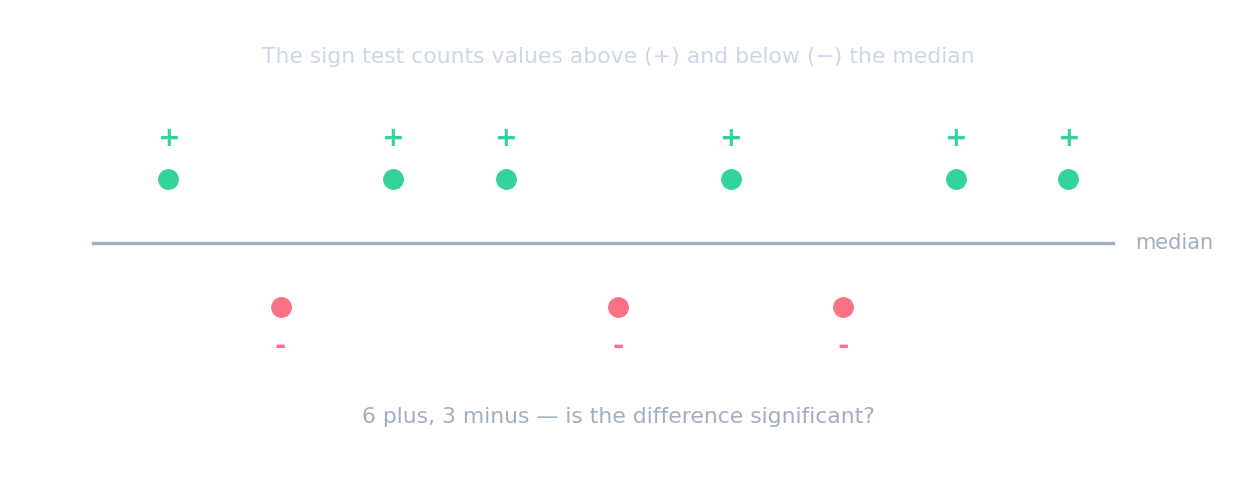
符号検定は中央値の上 (+) または下 (−) にある値の数を数える
実践
帰無仮説の下、符号検定では中央値以上の/以下の個体数にどのような分布を用いるか?
難易度 1/5 · 100 コイン + 今日初回完了時に小ボーナス付与
各値が中央値より上でも下でも同様の確率であるため、個体数は p = ½ の二項分布に従う。
実践
方向のみを使用するため、符号検定は ______ (極端な値:外れ値)の影響をほとんど受けない。
難易度 1/5 · 100 コイン + 今日初回完了時に小ボーナス付与
上/下のみを使用することで、符号検定は外れ値に対してロバストとなる。
ウィルコクソンの符号順位検定
- 符号検定は各値が中央値からどれだけ離れているかを捨ててしまう。ウィルコクソンの符号順位検定はその情報を保持する。
- 差の大きさで順位をつけ、その符号を付与し、正の(または負の)順位の和を検定統計量とする。
実践
ウィルコクソンの順位付符号検定では、差の符号だけでなくその大きさも用いる。
難易度 1/5 · 100 コイン + 今日初回完了時に小ボーナス付与
差の大きさに順位をつけ、符号検定が捨てた情報を利用する。
ウィルコクソンの順位和検定
- 2つの独立したサンプルを比較するには、すべての値をまとめ順位をつけて、一方のサンプルの順位の和をとる。
- 2つのグループに実質的な差がある場合、片方が明らかに高い順位を集める。
Watch out
検定と設計を合わせる。 符号検定と符号順位検定は1つのサンプル(またはペアデータ)用であり、順位和検定は2つの独立したサンプル用である。間違ったものを使うと結果が無効になる。
- 非参数検定には、ペアデータ向けのウィルコクソン・マッチド・ペア符号順位検定が含まれる。
実践
各検定とその設計を対応させよ。
難易度 2/5 · 140 コイン + 今日初回完了時に小ボーナス付与
符号検定と符号付き順位和検定は単一サンプル(または対応のある)用であり、順位和検定は2つの独立したサンプルを比較する。
理解できましたか
Key idea
- 非参数検定は正規性の仮定を要せず — 順序と順位を用いる
- 符号検定: 中央値より上/下の数を数える(二項分布、非常に頑健)
- ウィルコクソン符号順位(1つのサンプル、差の大きさを用いる)および順位和(2つの独立したサンプル)