Apa kursus ini, dan bagaimana menggunakannya
Ini adalah kursus kedua belas dalam Kedokteran Universitas: epidemiologi, biostatistika dan kedokteran berbasis bukti (EBM) — peralatan kerja yang mengubah pertanyaan klinis menjadi angka dan angka menjadi keputusan. Hal ini selaras dengan materi statistika UNI-BUS-05 yang ditinjau di mana matematikanya saling tumpang tindih.
Batasan ruang lingkup, dinyatakan sekali: kursus studi, bukan gelar kedokteran; setiap dataset di bawah ini sintetik atau berlisensi terbuka, setiap abstrak yang dievaluasi adalah fiksi, dan tidak ada di sini yang memberikan lisensi atau panduan pengobatan.
- Unit 12.1–12.3 mengukur dan membandingkan: frekuensi penyakit, desain studi, bias dan kausalitas.
- Unit 12.4–12.6 mengkuantifikasi: tes diagnostik, inferensi, uji klinis dan tinjauan.
- Unit 12.7 diterapkan: evaluasi, kepastian, dan pasien di depan Anda.
Kebiasaan EBM: tanyakan dalam PICO, ukur dalam risiko dan rasio, putuskan dengan interval bukan ritual** — setiap perhitungan di bawah ini sintetik, diperiksa mesin, dan sesuatu yang harus Anda hitung ulang.
Mengukur penyakit: insiden dan prevalensi
Mengapa ini penting. Sebelum perbandingan apa pun, penyakit harus dihitung — dan dua jenis penghitungan klasik menjawab pertanyaan berbeda: seberapa cepat kasus baru muncul, dan berapa banyak yang ada sekaligus.
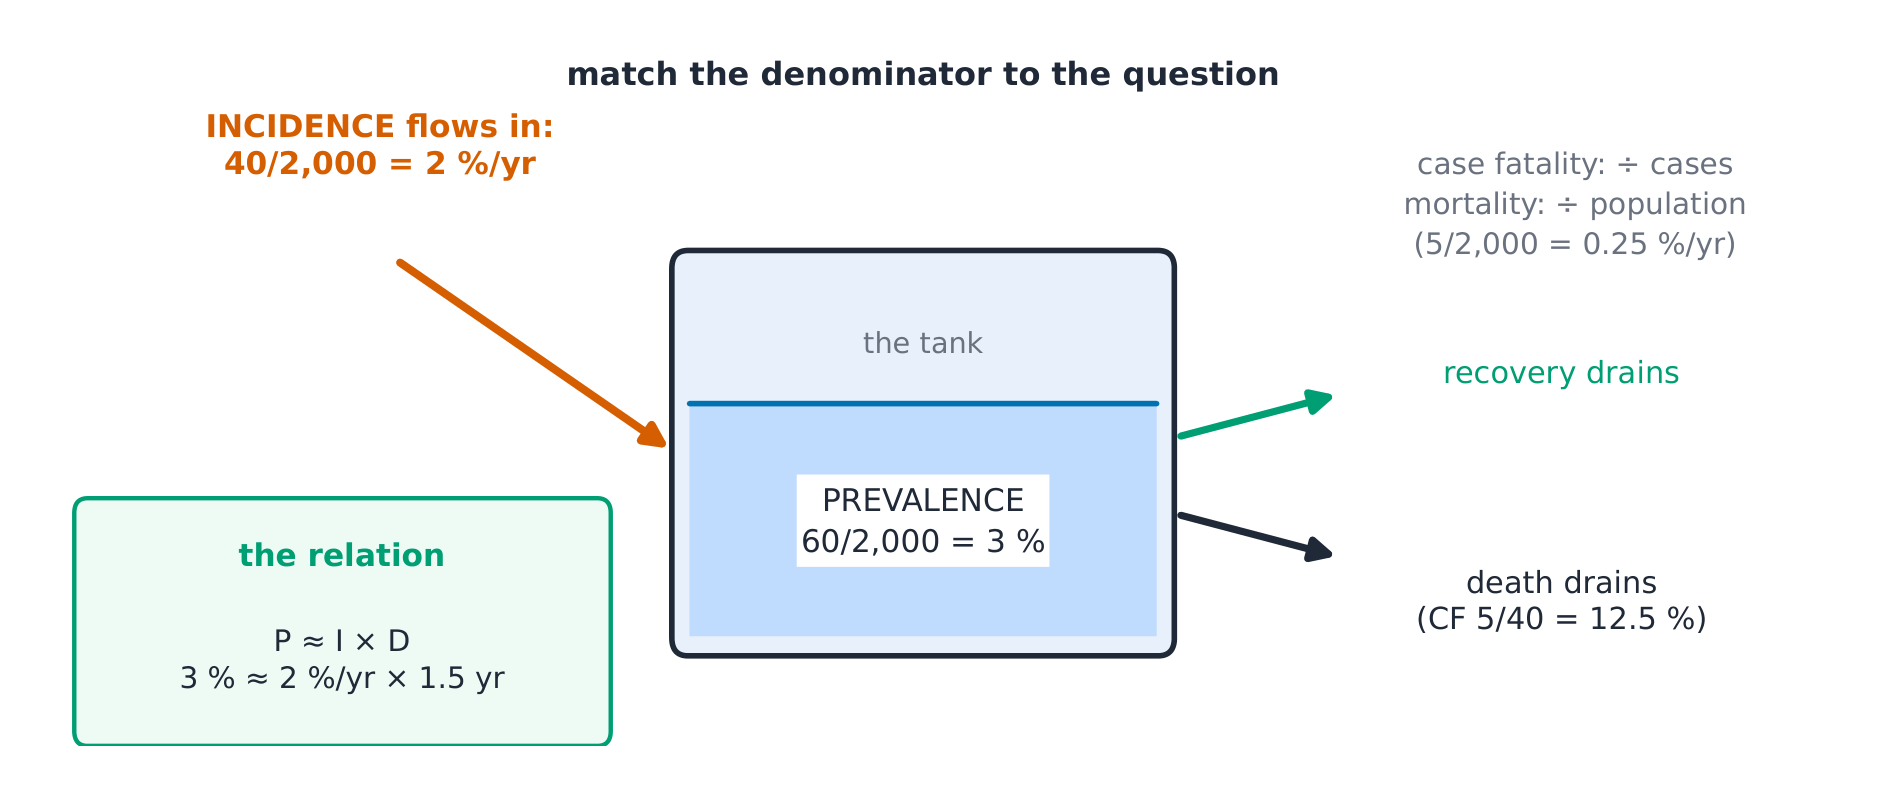
Ideanya, dengan gambar. Insiden = kasus baru ÷ orang pada risiko ÷ waktu; prevalensi = kasus yang sudah ada ÷ populasi pada suatu titik ✓. Keduanya terkait: prevalensi ≈ insiden × durasi — penyakit lama terakumulasi, sementara yang singkat menghilang di antara survei.
Penurunan (mengapa standarisasi diperlukan). Angka kasar mencampur dua efek: risiko penyakit dan struktur usia populasi. Distrik dengan lebih banyak penduduk lansia dapat menunjukkan angka kasar yang lebih tinggi dengan ANGKA KHUSUS-USIA yang LEBIH RENDAH ✓. Standarisasi langsung menerapkan angka khusus-usia dari setiap kelompok ke satu populasi standar dan menjumlahkannya — total artifisial ini dapat dibandingkan karena campuran usianya kini identik.
Contoh terpecahkan 1 — kota sintetis. 2,000 penduduk, satu tahun, 40 kasus baru penyakit tersebut → insiden 40/2,000 = 2 % per tahun ✓. Pada hari survei 60 orang menderita penyakit tersebut → prevalensi titik 60/2,000 = 3 % ✓. Periksa kaitannya: 3 % ≈ 2 %/tahun × 1.5 tahun durasi rata-rata — angka-angka ini membentuk sistem yang konsisten. sistem.
Contoh terpecahkan 2 — kaitan klinis: tiga wajah mortalitas. (Fiktif data set) dari 40 kasus baru, 5 meninggal dalam waktu satu tahun: kasus fatalitas 5/40 = 12.5 % ✓; kematian tahunan akibat penyebab ini di seluruh kota adalah 5/2,000 = 0.25 % (tingkat kematian spesifik penyebab); dan jika kota tersebut mencatat 20 kematian dari semua penyebab pada tahun itu, penyakit ini menyebabkan 5/20 = 25 % darinya (proporsional Kesalahan umum. Menyebut prevalensi sebagai laju (ini adalah proporsi — tanpa satuan waktu). Membandingkan laju kasar di antara populasi dengan struktur usia yang berbeda (standarisasi terlebih dahulu). Membaca fatalitas kasus sebagai tingkat kematian (penyebutnya adalah kasus, bukan orang).
Ringkasan. Insidensi = baru/risiko/waktu; prevalensi = ada/populasi; P ≈ I × D; standarisasi memperbaiki campuran usia; fatalitas kasus (kasus), kematian spesifik penyebab (populasi), kematian proporsional (semua kematian) — sesuaikan penyebut dengan pertanyaan. satuan waktu). Membandingkan tingkat kasar antar populasi dengan usia yang berbeda Mengapa hal ini penting. Setiap pertanyaan klinis memiliki desain yang menjawabnya dengan baik dan desain yang tidak dapat — memilih desain berarti memilih bias mana yang akan Anda hadapi. Gagasan, dengan gambar. Tangga: uji acak (eksperimen) → kohort (ikuti yang terpapar dan tidak terpapar ke depan) → kasus-kontrol (melihat mundur dari hasil) → lintang (satu tangkapan) → ekologis (kelompok, bukan individu) ✓.
Penyakit atau hasil langka → kasus-kontrol; paparan diukur sebelum hasil umum → kohort; kedua pertanyaan sekaligus → uji P ≈ I × D; standarisasi memperbaiki komposisi usia; kasus fatalitas (kasus), kematian spesifik penyebab (populasi), kematian proporsional (semua kematian) — sesuaikan dengan penyebut sesuai pertanyaan.
Desain studi
Mengapa hal itu penting. Setiap pertanyaan klinis memiliki desain yang menjawabnya dengan baik dan desain yang tidak dapat — memilih desain berarti memilih bias mana yang akan Anda hadapi.
Ide tersebut, dengan gambar. Tangga: uji acak (eksperimen) → kohort (ikuti terpapar dan tidak terpapar ke depan) → kasus-kontrol (lihat mundur dari hasil) → cross-sectional (satu potret) → ekologis (kelompok, bukan individu) ✓.
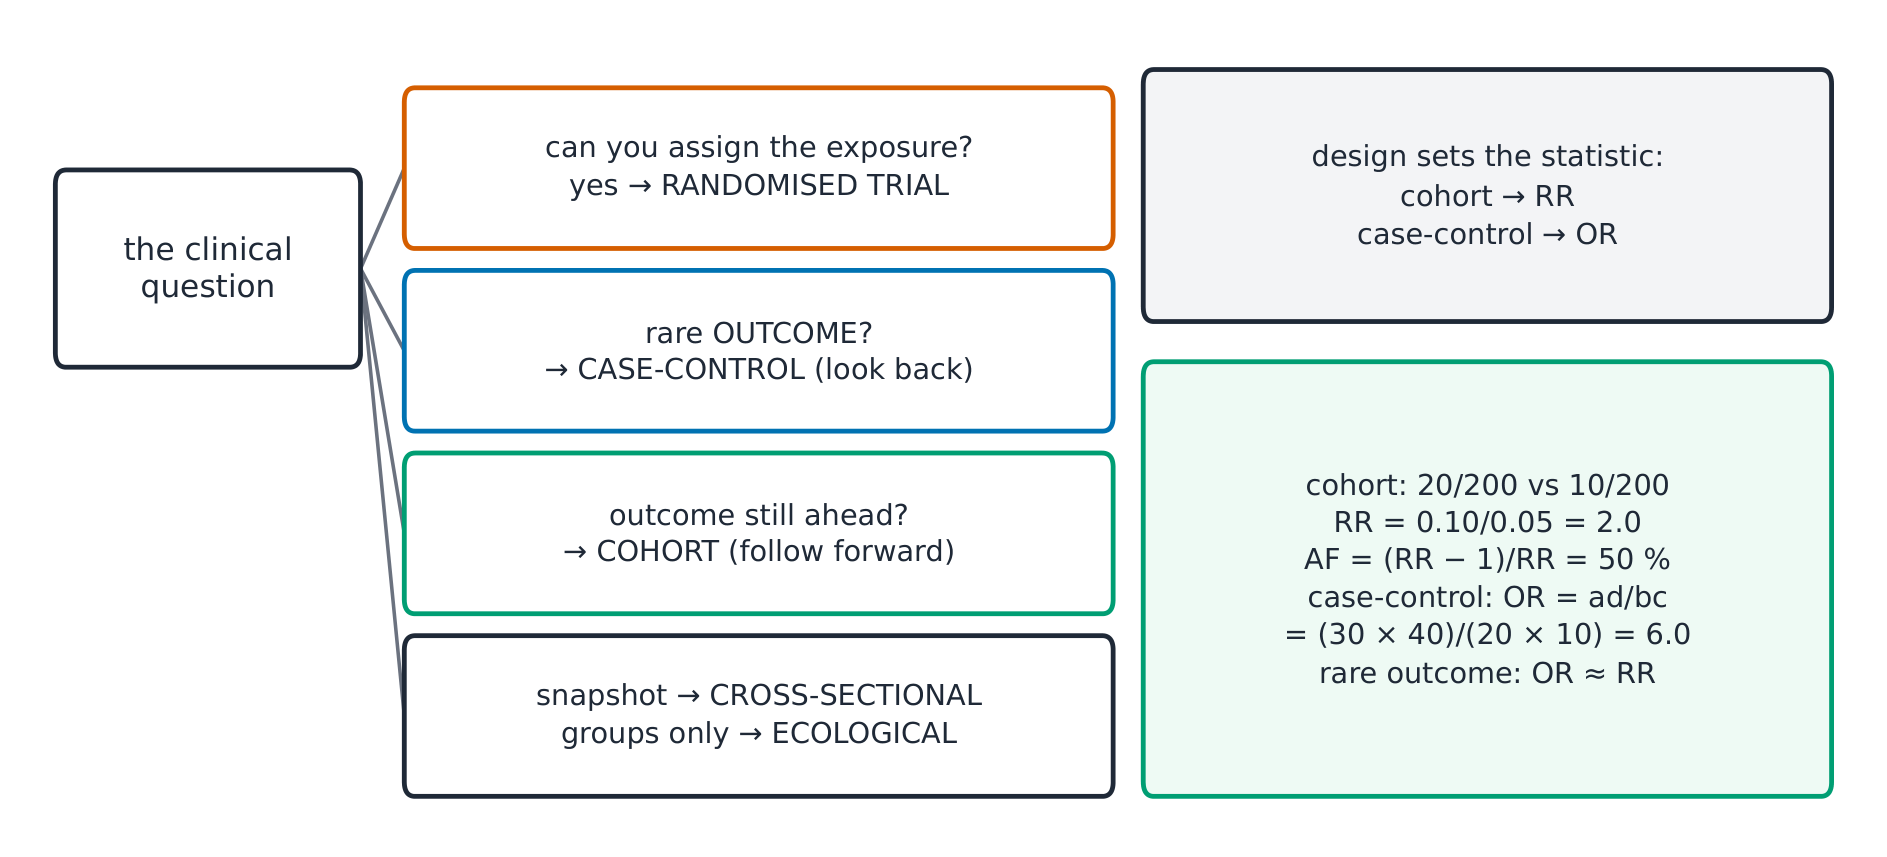
Turunan (mengapa RR cocok untuk kohort dan OR untuk studi kasus-kontrol). A sampel kohort berdasarkan PAPARAN, sehingga risiko di setiap lengan dapat diestimasi: relatif risiko** $RR = \frac{a/(a+b)}{c/(c+d)}$ ✓. Sampel studi kasus-kontrol diambil berdasarkan HASIL, sehingga "risiko" pada setiap kelompok merupakan artefak dari rasio pengambilan sampel — hanya rasio odds $OR = \frac{a/c}{b/d} = \frac{ad}{bc}$ yang valid ✓. Desain menentukan statistik, bukan preferensi.
Contoh terpecahkan 1 — satu kohort sintetis. Terpapar 200, 20 kejadian; tidak terpapar 200, 10 kejadian: risiko 0.10 vs 0.05 → $RR = 2.0$ ✓, fraksi yang dapat diatribusikan pada kelompok terpapar $(RR-1)/RR = 50\ \%$ ✓ — kejadian pada kelompok terpapar dua desain, dan pengambilan sampel menentukan mana yang sah secara statistik.
Contoh terpecahkan 2 — tautan klinis: cermin studi kasus-kontrol. (Fiksi) 30 dari 40 kasus terpapar; 20 dari 60 kontrol terpapar: $OR = \frac{30 \times 40} {10 \times 20} = 6.0$ ✓. Hasil yang langka membuat OR mendekati RR — satu angka, Ringkasan. Uji → kohort (RR) → studi kasus-kontrol (OR) → silang →
Kesalahan umum. Menghitung RR dari studi kasus-kontrol (penyebutnya dipilih oleh peneliti, bukan ditemukan). Membaca rasio odds silang sebagai kausal (paparan dan hasil terjadi bersamaan). Setara "prospektif" dengan "lebih baik" (kohort prospektif masih bisa terkonfundasi; hanya randomisasi yang menyeimbangkan faktor-faktor yang tidak diketahui). Ringkasan. Uji → kohort (RR) → studi kasus-kontrol (OR) → silang →
Summary. Trial → cohort (RR) → case-control (OR) → cross-sectional → ecological; $RR = \frac{a/(a+b)}{c/(c+d)}$, $OR = ad/bc$; cohort samples by paparan, studi kasus-kontrol berdasarkan hasil; OR penyakit langka ≈ RR; dapat diatribusikan fraksi $(RR-1)/RR$.
Bias, perancu, dan kausalitas
Mengapa ini penting. Angka dapat menyesatkan dengan tiga cara: secara sistematis (bias), melalui variabel ketiga (perancu), dan oleh asosiasi tanpa sebab. Menamai mode kegagalan adalah separuh dari penilaian kritis.
Konsepnya, dengan ilustrasi. Bias adalah kesalahan sistematis dalam desain atau pengukuran: bias seleksi (siapa yang masuk), bias informasi/ingatan (apa yang diingat atau dicatat). Perancu adalah variabel ketiga yang terkait dengan baik paparan maupun hasil yang berpura-pura menjadi penyebab ✓.
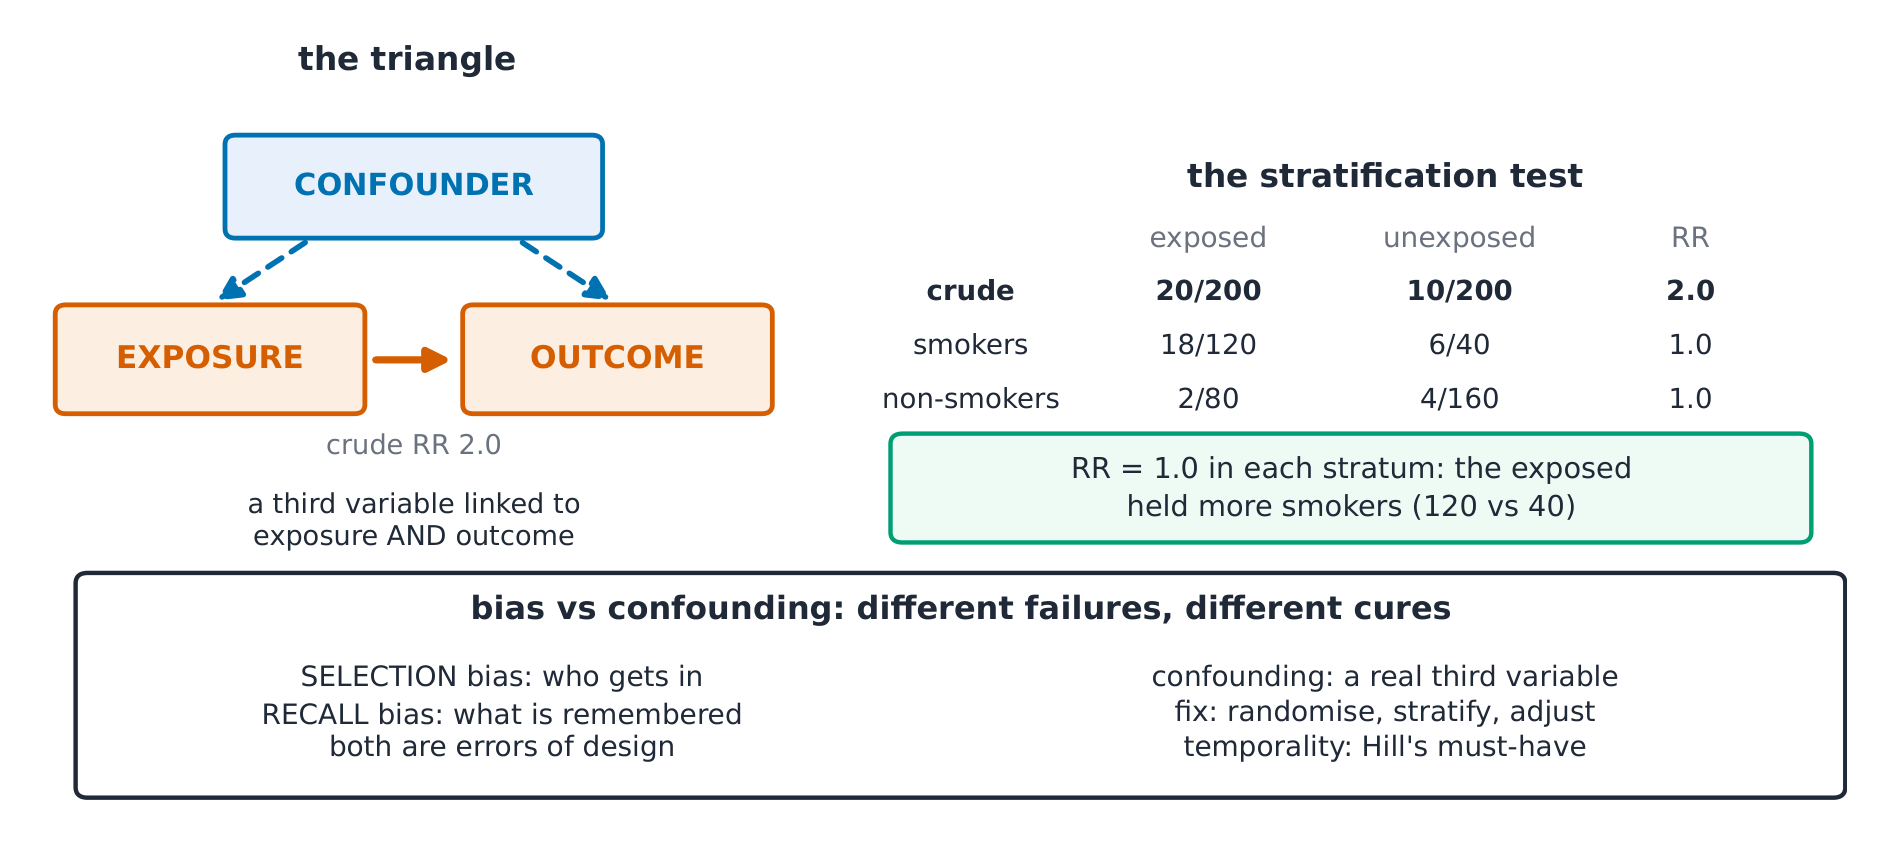
Penurunan logika (mengapa stratifikasi adalah pembuktian). Jika variabel ketiga adalah penggerak sebenarnya, asosiasi harus hilang di dalam strata di mana variabel tersebut konstan: kasar $RR$ 2.0, tetapi di antara perokok tidak $RR$ 1.0 dan di antara perokok $RR$ 1.0 → merokok adalah perancu ✓. Jika asosiasi tetap ada di dalam strata (misalnya 2.0 dan 1.9), paparan mempertahankan sinyalnya sendiri. Randomisasi mencegah perancu secara prospektif dengan menyeimbangkan bahkan faktor yang belum diketahui ✓.
Contoh terarah 1 — tabel bertingkat. (Sintetis) kasar: terpapar 20/200 kejadian vs tidak terpapar 10/200 → RR 2.0. Stratifikasi berdasarkan merokok: perokok tidak 6/100 vs 3/100 (RR 2.0 ✓ di dalam), perokok 14/100 vs 7/100 (RR 2.0) — asosiasi tetap bertahan stratifikasi: merokok BUKANlah confounder here; the exposure's signal stands. Now give the same crude table a different split — exposed: 120 smokers (18 events) and 80 non-smokers (2 events); unexposed: 40 smokers (6 events) and 160 non-perokok 4 % pada keduanya, sehingga RR adalah 15 di dalam setiap stratum: kelompok non-smokers' 2.5 % in both, so RR is 1.0 inside each stratum: the Satu tabel kasar, dua putusan — hanya stratum yang dapat membedakannya. Satu tabel mentah, dua putusan — hanya stratifikasi yang dapat memisahkannya.
Contoh terarah 2 — tautan klinis: pertanyaan penilaian. (Fiksi) mengingat berbeda), dan apa yang dibutuhkan untuk menjadi perancu (terkait dengan kopi DAN dengan hasil akhir, seperti merokok). Pandangan Bradford Hill — temporalitas terlebih dahulu, kemudian kekuatan, konsistensi, hubungan dosis-efek, plausibilitas — mengubah judul utama menjadi daftar periksa ✓. Kesalahan umum. Memperlakukan perancu dan bias pengukuran sebagai satu masalah (perancu adalah pencampuran efek melalui variabel ketiga, diatasi oleh randomisasi, stratifikasi atau penyesuaian; seleksi dan informasi
bias adalah kesalahan tentang siapa yang diteliti dan bagaimana hal-hal diukur, yang tidak ada analisis yang sepenuhnya memperbaiki). masalah (confounding adalah pencampuran efek melalui variabel ketiga, diatasi oleh randomisasi, stratifikasi atau penyesuaian; bias seleksi dan informasi merupakan kesalahan dalam siapa yang diteliti dan bagaimana hal-hal diukur, yang tidak analisis mana pun dapat memperbaiki sepenuhnya). Mengharapkan data besar dapat mengatasi bias pengacau (lebih presisi di sekitar estimasi yang bias). Menuntut setiap pandangan Hill (mereka adalah pandangan, bukan skor; temporalitas adalah satu-satunya yang tidak bisa ditawar). Ringkasan. Bias = kesalahan sistematis (seleksi, informasi/ingatan); faktor pengacau = variabel ketiga pada kedua jalur; uji stratifikasi runtuh jika terpengaruh; randomisasi menyeimbangkan hal-hal yang tidak diketahui; pandangan Hill dengan temporalitas sebagai prioritas.
Ringkasan. Bias = kesalahan sistematis (seleksi, informasi/ingatan); Mengapa ini penting. Angka tes bukan hanya properti dari tes itu sendiri — sensitivitas dan spesifisitas milik tes, tetapi nilai prediksi milik populasi yang menggunakannya. Kesalahan membaca hal ini adalah kesalahan kuantitatif paling umum dalam penalaran klinis. asosiasi jika terkonfusi; randomisasi menyeimbangkan faktor yang tidak diketahui; Hill's Sensitivitas dan spesifisitas berada di kolom; nilai prediksi berada di baris — prevalensi menentukan lebar baris
Tes diagnostik
Mengapa ini penting. Angka dari sebuah tes bukan hanya sifat tes itu sendiri — sensitivitas dan spesifisitas milik tes, tetapi nilai prediktif milik populasi yang menggunakannya. Kesalahpahaman ini adalah kesalahan kuantitatif terbanyak dalam penalaran klinis.
Gagasan, dengan gambar. Tabel 2×2: sensitivitas = a/(a+c) (sakit, tes positif); spesifisitas = d/(b+d) (sehat, tes negatif); PPV = a/(a+b), NPV = d/(c+d) — dan pohon frekuensi alami menunjukkan mengapa prevalensi menggerakkan nilai prediktif ✓.

Penurunan (mengapa prevalensi mendorong PPV). PPV = $\frac{Se \times P}{Se \times P + (1-Sp)(1-P)}$ ✓. Dengan Se = Sp = 90 %: pada prevalensi 10 %, PPV = $\frac{0.9 \times 0.1}{0.9 \times 0.1 + 0.1 \times 0.9} = 0.5$ ✓ — bahkan untuk Uji yang sangat baik hanyalah seperti melempar koin di klinik dengan prevalensi rendah. Positif palsu skala lengan dengan mayoritas sehat.
Contoh terpecahkan 1 — pohon frekuensi alami (sintetis). 1,000 orang, prevalensi 10 %: 100 sakit → 90 positif sejati, 10 negatif palsu; 900 sehat → 810 negatif sejati, 90 positif palsu ✓. PPV = 90/180 = 50 %; NPV = 810/820 = 98.8 % ✓. Tes yang sama pada prevalensi 1 %: 9 TP vs 99 FP → PPV 9/108 = 8.3 % ✓ — satu pohon, dua dunia.
Contoh terpecahkan 2 — kaitan klinis: rasio likelihood bergerak. $LR+ = Se/(1-Sp) = 0.9/0.1 = 9$ ✓: hasil positif mengalikan odds pra-tes dengan 9 apa pun prevalensi kliniknya. Odds pra-tes 1:9 (10 %) → pasca-tes 9:9 = 1:1 → probabilitas 50 % — PPV yang sama, diturunkan dalam satu baris. Rasio likelihood (LR) adalah bentuk portabel dari tes; nilai prediktif bersifat lokal.
Kesalahan umum. Menyebutkan sensitivitas sebagai "tes ini benar 90 %" (tes ini benar untuk 90 % orang SAKIT — sebutkan siapa). Menerapkan PPV buku teks ke klinik dengan prevalensi berbeda. Membingungkan dua kolom (sensitivitas dibaca ke bawah kolom sakit; spesifisitas ke bawah kolom sehat).
Ringkasan. Se = a/(a+c), Sp = d/(b+d) — sifat tes; PPV/NPV — sifat populasi, berubah seiring prevalensi; pohon frekuensi alami membuatnya terlihat; $LR+ = Se/(1-Sp)$ mengalikan odds secara portabel (0.9/0.1 = 9); 50 % PPV pada 10 % prevalensi meskipun Se = Sp = 90 %.
Inferensi statistik untuk data klinis
Mengapa ini penting. Inferensi adalah cara sampel berbicara tentang populasi — dan salah baca nilai-p dan interval kepercayaan adalah kesalahan khas dari literatur modern.
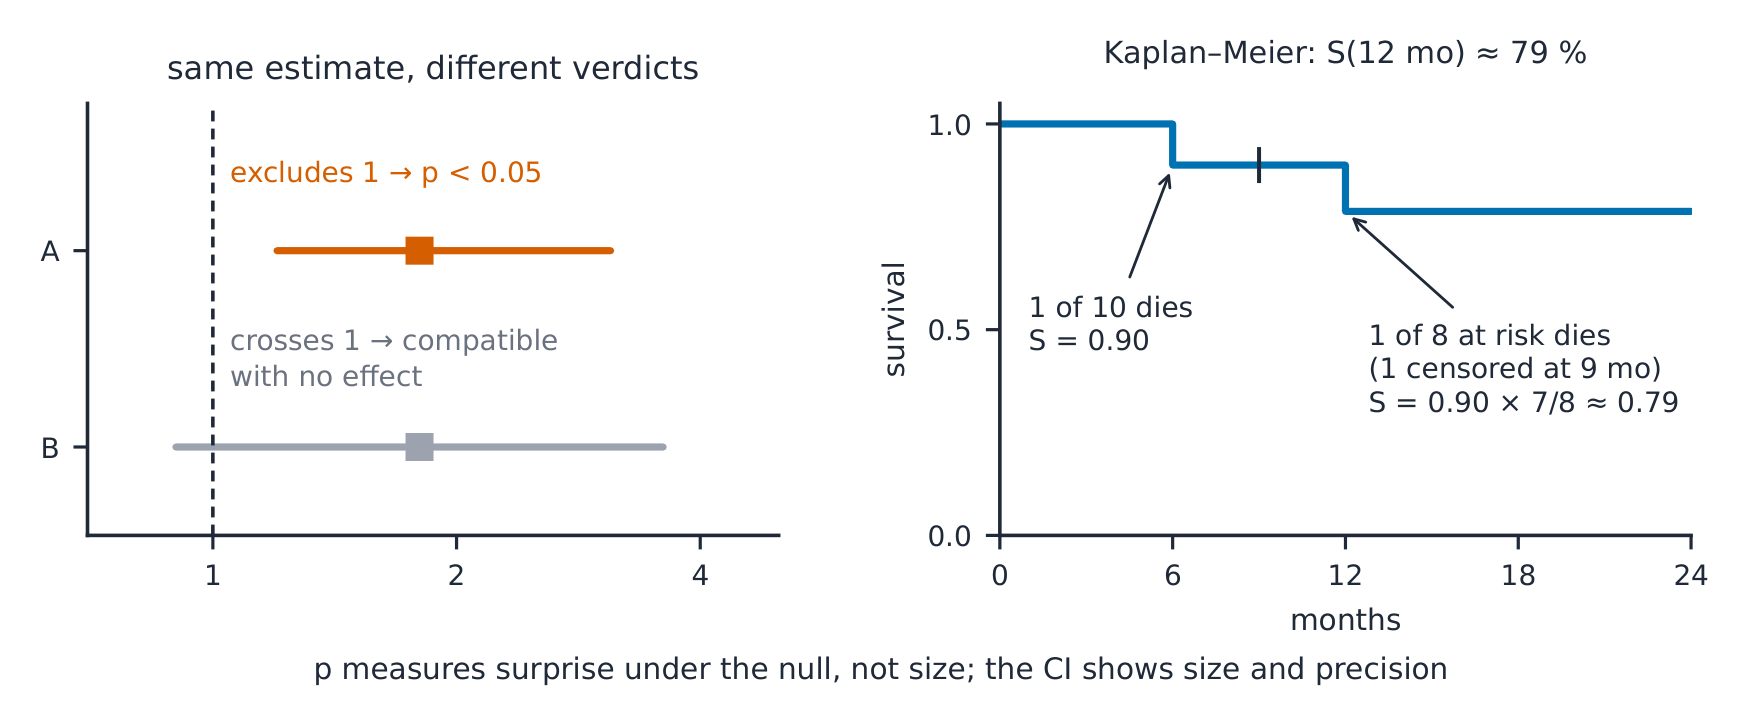
Ideanya, dengan gambar. Sebuah interval kepercayaan 95 % adalah rentang nilai sejati yang konsisten dengan data pada tingkat tersebut; sebuah nilai-p P adalah probabilitas data setidaknya se-ekstrem ini JIKA hipotesis nol berlaku ✓. CI merangkum ukuran dan presisi; nilai-p hanya merangkum kejutan.
Penurunan (mengapa tes mengikuti jenis data). Hitung per kelompok → χ²; dua rata-rata (hampir normal) → uji-t (berpasangan jika setiap baris diukur dua kali); beberapa rata-rata → ANOVA; miring/ukuran-n kecil → peringkat (non-parametrik) alternatif; dua pengukuran kontinu → korelasi (Pearson, atau Spearman untuk peringkat) ✓. Skala pengukuran menentukan tes — memutuskan setelah melihat hasil mengundang pertanyaan yang salah.
Contoh terpecahkan 1 — membaca satu interval. (Abstrak fiksi) RR 1.8, 95 % CI 1.2–3.1: interval mengecualikan 1, sehingga data tidak konsisten dengan "tidak ada efek" pada tingkat ini (p < 0.05 mengikuti); lebarnya menunjukkan estimasi tidak tepat tetapi konsisten di atas 1 ✓. RR 1.8 dengan CI 0.9–3.6 menyatakan sebaliknya — estimasi titik sama, putusan berbeda, dan hanya interval memberitahu Anda.
Contoh terpecahkan 2 — kait klinis: aritmatika Kaplan–Meier. (Sintetis) 10 pasien tercantum; pada bulan ke-6, terjadi 1 peristiwa di antara 10 yang masih berisiko: $S = 9/10 = 0.90$; pada bulan ke-12, terjadi 1 peristiwa di antara 8 yang masih berisiko (satu disensor): $S = 0.90 \times 7/8 = 0.7875$ ≈ 79 % ✓. Median kelangsungan hidup adalah waktu ketika kurva memotong 50 %; sensoring menghapus orang dari penyebut, bukan dari logika estimasi itu sendiri.
Kesalahan umum. "p > 0.05 berarti tidak ada perbedaan" (artinya data kompatibel dengan tidak adanya perbedaan — ketiadaan bukti ≠ bukti ketiadaan). Membaca CI sebagai probabilitas 95 % bahwa nilai sebenarnya berada di dalamnya (interval tersebut merupakan sifat prosedur, diterapkan pada estimasi sampel ini). Memilih uji setelah melihat mana yang menghasilkan p < 0.05.
Ringkasan. CI = kebenaran yang kompatibel, membawa ukuran dan presisi; nilai-p = P(data se-ekstrem ini | nol); jangan pernah "terbukti" atau "tidak ada efek" hanya dari nilai-p; χ²/t/ANOVA/rank/korelasi dipilih berdasarkan jenis data; kurva Kaplan–Meier mengalikan (1 − peristiwa/berisiko); median = persentase 50 yang melintasi.
Uji klinis dan tinjauan sistematis
Mengapa hal ini penting. Uji adalah mesin pembuktian dan tinjauan adalah perakitannya — kosakata (randomisasi, blinding, ITT, NNT) adalah apa yang setiap abstrak dan setiap plot hutan asumsikan Anda ketahui.
Gagasan, dengan gambar. Tulang punggung uji: kelayakan → randomisasi (penugasan secara acak, alokasi tersembunyi) → penyamaran (peserta, klinisiens, penilai hasil) → analisis sesuai niat untuk mengobati (analisis sebagai randomisasi, semua dihitung) ✓. Tinjauan menggabungkan dalam peta hutan: persegi (ukuran = bobot), garis (CI), berlian (gabungan), dan heterogenitas $I^2$ ✓.
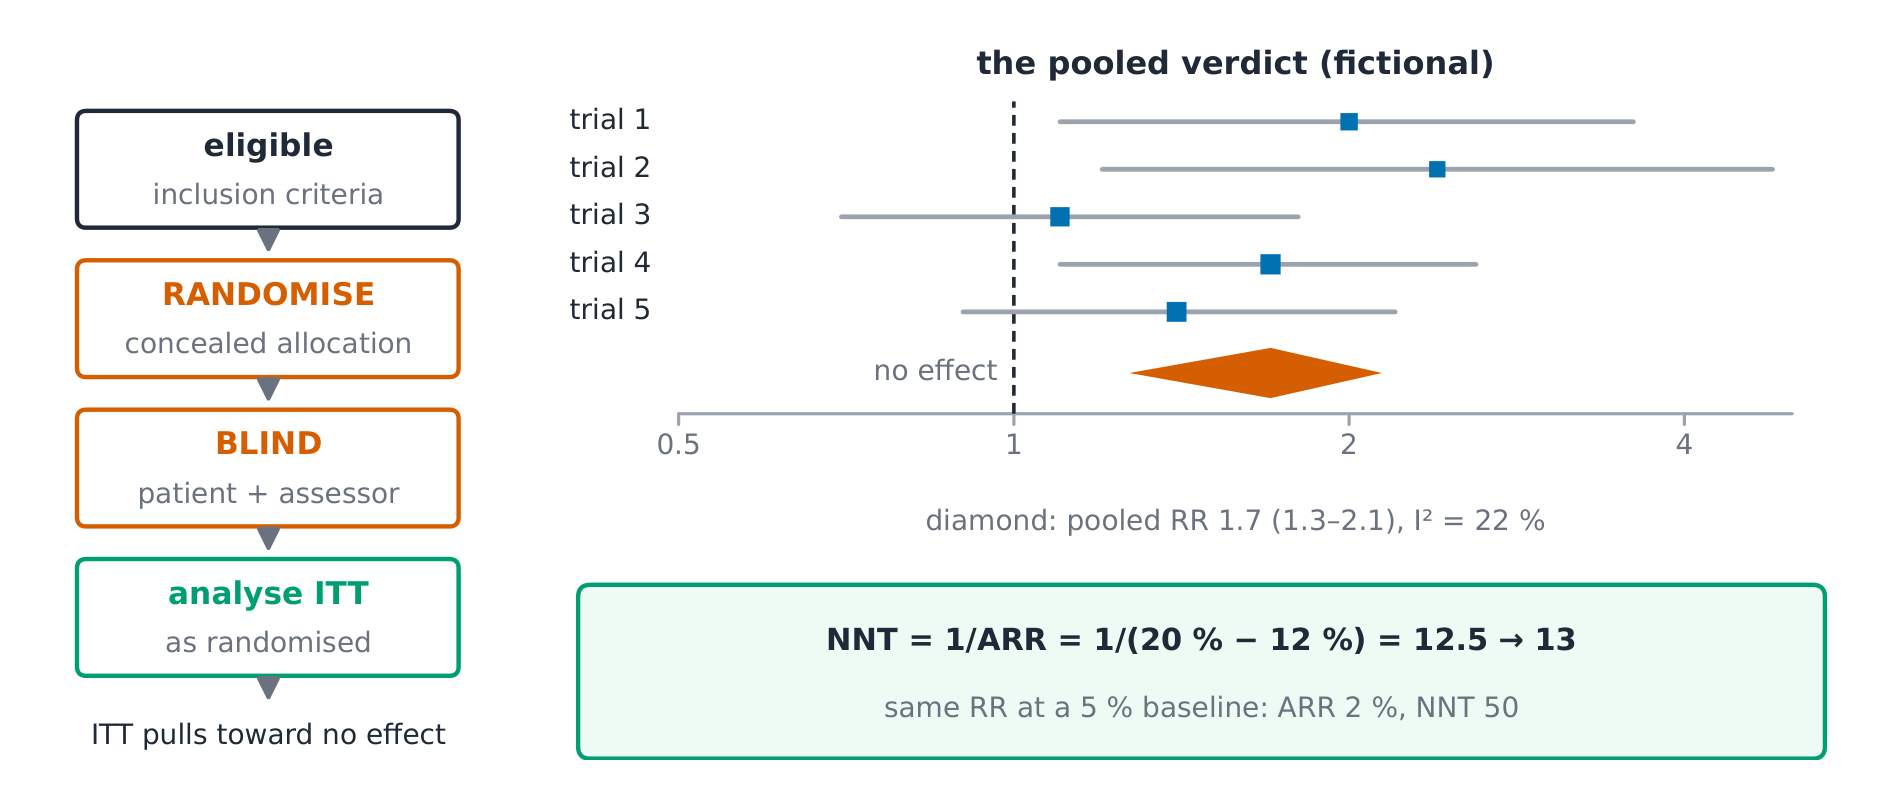
Penurunan (mengapa NNT adalah ukuran klinis efek). NNT = $1/ARR$: tingkat kejadian kontrol 20 %, diobati 12 % → ARR 8 % → NNT = 1/0.08 = 12.5 → 13 orang harus ditangani agar satu orang mendapat manfaat ✓. NNT mengonversi rasio abstrak menjadi beban kerja — dan penyebutnya (ARR) mengecil seiring risiko dasar menurun, yang menyebabkan hasil uji klinis tidak dapat diteruskan ke klinik dengan risiko lebih rendah tanpa perubahan.
Contoh terlatih 1 — logika ITT. (Uji klinis fiksi) 20 % kontrol vs 12 % diobati: ARR 8 %, NNT 13 ✓. Jika 30 % dari kelompok diobati berhenti penugasan mereka lebih awal, ITT tetap menghitung mereka sebagai diobati — mengencerkan efek tampak menuju nol — karena pertanyaannya adalah KEBIJAKAN penugasan, bukan biologi dari pasien taat ✓. Per-protocol menjawab pertanyaan berbeda dan mewarisi bias kepatuhan.
Contoh terlatih 2 — kaitan klinis: membaca berlian. (Fiksi hutan) lima uji klinis, RR individu 1.1–2.4 dengan CI lebar, RR gabungan 1.7 (1.3–2.1), $I^2 = 22\ \%$ ✓: berlian berada tepat di kanan 1 dan intervalnya menyingkirkan 1, dengan heterogenitas rendah — efek yang konsisten di berbagai setting. Berlian yang sama dengan $I^2 = 78\ \%$ akan memicu pertanyaan "mengapa uji coba ini tidak setuju?" sebelum penggabungan apa pun dipercaya.
Kesalahan umum. Menganggap acak sebagai samar (kebetulan menyeimbangkan kelompok; ketiadaan informasi menyeimbangkan harapan — sebuah uji coba dapat memiliki salah satu saja). Membaca analisis per-protokol sebagai analisis jujur (ini melanggar perlindungan acak). Memperlakukan berlian gabungan sebagai kebenaran mutlak meskipun heterogenitasnya tinggi. Ringkasan. Acak (tersembunyi) → samar → analisis sesuai acak (ITT,
Ringkasan. Acak (tersembunyi) → buta → analisis sesuai pengacakan (ITT, dilutes toward null); NNT = 1/ARR (20 % → 12 %: ARR 8 %, NNT 13); forest: kotak berbobot, berlian digabungkan, $I^2$ ketidaksesuaian; klinik dengan baseline rendah mengecilkan ARR dan membesarkan NNT.
Penilaian kritis dan penerapan bukti
validitasnya, ukuran kepentingannya, dan kecocokannya dengan pasien di depan Anda. Unit ini adalah sintesis dari seluruh kursus. Ide tersebut, dengan gambar. Tulang punggung penilaian: PICO (populasi,
intervensi, pembanding, hasil) kerangka kerja → validitas (apakah hasilnya bias?) → ukuran (seberapa besar, seberapa presisi?) → keteraplikasian (apakah pasien saya mirip dengan populasi yang diteliti?) ✓. Penilaian tingkat keyakinan (GRADE): teracak menyerupai populasi yang dipelajari?) ✓. Penilaian ketepatan (GRADE): acak bukti dimulai dari tinggi dan bukti observasional rendah; turunkan tingkatnya karena risiko bias, inkonsistensi, tidak langsung, ketidakpastian atau bias publikasi; naikkan tingkatnya untuk efek besar atau gradien dosis-respons ✓.

Penurunan (mengapa hierarki merupakan prior, bukan vonis). Desain berbeda dalam pengendalian bias TYPICAL-nya: randomisasi menyeimbangkan faktor perancu yang terukur maupun tidak terukur; kohort membawa perancuan; studi kasus-kontrol menambahkan bias ingatan ✓. Namun hierarki memberi peringkat pada kelas desain, sementara vonis menyatu dengan studi yang sedang dibahas — uji kecil, tanpa blinding, yang dianalisis per-protokol mungkin kurang layak dipercaya dibandingkan kohort besar yang telah didaftarkan sebelumnya dengan penyesuaian propensitas. GRADE ada justru karena kelas desain hanyalah titik awal saja.
Contoh terpecahkan 1 — abstrak fiktif dalam lima pertanyaan. (Fiktif) "Randomisasi, double-blind, n = 400; RR 0.75 (0.60–0.94)": validitas — terrandomisasi dan tertutup ✓; ukuran — penurunan relatif 25 %, interval mencakup 1; relevansi lokal — apakah pasien seperti saya direkrut (usia, keparahan, obat penyerta)?; hasil — relevan bagi pasien atau sebagai pengganti?; keyakinan — apakah ada fitur penurunan? Lima pertanyaan, satu vonis terstruktur ✓.
Contoh terpecahkan 2 — tautan klinis: transplantasi NNT. (Fiktif) sebuah uji pada penyakit berat (baseline 20 %, ARR 8 %, NNT 13); pasien saya klinik berjalan pada 5 % dari nilai dasar: dengan penurunan risiko relatif yang sama, ARR diskalakan menjadi $8\ \% \times 5/20 = 2\ \%$ → NNT 50 ✓. Efek relatif mungkin berpindah; beban absolut — beban kerja dan aritmatika manfaat-rugi — bersifat lokal.
Kesalahan umum. Menilai hanya validitas (efek yang valid tetapi sangat kecil tetap tidak berguna: ukuran dan presisi menentukan signifikansi). Penilaian berdasarkan jurnal atau label desain semata (GRADE dimulai di sana dan bergerak bersama kesalahan bukti yang ada). Menerapkan rata-rata kelompok ke pasien yang ciri utamanya adalah kriteria eksklusi.
Ringkasan. PICO → validitas → ukuran → relevansi klinis; GRADE: mulai dari desain, turunkan tingkat kualitas karena bias/konsistensi/indireksi/ketidakpastian, naikkan untuk efek besar; piramida adalah prior, bukan vonis; efek relatif berpindah, manfaat absolut (ARR, NNT) bersifat lokal — hitung ulang sebelum diterapkan.