קודי תווים — ASCII ו-Unicode
הוצג| English | משמעות |
|---|---|
| Unicode/ˈjuːnɪkəʊd/ | יוניקוד |
| character set/ˈkærɪktə set/ | אוסף תווים |
| ASCII/ˈæski/ | ASCII |
| encoding/enˈkəʊdɪŋ/ | המרה |
| code point/kəʊd pɔɪnt/ | נקודת קידוד |
| UTF-8/ˌjuː tiː ˈef eɪt/ | UTF-8 |
האימייל שהגיע כערימות תווים
- דרך ה-1990s, הודעה שהוכנסה בווורשה ונקראה בטוקיו הגיעה לעיתים קרובות כקיר של טקסט חסר משמעות. שני המחשבים אחסנו שמונה ביטים לכל אות. הם פשוט חלקו על המשמעות של הדגמים ב-128 העליונים.
- טבלת הקידוד הפולנית השתמשה במקום הזה לאותיות פולניות. הטבלה היפנית השתמשה בה לאותיות יפניות. לא קרה שום נזק במהלך השידור: הבאייטים הגיעו שלמים ונקראו לפי טבלה שונה.
- הפתרון היה להפסיק להשתמש בטבלות נפרדות לכל מדינה ולספק כל אות בכל מערכת כתב מספר יחיד, לנצח. זו יוניקוד, ולפיכך האמוג'י שאתה שולח מגיע כאותו תמונה.
- שיעור זה מסביר איך טקסט הופך למספרים: מערכות קידוד אותיות, ASCII, יוניקוד, והקידודים שאוחסנים אותם.
מערכת קידוד אותיות מעניקה כל אות מספר
- מחשב אינו אוסף אותיות, רק מספרים. מערכת קידוד אותיות היא קבוצת האותיות שמחשב יכול לייצג, כאשר לכל אות יש קוד בינארי משלו.
- המספר המיועד לאות אחת הוא נקודת הקידוד שלה.
Aהיא 65,aהיא 97, ו0הספרה היא 48. - נקודת הקידוד אינה משמעות האות; היא תווית הסכמה. הטקסט קריא רק מכיוון ששני המחשבים משתמשים באותה מערכת קידוד אותיות.
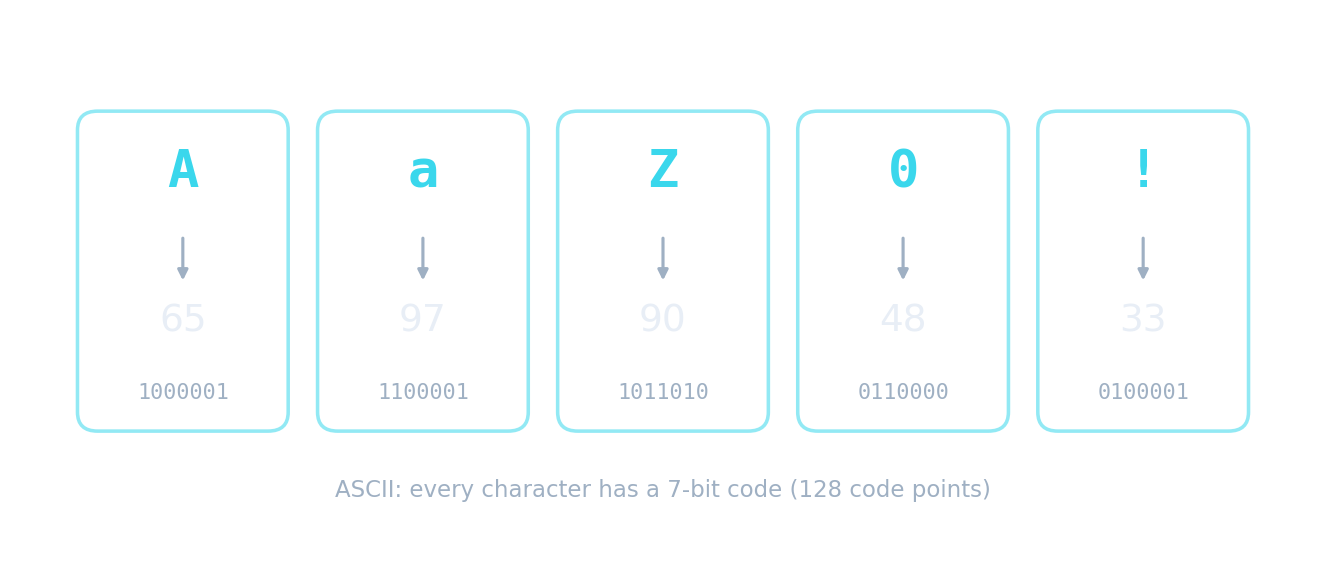
האות היא התמונה; הבאייט הוא המספר
תוויון מאוחסן כמספר
לכל תוויון יש מספר זיהוי; ל-⟦'A'⟧ זהו 65. הפוך ביטים כדי לראות את הקוד הזה בצורה בינארית וברמזית, בדיוק כפי שהמחשב שומר אותו.
סט תוויונים כמו ASCII מגדיר:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
קבוצת תווים מקשרת כל תווה למספר (נקודת הקוד שלו), שהיא מה שמחשב באמת שומר.
ASCII
- ASCII (הקוד האמריקאי הסטנדרטי להחלפת מידע) משתמש ב-7 ביטים, מה שמספק $2^7 = 128$ נקודות קוד: האותיות הלטיניות הבסיסיות, המספרים, הניקוד ו-32 פקודות בקרה כמו החזרת גלגלת.
- Extended ASCII (אסקי מורחב) משתמש ב-8 ביטים, מה שמספק 256 נקודות קוד. ה-128 התחתונים זהים ל-ASCII; ה-128 העליונים משתנים לפי אזור, בדיוק הדבר שגרם לקריסת האימייל הזה.
- לעולם לא נתבקש לשנן קוד, אך נתבקש לתת את המספרים: 7 ביטים, 128; 8 ביטים, 256.
כמה נקודות קוד שונות יש ל-ASCII בעל 7 ביטים?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
7 ביטים מספקים $2^7 = 128$ נקודות קוד.
כמה נקודות קוד שונות יש ל-Extended ASCII?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
שמונה ביטים נותנים 2^8 = 256. ה128 ביטים התחתונים תואמים ASCII רגיל ב-7 ביטים; ה128 ביטים העליונים משתנים לפי אזור.
Unicode
- Unicode הוא סט דמויות אוניברסלי: נקודת קוד אחת לכל כמעט כל דמות בכל כתב חי או מת, בנוסף לסמלים ואימוג'י, מעל 149,000 מהם.
- נקודת הקוד נפרדת מאופן האחסון שלה. Encoding (הכנה/אניקודינג) ממיר נקודת קוד לבתי-ביט.
- UTF-8: UTF-8 משתמש ב-1 עד 4 בייטים לדמות והוא תואם ASCII: ה-128 נקודות הקוד הראשונות הן בייט אחד, זהות ל-ASCII. UTF-16 משתמש ב-2 או 4 בייטים; UTF-32 משתמש ב-4 קבועים.
מה נכון לגבי UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
UTF-8 הוא קידוד Unicode באורך משתנה (1–4 בתים); ה-128 נקודות הקוד הראשונות שלו תואמות ל-ASCII, ולכן טקסט ASCII רגיל הוא קידוד UTF-8 תקף.
מהי הקשר בין Unicode ל-UTF-8?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
קבוצת התווים מייחסת את המספרים; הקידוד מחליט כמה בתים לוקח כל מספר. UTF-16 ו-UTF-32 הן קידודים אחרים של אותה קבוצת תווים.
דוגמה פותרת: השוואת ASCII ל-Unicode
- תן יתרון אחד והפרעה אחת בשימוש ב-Unicode במקום ASCII. [2]
- יתרון: Unicode מייצג הרבה יותר דמויות, כך הטקסט בכל כתב, סינית, ערבית, יוונית ואימוג'י יכול להיות מאוחסן, ומסמך אחד יכול לערבב שפות; הקבצים ניידים מכיוון שאין צורך בהתאמת עמודת קודs לאומית שתסכן על אי-הסכמה.
- הפרעה: עבור טקסט באנגלית בלבד, קובץ Unicode הוא בדרך כלל גדול יותר, מכיוון שדמות עשויה לקחת יותר מבייט אחד.
- יש להציג את שני החלקים. "יש לו יותר דמויות" לבדו נותן נקודה אחת מבין שתיים.
יתרון עיקרי של Unicode על פני ASCII הוא שהוא:
Difficulty 1/5 · 100 coins + a small bonus on first completion today
יוניקוד מכסה כמעט כל מערכת כתב, בנוסף לסמלים ואמוג'י — הרבה מעבר לערכה הבסיסית של אנגלית באסקי.
לטקסט באנגלית בלבד, קובץ יוניקוד הוא לרוב גדול יותר מאותו טקסט באסקי.
Difficulty 1/5 · 100 coins + a small bonus on first completion today
תצפיות יוניקוד יכולות להשתמש בכמות גדולה יותר של בתים לתווית, ולכן טקסט באנגלית רגיל הוא לרוב גדול יותר מאשר באסקי 7-ביט — העלות ששולם עבור כיסוי אוניברסלי.
מהן היתרונות של יוניקוד על פני אסקי? סמן את כולם החלים.
Difficulty 2/5 · 140 coins + a small bonus on first completion today
גודל הוא העלות, לא יתרון: עבור אנגלית רגילה קובץ יוניקוד הוא לרוב גדול יותר.
דוגמה פותרת: גודל של קובץ טקסט
- הודעה של 500 דמויות מאוחסנת ב-Extended ASCII. כמה גדול הקובץ בבייטים?
- Extended ASCII משתמש ב-8 ביטים, בייט אחד, לכל דמות, ולכן $500 \times 1 = 500$ בייטים, או $500 \times 8 = 4000$ ביטים.
- אותה הודעה ב-UTF-32? ארבעה בייטים לכל דמות, כלומר 2000 בייטים.
- הצג את הביטים לכל דמות, כפל, ולאחר מכן המרה פעם אחת. ערבוב בין ביטים לבייטים באמצע הדרך הוא המקור הנפוץ לאובדן נקודות.
הודעה בעלת 500 אותות מאוחזת ב-extended ASCII. כמה בייטים היא דורשת (בלתי לבדוק ראשי עמודה)?
Difficulty 2/5 · 140 coins + a small bonus on first completion today
שמונה ביטים, בייט אחד לכל אות: 500 x 1 = 500 בייטים, או 4000 ביטים. באנקודिंग UTF-32 הטקסט אותו דורש 2000 בייטים.
קריאת דמות בבנרי ובאקסאדצימלי
- מכיוון שנקודת קוד היא פשוט מספר, היא מומרת כמו כל מספר אחר.
Aהוא 65, שהוא0100 0001בבנרי ו-41באקסאדצימלי. - שני דפוסים שימושיים: הספרות
0עד9מתחילות ב-48, ואותיות קטנות נמצאות ב-32 מעל האותיות הגדולות, ולכןa(97) הואA(65) פלוס 32. ההפרש הזה הוא ביט בודד. - שאלה הנתונה לך בה
A= 65 ושואלת עלEרוצה את $65 + 4 = 69$, ולא טבלת שינון.
קוד ה-ASCII עבור A הוא 65. מהו קוד ה-ASCII עבור E?
Difficulty 1/5 · 100 coins + a small bonus on first completion today
האותיות הן ברצף, לכן E היא ארבע אחרי A. אין צורך לזכור דבר מעבר לערך בסיס אחד.
סימונים נופלים מהיד
- ASCII היא 7 ביטים ו-128 נקודות קוד; ASCII מורחבת היא 8 ביטים ו-256. אל תכתוב 8 ביטים עבור ASCII רגילה.
- Unicode היא סט סימנים; UTF-8 היא קידוד שלה. הן אינן שני סטים מתחרים.
- UTF-8 הוא באורך משתנה, 1 עד 4 בייטים, לא תמיד בייט אחד ולא תמיד ארבעה.
- החיסרון של Unicode הוא גודל הקובץ בטקסט אנגלי רגיל, לא "זה איטי יותר" או "זה קשה לקרוא".
הבנתך מושלמת
- סט סימנים נותן לכל אות נקודת קוד; טקסט הוא מספרים plus הסכמה על איך לקרוא אותם
- ASCII: 7 ביטים, 128 נקודות קוד, אנגלית בלבד · ASCII מורחבת: 8 ביטים, 256, החצי העליון משתנה לפי אזור
- Unicode: נקודת קוד אחת לכל כתב ואמוजी, מאוחסן על ידי קידוד; UTF-8 הוא 1 עד 4 בייטים ותואם ASCII
- Unicode מוסיף סימנים, ניידות ושילוט לשון; זה עולה בגודל קובץ בטקסט אנגלי רגיל