Perspectives historiques et interprétation psychométrique
Introduit| English | Sens |
|---|---|
| base rates/beɪs reɪts/ | Taux de base |
| structuralism/ˈstrʌktʃərəlɪzəm/ | structuralisme |
| percentile/pəˈsentaɪl/ | Percentile |
Un taux élevé de détection peut tromper
- Un test fictif signale 9 personne sur 10 ayant une condition. Pourtant, la plupart des personnes signalées ne l'ont pas. L'information manquante est la fréquence avec laquelle il signale d'autres personnes et la prévalence de la condition.
- Les questions sur l'histoire et la mesure du GRE nécessitent des concepts précis et des comparaisons soignées. Nous relierons les perspectives psychologiques à l'interprétation des scores et aux taux de base : la fréquence avec laquelle une condition ou une catégorie se manifeste dans la population considérée.
Premiers laboratoires et écoles
- Wundt a établi son laboratoire de psychologie expérimentale à Leipzig en 1879. Son approche comprenait l'organisation active de l'expérience. Le structuralisme est particulièrement associé à l'analyse ultérieure de Titchener de l'expérience consciente en éléments ; ne pas traiter le jalon du laboratoire et cette école comme identiques.
- Le fonctionnalisme, associé à William James et d'autres, s'est interrogé sur ce que font les processus mentaux et comment ils soutiennent l'adaptation. Les questions structuralistes et fonctionnalistes soulignent des objectifs différents, mais une brève étiquette d'école ne peut capturer tout le travail d'un chercheur.
Comparaison worked. « Décrire les qualités fondamentales d'une expérience de couleur » correspond à l'accent structuraliste. « Comment l'attention aide-t-elle quelqu'un à répondre à une tâche changeante ? » correspond à l'accent fonctionnaliste. Choisissez selon la question posée, puis utilisez les noms comme indices de soutien.
Match each school with a key figure.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Titchener is especially associated with structuralism; James with functionalism; Watson with behaviourism; Wertheimer with Gestalt psychology. Wundt’s 1879 laboratory is a related milestone, not an interchangeable attribution.
Wundt’s 1879 laboratory and Titchener’s structuralist programme are interchangeable historical labels.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Distinguish the laboratory milestone from the later school and its particular aims.
Perspectives ultérieures posent des questions différentes
- Le programme behavioriste de Watson 1913 a mis l'accent sur l'étude objective du comportement ; Skinner a ensuite analysé le comportement opérant et ses conséquences. La psychologie gestaltienne, associée à Wertheimer et ses collègues, a mis l'accent sur la façon dont l'organisation d'un tout façonne l'expérience de ses parties.
- L'approche psychanalytique de Freud a insisté sur les processus inconscients et les conflits ; Maslow et Rogers sont associés aux accents humanistes sur la croissance et l'expérience personnelle. Les approches cognitives étudient les processus mentaux tels que la mémoire et le langage. La critique 1959 de Chomsky envers Skinner était une contribution à un changement plus large, et non un événement unique qui a remplacé toute la recherche behavioriste.
A study asks how rewards following an action change its future frequency. Which emphasis is closest?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
The question concerns behaviour and its consequences. Classify the research question rather than relying only on a researcher’s name.
Décider avec quoi le score est comparé
- Une interprétation norm-référencée compare un score à un groupe de référence spécifié. Une interprétation critère-référencée compare la performance à une norme définie. Le même instrument peut soutenir les deux types d'affirmations si des preuves justifient chaque interprétation.
- L'administration et la notation standardisées aident à contrôler la variation indésirable. Elles n'établissent pas seules une signification comparable entre populations, un accès équitable ou une adaptation à tous les usages. Demandez qui a fourni les normes, quand elles ont été collectées et si elles correspondent à la comparaison proposée.
Quelle comparaison est mentionnée ?
Classifiez les interprétations des scores.
Which score is criterion-referenced?
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Meeting a defined performance standard is a criterion comparison. Rank and percentile statements compare with people in a specified group.
Un score standard n'est pas automatiquement un percentile
- Un score z décrit la distance par rapport à une moyenne de référence en écarts-types : $z=(X-M)/S$. Un score de 115 avec une moyenne de 100 et un écart-type de 15 donne $z=(115-100)/15=1$. La moyenne et l'écart-type seuls ne déterminent pas son percentile.
- Si la distribution de référence est approximativement normale, $z=1$ correspond au environ 84e percentile. Avec des normes empiriques, utilisez le tableau de percentiles pertinent et sa convention pour les ex æquo. Un percentile est une position relative, et non le pourcentage de questions répondues correctement.
Interprétation illustrée. Supposons qu'une échelle de référence normalement distribuée ait une moyenne de 50 et un écart-type de 10. Un score de 40 donne $z=(40-50)/10=-1$, soit environ le 16e percentile. Sans l'hypothèse d'une distribution normale ou sans tableau de normes empiriques, le percentile n'est pas identifié par ce calcul.
On an approximately normal reference scale with mean 100 and SD 15, a score of 115 is at roughly which percentile?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
z = (115 − 100)/15 = 1. With the stated normal approximation, about 84% of the reference distribution lies below that score. Mean and SD alone would not determine a percentile.
A mean of 100 and SD of 15, without a distribution or percentile table, prove that 115 is at the 84th percentile.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
The mean and SD locate a score in standard-deviation units. The percentile additionally needs the distribution or appropriate empirical norms.
Gardez séparés les dénominateurs du dépistage
- La sensibilité est la proportion signalée parmi les personnes ayant la condition. La spécificité est la proportion non signalée parmi celles qui ne l'ont pas. Le taux de faux positifs est égal à un moins la spécificité.
- La valeur prédictive positive (VPP) pose une question différente : parmi toutes les personnes signalées, quelle proportion a la condition ? Pour ces exemples pédagogiques, supposons que le statut de la condition est connu indépendamment et que les taux de test sont spécifiés pour la population déclarée.
Comptes illustrés. Sur 1,000 personnes, 10 ont une condition et 990 ne l'ont pas. Le test signale 9 sur les 10 et 99 sur les 990. La sensibilité est $9/10=90\%$ ; la spécificité est $891/990=90\%$. Les 99 faux positifs appartiennent au dénominateur de la VPP, et non à celui de la sensibilité.
Of 900 people independently known not to have a condition, 810 are not flagged. What is specificity as a percentage?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Specificity = true negatives/all non-cases = 810/900 = 0.90, or 90%.
Utilisez tous les résultats positifs pour calculer la VPP
- Le même exemple fictif présente 108 résultats positifs : 9 vrais positifs plus 99 faux positifs. Ainsi $\mathrm{PPV}=9/(9+99)=9/108\approx0.0833$, soit environ 8.3%. La plupart des personnes signalées n'ont pas la condition, bien que la sensibilité soit élevée.
- Un résultat négatif est une question différente, avec un dénominateur différent. Ici, il y a 892 résultats négatifs : 891 vrais négatifs et un cas manqué. Ni un résultat positif ni négatif n'est équivalent à une certitude concernant un individu.
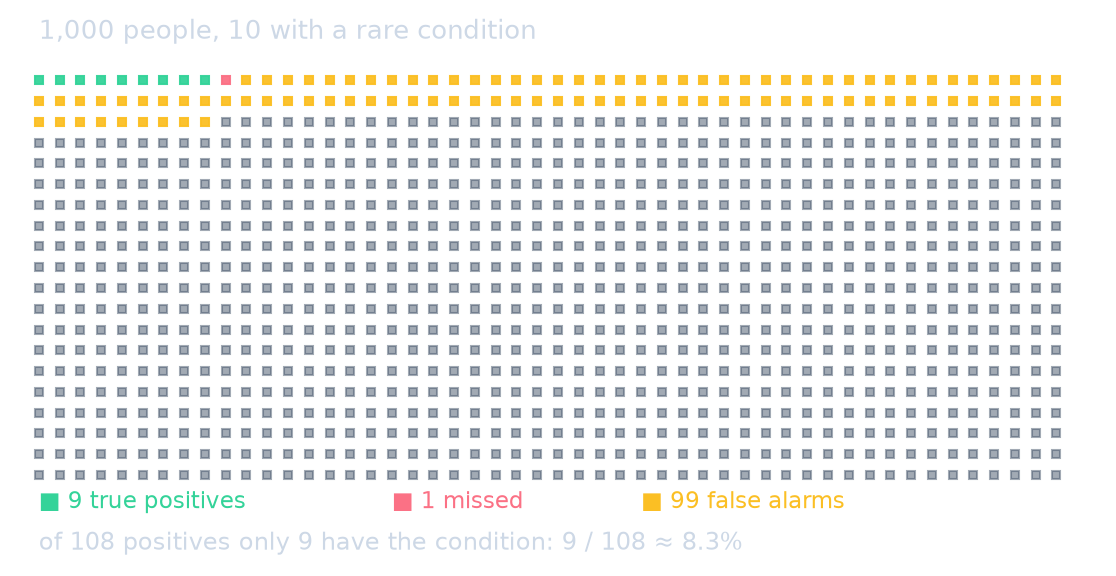
Comptes fictifs avec statut de condition connu indépendamment ; un exemple de méthode de dépistage plutôt qu'une recommandation clinique.
Modifiez le taux de base, maintenez les taux de test fixes
- Dans une autre population fictive de 1,000, 100 ont la condition. En maintenant la sensibilité et la spécificité à 90%, on obtient 90 vrais positifs et 90 faux positifs, soit $\mathrm{PPV}=90/(90+90)=50\%$. Le taux de base modifié change la VPP.
- Cette comparaison suppose que les mêmes taux de test s'appliquent dans les deux populations. En pratique, les différences de population et la manière dont un test est utilisé peuvent également modifier la sensibilité ou la spécificité. Le taux de base, la sensibilité et la spécificité comptent tous.

Les deux populations contiennent 1,000 personnes. La comparaison maintient la sensibilité et la spécificité à 90% ; elle ne prétend pas que ces taux se transfèrent automatiquement aux populations réelles.
In a fictional population of 1,000, the condition prevalence is 5%, sensitivity is 80% and the false-positive rate is 5%. Using expected counts, what proportion of positive results are true positives (three decimal places)?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Expected true positives = 0.8 × 50 = 40; expected false positives = 0.05 × 950 = 47.5. Fractional expected counts describe a model, not half a person observed. PPV = 40/(40 + 47.5) ≈ 0.457.
A fictional test population contains 100 cases and 900 non-cases. Sensitivity is 80% and specificity is 90%. Using these counts, what is PPV as a proportion, to three decimal places?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
True positives = 80; false positives = 0.10 × 900 = 90. PPV = 80/(80 + 90) ≈ 0.471. Sensitivity uses a different denominator.
L'erreur de mesure nécessite un modèle
- Dans la théorie classique des tests, un score observé combine un score vrai et une erreur de mesure pour des mesures répétées spécifiées. Le score vrai est le score attendu sur ces mesures, et non une mesure parfaite de toutes les capacités d'une personne.
- L'erreur standard de mesure (ESM) synthétique décrit l'écart type des erreurs de mesure sur l'échelle des scores. Il peut servir à définir un intervalle d'incertitude sous certaines hypothèses supplémentaires ; il ne constitue pas en lui-même un intervalle ni une erreur maximale possible. Pour un écart type de score fixe, une fiabilité pertinente plus faible entraîne une ESM classique plus grande.
Calcul illustré. Si une échelle de scores a un écart type 10 et une fiabilité pertinente $r=0.84$, la formule synthétique donne $\mathrm{SEM}=S\sqrt{1-r}=10\sqrt{0.16}=4$ points de score. Il s'agit d'une incertitude de mesure, et non de l'erreur standard d'une moyenne d'échantillon. Cela ne garantit pas que toutes les erreurs se situent dans une fourchette de quatre points.
Using the classical summary SEM formula with score SD 15 and relevant reliability 0.84, what is SEM in score points?
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
SEM = 15 × √(1 − 0.84) = 15 × 0.4 = 6 score points. This is not an interval width or a bound on every error.
SEM = 4 guarantees that no measurement error exceeds four score points.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
SEM is a standard deviation under the measurement model. Errors can exceed one SEM; interval claims require additional assumptions.
Fiabilité, validité et équité nécessitent des preuves distinctes
- La fiabilité concerne la cohérence ou la précision lors de reproductions spécifiées. La validité concerne les preuves étayant une interprétation et une utilisation proposées du score. Un score précis peut encore conduire à une conclusion erronée ; un seul coefficient de fiabilité ne peut valider une règle de sélection ni établir l'équité.
- Examinez l'utilisation prévue, le groupe de référence, le contenu, l'accessibilité et les preuves de biais. Deux personnes ayant le même score ne possèdent pas nécessairement des forces identiques, et un percentile de groupe de référence ne signifie pas par lui-même si l'un ou l'autre atteint une norme de performance.
Critique illustrée. Une école affirme : « Notre quiz est fiable, donc ses 10% meilleurs sont prêts pour un cours. » Les 10% supérieurs décrivent une comparaison normative. La préparation nécessite des preuves reliant la performance aux exigences du cours ainsi qu'une norme justifiée ; la fiabilité seule ne fournit pas ce lien.
High reliability alone is insufficient evidence for every proposed interpretation or use of a score.
Difficulté 1/5 · 100 pièces + un petit bonus lors de la première réussite aujourd'hui
Consistency or precision under specified replications does not establish that an intended interpretation, decision or fairness claim is supported.
A training test reports both a 70th percentile in a local reference group and successful completion of every required safety procedure. Identify the two comparison types and explain why the percentile alone cannot establish readiness.
Le percentile 70 est normalisé par référence à un groupe spécifié. L'achèvement des procédures de sécurité requises est normé par critère. Le percentile concerne la position relative, et non la maîtrise des procédures ; la préparation nécessite des preuves pertinentes et un standard justifié. Les deux interprétations peuvent être rapportées pour une même évaluation si elles sont soutenues.
Résumé
- Associez une perspective à sa question et sa méthode, ainsi qu'à une figure historique.
- Distuez entre normes, standards, scores normalisés et percentiles.
- Sensibilité, spécificité et valeur prédictive positive dépendent de groupes différents.
- La VPP change avec le taux de base lorsque les taux de test restent fixes.
- Considérez l'ESM comme un écart type basé sur un modèle et examinez les preuves relatives à l'utilisation prévue du score.
- taux de base : Fréquence d'une condition ou d'une catégorie dans la population spécifiée.
- structuralisme : École associée à l'analyse de l'expérience consciente en éléments fondamentaux.
- percentile : Position relative d'un score dans une distribution de référence spécifiée.
A company says: “Our test has 90% sensitivity, so any positive applicant has a 90% chance of belonging to the target category. Its high reliability also proves that rejecting every positive is fair.” Identify two distinct gaps and name relevant additional evidence.
La sensibilité porte sur les personnes de la catégorie cible ; le VPP porte sur les résultats positifs. Estimer le VPP nécessite le taux de prévalence de la catégorie et le taux de faux positifs, avec des preuves que ces taux s'appliquent à la population des candidats. La fiabilité n'établit pas une interprétation justifiée, un seuil de décision ou l'équité. La règle de rejet proposée nécessite des preuves concernant la pertinence au travail, les erreurs et les conséquences, l'accessibilité et les biais possibles.