RISC, CISC and pipelining · RISC, CISC et pipelinage
| English | Français |
|---|---|
| CISC/sɪsk/ | CISC |
| RISC/rɪsk/ | RISC |
| pipelining/ˈpaɪplaɪnɪŋ/ | pipelining |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Taxonomie de Flynn |
| register/ˈredʒɪstə/ | registre |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | danger |
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | massivement parallèle |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | superordinateurs |
The phone in your pocket does not run Intel
- For thirty years the fastest processors were the most complicated ones: add instructions, and each one does more work. Intel built an empire on it.
- Then a small British company put a deliberately simple processor in a phone. Fewer instructions, all the same length, almost none touching memory. It could not do as much per instruction, and it won anyway.
- It won because simple, uniform instructions can be overlapped, and overlapping is worth more than complexity.
- This lesson is CISC 复杂指令集 and RISC 精简指令集, pipelining 流水线, the four architectures of Flynn's taxonomy, and where a processor's heat and speed limits lead.
Le téléphone dans votre poche ne fonctionne pas sur Intel
- Pendant trente ans, les processeurs les plus rapides étaient aussi les plus complexes : ajouter des instructions, et chacune faisait plus de travail. Intel a bâti un empire là-dessus.
- Puis une petite entreprise britannique a intégré un processeur délibérément simple dans un téléphone. Moins d'instructions, toutes de longueur fixe, presque aucune interaction avec la mémoire. Elle ne pouvait pas faire autant par instruction, et elle a quand même gagné.
- Elle a gagné parce que les instructions simples et uniformes peuvent être chevauchées, et le chevauchement vaut plus que la complexité.
- Cette leçon porte sur CISC 复杂指令集 (ensemble d'instructions complexe) et RISC 精简指令集 (ensemble d'instructions réduit), pipelining 流水线 ( Pipeline / découpage en pipeline), les quatre architectures de la taxonomie de Flynn, et où mènent les limites thermiques et de vitesse d'un processeur.
CISC and RISC
- A CISC, Complex Instruction Set Computer, has many, often complex instructions: one may perform several memory accesses and operations. They are of variable length, so decoding is intricate. It does more per instruction, in hardware. Example: Intel x86.
- A RISC, Reduced Instruction Set Computer, has a small set of simple instructions, each doing one basic operation, all of fixed length and quick to decode. Only load and store touch memory; everything else is register 寄存器 to register. Example: ARM.
- RISC programs are longer, but each instruction is quick and predictable, which is exactly what a pipeline needs.
More per instruction, or faster and more predictable per instruction
CISC et RISC
- Un CISC, Complex Instruction Set Computer (ordinateur à ensemble d'instructions complexe), possède beaucoup d'instructions souvent complexes : l'une peut effectuer plusieurs accès mémoire et opérations. Elles sont de longueur variable, donc le décodage est complexe. Il fait plus par instruction, en matériel. Exemple : Intel x86.
- Un RISC, Reduced Instruction Set Computer (ordinateur à ensemble d'instructions réduit), possède un petit ensemble d'instructions simples, chacune effectuant une opération de base, toutes de longueur fixe et rapides à décoder. Seuls load (charger) et store (stocker) accèdent à la mémoire ; tout le reste est register 寄存器 (registre) vers registre. Exemple : ARM.
- Les programmes RISC sont plus longs, mais chaque instruction est rapide et prévisible, ce qui est exactement ce dont a besoin un pipeline.

Plus par instruction, ou plus vite et plus prévisible par instruction
A RISC processor is characterised by: · Un processeur RISC se caractérise par :
RISC keeps instructions few, simple and fixed-length (usually 1 cycle); CISC has many complex variable-length ones. · RISC garde les instructions peu nombreuses, simples et de longueur fixe (généralement 1 cycle) ; CISC en a beaucoup de complexes et de longueurs variables.
The differences the exam wants
| Feature | CISC | RISC |
|---|---|---|
| instruction set | many, complex | few, simple |
| instruction length | variable | fixed |
| memory access | many instructions may access memory | only load and store |
| registers | fewer | many |
| cycles per instruction | varies | usually one |
| pipelining | harder | natural |
- Modern Intel chips translate their CISC instructions into simpler RISC-like micro-operations internally, which is the clearest evidence of which design won the argument.
Les différences que l'examen veut
| Fonctionnalité | CISC | RISC |
|---|---|---|
| ensemble d'instructions | nombreux, complexes | rares, simples |
| longueur d'instruction | variable | fixe |
| accès mémoire | de nombreuses instructions peuvent accéder à la mémoire | seulement load et store |
| registres | moins | beaucoup |
| cycles par instruction | variable | généralement un |
| pipeline | difficile | naturel |
- Les puces Intel modernes traduisent leurs instructions CISC en micro-opérations RISC-like plus simples en interne, ce qui est la preuve la plus claire de quel design a remporté le débat.
Match each term to its description. · Associez chaque terme à sa description.
RISC = simple + fixed-length + load/store; CISC = complex + variable-length; pipelining overlaps stages for speed. · RISC = simple + longueur fixe + load/store ; CISC = complexe + longueur variable ; le pipelinage chevauche les stades pour la vitesse.
In a RISC processor, the only instructions that access memory are load and ____. · Dans un processeur RISC, les seules instructions qui accèdent à la mémoire sont le load et le ____.
Everything else is register to register. That restriction is what makes instructions fixed-length, uniform in timing and easy to pipeline. · Tout le reste est registre à registre. Cette restriction est ce qui rend les instructions de longueur fixe, uniformes dans le temps et faciles à pipeline.
Pipelining
- A pipeline processes instructions in overlapping stages, like an assembly line: fetch, decode, execute in the ALU 算术逻辑单元, memory access, write back.
- Each stage works on a different instruction at the same time, so once the pipeline is full, one instruction completes per cycle.
- It does not make any single instruction faster. It increases throughput: more instructions finish per second.
- RISC's fixed-length, simple instructions make every stage take the same time, which is why RISC pipelines cleanly and CISC does not.
Six instructions in flight, one finishing each cycle
Pipelining
- Un pipeline traite les instructions en étapes chevauchantes, comme une chaîne d'assemblage : fetch (récupération), decode (décodeur), execute (exécution dans l'ALU 算术逻辑单元 (unité arithmétique logique)), memory access (accès mémoire), write back (écriture arrière).
- Chaque étape travaille sur une instruction différente en même temps, donc une fois le pipeline plein, une instruction se termine par cycle.
- Il ne rend aucune instruction individuelle plus rapide. Il augmente le débit : plus d'instructions se terminent par seconde.
- Les instructions fixes et simples de RISC font que chaque étape prend le même temps, pourquoi les pipelines RISC fonctionnent proprement et ceux de CISC non.
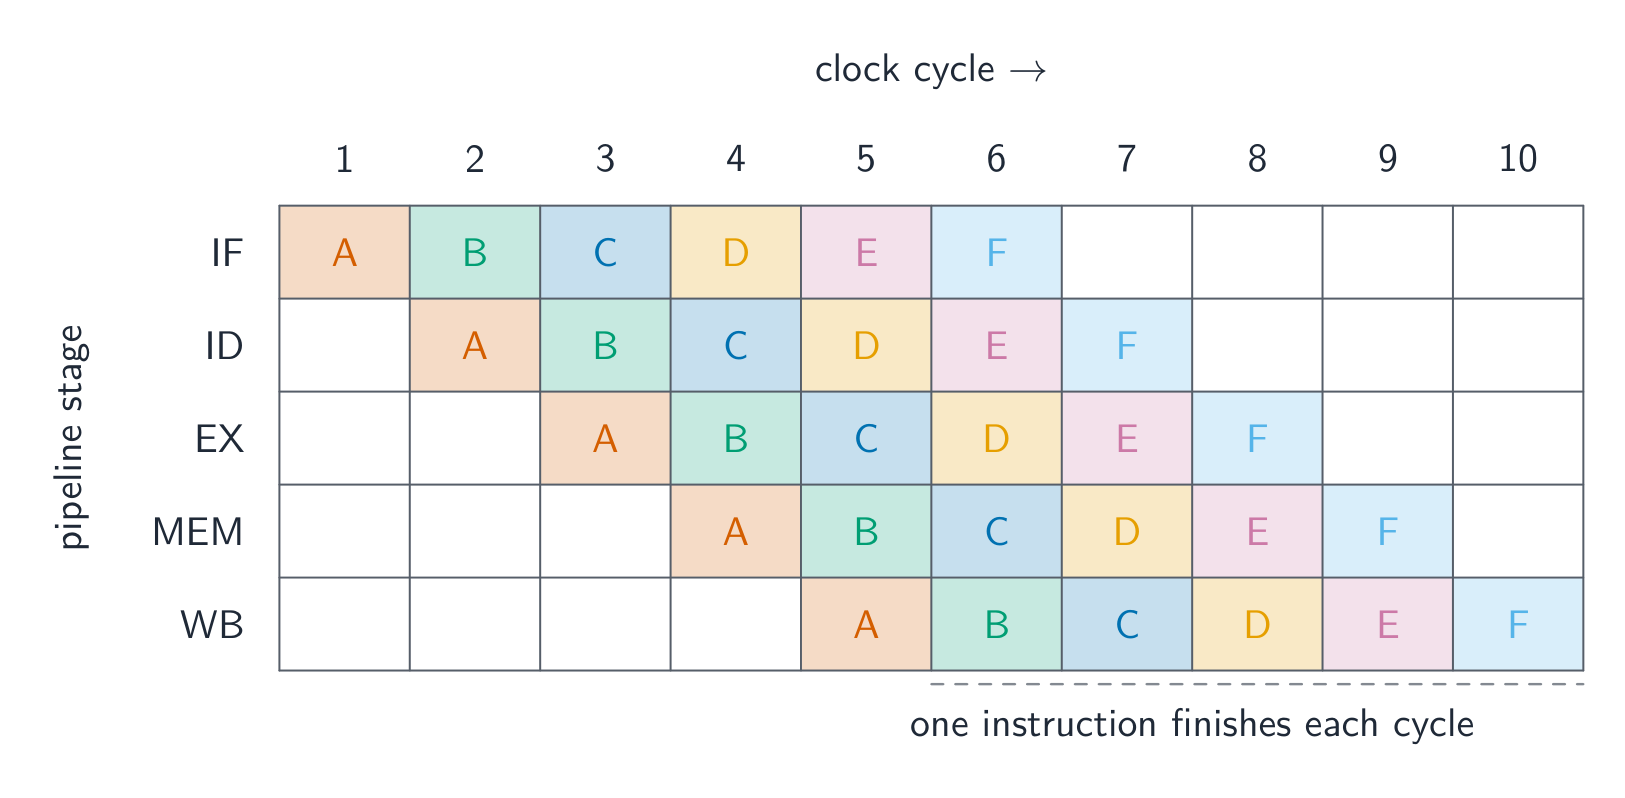
Six instructions en vol, une se terminant à chaque cycle
How pipelining fills up · Comment le pipelinage se remplit
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap. · Passez en revue les cycles d'horloge. Une fois le pipeline plein, une nouvelle instruction se termine tous les cycles — bien que chacune prenne encore plusieurs stades — parce que les stades de différentes instructions se chevauchent.
When a pipeline is full, it completes about: · Lorsqu'un pipeline est plein, il termine environ :
Overlapping the stages means a new instruction finishes each cycle once the pipeline is full. · Le chevauchement des stades signifie qu'une nouvelle instruction se termine chaque cycle une fois le pipeline plein.
Pipelining speeds up a processor by: · Le pipelinage accélère un processeur en :
Stages of different instructions run at the same time. · Les stades de différentes instructions fonctionnent en même temps.
Worked example: why pipelining is faster
- A five-stage pipeline runs at one cycle per stage. Explain why it is faster than executing instructions one after another.
- Without a pipeline, each instruction occupies the processor for all five stages, so one finishes every five cycles.
- With a pipeline, the fetch unit starts the next instruction while the current one is still decoding, so five instructions are in progress at once and, once it is full, one completes every cycle.
- No individual instruction is executed faster; the throughput rises about fivefold. Say that explicitly: it is the mark most often missed.
Exemple résolu : pourquoi le pipeline est plus rapide
- Un pipeline à cinq étapes fonctionne à un cycle par étape. Expliquez pourquoi il est plus rapide qu'exécuter les instructions les unes après les autres.
- Sans pipeline, chaque instruction occupe le processeur pour les cinq étapes, donc une se termine tous les cinq cycles.
- Avec un pipeline, l'unité de fetch commence l'instruction suivante pendant que la courante est encore en cours de décodage, donc cinq instructions sont en cours simultanément, et une fois plein, une se termine tous les cycles.
- Aucune instruction individuelle n'est exécutée plus vite ; le débit augmente d'environ cinq fois. Dites-le explicitement : c'est la marque la plus souvent manquée.
What does pipelining actually improve? · Que le pipelinage améliore-t-il réellement ?
Stages overlap, so five instructions are in progress at once and one completes per cycle. No individual instruction is executed any faster. · Les stades se chevauchent, donc cinq instructions sont en cours en même temps et une se termine par cycle. Aucune instruction individuelle n'est exécutée plus vite.
Hazards
- A hazard 冒险 stalls the pipeline. A data hazard occurs when an instruction needs a result the previous one has not yet produced, so it must wait.
- A control hazard occurs at a branch: until the branch is resolved, the processor does not know which instruction to fetch next.
- Both waste cycles, which is why processors predict branches and forward results between stages.
Hazards (Aléas)
- Un hazard 冒险 (aléa) bloque le pipeline. Un data hazard (aléa de données) survient lorsqu'une instruction a besoin d'un résultat que la précédente n'a pas encore produit, donc elle doit attendre.
- Un control hazard (aléa de contrôle) survient lors d'une branchement : jusqu'à ce que le branchement soit résolu, le processeur ne sait pas quelle instruction chercher ensuite.
- Les deux gaspillent des cycles, c'est pourquoi les processeurs prévoient les branchements et transfèrent les résultats entre les étapes.
A data hazard stalls the pipeline when an instruction needs a result that is not ready yet; a control hazard comes from a branch changing which instruction runs next. · Une danger de données bloque le pipeline lorsqu'une instruction a besoin d'un résultat qui n'est pas encore prêt ; un danger de contrôle vient d'une branche changeant quelle instruction s'exécute ensuite.
Hazards force the pipeline to stall (or flush), which is why they reduce the ideal one-per-cycle throughput. · Les dangers forcent le pipeline à staller (ou être vidé), ce qui explique pourquoi ils réduisent le débit idéal d'une instruction par cycle.
Match each pipeline hazard to what causes it. · Associez chaque danger de pipeline à ce qui le provoque.
Both stall the pipeline and waste cycles, which is why processors forward results between stages and predict branches. · Les deux bloquent le pipeline et gaspillent des cycles, c'est pourquoi les processeurs transfèrent les résultats entre les stades et prévoient les branches.
Flynn's taxonomy
- Flynn's taxonomy 弗林分类 sorts computers by how many instruction streams and data streams they have.
- SISD: one instruction stream, one data stream, a traditional single core.
- SIMD 单指令多数据: one instruction operates on many data items at once. This is a GPU or a CPU's vector unit, and it suits images, video and scientific arrays.
- MISD: several operations on the same data; rare and mostly theoretical. MIMD 多指令多数据: many processors run different instructions on different data, which is a multi-core CPU or a cluster, and it is the most general.
One instruction, many data items
Taxonomie de Flynn
- Flynn's taxonomy 弗林分类 (Taxonomie de Flynn) classe les ordinateurs selon combien de flux instruction et de flux données ils ont.
- SISD : un flux instruction, un flux données, un cœur unique traditionnel.
- SIMD 单指令多数据 : une instruction opère sur beaucoup d'éléments de données en même temps. C'est un GPU ou l'unité vectorielle d'un CPU, et cela convient aux images, vidéo et tableaux scientifiques.
- MISD : plusieurs opérations sur les mêmes données ; rare et surtout théorique. MIMD 多指令多数据 : de nombreux processeurs exécutent différentes instructions sur différentes données, c'est un CPU multi-cœur ou un cluster, et c'est le plus général.
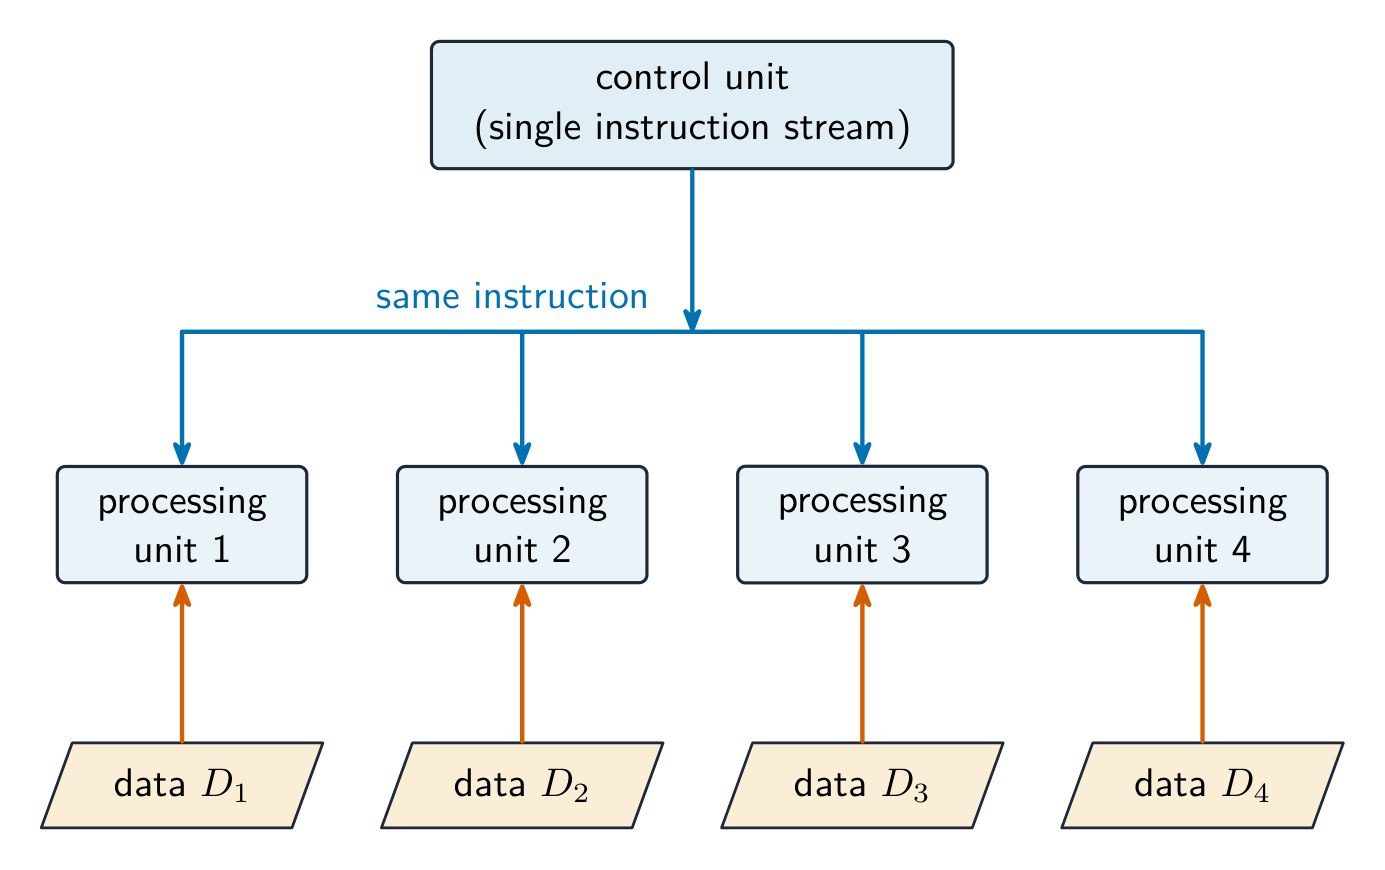
Une instruction, beaucoup d'éléments de données
Which describe SIMD? Select all · tout that apply. · Quels termes décrivent SIMD ? Sélectionnez toutes celles qui s'appliquent.
Different programs on different data is MIMD, the multi-core case. SIMD is one instruction stream over many data streams. · Différents programmes sur des données différentes est MIMD, le cas multi-cœur. SIMD est un flux d'instruction sur de multiples flux de données.
Massively parallel computers
- A massively parallel 大规模并行 system uses thousands of processors connected by a fast network, each with its own memory, exchanging data by messages rather than sharing memory.
- It is MIMD, and it needs specially written software, because the programmer must divide the problem and manage the communication.
- This is what the largest supercomputers 超级计算机 are: climate simulation, machine-learning training and astrophysics all run this way.
Ordinateurs massivement parallèles
- Un système massively parallel 大规模并行 utilise des milliers de processeurs connectés par un réseau rapide, chacun avec sa propre mémoire, échangeant des données par messages plutôt que partageant la mémoire.
- C'est du MIMD, et il nécessite un logiciel spécifiquement écrit, car le programmeur doit diviser le problème et gérer la communication.
- C'est ainsi que fonctionnent les plus grands superordinateurs 超级计算机 : simulation climatique, entraînement machine-learning et astrophysique tournent tous ainsi.
A massively parallel computer's processors share one block of memory. · Les processeurs d'un ordinateur massivement parallèle partagent un bloc de mémoire unique.
Each processor has its own memory, and they exchange data by messages over a fast network. That distributed memory is what the term means. · Chaque processeur a sa propre mémoire, et ils échangent des données par messages via un réseau rapide. C'est cette mémoire distribuée que le terme signifie.
Worked example: place the machine
- A graphics card applies the same brightness adjustment to two million pixels. SIMD: one instruction, many data items, which is precisely what the GPU's thousands of small cores are built for.
- A four-core laptop runs a browser, a compiler and a music player at once. MIMD: different instructions on different data, one stream per core.
- A weather centre divides the atmosphere into a grid across ten thousand processors, each with its own memory, passing boundary values as messages. Massively parallel, which is a form of MIMD.
- Name the category, then justify with the number of instruction and data streams.
Exemple résolu : placer la machine
- Une carte graphique applique le même réglage de luminosité à deux millions de pixels. SIMD : une instruction, beaucoup d'éléments de données, ce pour quoi sont conçues les milliers de petits cœurs du GPU.
- Un ordinateur portable à quatre cœurs exécute un navigateur, un compilateur et un lecteur de musique simultanément. MIMD : différentes instructions sur différentes données, un flux par cœur.
- Un centre météorologique divise l'atmosphère en grille sur dix mille processeurs, chacun avec sa propre mémoire, passant des valeurs frontalières par messages. Massively parallel, ce qui est une forme de MIMD.
- Nommez la catégorie, puis justifiez avec le nombre de flux d'instructions et de données.
Marks that slip away
- Pipelining raises throughput; it does not shorten any single instruction. Say so.
- In RISC, only load and store touch memory. That one fact explains the fixed length, the many registers and the clean pipeline.
- SIMD is one instruction on many data; MIMD is many instructions on many data. Count the streams before answering.
- Massively parallel means thousands of processors with distributed memory and message passing, not just "a fast computer".
Pièges qui font perdre des points
- Le pipeline augmente le débit ; il ne raccourcit aucune instruction individuelle. Dites-le.
- En RISC, seul load et store touchent la mémoire. Ce seul fait explique la longueur fixe, les nombreux registres et le pipeline propre.
- SIMD est une instruction sur beaucoup de données ; MIMD est beaucoup d'instructions sur beaucoup de données. Comptez les flux avant de répondre.
- Massivement parallel signifie des milliers de processeurs avec mémoire distribuée et passage de messages, pas juste « un ordinateur rapide ».
You've got it
- CISC: many complex variable-length instructions, more per instruction · RISC: few simple fixed-length instructions, load and store only, many registers, one cycle each
- a pipeline overlaps fetch, decode, execute, memory and write-back, so one instruction completes per cycle once full: higher throughput, not faster instructions; data and control hazards stall it
- Flynn: SISD, SIMD (a GPU), MISD, MIMD (multi-core)
- massively parallel: thousands of processors, distributed memory, message passing, MIMD, used by supercomputers
Vous avez compris
- CISC : beaucoup d'instructions complexes de longueur variable, plus par instruction · RISC : peu d'instructions simples de longueur fixe, load and store only (charge et stockage uniquement), beaucoup de registres, un cycle chacun
- un pipeline chevauche fetch, decode, execute, memory et write-back, donc une instruction se termine par cycle une fois plein : débit supérieur, pas instructions plus rapides ; data et control hazards (aléas de données et de contrôle) le bloquent
- Flynn : SISD, SIMD (un GPU), MISD, MIMD (multi-cœur)
- massively parallel : des milliers de processeurs, mémoire distribuée, passage de messages, MIMD, utilisé par les superordinateurs