Cette page nécessite un navigateur récent (avec support SharedArrayBuffer). Veuillez mettre à jour Chrome, Edge, Firefox ou Safari vers la dernière version.
Python exécute votre code ligne par ligne. Chaque ligne est une instruction 语句. Un programme 程序 n'est qu'une liste d'instructions exécutées de haut en bas.
La fonction print() affiche du texte à l'écran. On appelle cela la sortie 输出. Le texte entre guillemets est une chaîne 字符串.
print("Hello, world!")
print("I am learning Python")
Chaque print() commence une nouvelle ligne.
Les guillemets peuvent être "double" ou 'single' — les deux forment une chaîne.
Un programme ne fait rien jusqu'à ce que vous l'exécutiez.
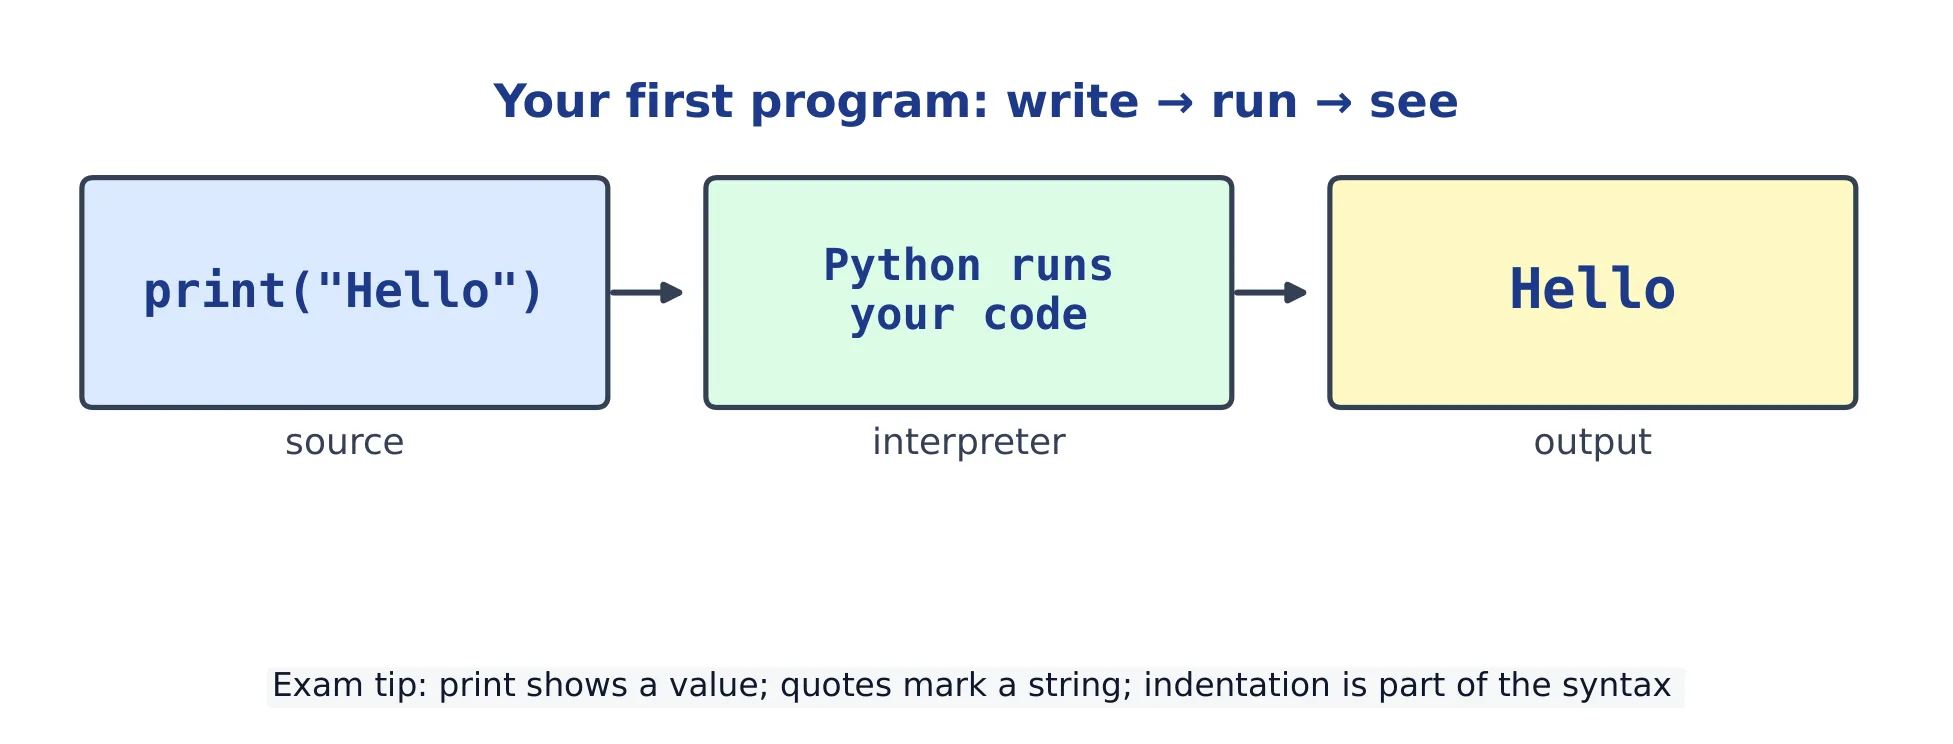
Le code source passe par l'interpréteur pour produire une sortie
1.2
Commentaires et style de code
Un commentaire 注释 commence par #. Python ignore tout après le # sur cette ligne. Les commentaires expliquent votre code aux gens ; ils ne changent pas ce que le code fait.
# This line is a note for humans
print("Hi")        # you can also comment at the end of a line
Un bon style rend le code facile à lire :
Utilisez des noms clairs qui indiquent ce qu'une valeur signifie.
Mettez une instruction par ligne.
N'ajoutez pas d'espaces au début d'une ligne normale. En Python, les espaces au début (indentation 缩进) ont une signification spéciale, donc un mauvais espace provoque une erreur 错误.
1.3
Entrée, traitement, sortie
De nombreux programmes suivent un plan simple : entrée 输入 → traitement → sortie. Vous obtenez des données, faites quelque chose avec, puis affichez un résultat.
La fonction input() lit le texte tapé par l'utilisateur. Elle retourne toujours une chaîne.
name = input("What is your name? ")
print("Hello, " + name)
input() attend que l'utilisateur tape et appuie sur Entrée.
Stockez le texte tapé dans une variable 变量 pour pouvoir l'utiliser plus tard.
Comme input() retourne une chaîne, changez-la avec int(...) d'abord si vous avez besoin d'un nombre.
Erreurs courantes
Oublier les guillemets : print(Hello) cherche une variable nommée Hello et soulève une NameError. Le texte nécessite des guillemets : print("Hello").
Un espace erroné au début d'une ligne : Python lit l'indentation comme une structure, donc il soulève une IndentationError.
Supposer que input() retourne un nombre. Il retourne toujours une chaîne, alors enveloppez-le dans int(...) avant de faire des mathématiques.
Une variable 变量 est un nom pour une valeur 值. Vous en créez une avec =, appelé affectation 赋值. Le nom va à gauche ; la valeur va à droite.
age = 17
name = "Mei"
price = 9.99
print(age, name, price)
Maintenant age contient 17. Utilisez le nom partout où vous avez besoin de la valeur, et changez-la plus tard :
age = 17
age = age + 1   # age is now 18
print(age)
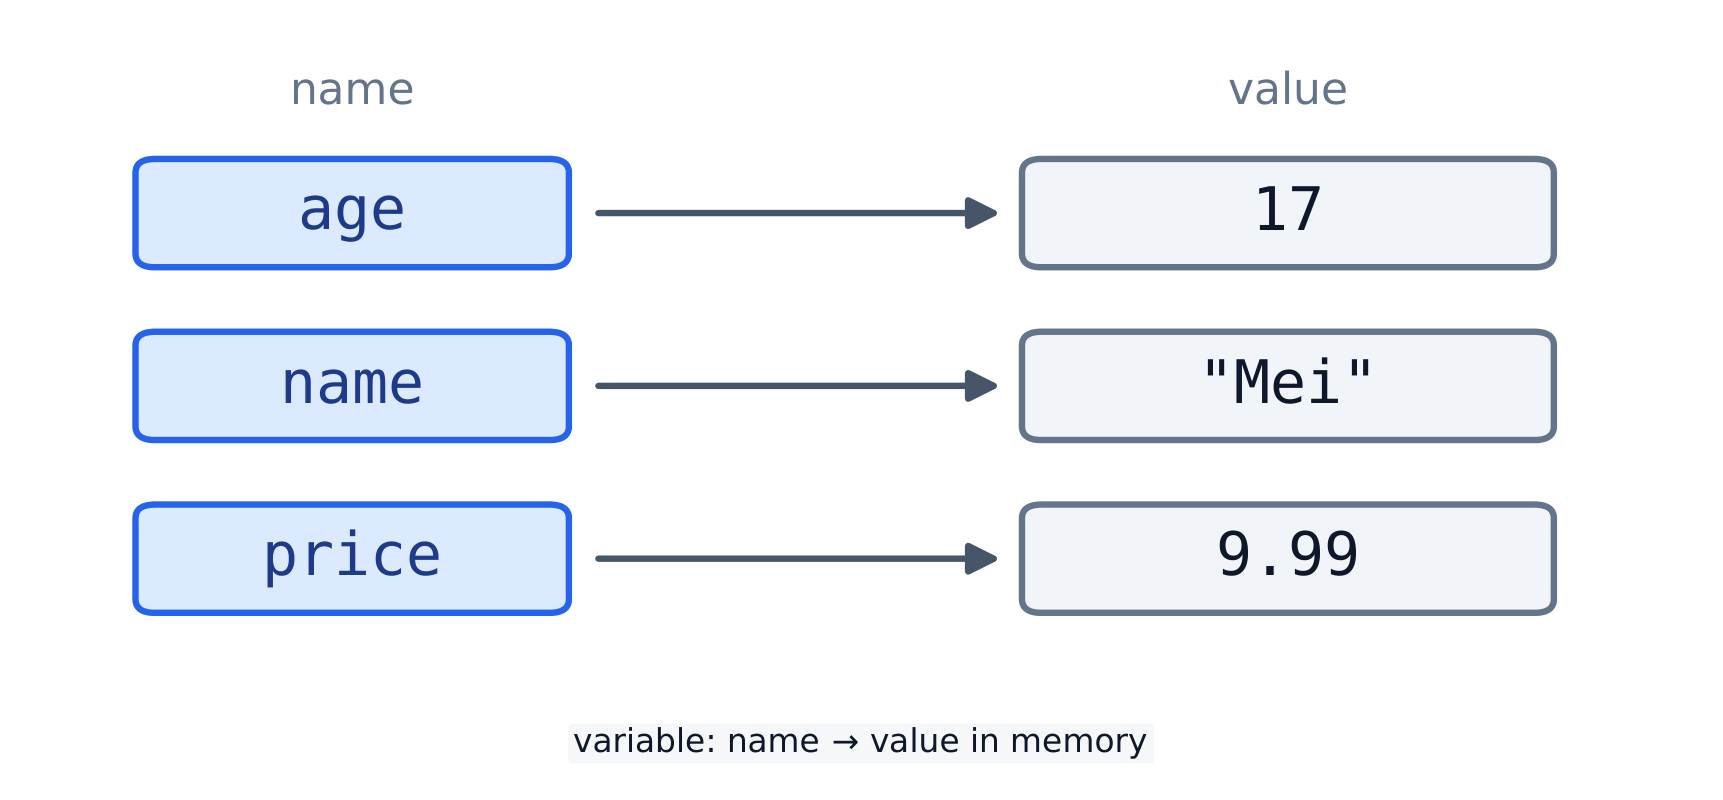
Chaque nom de variable pointe vers une valeur en mémoire
Le signe = ne signifie pas "égal". Cela signifie "stocker le côté droit sous le nom de gauche".
Pour tester si deux valeurs sont égales, utilisez == (voir ci-dessous).
2.2
Nombres : int & float
Python a deux types numériques principaux. Un entier 整数 (int) est un nombre entier comme 17. Un float 浮点数 (float) a un point décimal comme 9.99.
Ces opérateurs 运算符 fonctionnent sur les nombres :
Opérateur
Signification
Exemple
Résultat
+
addition
3 + 2
5
-
soustraction
3 - 2
1
*
multiplication
3 * 2
6
/
division (toujours float)
7 / 2
3.5
//
division entière
7 // 2
3
%
reste (modulo)
7 % 2
1
**
puissance
2 ** 3
8
/ retourne toujours un float, donc 4 / 2 est 2.0.
// et % vont ensemble : 17 // 5 est 3, et 17 % 5 est 2.
2.3
Expressions et conversion de type
Une expression 表达式 est n'importe quoi qui a une valeur, comme 3 + 4 * 2. Python utilise l'ordre mathématique normal (* et / avant + et -) ; ajoutez des parenthèses pour clarifier l'ordre.
input() retourne une chaîne, donc convertissez-la avant de faire des mathématiques. Changer une valeur d'un type à un autre est la conversion de type 类型转换 :
age = int("17")        # text "17" -> number 17
price = float("9.99")  # text -> 9.99
label = str(17)        # number -> text "17"
print(age, price, label)
int("abc") échoue, donc ne convertissez que le texte qui ressemble à un nombre.
Mélanger les types échoue aussi : "age: " + 17 est une erreur ; écrivez "age: " + str(17).
2.4
Booléens et comparaison
Un booléen 布尔值 est l'une de seulement deux valeurs : True ou False. Une comparaison 比较 retourne un booléen.
Un programme choisit quoi faire avec if. Il exécute un bloc indenté 缩进 seulement quand une condition 条件 est vraie. La ligne if se termine par deux-points 冒号.
score = 72
if score >= 60:
    print("pass")
# pass
Ajoutez elif (else-if) pour plus de cas et else pour « tout autre ». Python exécute la première branche vraie 分支 uniquement, puis saute le reste.
score = 72
if score >= 80:
    print("A")
elif score >= 60:
    print("B")
else:
    print("fail")
# B
Comparez des valeurs avec == (égal), != (non égal), <, >, <=, >=.
Une comparaison 比较 donne une valeur booléenne 布尔值 — soit True, soit False.
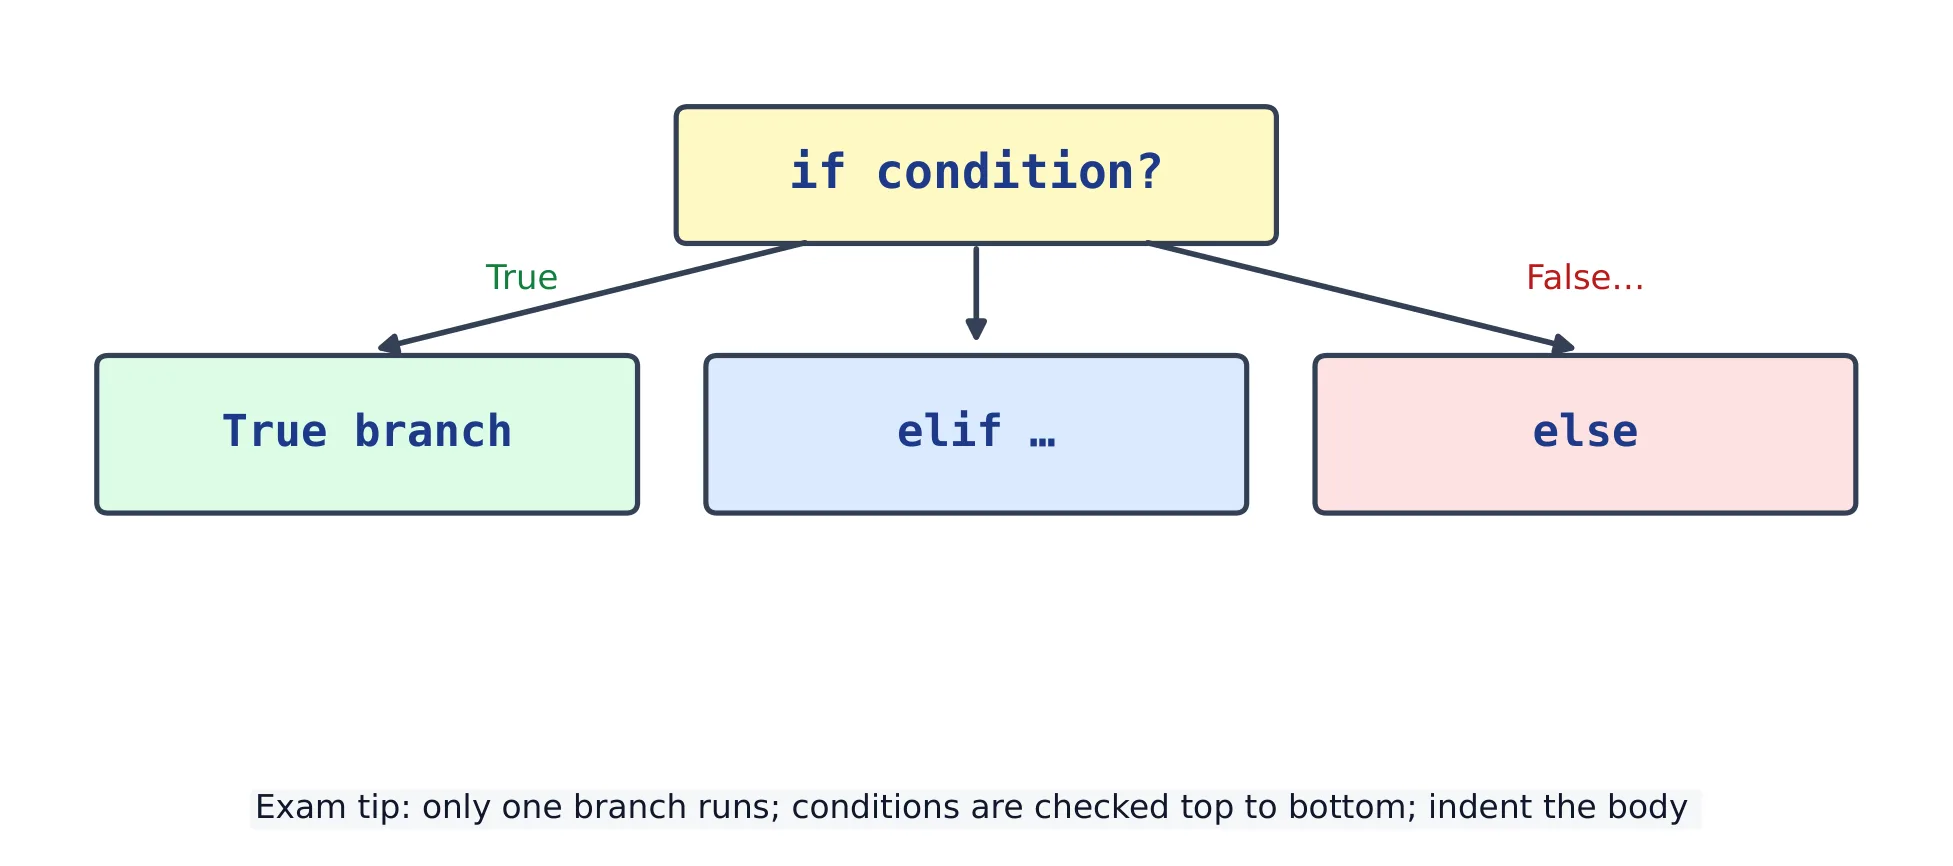
if / elif / else: seule une branche s'exécute
4.2
Combiner des conditions
Joignez des conditions avec and, or, not. and nécessite que les deux côtés soient vrais ; or nécessite que l'un ou l'autre côté soit vrai ; not inverse une valeur booléenne.
age = 16
has_ticket = True
if age >= 18 and has_ticket:
    print("entry allowed")
else:
    print("entry refused")
# entry refused
Utilisez des parenthèses pour clarifier l'ordre : (a or b) and c.
temp = 30
if temp > 25 and not temp > 35:
    print("warm but ok")
# warm but ok
Erreurs courantes
Écrivez elif, pas else if.
Chaque ligne if / elif / else se termine par deux-points :, et son corps doit être indenté.
if x = 5: est une erreur — utilisez == pour comparer.
else ne prend pas de condition ; seuls if et elif en prennent.
Une boucle 循环 répète du code. Une boucle for répète une fois pour chaque élément d'une séquence 序列. range(n) donne les nombres 0 jusqu'à n - 1.
for i in range(5):
    print(i)
# 0, then 1, 2, 3, 4 (each on its own line)
range(a, b) va de a jusqu'à (sans inclure) b.
range(a, b, step) ajoute un pas 步长 à chaque itération.
for n in range(2, 11, 2):
    print(n)        # 2 4 6 8 10
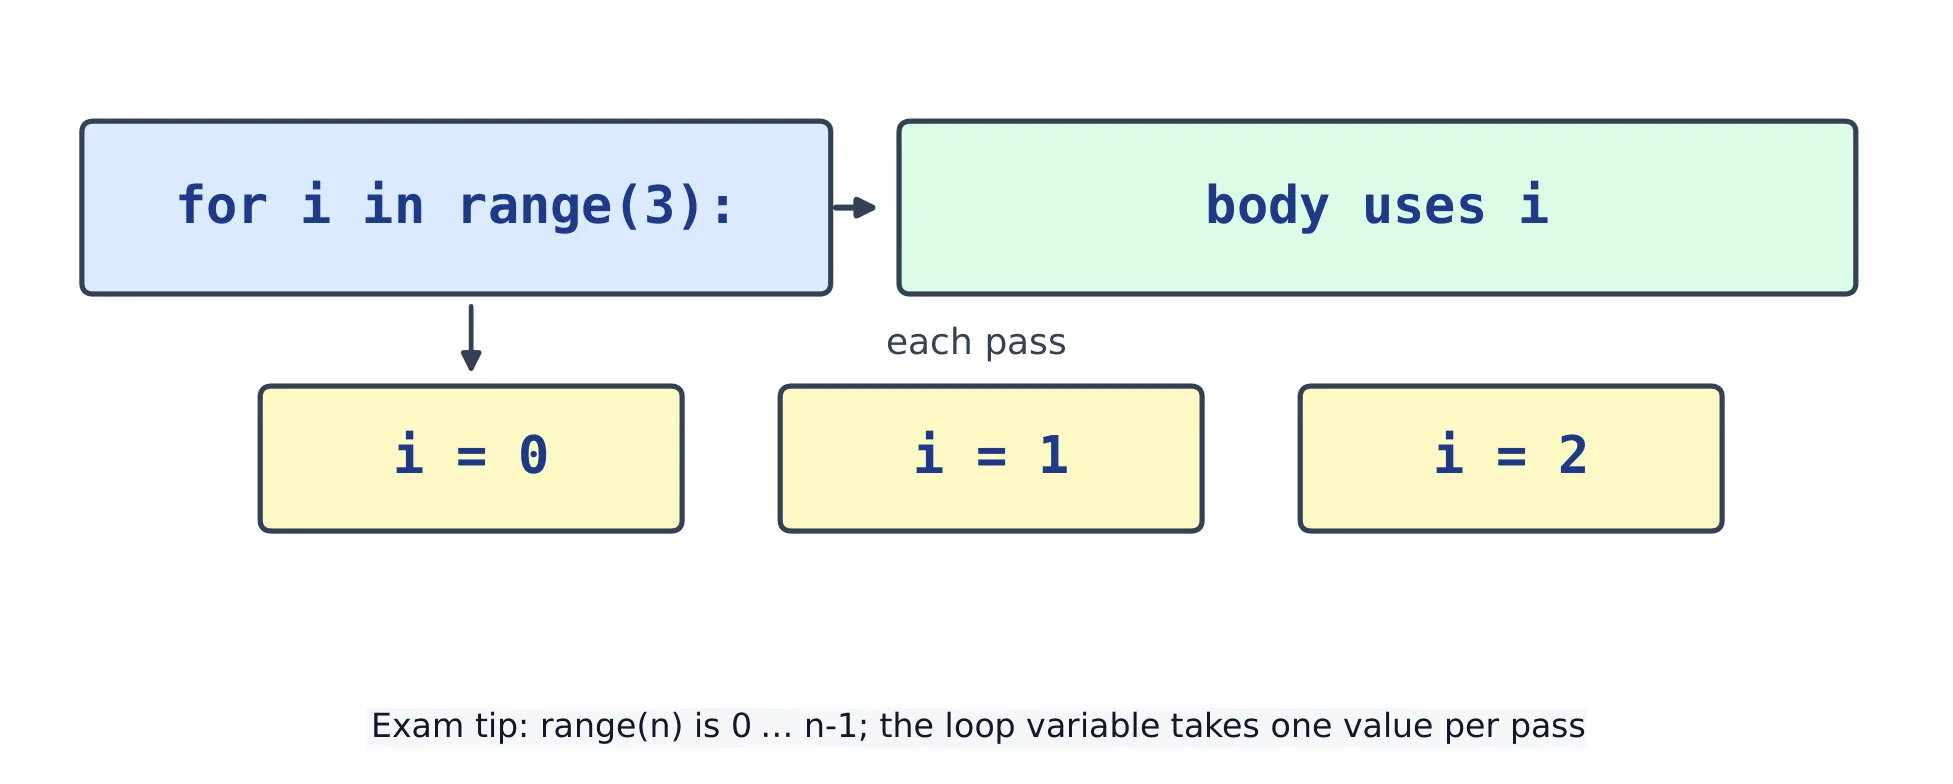
for i in range(n): le corps s'exécute avec i = 0 … n-1
5.2
Le motif de l'accumulateur
Pour construire un résultat au fil d'une boucle, initialisez une variable avant la boucle, puis mettez-la à jour 更新 à chaque tour. C'est le motif de l'accumulateur 累加器.
total = 0
for n in range(1, 6):
    total = total + n
print(total)        # 15
La même idée compte combien d'éléments correspondent à un test.
count = 0
for letter in "banana":
    if letter == "a":
        count = count + 1
print(count)        # 3
5.3
Boucles while
Une boucle while répète tant que une condition reste vraie. Changez quelque chose à l'intérieur, sinon elle ne s'arrêtera jamais — une boucle infinie 无限循环.
n = 1
while n <= 3:
    print(n)
    n = n + 1
# 1 2 3
break quitte immédiatement la boucle.
total = 0
while True:
    total = total + 10
    if total >= 30:
        break
print(total)        # 30
5.4
Boucles imbriquées
Une boucle dans une autre boucle est une boucle imbriquée 嵌套循环. La boucle interne 内层循环 s'exécute entièrement pour chaque itération de la boucle externe 外层循环.
for row in range(3):
    line = ""
    for col in range(3):
        line = line + "*"
    print(line)
# ***
# ***
# ***
Erreurs courantes
range(n) va de 0 à n - 1, pas de 1 à n — l'erreur classique off-by-one.
Modifier une liste pendant qu'on parcourt sauter des éléments ; parcourez une copie si vous devez supprimer des choses.
Oublier de modifier la variable de boucle dans une while la fera tourner indéfiniment.
L'indentation détermine ce qui est dans la boucle ; une ligne mal indentée ne s'exécute qu'une seule fois, après la boucle.
grid = [[1, 2], [3, 4]]
for row in grid:
    for value in row:
        print(value, end=" ")
print()               # 1 2 3 4
6.4
Compréhensions de liste
Une compréhension de liste construit une nouvelle liste en une seule ligne : [expression for item in sequence].
squares = [x * x for x in range(5)]
print(squares)        # [0, 1, 4, 9, 16]
Ajoutez if pour ne garder que certains éléments.
evens = [n for n in range(10) if n % 2 == 0]
print(evens)          # [0, 2, 4, 6, 8]
6.5
Tuples & ensembles
Un tuple est une séquence fixe entre parenthèses rondes. Il ne peut pas être modifié après sa création — utilisez-le pour des valeurs qui appartiennent ensemble, et décompactez-le en noms.
point = (3, 4)
x, y = point            # unpacking
print(x, y)             # 3 4
Une fonction devant retourner deux résultats retourne un tuple :
b = a partage une même liste. a.copy() ou a[:] crée une nouvelle liste externe, mais les éléments mutables imbriqués restent partagés (copie peu profonde).
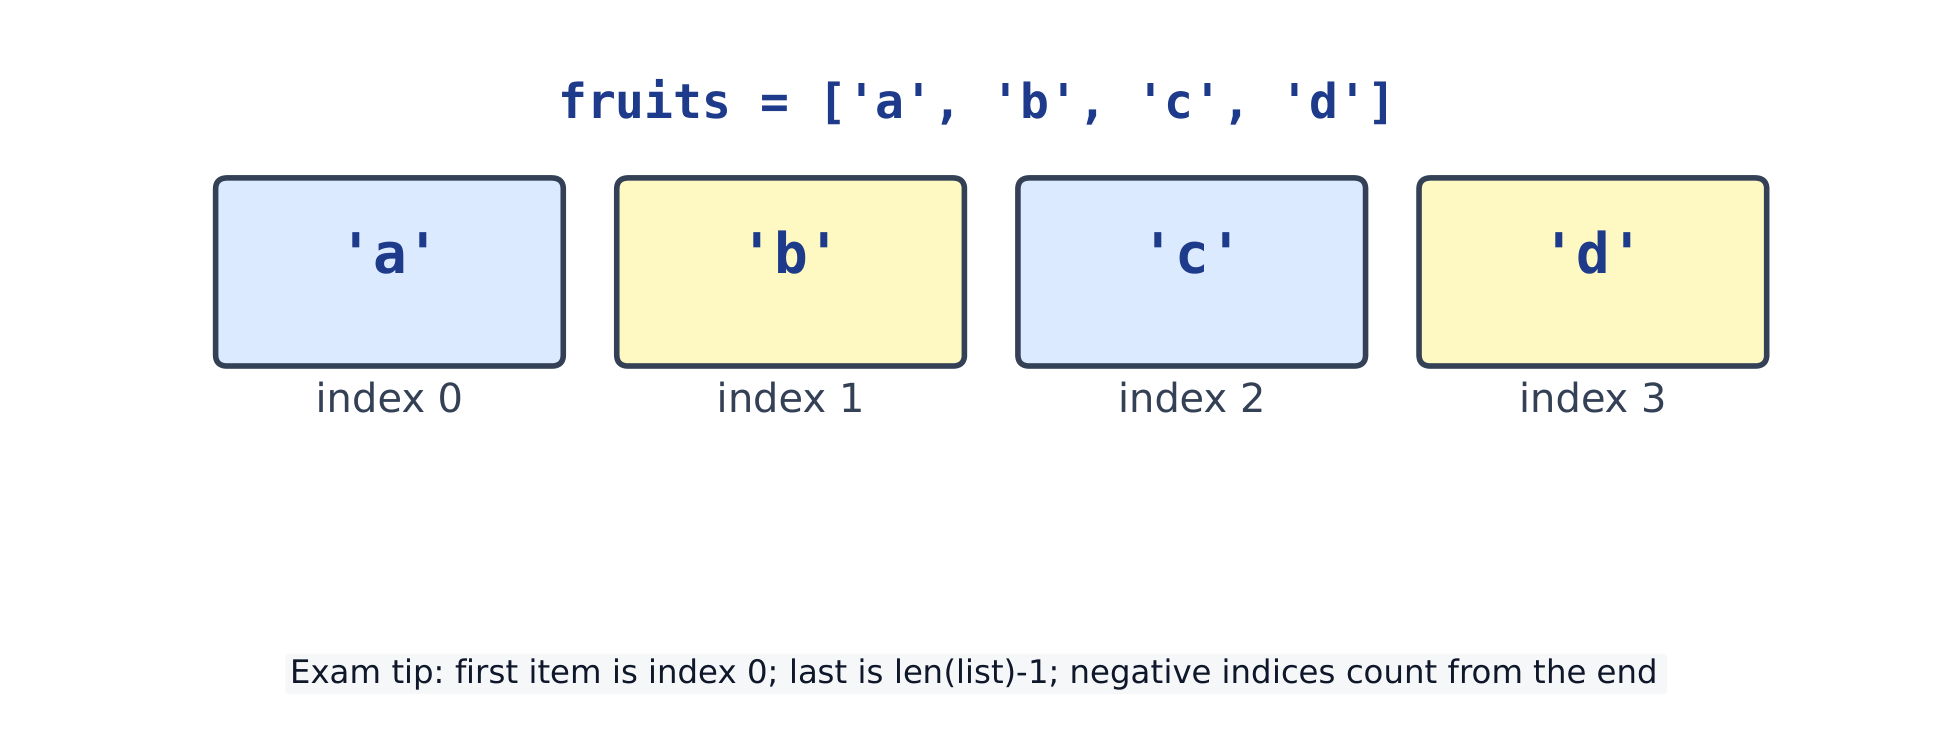
Le dernier élément est a[-1] ; a[len(a)] est hors limites.
append ajoute UN seul élément ; utilisez extend ou + pour joindre une autre liste.
Construire une grille avec [[0]*3]*3 crée trois copies de la même ligne. Construisez les lignes dans une boucle à la place.
Un tuple avec un seul élément a besoin d'une virgule : (5,), pas (5).
Un set n'a ni ordre ni doublons, donc on ne peut pas l' indexer avec s[0].
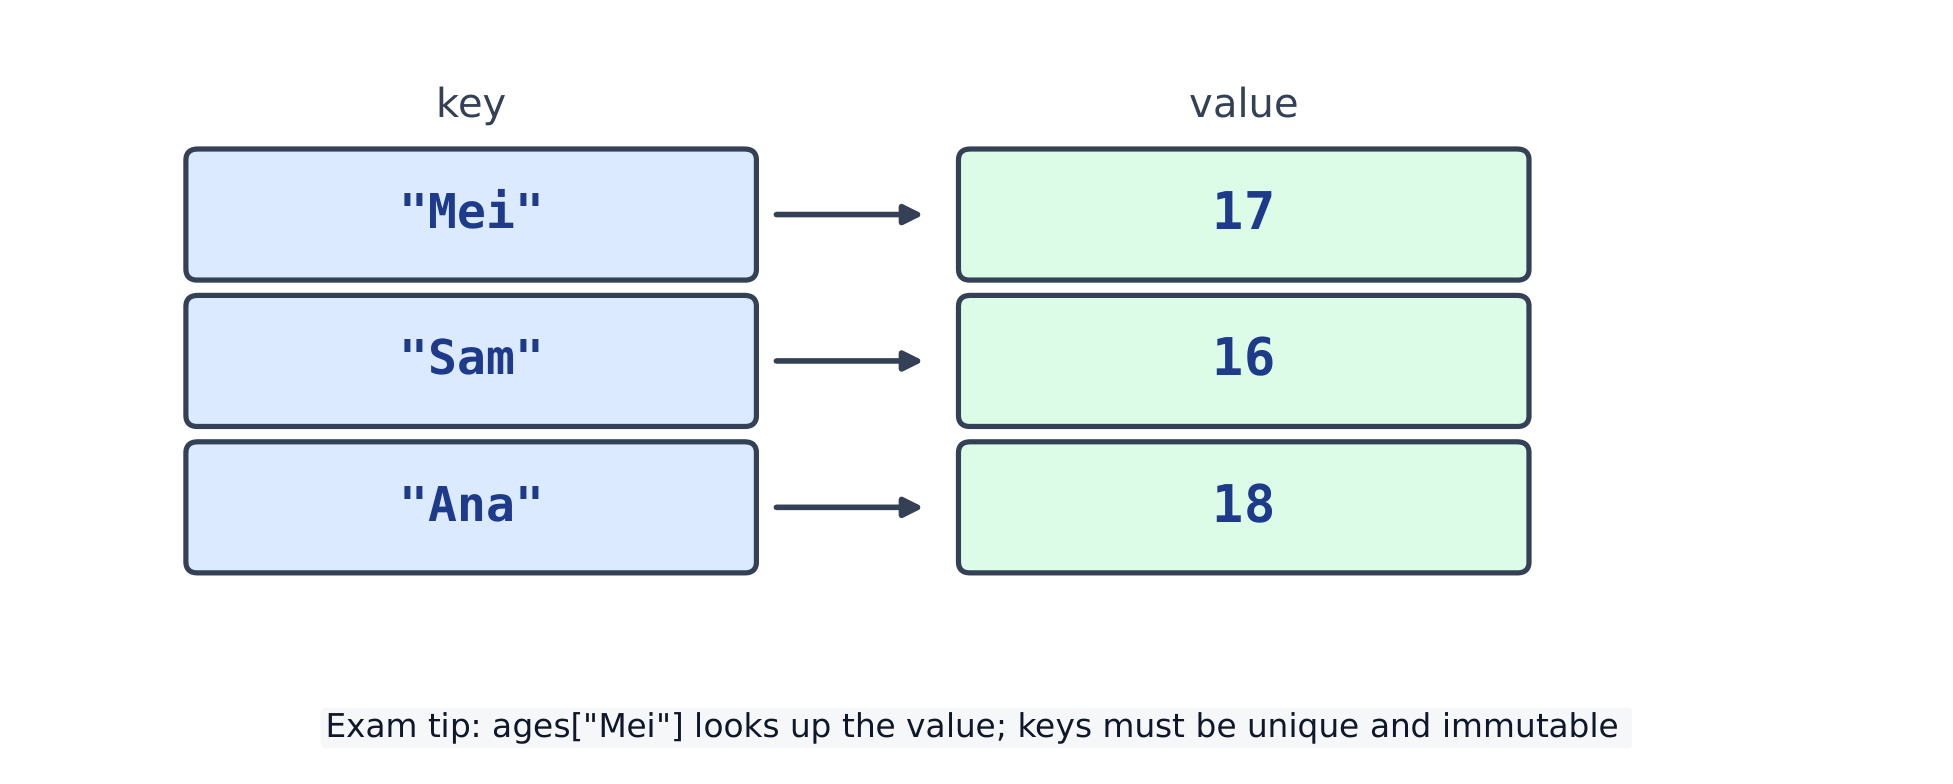
Attribuez à une clé pour l'ajouter, ou pour modifier une existante.
student = {"name": "Mei"}
student["score"] = 88      # add a new key
student["score"] = 90      # update the value
print(student)             # {'name': 'Mei', 'score': 90}
Vérifier et parcourir
Utilisez in pour tester l'existence d'une clé. Parcourez les clés, ou .items() pour obtenir à la fois clé et valeur.
student = {"name": "Mei", "score": 90}
print("score" in student)  # True
for key, value in student.items():
    print(key, "=", value)
# name = Mei
# score = 90
.get(key, default) retourne une valeur par défaut 默认值 quand la clé manque — aucune erreur.
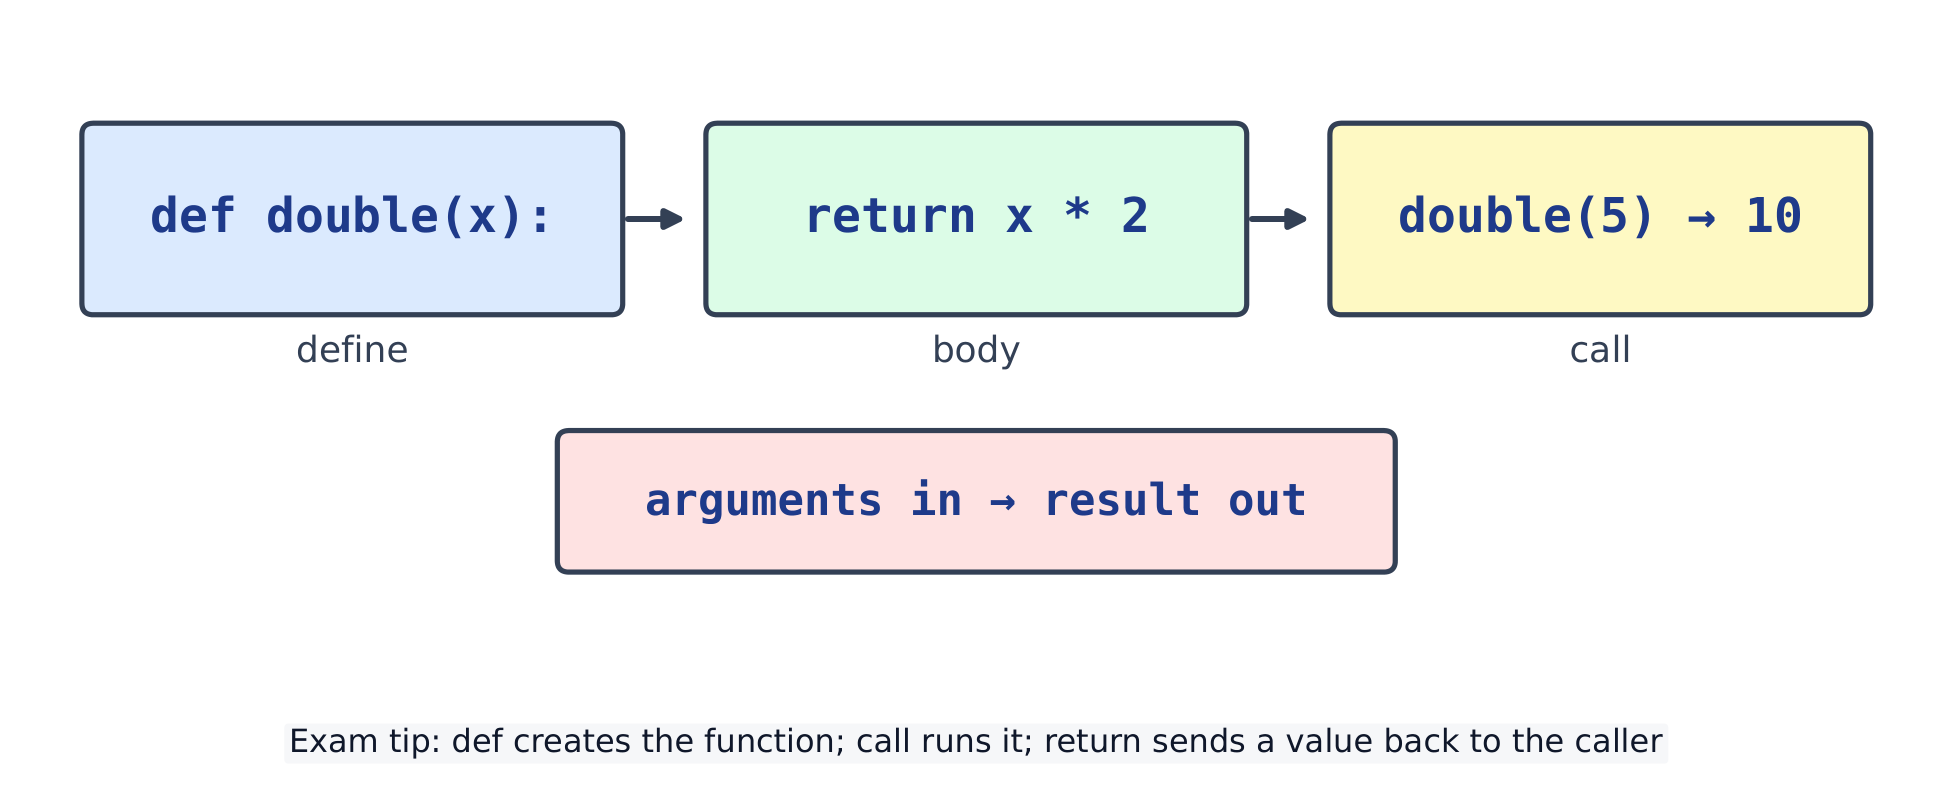
Le code à l'intérieur ne s'exécute que lorsque vous appelez la fonction.
def définit ; appel exécute ; return renvoie une valeur
8.2
Valeurs de retour
Une fonction peut retourner 返回 une valeur avec return. L'appel devient alors cette valeur.
def square(n):
    return n * n

print(square(5))          # 25
print(square(3) + 1)      # 10
return arrête immédiatement la fonction. Une fonction sans return retourne None.
8.3
Paramètres, arguments & portée
Un paramètre 形参 est le nom dans la def. Un argument 实参 est la valeur que vous passez.
def power(base, exp):         # base, exp are parameters
    return base ** exp

print(power(2, 3))            # 8  (2 and 3 are arguments)
Une variable créée à l'intérieur d'une fonction est locale 局部 — elle n'existe que là. Cette région est sa portée 作用域.
def f():
    x = 10            # local to f
    return x

print(f())            # 10
# print(x) here would be an error: x is not defined outside f
Un paramètre peut avoir une valeur par défaut 默认值, utilisée quand l'appelant l'ommet :
def greet(name, greeting="Hello"):
    return greeting + ", " + name

print(greet("Mei"))              # Hello, Mei
print(greet("Sam", "Welcome"))   # Welcome, Sam
8.4
Abstraction procédurale
L'abstraction procédurale 过程抽象 signifie cacher les détails derrière un nom. Vous utilisez une fonction par son nom et ce qu'elle fait, pas comment elle fonctionne.
def area_of_rectangle(w, h):
    return w * h

print(area_of_rectangle(4, 5))   # 20
Une bonne fonction fait une seule tâche, a un nom clair, et évite de répéter du code.
8.5
Modules & imports
Un module 模块 est un fichier de fonctions prêtes. Importez-en un avec import 导入.
import random
random.seed(0)               # makes the result repeatable
print(random.randint(1, 6))  # a dice roll

import math
print(math.sqrt(16))         # 4.0
Erreurs courantes
Une fonction retourne None sauf si vous écrivez return. Imprimer n'est pas pareil que retourner.
N'utilisez jamais une valeur par défaut mutable comme def f(x=[]) — la même liste est partagée entre tous les appels.
Une variable créée à l'intérieur d'une fonction est locale et invisible à l'extérieur.
Exécutez une fonction avec f() ; écrire f seul nomme simplement la fonction.
Le code peut échouer de trois manières. Une erreur de syntaxe viole les règles de Python, il ne s'exécute jamais. Une erreur d'exécution survient pendant l'exécution, comme une division par zéro. Une erreur logique s'exécute mais produit une réponse incorrecte.
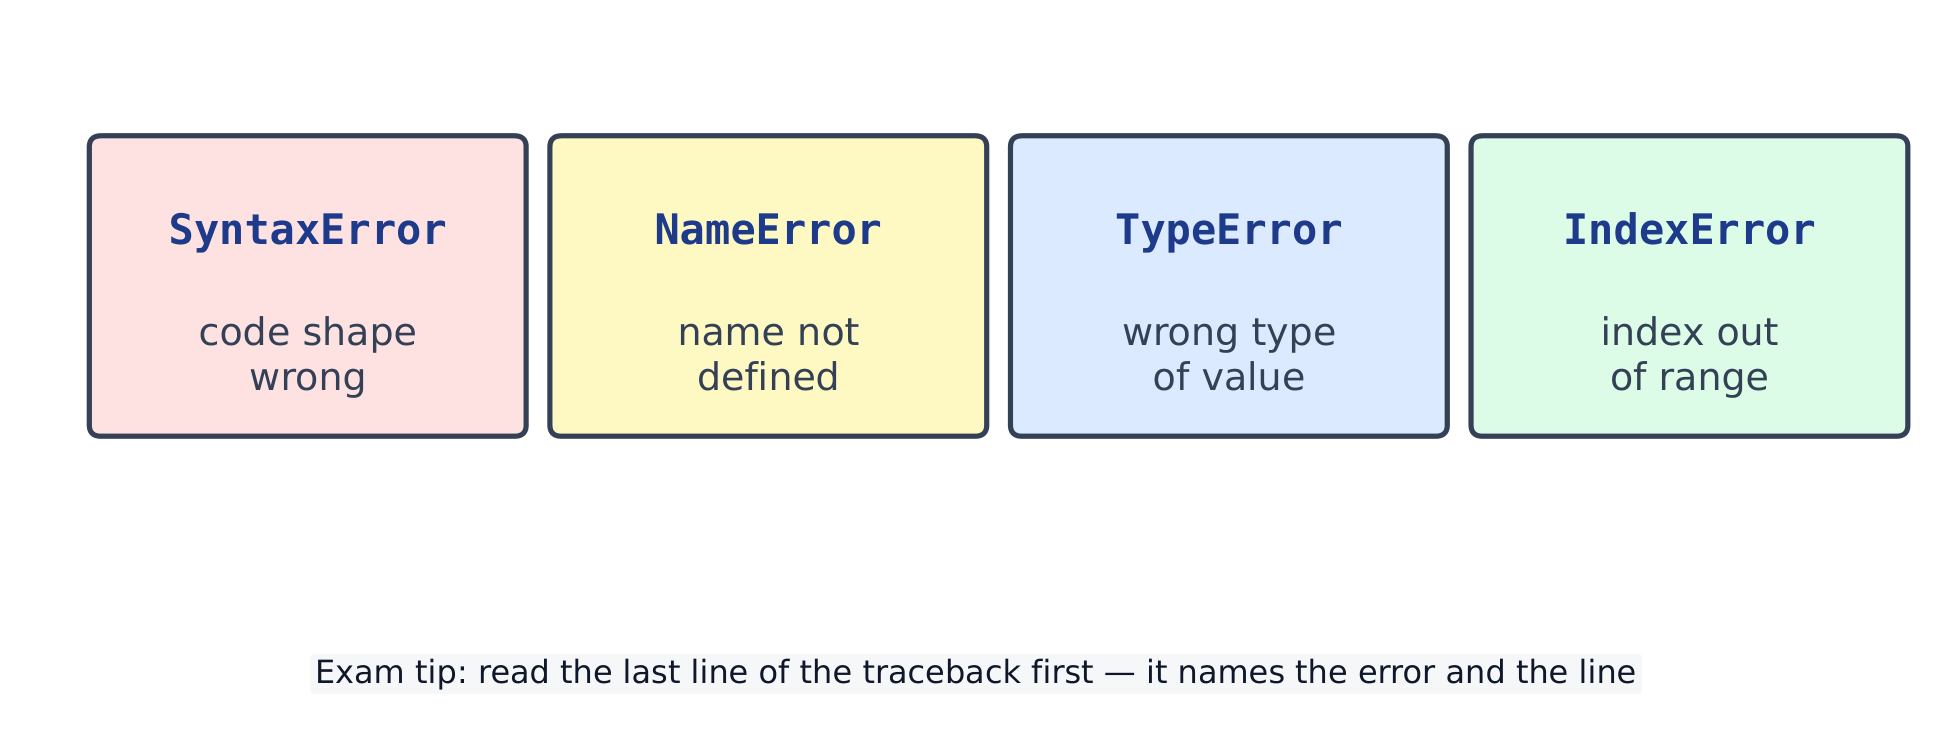
Erreurs Python courantes : Syntaxe, Nom, Type, Index
# A runtime error, caught so this block still finishes:
try:
    print(10 / 0)
except ZeroDivisionError:
    print("cannot divide by zero")
# cannot divide by zero
Python affiche une traceback indiquant où l'échec a eu lieu. Lisez-la de bas en haut.
9.2
try / except / raise
Placez le code risqué dans try ; si celui-ci échoue, except intercepte l'exception au lieu d'un crash.
Attrapez un type spécifique (ValueError, ZeroDivisionError, …).
raise génère volontairement votre propre erreur.
def set_age(age):
    if age < 0:
        raise ValueError("age cannot be negative")
    return age

try:
    set_age(-1)
except ValueError as err:
    print("error:", err)
# error: age cannot be negative
9.3
Tests & robustesse
Un test vérifie que le code produit la bonne réponse. Testez les cas normaux et les cas limites — entrée vide, zéro, très grandes valeurs.
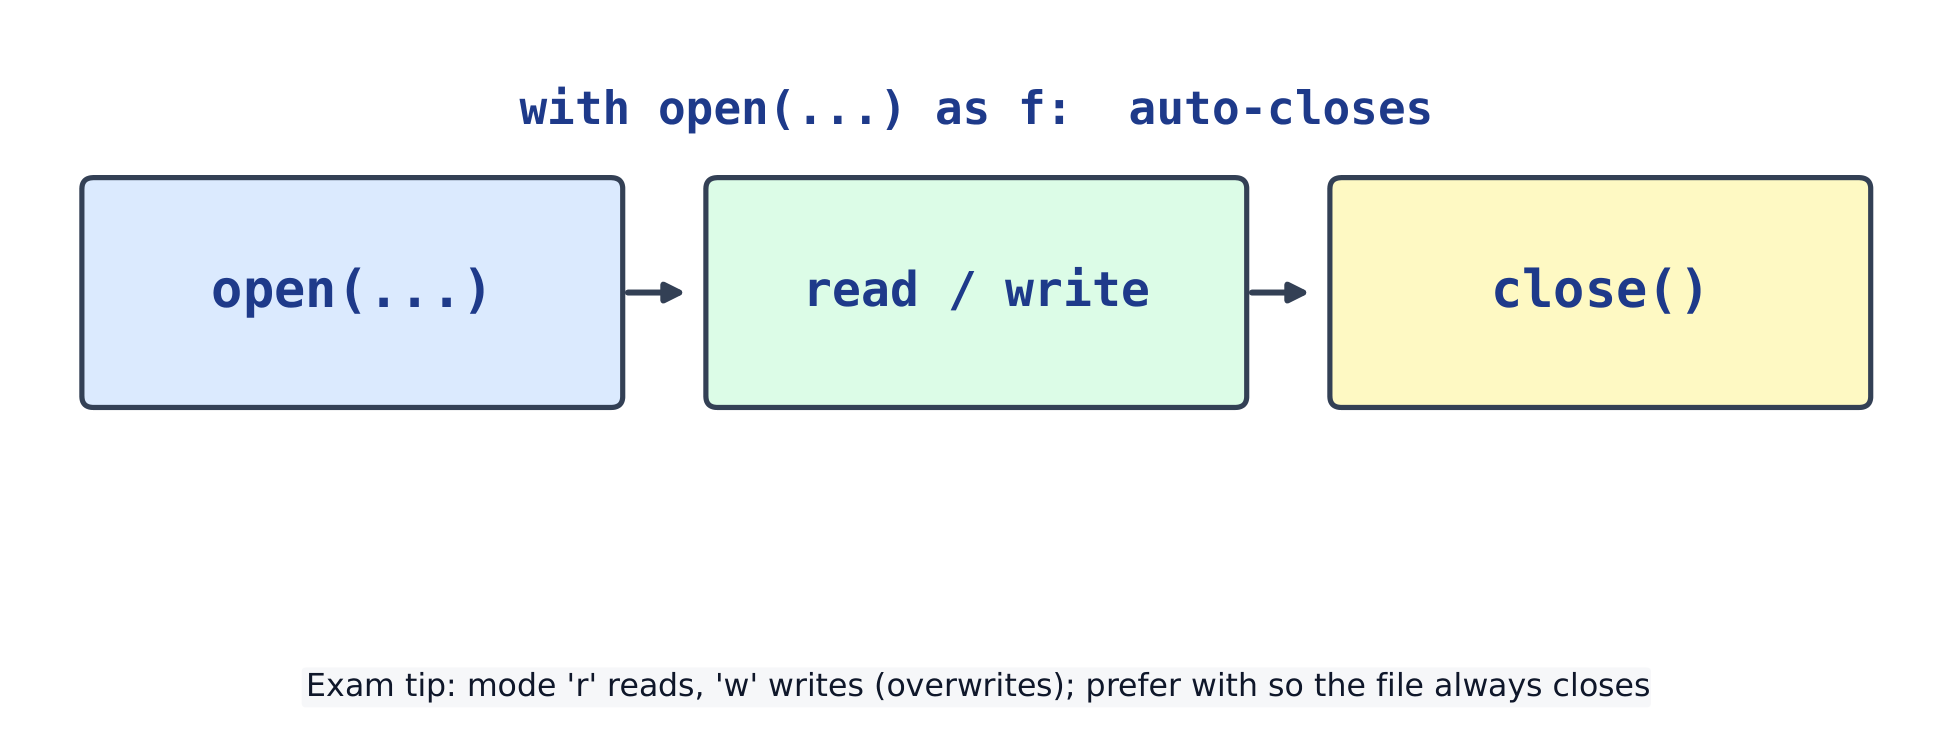
Un fichier texte 文本文件 stocke du texte sur le disque. Ouvrez-le avec open(name, mode) où mode 模式 indique la lecture ou l'écriture. Utilisez toujours with, qui ferme le fichier pour vous.
Écriture
Le mode "w" écrit un nouveau fichier et efface l'ancien.
with open("notes.txt", "w") as f:
    f.write("first line\n")
    f.write("second line\n")
print("saved")            # saved
Lecture
Le mode "r" (par défaut) lit. .read() retourne tout le fichier comme une seule chaîne.
with open("notes.txt", "w") as f:
    f.write("hello\nworld\n")
with open("notes.txt") as f:
    print(f.read().strip())   # hello / world
Ligne par ligne
Parcourez le fichier pour obtenir une ligne à la fois. .strip() retire 去除 le caractère de nouvelle ligne 换行符 à la fin.
with open("data.txt", "w") as f:
    f.write("Mei,88\nSam,71\n")
with open("data.txt") as f:
    for line in f:
        name, score = line.strip().split(",")
        print(name, "scored", score)
# Mei scored 88
# Sam scored 71
Ajout
Le mode "a" ajoute 追加 à la fin sans effacer.
with open("log.txt", "w") as f:
    f.write("line 1\n")
with open("log.txt", "a") as f:
    f.write("line 2\n")
with open("log.txt") as f:
    print(f.read().strip())   # line 1 / line 2
Mode
Signification
"r"
lecture (par défaut)
"w"
écriture (efface d'abord)
"a"
ajout (ajoute à la fin)
Erreurs courantes
Fermez toujours un fichier, ou utilisez with open(...) as f: qui le ferme pour vous.
read() retourne tout le fichier comme une seule chaîne, et chaque ligne se termine encore par \n.
Ouvrir avec "w" efface d'abord le fichier ; utilisez "a" pour ajouter à la fin.
Un algorithme est une liste claire d'étapes résolvant un problème. La décomposition consiste à découper un grand problème en petites parties que l'on peut résoudre les unes après les autres.
# Algorithm: find the largest number in a list
def largest(nums):
    best = nums[0]
    for n in nums:
        if n > best:
            best = n
    return best

print(largest([3, 9, 2, 7]))   # 9
L'abstraction signifie ignorer les détails : vous utilisez le largest(...) sans avoir à relire son fonctionnement interne.
11.2
Pseudocode et diagrammes de flux
Le pseudocode est un anglais structuré simple pour un algorithme, écrit avant le vrai code. Il n'est pas exécuté.
SET best TO first number
FOR Each number n
    IF n > best
      THEN
        SET best TO n
OUTPUT best
Un organigramme dessine le même plan : une boîte pour chaque étape, un losange pour chaque décision, et des flèches pour l'ordre.
11.3
Récursivité et pile d'appels
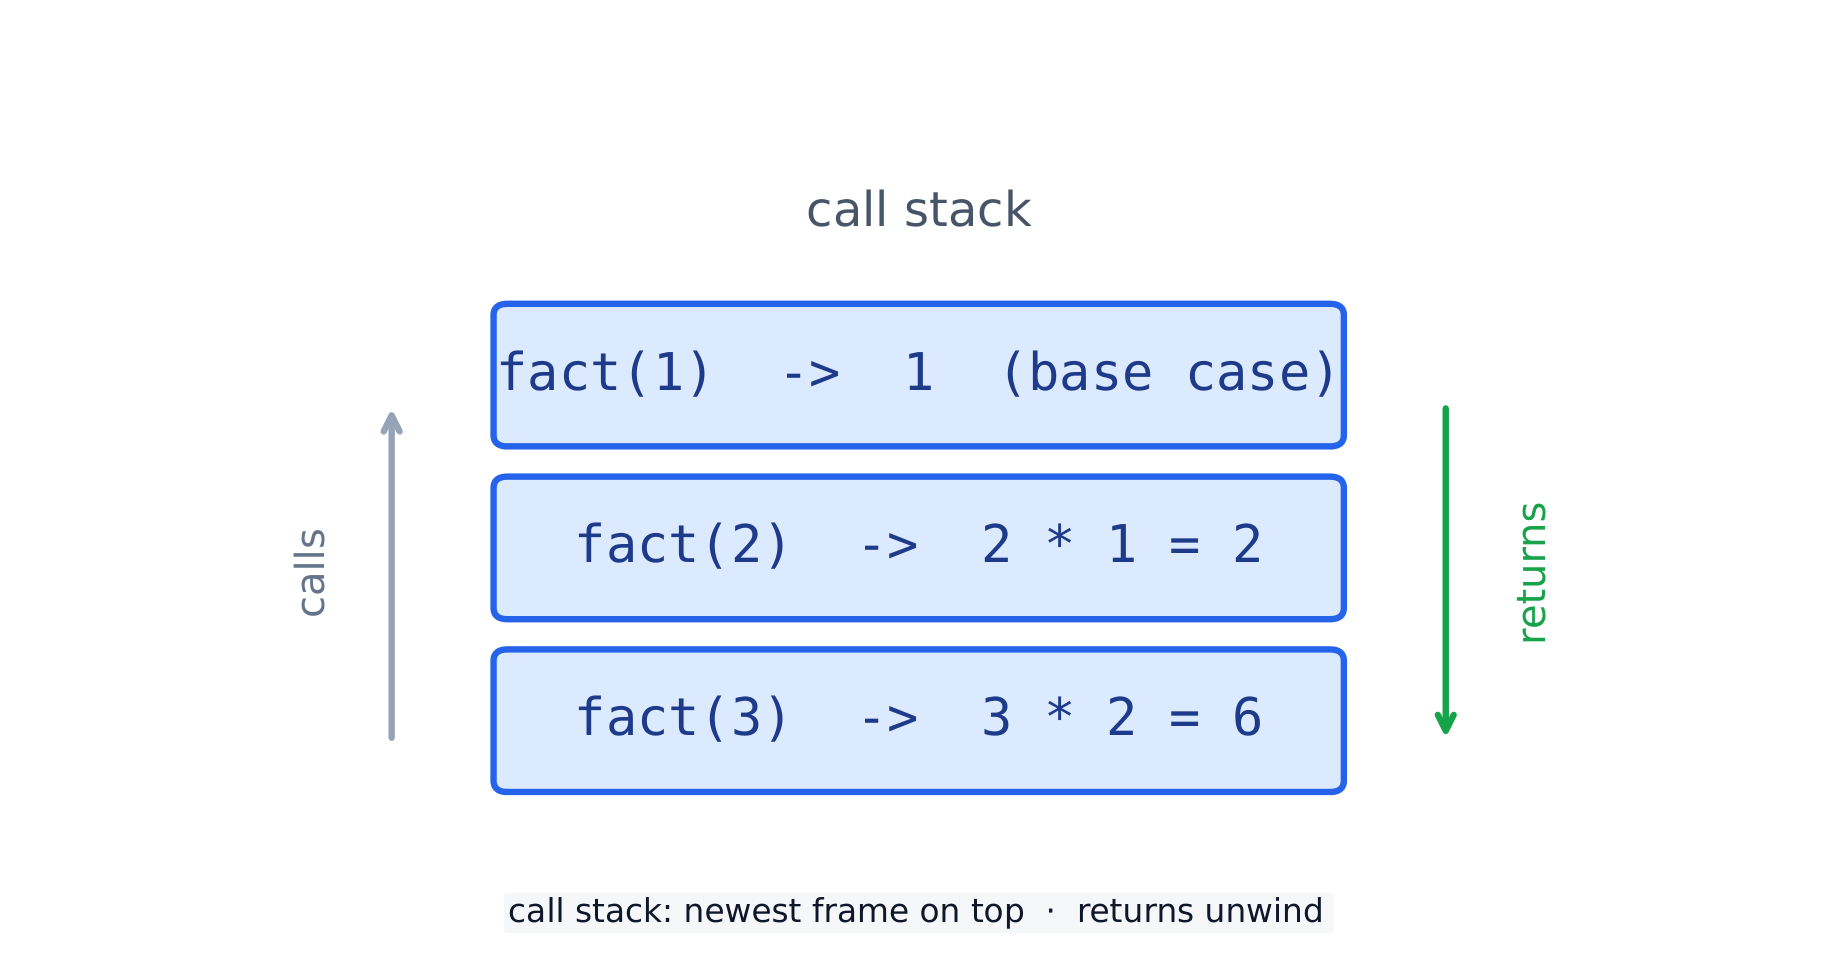
La récursion se produit lorsqu'une fonction s'appelle elle-même. Elle nécessite un cas de base (une entrée simple qui retourne immédiatement) et un cas récursif (elle s'appelle elle-même sur une entrée plus petite).
La pile d'appels pour factorial(3) : chaque appel attend, puis retourne dans l'ordre inverse
def fact(n):
    return 1 if n <= 1 else n * fact(n - 1)

print(fact(5))     # 120
Chaque appel en pause repose sur la pile d'appels jusqu'à ce que l'appel supérieur retourne.
Erreurs courantes
La récursivité a besoin d'un cas de base, sinon elle s'appelle éternellement et fait déborder la pile d'appels.
Le pseudocode sert à planifier — il n'a pas besoin de s'exécuter, mais chaque étape doit être sans ambiguïté.
Divisez un grand problème en petites étapes nommées avant d'écrire du code.
Un type de données abstrait 抽象数据类型 (ADT) décrit des données ainsi que les opérations dessus, séparément de sa mise en œuvre. Vous l'utilisez via ses opérations, pas via son stockage interne.
# A stack ADT, built on a list
s = []
s.append(1)        # add
s.append(2)
print(s.pop())     # 2  (remove the most recent)
12.2
Piles
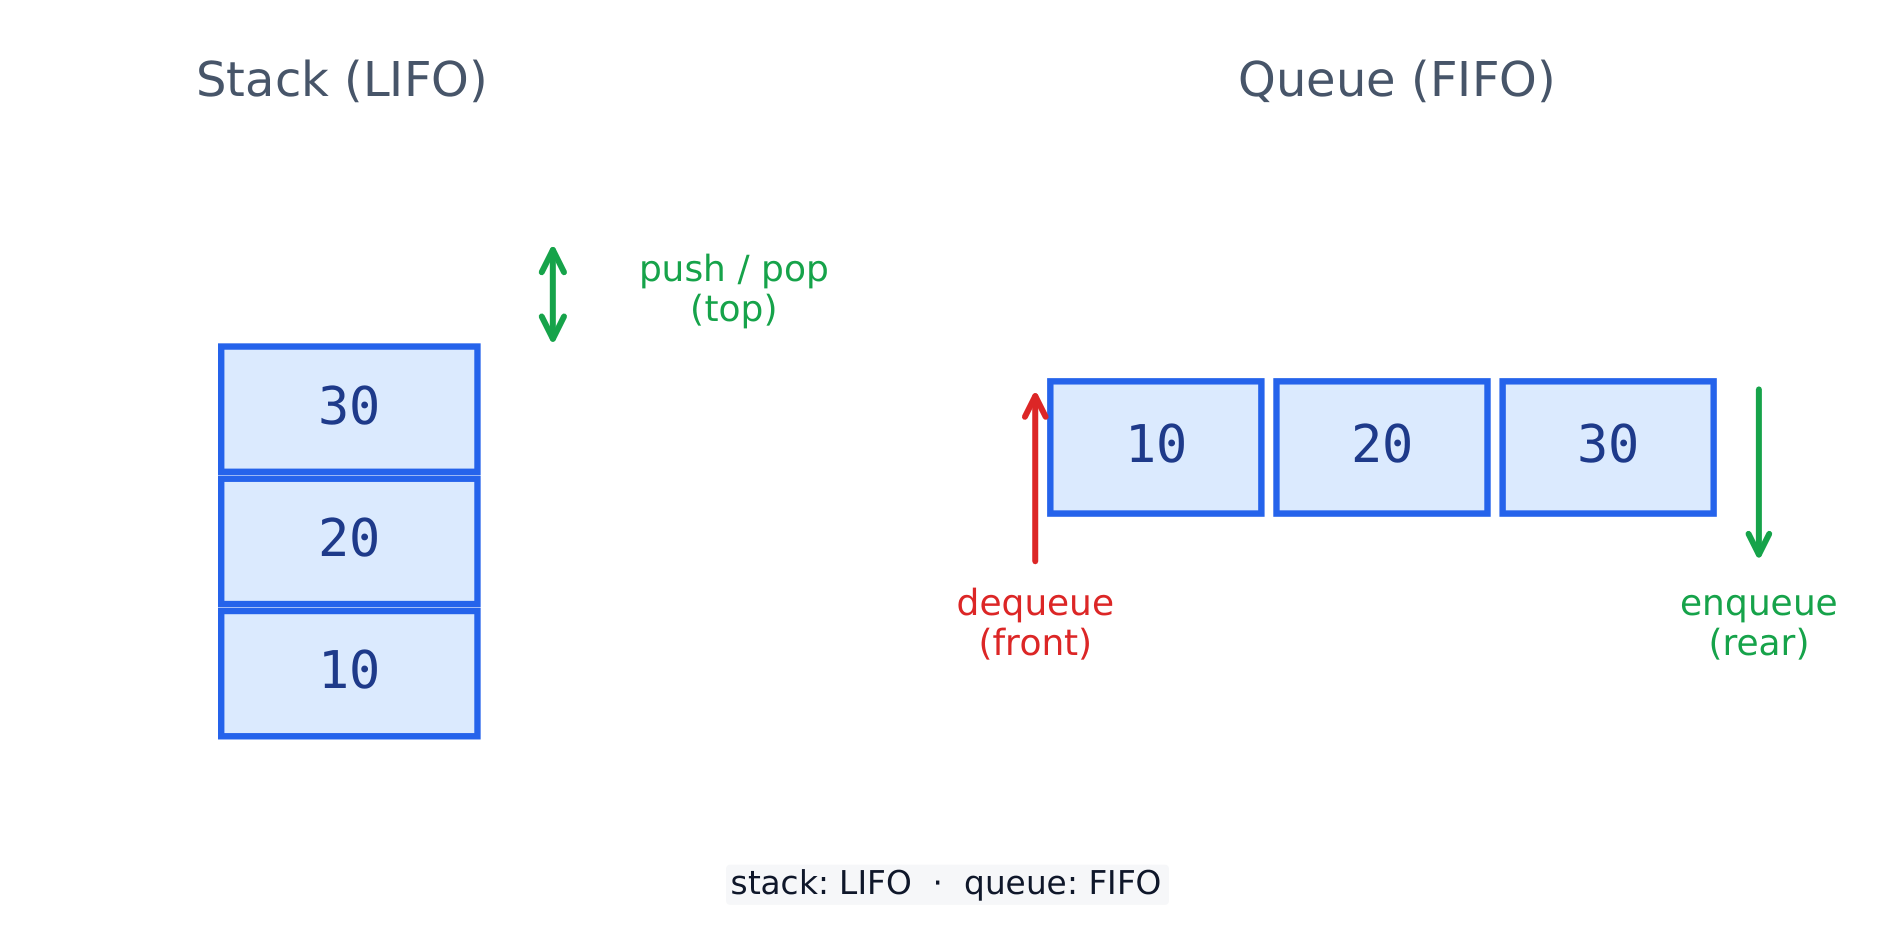
Une pile 栈 est Last-In-First-Out (LIFO 后进先出). Vous empilez 压入 sur le dessus et dépilez 弹出 depuis le dessus.
Une pile retire depuis le haut (LIFO) ; une file retire depuis l'avant (FIFO)
stack = []
stack.append("a")
stack.append("b")
print(stack.pop())   # b
print(stack.pop())   # a
12.3
Fichiers
Une file 队列 est First-In-First-Out (FIFO 先进先出). Vous insérez 入队 à l'arrière et retirez 出队 depuis l'avant.
queue = []
queue.append("a")     # enqueue
queue.append("b")
print(queue.pop(0))   # a  (dequeue the front)
print(queue.pop(0))   # b
12.4
Listes chainées
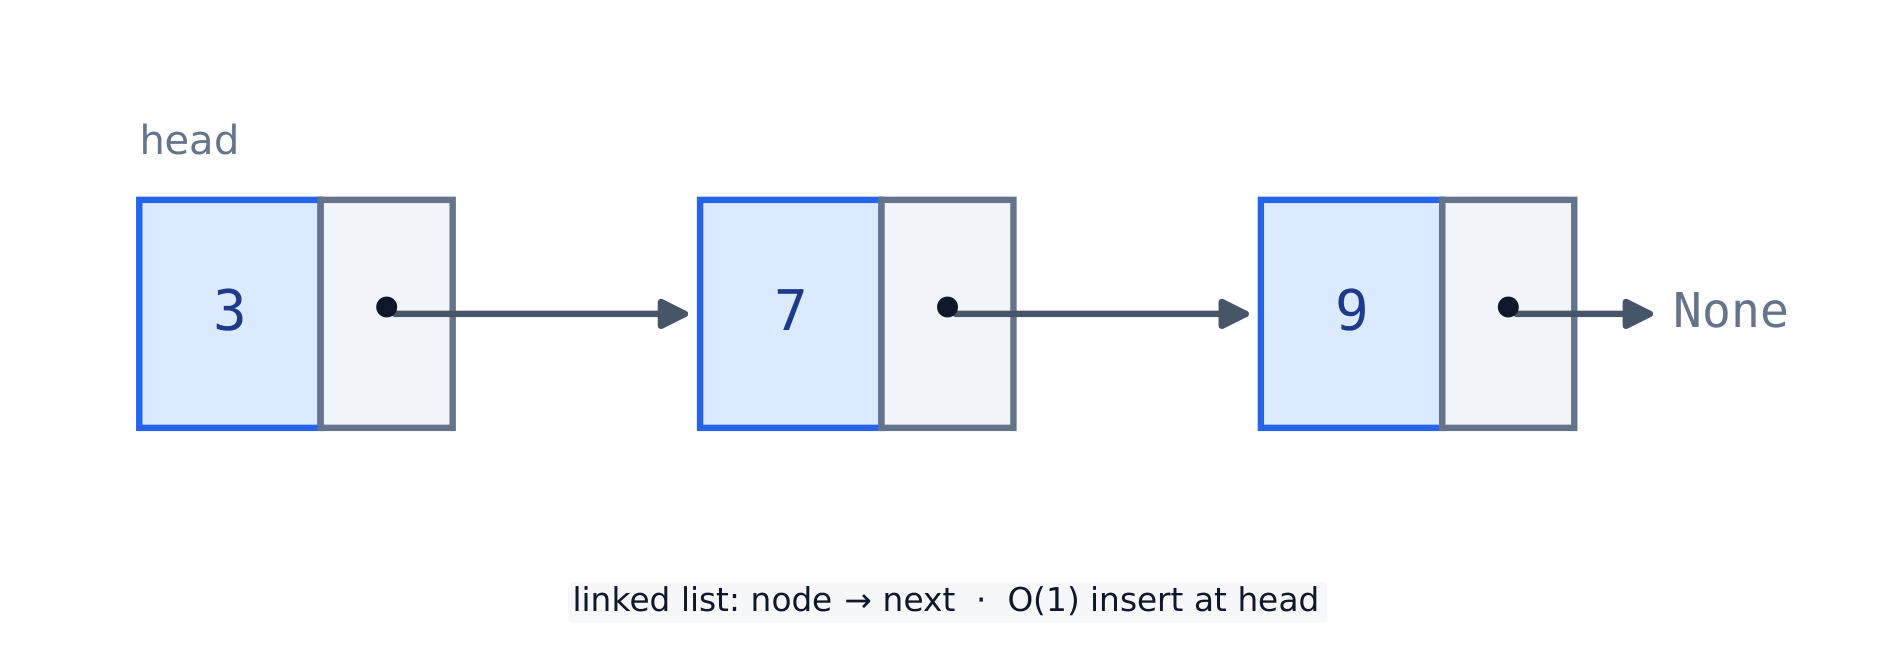
Une liste chaînée 链表 est une chaîne de nœuds 节点. Chaque nœud contient des données et un pointeur 指针 vers le nœud suivant ; le dernier pointe vers None.
Une liste chaînée : chaque noeud contient des données et un pointeur vers le noeud suivant, se terminant par None
n3 = {"data": 3, "next": None}
n2 = {"data": 2, "next": n3}
n1 = {"data": 1, "next": n2}
node = n1
while node is not None:      # traverse to the end
    print(node["data"])
    node = node["next"]
# 1 2 3
12.5
Tables de hachage
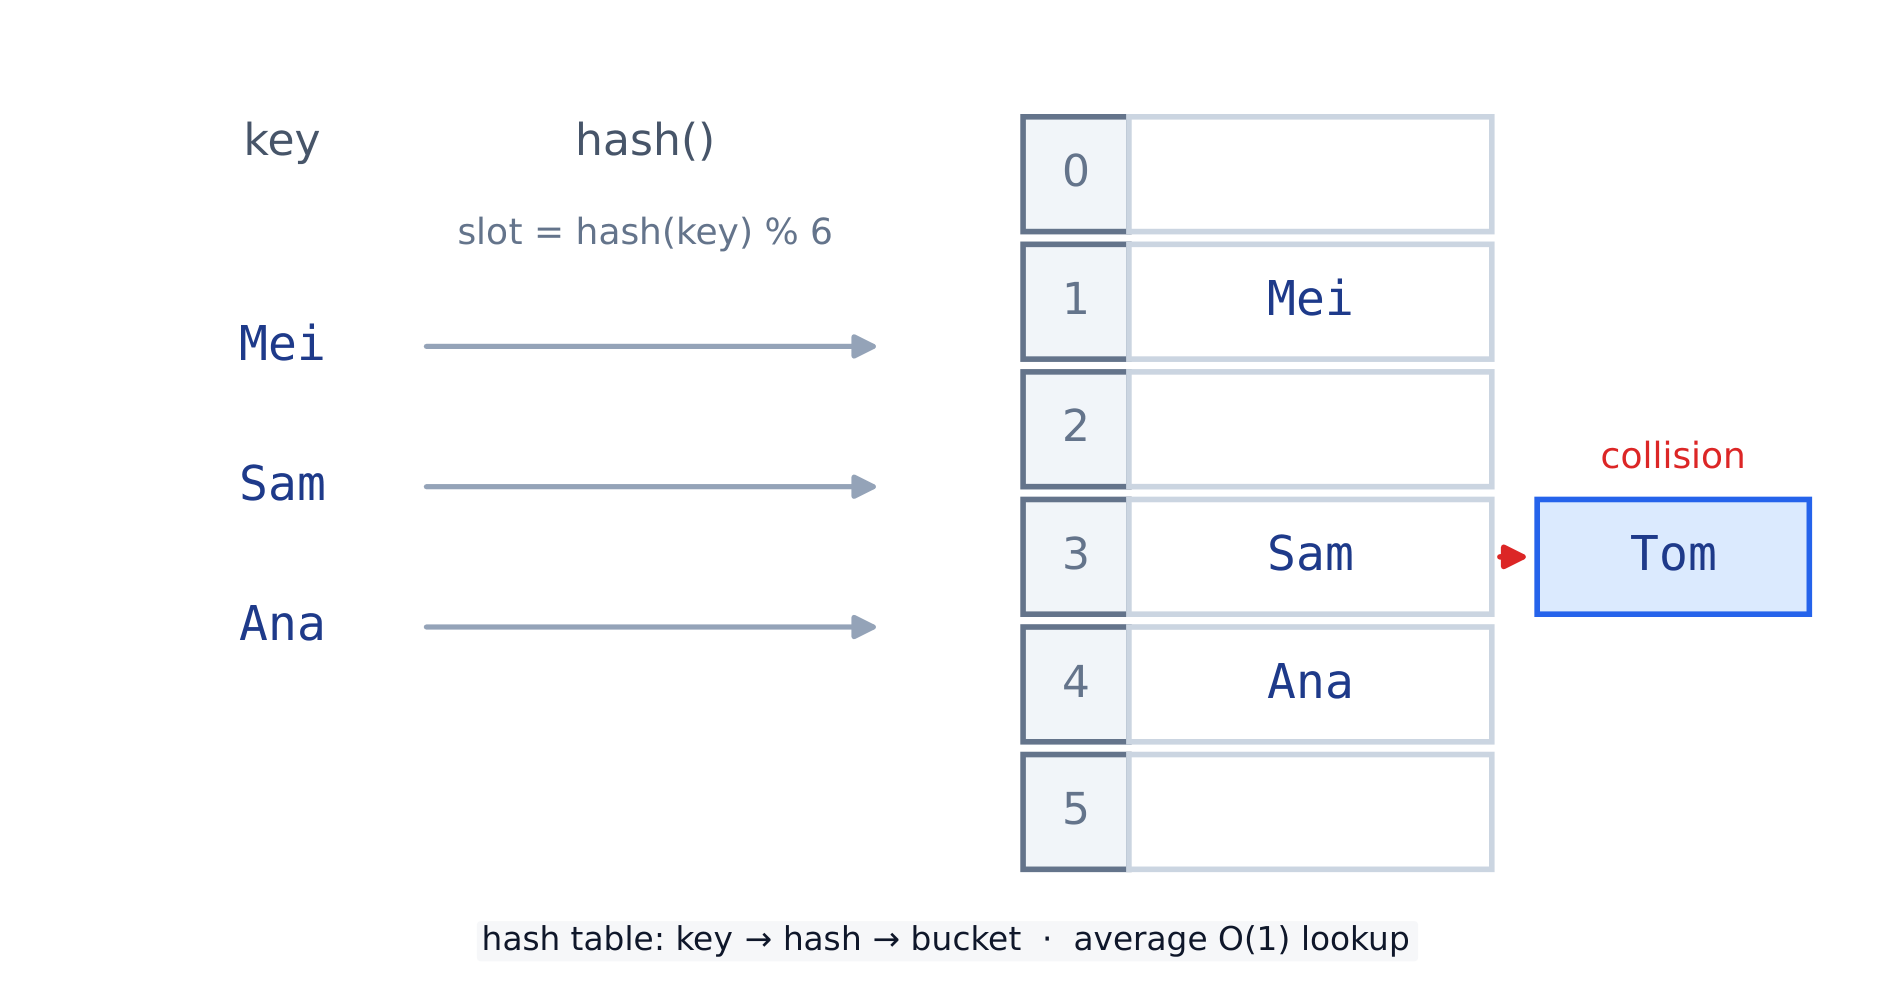
Une table de hachage 哈希表 associe une clé à une case via une fonction de hachage 哈希函数. Deux clés peuvent atterrir dans la même case — c'est une collision 冲突. Python's dict est une table de hachage, donc la recherche est rapide.
Une fonction de hachage mappe chaque clé à un emplacement ; deux clés peuvent entrer en collision dans un même emplacement
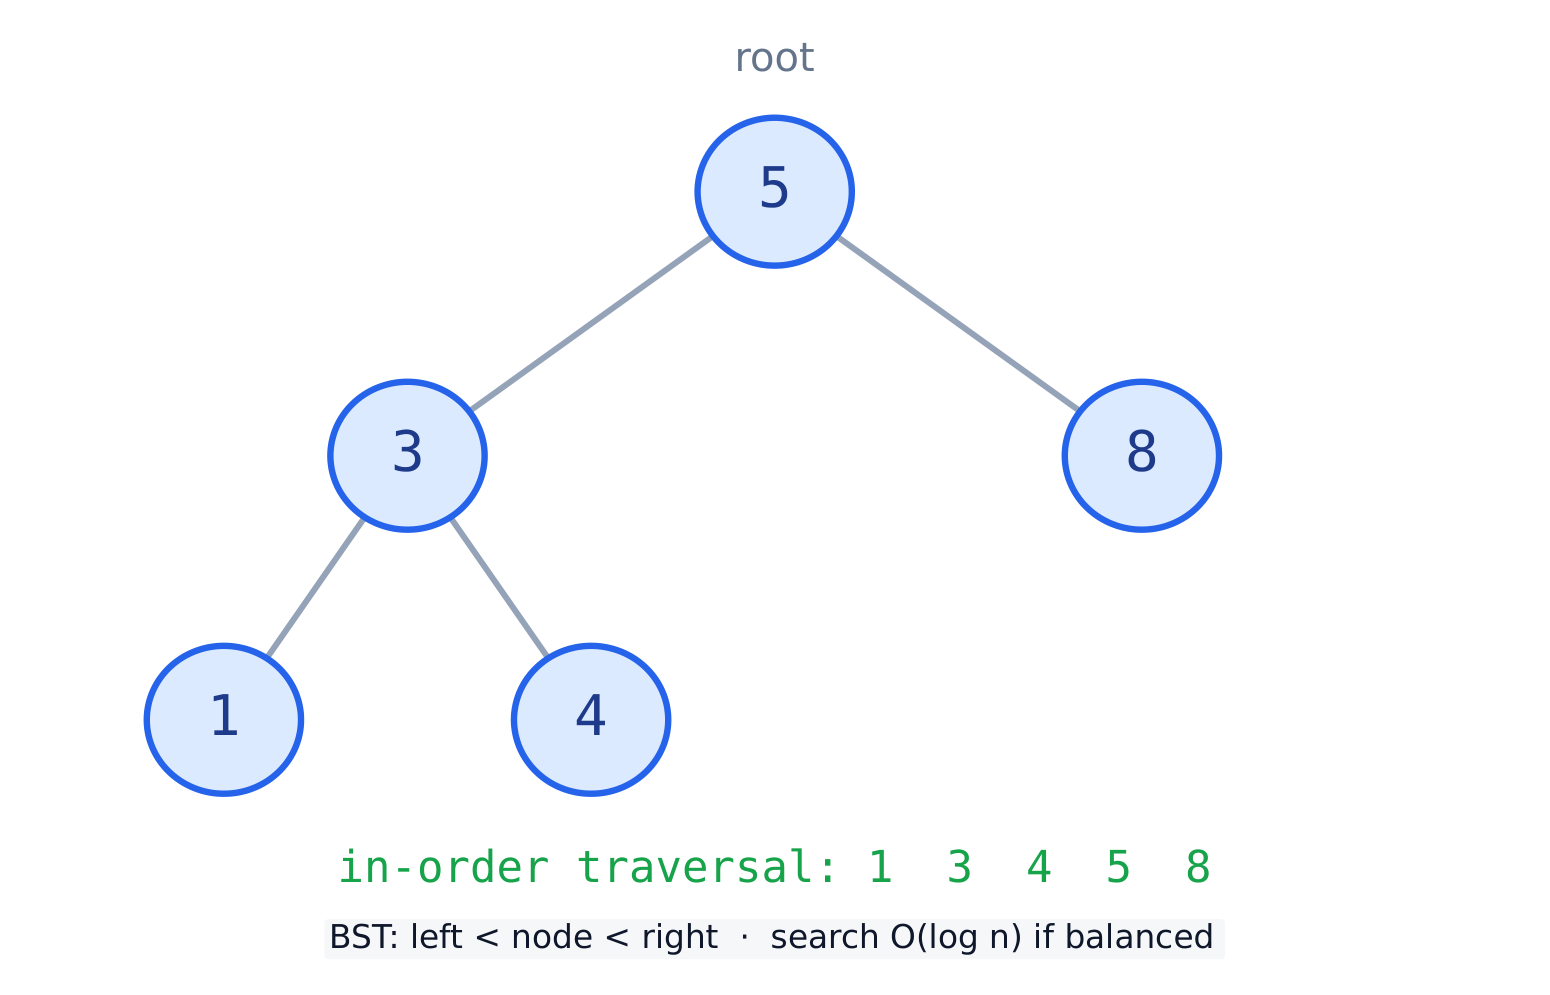
Un arbre binaire de recherche 二叉搜索树 (BST) maintient l'ordre : chaque enfant gauche est plus petit que son nœud, chaque enfant droit est plus grand. La recherche reste rapide.
Un arbre binaire de recherche : les valeurs plus petites vont à gauche, les plus grandes à droite
def insert(root, val):
    if root is None:
        return {"val": val, "left": None, "right": None}
    if val < root["val"]:
        root["left"] = insert(root["left"], val)
    else:
        root["right"] = insert(root["right"], val)
    return root

def inorder(root):
    if root is None:
        return []
    return inorder(root["left"]) + [root["val"]] + inorder(root["right"])

tree = None
for v in [5, 3, 8, 1, 4]:
    tree = insert(tree, v)
print(inorder(tree))   # [1, 3, 4, 5, 8]
12.7
Graphes
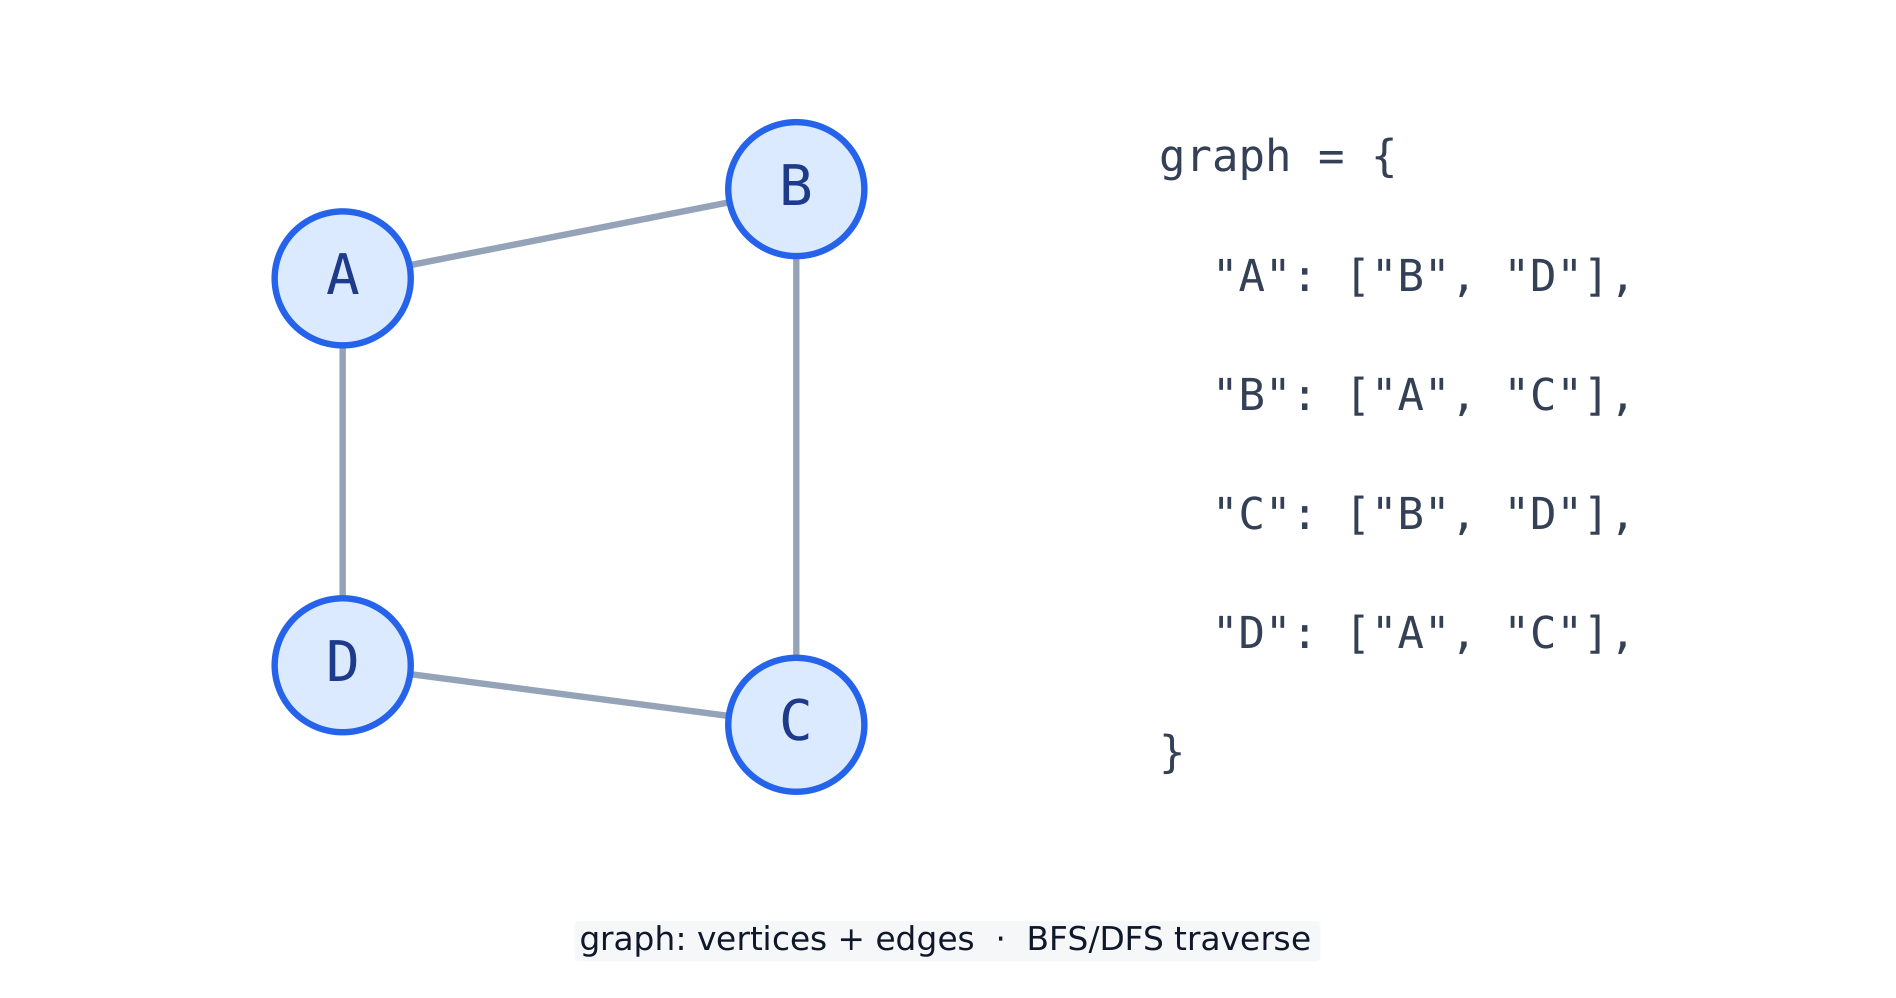
Un graphe 图 est un ensemble de sommets 顶点 joints par des arêtes 边. Une liste d'adjacence 邻接表 — un dictionnaire de listes de voisins — est une méthode courante pour le stocker.
Un graphe de sommets et d'arêtes, avec sa forme de liste d'adjacence
graph = {"A": ["B", "D"], "B": ["A", "C"], "C": ["B", "D"], "D": ["A", "C"]}
for vertex in graph:
    print(vertex, "->", graph[vertex])
# A -> ['B', 'D']  (and so on for B, C, D)
Erreurs courantes
Une pile est Last-In-First-Out ; une file est First-In-First-Out. Ne les mélangez pas.
Vérifiez si une structure est vide avant de dépiler ou de retirer de la file.
Dans une liste chaînée, perdre le pointeur head fait perdre toute la liste.
Une recherche 查找 trouve où se trouve une valeur. La recherche linéaire 线性查找 vérifie chaque élément à tour de rôle, donc elle fonctionne sur n'importe quelle liste.
def linear_search(items, target):
    for i in range(len(items)):
        if items[i] == target:
            return i
    return -1     # not found

print(linear_search([4, 8, 2, 9], 2))   # 2
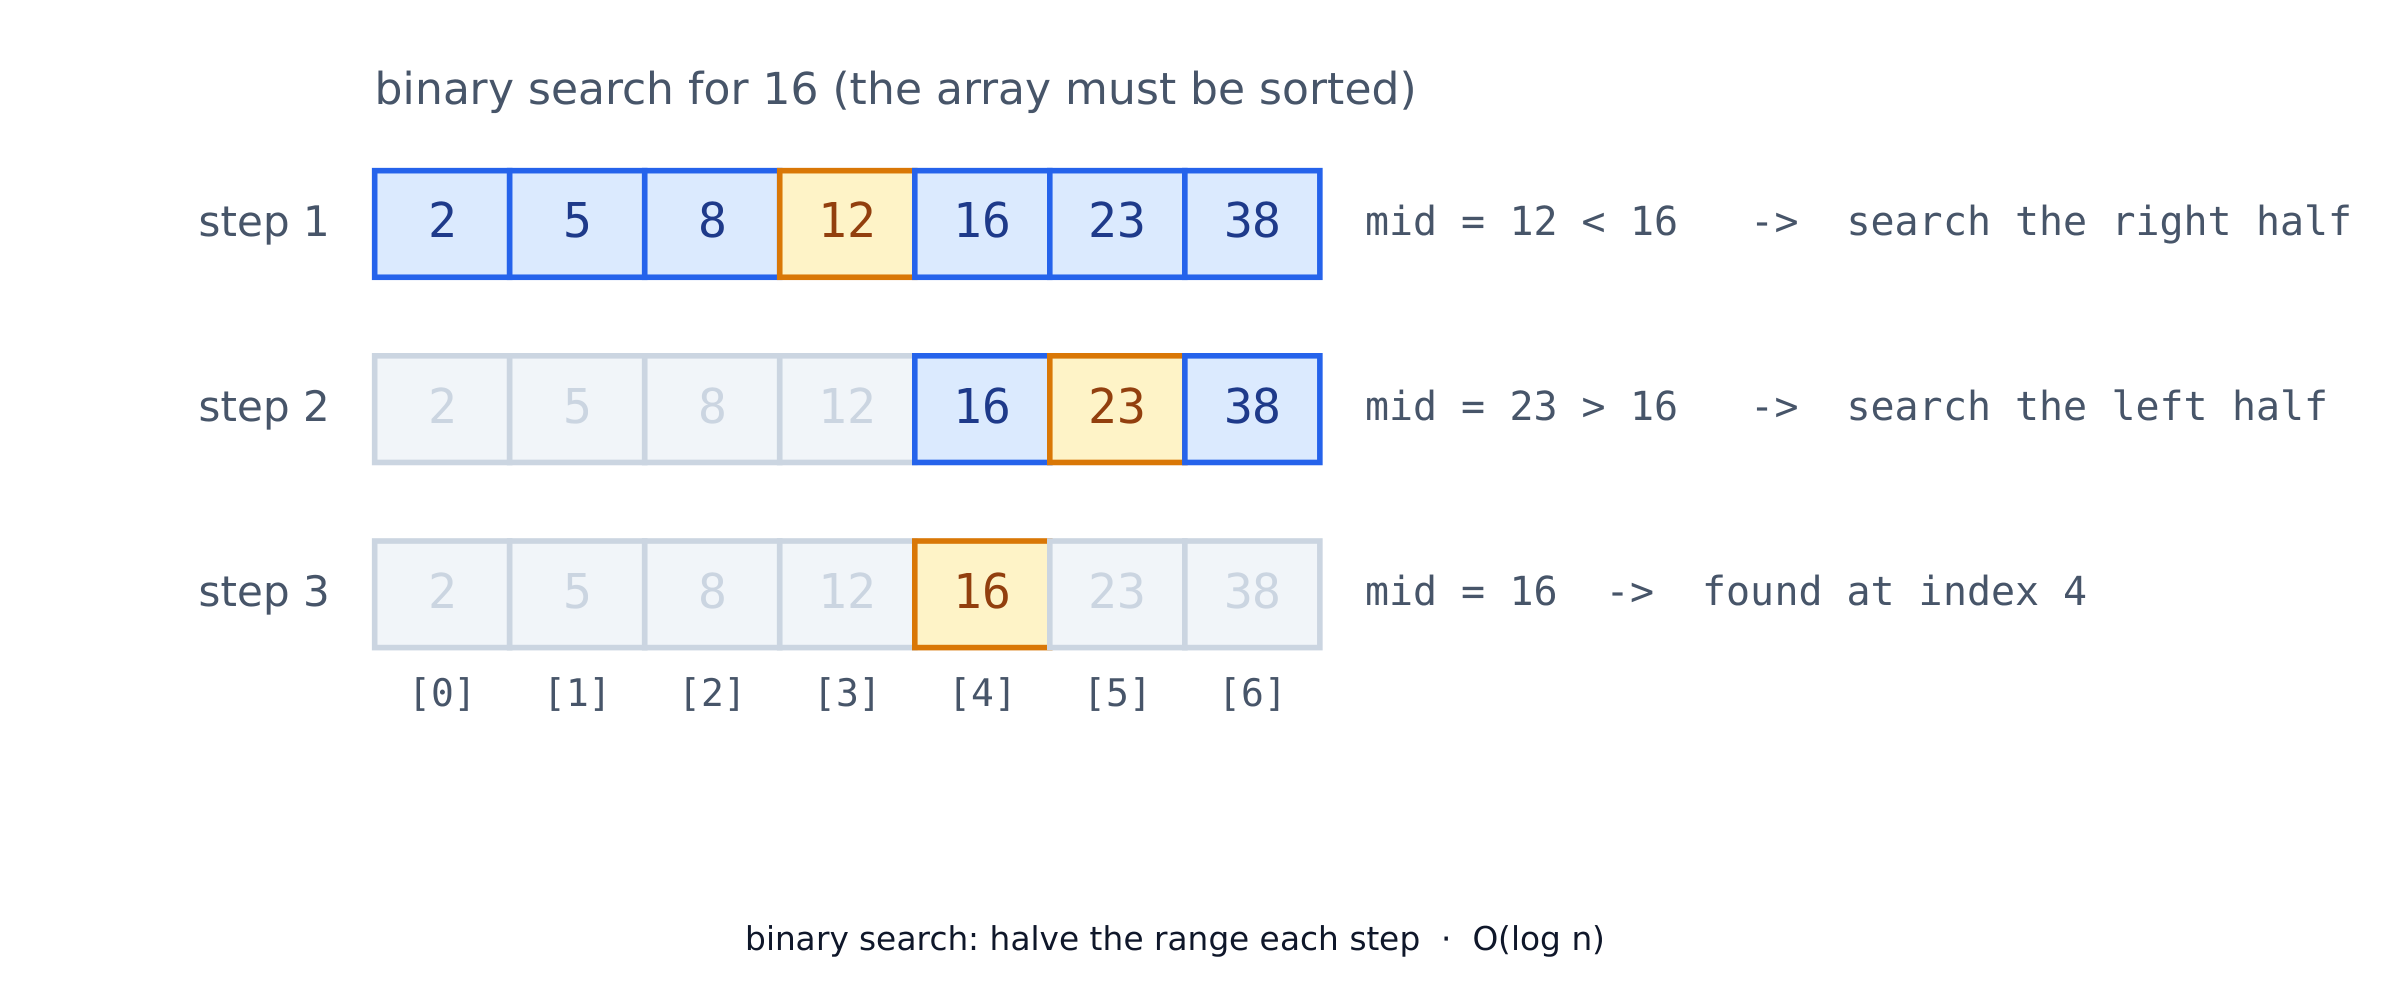
La recherche dichotomique 二分查找 est beaucoup plus rapide mais nécessite une liste triée. Elle divise la plage par deux à chaque étape.
def binary_search(items, target):
    lo, hi = 0, len(items) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if items[mid] == target:
            return mid
        elif items[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

print(binary_search([1, 3, 5, 7, 9], 7))   # 3
La recherche dichotomique divise la plage par deux à chaque étape — O(log n) sur une liste triée
13.2
Tri (bulle et insertion)
Trier 排序 consiste à mettre les éléments dans l'ordre. Le tri bulle 冒泡排序 échange répétitivement les voisins qui sont dans le mauvais ordre.
def bubble_sort(a):
    a = a[:]                          # work on a copy
    for i in range(len(a)):
        for j in range(len(a) - 1 - i):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
    return a

print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
Le tri par insertion 插入排序 construit une partie triée un élément à la fois, glissant chaque nouvel élément à sa place :
def insertion_sort(a):
    a = a[:]                           # work on a copy
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:   # shift bigger values right
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key                 # drop key into the gap
    return a

print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
En code réel, utilisez le built-in Python sorted() :
print(sorted([5, 2, 4, 1])) # [1, 2, 4, 5]
13.3
Efficacité algorithmique
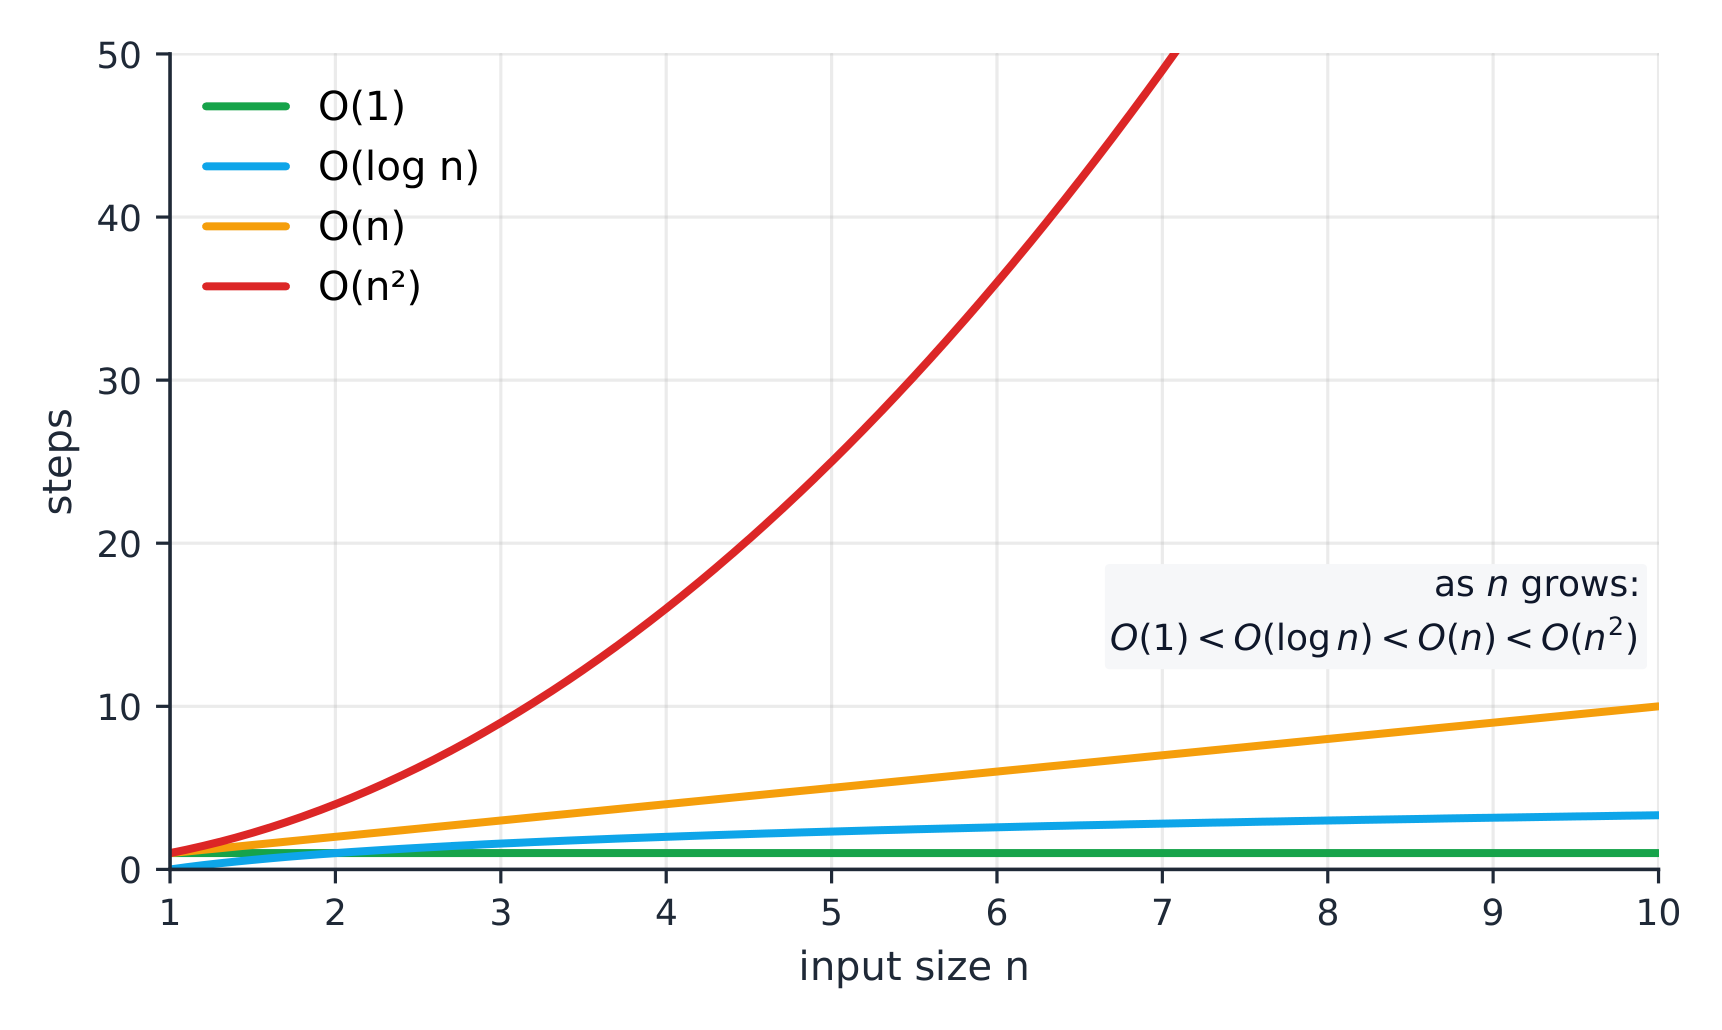
L'efficacité 效率 examine comment le travail augmente lorsque l'entrée augmente. Nous la décrivons avec la notation Big-O 大O记号.
Comment le nombre d'étapes croît avec la taille de l'entrée pour les complexités courantes
Big-O
Nom
Exemple
$O(1)$
constant
look up a dict key
$O(\log n)$
logarithmique
binary search
$O(n)$
linéaire
linear search
$O(n^2)$
quadratique
bubble sort
def steps(n):           # how many steps a linear scan takes
    count = 0
    for i in range(n):
        count = count + 1
    return count

print(steps(100))       # 100  -> O(n)
13.4
Aléatoire et simulation
Le module random génère des nombres aléatoires. Utilisez une graine 种子 pour rendre les résultats reproductibles. Une simulation 模拟 exécute de nombreux essais aléatoires pour estimer une réponse.
import random
random.seed(0)
rolls = [random.randint(1, 6) for _ in range(1000)]
print(rolls.count(6))   # about 1/6 of 1000
Erreurs courantes
La recherche dichotomique ne fonctionne que sur une liste triée.
Big-O vous dit comment le temps CROÎTRAIT, pas le temps exact ; une méthode O(n²) bat O(n) seulement pour de minuscules entrées.
Le tri bulle est O(n²) — bien pour apprendre, mais lent sur de grandes listes.
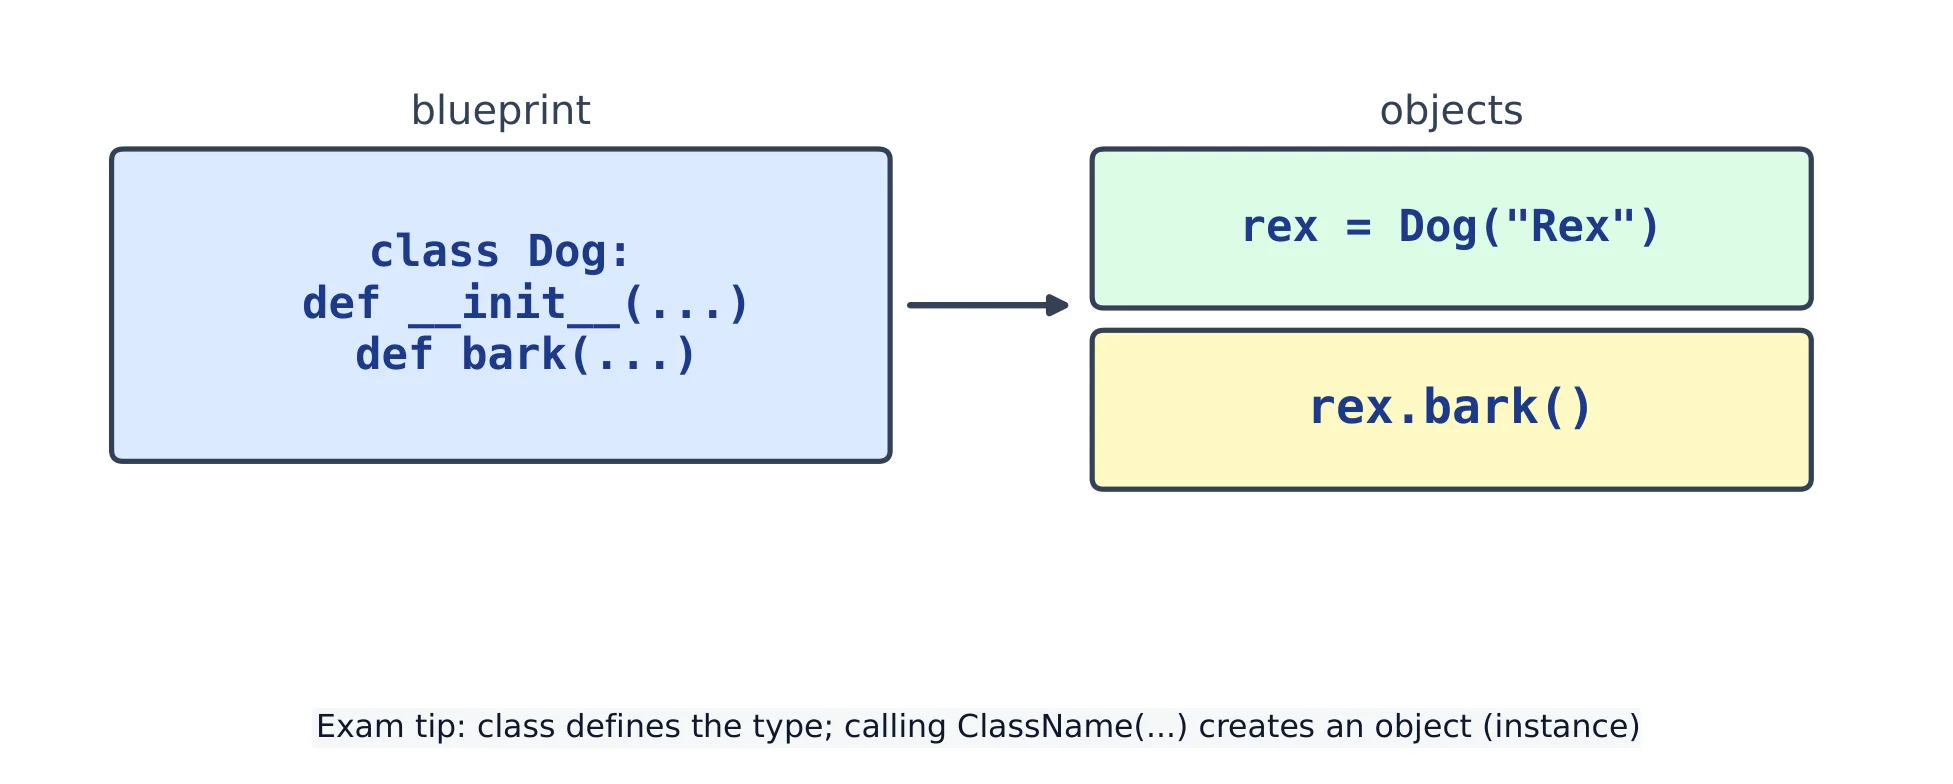
Une classe est un modèle. Un objet est une entité construite à partir de celui-ci (une instance). __init__ est le constructeur qui initialise chaque objet ; self est l'objet lui-même.
class Dog:
    def __init__(self, name):
        self.name = name            # an attribute
    def speak(self):
        return self.name + " says woof"

d = Dog("Rex")
print(d.speak())     # Rex says woof
name est un attribut (données sur l'objet) ; speak est une méthode (une action).
Ajoutez __str__ pour contrôler ce que montre print(obj) :
class Dog:
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return f"Dog named {self.name}"

print(Dog("Rex"))    # Dog named Rex
Une classe est un modèle ; son appel crée un objet
14.2
Héritage, encapsulation et polymorphisme
L'héritage permet à une sous-classe de réutiliser une superclasse. Utilisez super() pour appeler le parent ; redéfinissez une méthode pour la modifier.
class Animal:
    def speak(self):
        return "some sound"

class Cat(Animal):
    def speak(self):                # override
        return "meow"

print(Cat().speak())   # meow
L'encapsulation regroupe les données avec les méthodes et expose une interface prévue. En Python, un underscore initial marque un nom intentionnellement non public (souvent appelé privé) par convention ; cela n'empêche pas le code externe de y accéder. Le manglement de noms à double underscore aide à éviter les conflits accidentels de noms entre sous-classes, mais ne sert pas à imposer la sécurité.
class Account:
    def __init__(self):
        self._balance = 0           # non-public by convention
    def deposit(self, n):
        self._balance += n
    def balance(self):
        return self._balance

a = Account()
a.deposit(50)
print(a.balance())     # 50
Le polymorphisme signifie un seul nom, plusieurs comportements : le bon speak s'exécute pour chaque objet.
class Cat:
    def speak(self):
        return "meow"

class Cow:
    def speak(self):
        return "moo"

for animal in [Cat(), Cow()]:
    print(animal.speak())   # meow, then moo
14.3
Paradigmes de programmation
Un paradigme est un style d'écriture de programmes. Le code procédural est une séquence d'étapes et de fonctions. Le code orienté objet regroupe les données et les méthodes dans des objets. Le code déclaratif dit ce que vous voulez, pas comment (une compréhension de liste ou SQL).
def total(nums):           # procedural
    t = 0
    for n in nums:
        t += n
    return t
print(total([1, 2, 3]))    # 6

print(sum([1, 2, 3]))      # 6  (declarative: same result)
Erreurs courantes
Chaque méthode a besoin de self comme premier paramètre.
__init__ met en place un nouvel objet et s'exécute automatiquement lors de sa création.
Deux objets de la même classe ont des attributs séparés ; modifier l'un ne modifie pas l'autre.
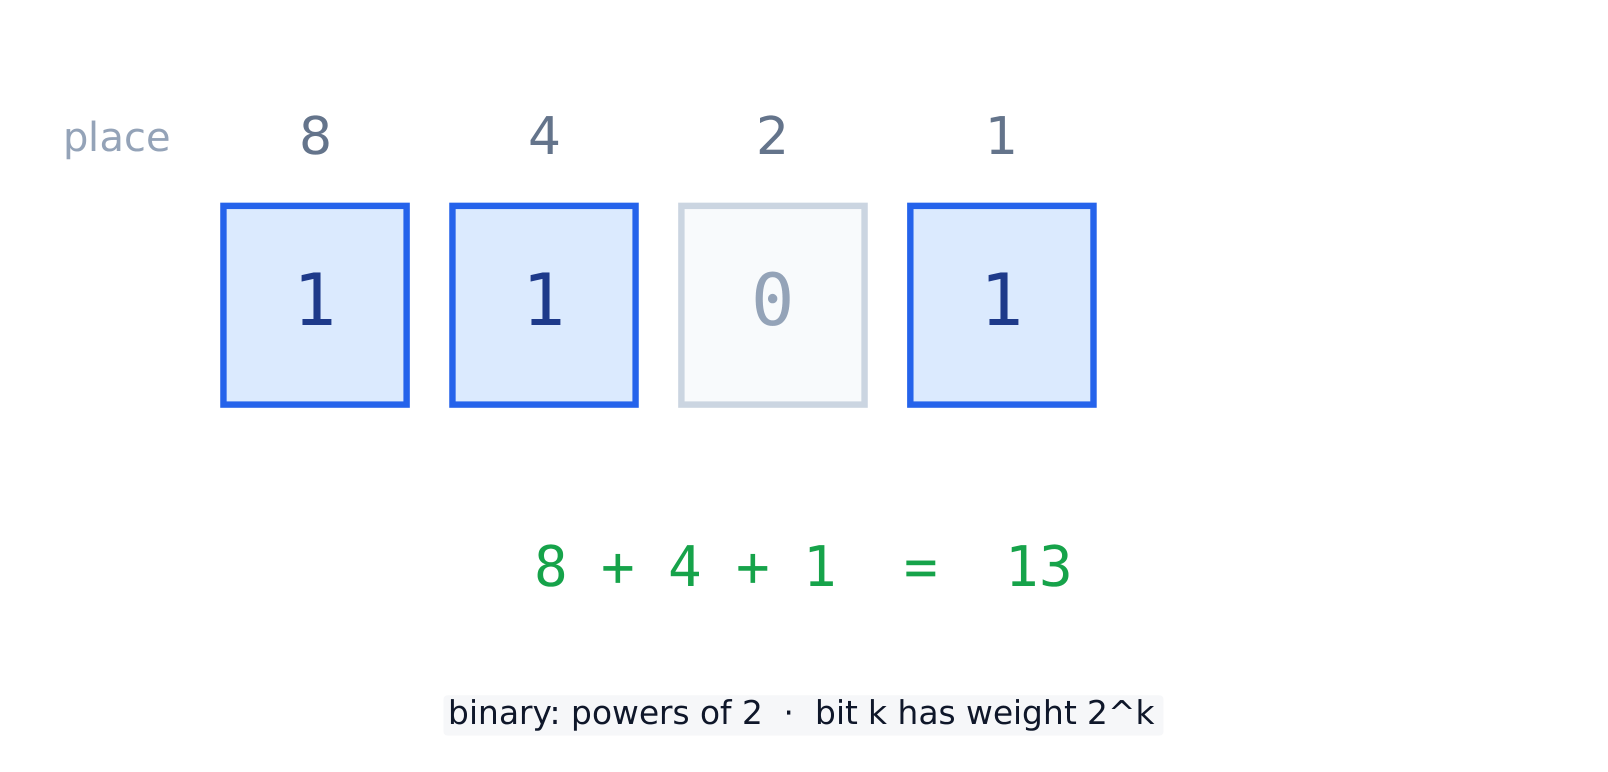
Un bit 比特 est un seul 0 ou 1. Le binaire 二进制 est le système numérique base-2 : chaque position vaut le double de celle de droite (1, 2, 4, 8, …). Le décimal 十进制 (base-10) correspond à nos nombres habituels.
8 bits font un octet 字节. Une largeur fixe peut déborder 溢出 (s'enrouler) lorsque le nombre est trop grand.
x = 250
x = (x + 10) % 256     # one byte wraps at 256
print(x)               # 4
L'hexadécimal 十六进制 (base 16) est une façon compacte de lire le binaire : un chiffre hexadécimal représente exactement quatre bits. Python écrit l'hexadécimal avec 0x :
La compression 压缩 rend les données plus petites. La compression sans perte 无损 compression conserve tous les bits, permettant de reconstruire l'original exactement. La compression avec perte 有损 compression jette des détails — plus petite mais pas exacte — et est utilisée pour les photos et la musique.
Le codage par longueur de run 游程编码 est une simple méthode sans perte : stocker un run 游程 (une répétition) comme un compteur suivi de la valeur.
def rle(text):
    out = ""
    i = 0
    while i < len(text):
        run = 1
        while i + run < len(text) and text[i + run] == text[i]:
            run += 1
        out += str(run) + text[i]
        i += run
    return out

print(rle("AAAABBBCCD"))   # 4A3B2C1D
Erreurs courantes
n bits stockent 2**n valeurs différentes, de 0 à 2**n - 1.
La compression avec perte jette des détails et ne peut pas être annulée ; la sans perte peut être inversée exactement.
Ce qu'est l'informatique et le cycle de conception
L'informatique 计算 signifie résoudre des problèmes avec des ordinateurs : entrée, traitement, sortie. Un bon logiciel est construit selon un cycle de conception 设计循环 — planifier, écrire, tester, améliorer — répété de nombreuses fois.
Décomposez un problème, construisez une petite partie, testez-la, puis ajoutez-en davantage.
Les programmeurs travaillent en équipe et réutilisent le code les uns des autres.
16.2
Internet
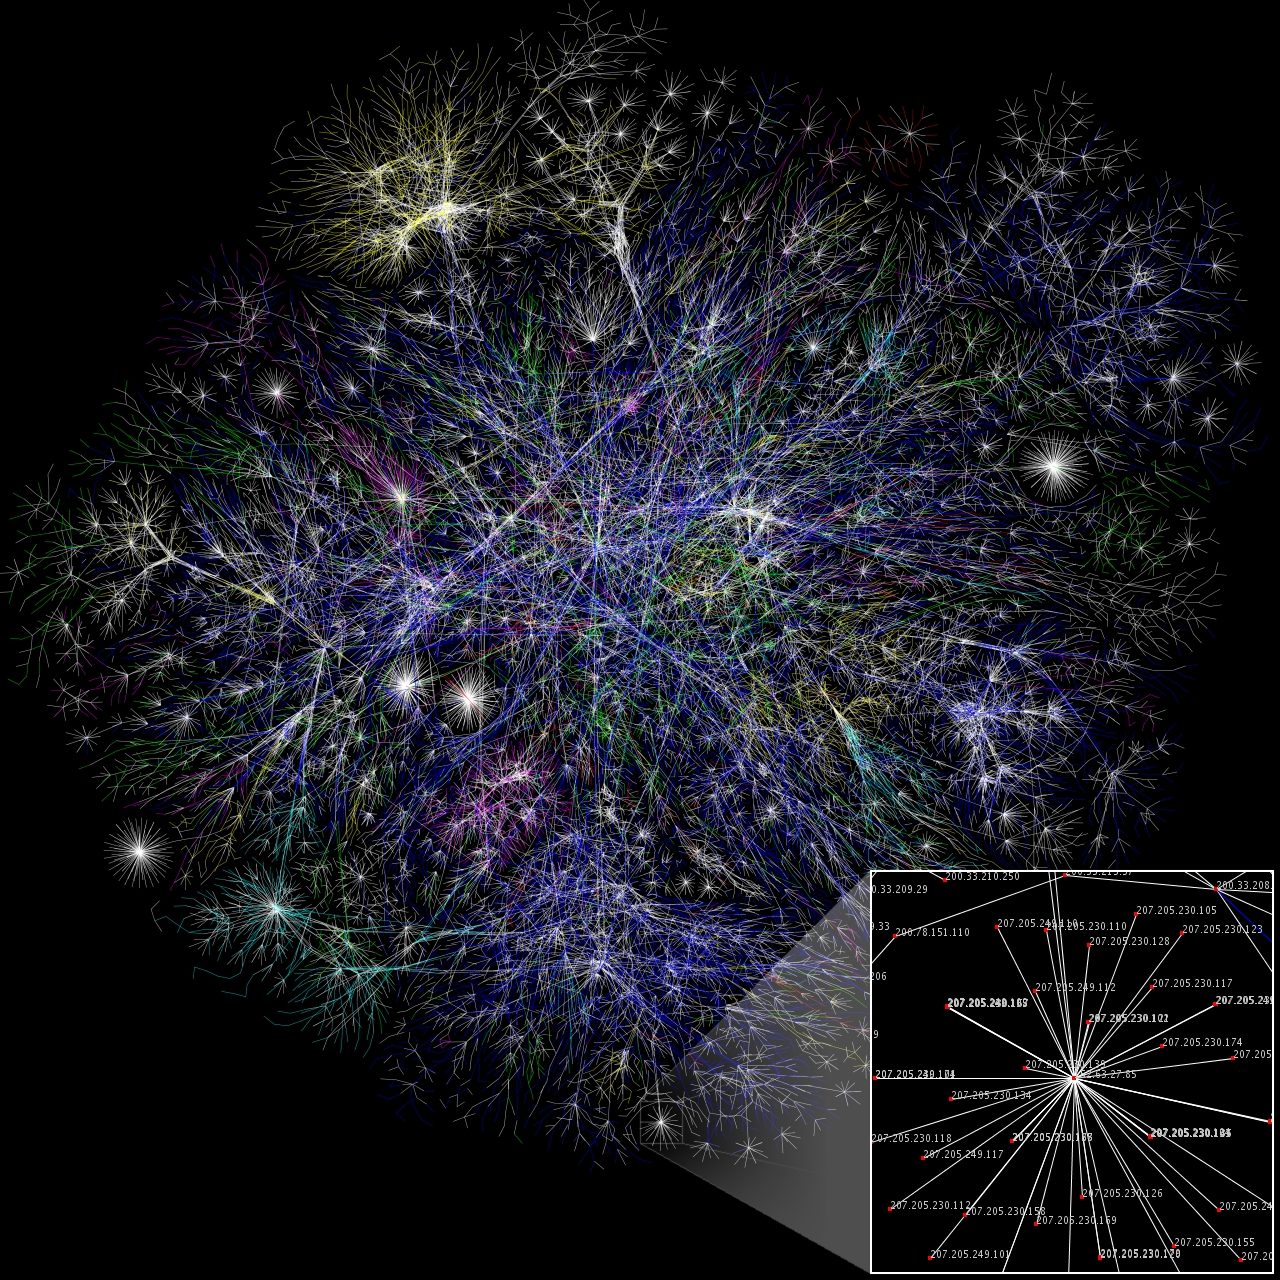
Internet 互联网 est un réseau 网络 de réseaux. Les données sont découpées en paquets 数据包 qui circulent séparément et sont reconstitués à l'autre extrémité. Des règles partagées appelées protocoles 协议 (comme TCP/IP) rendent cela possible. Si un chemin est interrompu, les paquets empruntent une autre voie — c'est la redondance 冗余, qui confère une tolérance aux pannes 容错.
Une carte d'Internet : chaque ligne représente un chemin entre deux réseaux
Couche
Rôle
HTTP
demande et envoie des pages web
TCP
livraison fiable, dans l'ordre
IP
adressage et routage
16.3
Calcul parallèle et distribué
Le code séquentiel 顺序 effectue une étape à la fois. Le calcul parallèle 并行 effectue plusieurs étapes simultanément sur de nombreux cœurs 核心, ce qui peut apporter un gain de performance 加速. Le calcul distribué 分布式 répartit la charge de travail sur plusieurs ordinateurs, comme dans le cloud.
Tout ne peut pas s'exécuter en parallèle : certaines étapes doivent attendre un résultat antérieur.
16.4
Impact du calcul
Le calcul apporte à la fois des avantages et des inconvénients. La fracture numérique 数字鸿沟 signifie que tout le monde n'a pas un accès égal. Les logiciels peuvent contenir des biais 偏见 tirés des données dont ils apprennent. Respectez la propriété intellectuelle 知识产权 (licences), et protégez les données personnelles 个人数据 et la vie privée 隐私 des personnes.
Erreurs courantes
Internet et le World Wide Web ne sont pas la même chose : le Web est un service qui fonctionne au-dessus d'Internet.
Avoir plus de cœurs de processeur n'est utile que si la tâche peut être divisée en parties exécutables simultanément.
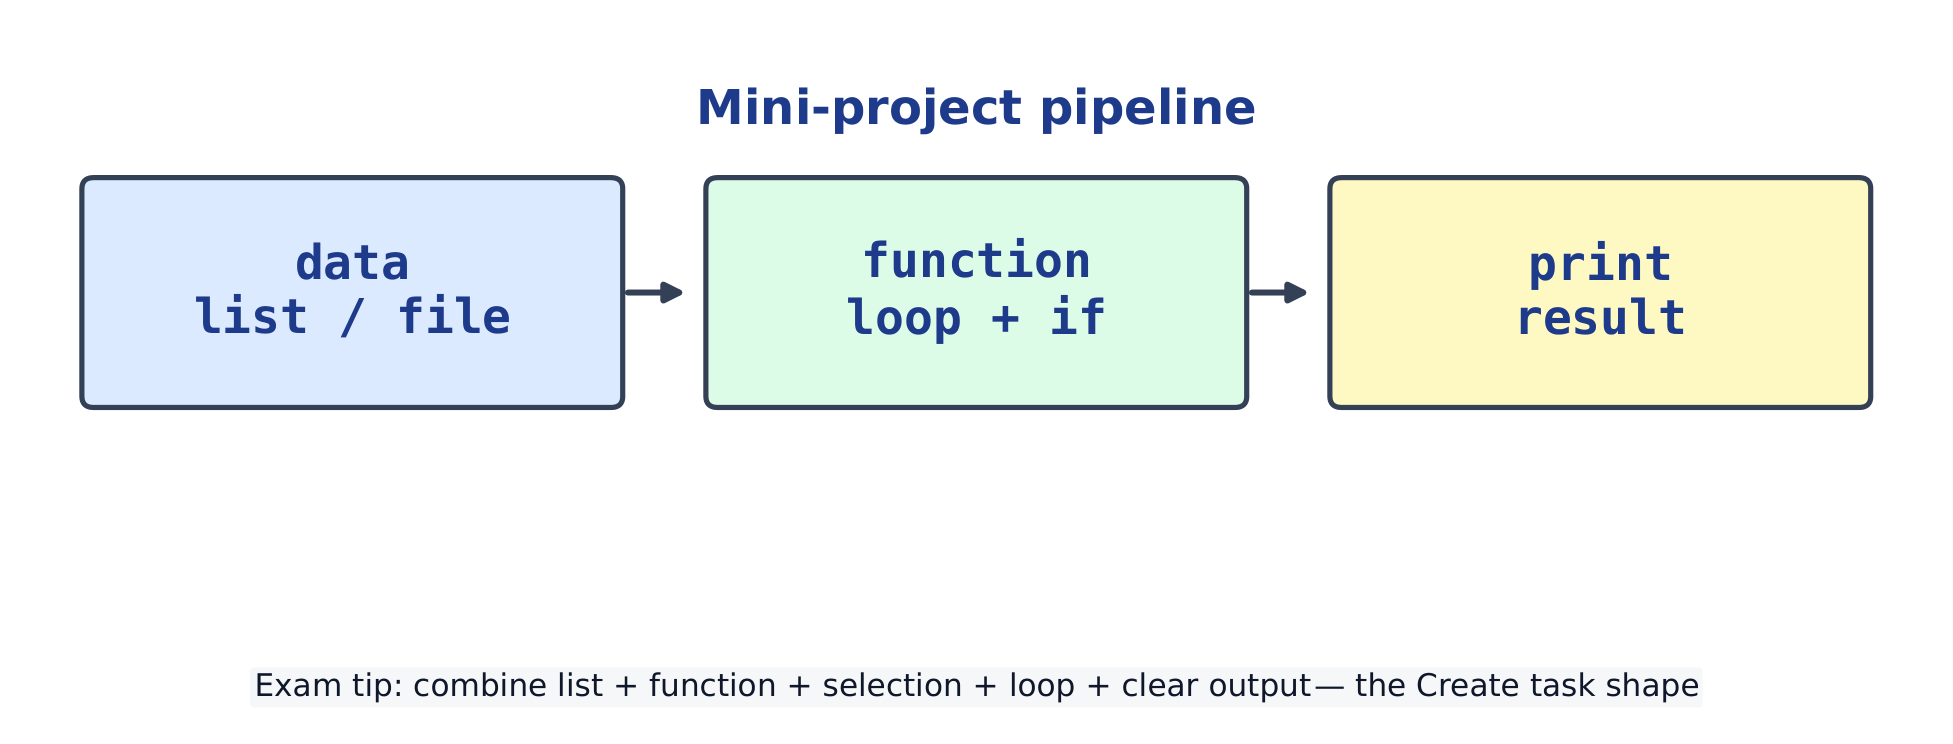
Un mini-projet 小项目 combine les notions précédentes : des données dans une liste, une fonction avec une sélection dans une boucle, et une sortie imprimée. C'est aussi la forme de la Tâche de Performance AP Create.
def count_passes(marks, pass_mark=60):
    passes = 0
    for m in marks:                 # iteration
        if m >= pass_mark:          # selection
            passes += 1
    return passes

print(count_passes([88, 50, 95, 60]))   # 3
Projet : filtrer vers une nouvelle liste
def merit(marks):
    return [m for m in marks if m >= 80]

print(merit([88, 71, 95, 60]))     # [88, 95]
La Tâche AP Create demande une liste, une procédure paramétrée 过程 utilisant une sélection 选择 et une itération 迭代, ainsi qu'une entrée/sortie. Chacun des projets ci-dessus suit exactement cette structure — construisez des petits morceaux, puis assemblez-les.
Erreurs courantes
Construisez par petites étapes et testez chaque partie avant de passer à la suivante — ne writez pas tout d'un coup.
Lisez toute la tâche d'abord, puis planifiez l'entrée → traitement → sortie avant de coder.
Mini-projet : données → fonction → résultat imprimé