Efficacité algorithmique
Ce que nous allons faire
- Deux programmes peuvent tous deux être corrects mais prendre des temps très différents.
- Cette leçon porte sur l'efficacité : comment le travail augmente lorsque l'entrée augmente.
- Lisez et réfléchissez aux idées ; ensuite, quelques petites tâches vous permettent de compter les étapes vous-même.
Compter le travail
- Nous mesurons un algorithme par combien d'étapes il effectue, pas en secondes.
- Les étapes en secondes dépendent de l'ordinateur ; compter les étapes non.
- Plus d'entrées signifient généralement plus d'étapes. La question est combien de plus.
Temps d'exécution raisonnable vs irraisonnable
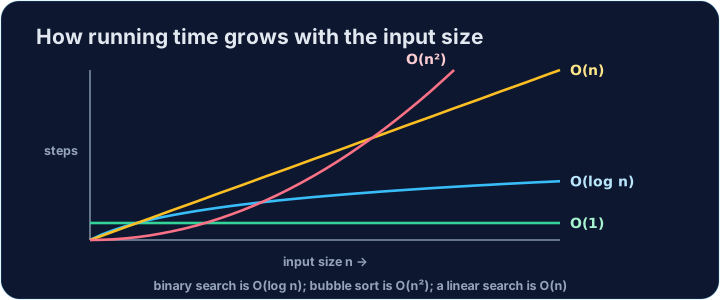
- Un temps raisonnable signifie que le nombre d'étapes croît comme un polynôme, ou plus lentement : constant, linéaire, quadratique ou cubique.
- Une boucle unique est linéaire. Une boucle imbriquée dans une autre est quadratique (n × n). Quadratique croît plus vite qu'une ligne, mais reste un temps raisonnable.
- Un temps irraisonnable implique une croissance exponentielle ou factorielle. Une légère augmentation de l'entrée fait exploiter le travail.
Input size:      10          20          40
Search a list:   10          20          40          (linear - reasonable)
Nested loops:    100         400         1,600       (square - still reasonable)
Try all orders:  3,628,800   ...         48 digits   (factorial - unreasonable)
Une petite démo : compter les étapes
- Ci-dessous, nous comptons les comparaisons qu'une recherche linéaire effectue.
- Le compte augmente au rythme de la taille de la liste — croissance lente et constante.
- Essayez de changer la taille pour voir le compte la suivre.
def count_steps(n):
    steps = 0
    data = list(range(n))
    target = -1            # not in the list, so we scan everything
    for item in data:
        steps = steps + 1
        if item == target:
            break
    return steps

print(count_steps(10))
print(count_steps(20))
print(count_steps(40))
Quand la rapidité ne suffit pas
- Certains problèmes ne possèdent aucun algorithme connu à temps raisonnable.
- Une méthode exacte peut essayer tous les ordonnancements. Il s'agit d'une croissance factorielle, donc irraisonnable pour une grande entrée.
- Une heuristique est un raccourci pouvant fournir une réponse suffisante. Elle n'est pas garantie comme étant la meilleure. Vous n'avez pas besoin de mémoriser une heuristique particulière.
Problèmes indécidables
- Pire que lent : certains problèmes ne peuvent pas être résolus par aucun algorithme du tout.
- On les appelle des problèmes indécidables.
- Peu importe à quelle vitesse les ordinateurs deviennent rapides, aucun programme ne peut toujours donner la bonne réponse.
Reasonable   : constant, linear, square or cube growth
Unreasonable : exponential or factorial growth
Undecidable  : no algorithm can solve it for every input
Idées clés à retenir
- L'efficacité concerne la manière dont le nombre d'étapes croît avec la taille de l'entrée, et non le nombre de secondes prises par un ordinateur.
- Une croissance polynomiale ou inférieure constitue un temps raisonnable. Une boucle imbriquée (n × n) reste également raisonnable.
- Une croissance exponentielle ou factorielle est irréaliste. Certains problèmes sont également indécidables.
Erreurs courantes
- Qualifier une boucle imbriquée d'irréaliste est inexact. Les croissances quadratique et cubique restent raisonnables en termes de temps d'exécution.
- Utiliser la notation formelle Big-O comme règle d'examen est incorrect. Le Big-O n'est pas testé. La ligne de complexité doit être polynomiale ou inférieure, contrairement à l'exponentiel ou au factoriel.
À vous maintenant
- Écrivez de petites fonctions qui comptent les étapes pour ressentir comment le travail croît.
- Comparer une boucle simple, une boucle imbriquée et « tester toutes les permutations ». La boucle imbriquée reste raisonnable en temps d'exécution. Appuyez sur Vérifier la réponse.
Comment les algorithmes évoluent
La croissance quadratique progresse plus vite qu'une droite, et reste raisonnable en temps. La croissance factorielle n'est pas raisonnable.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Écrivez scan_compares(data, target) qui retourne combien de comparaisons effectue une recherche linéaire. Comparez chaque élément à target, en comptant un à chaque fois, et arrêtez dès que vous le trouvez. S'il n'est pas dans la liste, vous avez comparé tous les éléments. Exemple : scan_compares([5, 8, 2], 8) → 2.
Cliquez sur Exécuter pour voir le résultat ici.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Écrivez pair_count(n) qui utilise une boucle dans une boucle (toutes deux sur range(n)) et retourne combien de fois l'étape intérieure s'exécute. C'est n × n. Exemple : pair_count(3) → 9. Cela croît beaucoup plus vite qu'une seule boucle.
Cliquez sur Exécuter pour voir le résultat ici.
Difficulté 3/5 · 200 pièces + un petit bonus lors de la première réussite aujourd'hui
Écrivez count_orderings(n) qui retourne combien d'ordres différents n éléments peuvent prendre — c'est-à-dire 1 × 2 × ... × n (factorielle de n). count_orderings(0) est 1. Exemple : count_orderings(3) → 6. Remarquez à quel point cela explose vite : count_orderings(10) est supérieur à 3 millions.
Cliquez sur Exécuter pour voir le résultat ici.