Compression de données
Pourquoi compresser les données
- Les données prennent de l'espace pour être stockées et du temps pour être envoyées.
- La compression rend un fichier plus petit afin qu'il soit moins cher à sauvegarder et plus rapide à partager.
- Il y a deux types : sans perte et avec perte.
Compression sans perte
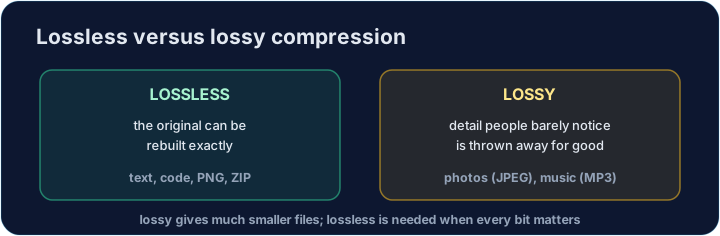
- La compression sans perte réduit un fichier tout en conservant chaque bit des données.
- Lorsque vous ouvrez le fichier, vous récupérez l'original exact.
- Elle fonctionne en trouvant des motifs et en les écrivant de manière plus courte.
Original:  AAAAAAAA-BBB
Shorter:   8A-3B          (8 A's, then 3 B's)
Open it:   AAAAAAAA-BBB   (exactly the same again)
Compression avec perte
- La compression avec perte réduit considérablement un fichier en jetant certaines données.
- Elle élimine les détails que les gens peuvent à peine voir ou entendre.
- Vous ne pouvez pas récupérer l'original exact — mais c'est "assez proche".
Photo (large)  --lossy-->  Photo (small)
A few colors and fine details are gone,
but your eye hardly notices.
Le compromis : taille vs qualité
- Sans perte conserve une qualité totale, mais le fichier reste plus grand.
- Avec perte donne un fichier beaucoup plus petit, mais la qualité diminue un peu.
- Vous choisissez selon ce qui importe le plus : données parfaites ou petite taille.
Quand utiliser chacun
- Utilisez sans perte lorsque chaque détail doit être exact.
- Utilisez avec perte lorsqu'une légère baisse de qualité est acceptable et qu'une petite taille est importante.
Lossless:  text, code, a .zip file, a spreadsheet
Lossy:     photos (JPEG), music (MP3), video
Idée clé
- La compression échange la taille contre la qualité (ou contre le travail nécessaire pour l'inverser).
- Sans perte = plus petit et parfait ; avec perte = beaucoup plus petit mais pas exact.
- De bons ingénieurs choisissent le bon type pour la tâche.
Codage par longueur de run
- Le codage par longueur de run (RLE) est une méthode simple sans perte.
- Un run est une série de caractères identiques répétés. RLE stocke un compteur au lieu des répétitions.
- Nous stockerons chaque run sous forme de paire
[character, count]dans une liste.
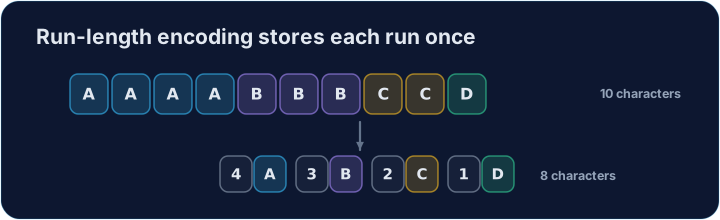
"AAAB"                ->  [["A", 3], ["B", 1]]     (3 A's, then 1 B)
[["A", 3], ["B", 1]]  ->  "AAAB"                   (decode it back — exact again)
Erreurs courantes
- La compression sans perte peut être inversée exactement ; avec perte jette des détails.
- Plus de compression peut signifier une qualité inférieure.
À vous maintenant
- Créez RLE vous-même : un encodeur, un décodeur et un utilitaire de longueur.
- Chaque tâche vérifie votre fonction sur plusieurs entrées. Appuyez sur Vérifier la réponse.
Compression sans perte
Le codage par longueur de run remplace une série de répétitions par compteur + symbole.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Écrivez encode(text) pour l'encodage par longueur de course (run-length encoding). Retournez une liste de paires [character, count], une par série de répétitions. Exemple : encode("AAAB") → [['A', 3], ['B', 1]]. Pour la chaîne vide, retournez [].
Cliquez sur Exécuter pour voir le résultat ici.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Écrivez decode(pairs) qui inverse l'encodeur : étant donné une liste de [character, count] paires, reconstruisez la chaîne originale. Exemple : decode([['A', 3], ['B', 1]]) → 'AAAB'. Pour [], retournez ''.
Cliquez sur Exécuter pour voir le résultat ici.
Difficulté 2/5 · 140 pièces + un petit bonus lors de la première réussite aujourd'hui
Sans décoder, écrivez original_length(pairs) qui retourne combien de caractères avait le texte original — ajoutez simplement les compteurs. Exemple : original_length([['A', 3], ['B', 1]]) → 4.
Cliquez sur Exécuter pour voir le résultat ici.