Perspectivas históricas e interpretación psicométrica
Introducido| English | Significado |
|---|---|
| base rates/beɪs reɪts/ | tasas base |
| structuralism/ˈstrʌktʃərəlɪzəm/ | estructuralismo |
| percentile/pəˈsentaɪl/ | percentil |
Una alta tasa de aciertos puede inducir a error
- Una prueba ficticia marca 9 de cada 10 persona que tiene una condición. Sin embargo, la mayoría de las personas marcadas no la tienen. La información faltante es con qué frecuencia marca a otras personas y qué tan común es la condición.
- Las preguntas de historia y medición del GRE requieren conceptos precisos y comparaciones cuidadosas. Conectaremos perspectivas psicológicas con la interpretación de puntuaciones y tasas base: qué tan común es una condición o categoría en la población considerada.
Laboratorios y escuelas tempranas
- Wundt estableció su laboratorio de psicología experimental en Leipzig en 1879. Su enfoque incluía la organización activa de la experiencia. El estructuralismo se asocia especialmente con el análisis posterior de Titchener sobre la experiencia consciente en elementos; no trate el hito del laboratorio y esa escuela como idénticos.
- El funcionalismo, asociado con William James y otros, preguntaba qué hacen los procesos mentales y cómo apoyan la adaptación. Las preguntas estructurales y funcionales enfatizan objetivos diferentes, pero una etiqueta breve de escuela no captura todo el trabajo de un investigador.
Comparación guiada. "Describa las cualidades básicas de una experiencia de color" se ajusta al énfasis estructural. "¿Cómo ayuda la atención a alguien a responder a una tarea cambiante?" se ajusta al énfasis funcional. Elija según la pregunta formulada, luego use nombres como pistas de apoyo.
Match each school with a key figure.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Titchener is especially associated with structuralism; James with functionalism; Watson with behaviourism; Wertheimer with Gestalt psychology. Wundt’s 1879 laboratory is a related milestone, not an interchangeable attribution.
Wundt’s 1879 laboratory and Titchener’s structuralist programme are interchangeable historical labels.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Distinguish the laboratory milestone from the later school and its particular aims.
Perspectivas posteriores formulan preguntas diferentes
- El programa conductista de Watson en 1913 enfatizó el estudio objetivo de la conducta; Skinner analizó posteriormente la conducta operante y sus consecuencias. La psicología Gestalt, asociada con Wertheimer y colegas, enfatizó cómo la organización de un todo moldea la experiencia de sus partes.
- El enfoque psicoanalítico de Freud enfatizó procesos inconscientes y conflicto; Maslow y Rogers se asocian con énfasis humanistas en el crecimiento y la experiencia personal. Los enfoques cognitivos estudian procesos mentales como la memoria y el lenguaje. La crítica de Chomsky en 1959 a Skinner fue una contribución a un cambio más amplio, no un evento único que reemplazara toda la investigación conductual.
A study asks how rewards following an action change its future frequency. Which emphasis is closest?
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
The question concerns behaviour and its consequences. Classify the research question rather than relying only on a researcher’s name.
Decida con qué se compara la puntuación
- Una interpretación referenciada en normas compara una puntuación con un grupo de referencia especificado. Una interpretación referenciada en criterio compara el desempeño con un estándar definido. La misma evaluación puede respaldar ambos tipos de afirmaciones si la evidencia justifica cada interpretación.
- La administración y puntuación estandarizadas ayudan a controlar variaciones no deseadas. Solas no establecen significados comparables entre poblaciones, acceso justo o adecuación para cada uso. Pregunte quién proporcionó las normas, cuándo se recolectaron y si se ajustan a la comparación propuesta.
¿Qué comparación se menciona?
Clasificar las interpretaciones de las puntuaciones.
Which score is criterion-referenced?
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Meeting a defined performance standard is a criterion comparison. Rank and percentile statements compare with people in a specified group.
Una puntuación estándar no es automáticamente un percentil
- Una puntuación z describe la distancia desde una media de referencia en desviaciones estándar: $z=(X-M)/S$. Una puntuación de 115 con media 100 y DE 15 da como resultado $z=(115-100)/15=1$. La media y la DE solas no determinan su percentil.
- Si la distribución de referencia es aproximadamente normal, $z=1$ corresponde aproximadamente al percentil 84. Con normas empíricas, use la tabla de percentiles relevante y su convención para empates. Un percentil es una posición relativa, no el porcentaje de preguntas respondidas correctamente.
Interpretación resuelta. Suponga que una escala de referencia con distribución normal tiene media 50 y desviación estándar (DE) 10. Una puntuación de 40 corresponde a $z=(40-50)/10=-1$, aproximadamente al percentil 16. Sin la suposición de distribución normal o sin una tabla de normas empíricas, el percentil no puede determinarse mediante ese cálculo.
On an approximately normal reference scale with mean 100 and SD 15, a score of 115 is at roughly which percentile?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
z = (115 − 100)/15 = 1. With the stated normal approximation, about 84% of the reference distribution lies below that score. Mean and SD alone would not determine a percentile.
A mean of 100 and SD of 15, without a distribution or percentile table, prove that 115 is at the 84th percentile.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
The mean and SD locate a score in standard-deviation units. The percentile additionally needs the distribution or appropriate empirical norms.
Mantenga separados los denominadores del cribado
- La sensibilidad es la proporción de personas identificadas entre quienes tienen la condición. La especificidad es la proporción de personas no identificadas entre quienes no la tienen. La tasa de falsos positivos es uno menos la especificidad.
- El valor predictivo positivo (VPP) formula una pregunta diferente: de todas las personas identificadas, ¿cuál es la proporción que tiene la condición? Para estos ejemplos didácticos, asuma que el estado de la condición se conoce independientemente y que las tasas de prueba se especifican para la población declarada.
Worked counts. Of 1,000 people, 10 have a condition and 990 do not. The test flags 9 of the 10 and 99 of the 990. Sensitivity is $9/10=90\%$; specificity is $891/990=90\%$. The 99 false positives belong in the PPV denominator, not the sensitivity denominator.
Of 900 people independently known not to have a condition, 810 are not flagged. What is specificity as a percentage?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Specificity = true negatives/all non-cases = 810/900 = 0.90, or 90%.
Utilice todos los resultados positivos para calcular el VPP
- El mismo ejemplo ficticio tiene 108 resultados positivos: 9 verdaderos positivos más 99 falsos positivos. Por lo tanto, $\mathrm{PPV}=9/(9+99)=9/108\approx0.0833$, o aproximadamente el 8.3%. La mayoría de las personas identificadas no tienen la condición, aunque la sensibilidad sea alta.
- Un resultado negativo plantea una pregunta diferente, con un denominador distinto. Aquí hay 892 resultados negativos: 891 verdaderos negativos y un caso pasado por alto. Ni un resultado positivo ni uno negativo equivalen a certeza sobre un individuo.
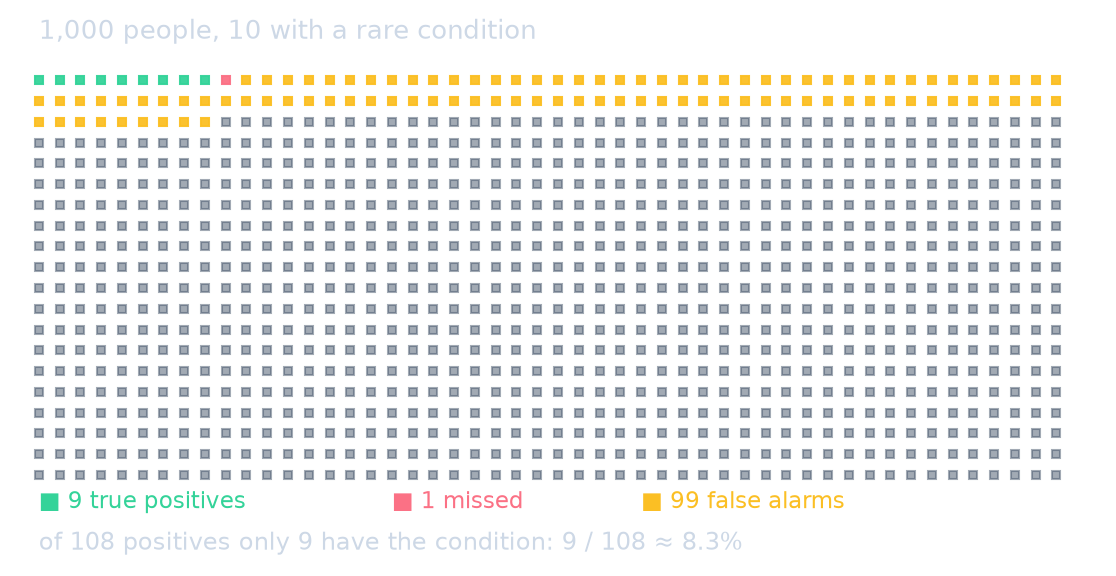
Conteos ficticios con estado de condición conocido independientemente; un ejemplo de método de cribado, no una recomendación clínica.
Cambie la tasa base, manteniendo fijas las tasas de prueba
- En otra población ficticia de 1,000, 100 tienen la condición. Manteniendo la sensibilidad y la especificidad en 90%, se obtienen 90 verdaderos positivos y 90 falsos positivos, resultando en $\mathrm{PPV}=90/(90+90)=50\%$. El cambio en la tasa base altera el VPP.
- Esta comparación asume que las mismas tasas de prueba aplican en ambas poblaciones. En la práctica, las diferencias poblacionales y el uso de la prueba también pueden modificar la sensibilidad o la especificidad. Tanta la tasa base como la sensibilidad y la especificidad son relevantes.

Ambas poblaciones contienen 1,000 personas. La comparación mantiene la sensibilidad y la especificidad en 90%; no afirma que estas tasas se transfieran automáticamente a poblaciones reales.
In a fictional population of 1,000, the condition prevalence is 5%, sensitivity is 80% and the false-positive rate is 5%. Using expected counts, what proportion of positive results are true positives (three decimal places)?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Expected true positives = 0.8 × 50 = 40; expected false positives = 0.05 × 950 = 47.5. Fractional expected counts describe a model, not half a person observed. PPV = 40/(40 + 47.5) ≈ 0.457.
A fictional test population contains 100 cases and 900 non-cases. Sensitivity is 80% and specificity is 90%. Using these counts, what is PPV as a proportion, to three decimal places?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
True positives = 80; false positives = 0.10 × 900 = 90. PPV = 80/(80 + 90) ≈ 0.471. Sensitivity uses a different denominator.
El error de medición requiere un modelo
- En la teoría clásica de pruebas, una puntuación observada combina una puntuación verdadera y un error de medición para mediciones repetidas especificadas. La puntuación verdadera es la puntuación esperada a través de esas mediciones, no una medida perfecta de todas las habilidades de una persona.
- Un error estándar de medición (SEM) resumen describe la desviación estándar de los errores de medición en la escala de puntuaciones. Puede informar un intervalo de incertidumbre con suposiciones adicionales; no es en sí mismo un intervalo ni un error máximo posible. A una DE fija de puntuaciones, una fiabilidad relevante menor produce un SEM clásico mayor.
Cálculo resuelto. Si una escala de puntuaciones tiene DE 10 y fiabilidad relevante $r=0.84$, la fórmula resumida da $\mathrm{SEM}=S\sqrt{1-r}=10\sqrt{0.16}=4$ puntos de puntuación. Esto es incertidumbre de medición, no el error estándar de una media muestral. No garantiza que cada error esté dentro de cuatro puntos.
Using the classical summary SEM formula with score SD 15 and relevant reliability 0.84, what is SEM in score points?
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
SEM = 15 × √(1 − 0.84) = 15 × 0.4 = 6 score points. This is not an interval width or a bound on every error.
SEM = 4 guarantees that no measurement error exceeds four score points.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
SEM is a standard deviation under the measurement model. Errors can exceed one SEM; interval claims require additional assumptions.
La fiabilidad, la validez y la equidad requieren evidencia diferente
- La fiabilidad se refiere a la consistencia o precisión bajo replicaciones especificadas. La validez se refiere a la evidencia que respalda una interpretación y uso propuestos para una puntuación. Una puntuación precisa puede seguir apoyando una conclusión errónea; un único coeficiente de fiabilidad no valida una regla de selección ni establece la equidad.
- Revise el uso previsto, el grupo de referencia, el contenido, la accesibilidad y la evidencia de sesgo. Dos personas con la misma puntuación no necesariamente tienen fortalezas idénticas, y un percentil del grupo de referencia no indica por sí solo si alguno cumple un estándar de desempeño.
Crítica trabajada. Una escuela afirma: “Nuestro examen es fiable, por lo que el 10% superior está preparado para un curso”. El término “el 10% superior” describe una comparación con normas. La preparación requiere evidencia que vincule el desempeño con las demandas del curso y un estándar justificado; la fiabilidad sola no proporciona ese vínculo.
High reliability alone is insufficient evidence for every proposed interpretation or use of a score.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Consistency or precision under specified replications does not establish that an intended interpretation, decision or fairness claim is supported.
A training test reports both a 70th percentile in a local reference group and successful completion of every required safety procedure. Identify the two comparison types and explain why the percentile alone cannot establish readiness.
El percentil 70 se referencia normativamente a un grupo especificado. La finalización de los procedimientos de seguridad requeridos se referencia por criterio. El percentil concierne a la posición relativa, no al dominio de los procedimientos; la preparación requiere evidencia relevante y un estándar justificado. Ambas interpretaciones pueden reportarse para una misma evaluación si están respaldadas.
Resumen
- Empareje una perspectiva con su pregunta y método, así como con una figura histórica.
- Separe las normas, los estándares, las puntuaciones estándar y los percentiles.
- La sensibilidad, la especificidad y el VPP están condicionados a diferentes grupos.
- El VPP cambia con la tasa base cuando las tasas de prueba se mantienen fijas.
- Trate el EEM como una desviación estándar basada en un modelo y examine la evidencia para el uso previsto de la puntuación.
- tasas base: Qué tan común es una condición o categoría en la población especificada.
- estructuralismo: La escuela asociada al análisis de la experiencia consciente en elementos básicos.
- percentil: La posición relativa de una puntuación en una distribución de referencia especificada.
A company says: “Our test has 90% sensitivity, so any positive applicant has a 90% chance of belonging to the target category. Its high reliability also proves that rejecting every positive is fair.” Identify two distinct gaps and name relevant additional evidence.
La sensibilidad depende de las personas en la categoría objetivo; el VPP depende de los resultados positivos. Estimar el VPP necesita la tasa base de la categoría y la tasa de falsos positivos, con evidencia de que las tasas se ajustan a la población de solicitantes. La fiabilidad no establece una interpretación justificada, umbral de decisión o equidad. La regla propuesta de rechazo necesita evidencia sobre relevancia laboral, errores y consecuencias, accesibilidad y posible sesgo.