Machine learning types and training
Introducido| English | Significado |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | aprendizaje automático |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | propagación hacia atrás |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | aprendizaje supervisado |
| classification/ˌklæsɪfɪˈkeɪʃn/ | clasificación |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | aprendizaje no supervisado |
| clusters/ˈklʌstəz/ | clústeres |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | aprendizaje por refuerzo |
| agent/ˈeɪdʒənt/ | agente |
| reward/rɪˈwɔːd/ | recompensa |
| policy/ˈpɒlɪsi/ | política |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | descenso de gradiente |
| loss function/lɒs ˈfʌŋkʃn/ | función de pérdida |
| epoch/ˈiːpɒk/ | época |
El programa que aprendió solo una apertura que ningún humano había jugado
- A AlphaGo Zero se le dieron las reglas del Go y nada más. Ningún juego humano, ningún libro de aperturas, ningún consejo. Jugó contra sí mismo, comenzando con movimientos aleatorios.
- En tres días superó a la versión que había vencido al campeón mundial. En el proceso redescubrió siglos de teoría humana de aperturas, y luego descartó partes de ella por ser inferiores.
- Aprendió de un único número después de cada juego: ganada o perdida. Ese es un tipo de aprendizaje completamente distinto al de ser mostrado un millón de fotografías etiquetadas.
- Esta lección presenta los tres paradigmas del aprendizaje automático, qué datos necesita cada uno y cómo cambian realmente los pesos de una red mediante la backpropagación 反向传播.
Aprendizaje supervisado
- El aprendizaje supervisado 监督学习 entrena con datos que llevan etiquetas: fotografías marcadas como "gato" o "perro", correos electrónicos identificados como spam o no, casas con sus precios de venta.
- El modelo aprende el mapeo desde la entrada hasta la etiqueta, y luego se le proporcionan entradas que nunca ha visto para que produzca la etiqueta correspondiente.
- Se divide en clasificación 分类, donde la salida es una categoría, y regresión, donde la salida es un número.
- Su costo son las etiquetas: alguien debe producirlas, lo cual implica una gran cantidad de trabajo humano si se trata de un millón de imágenes.
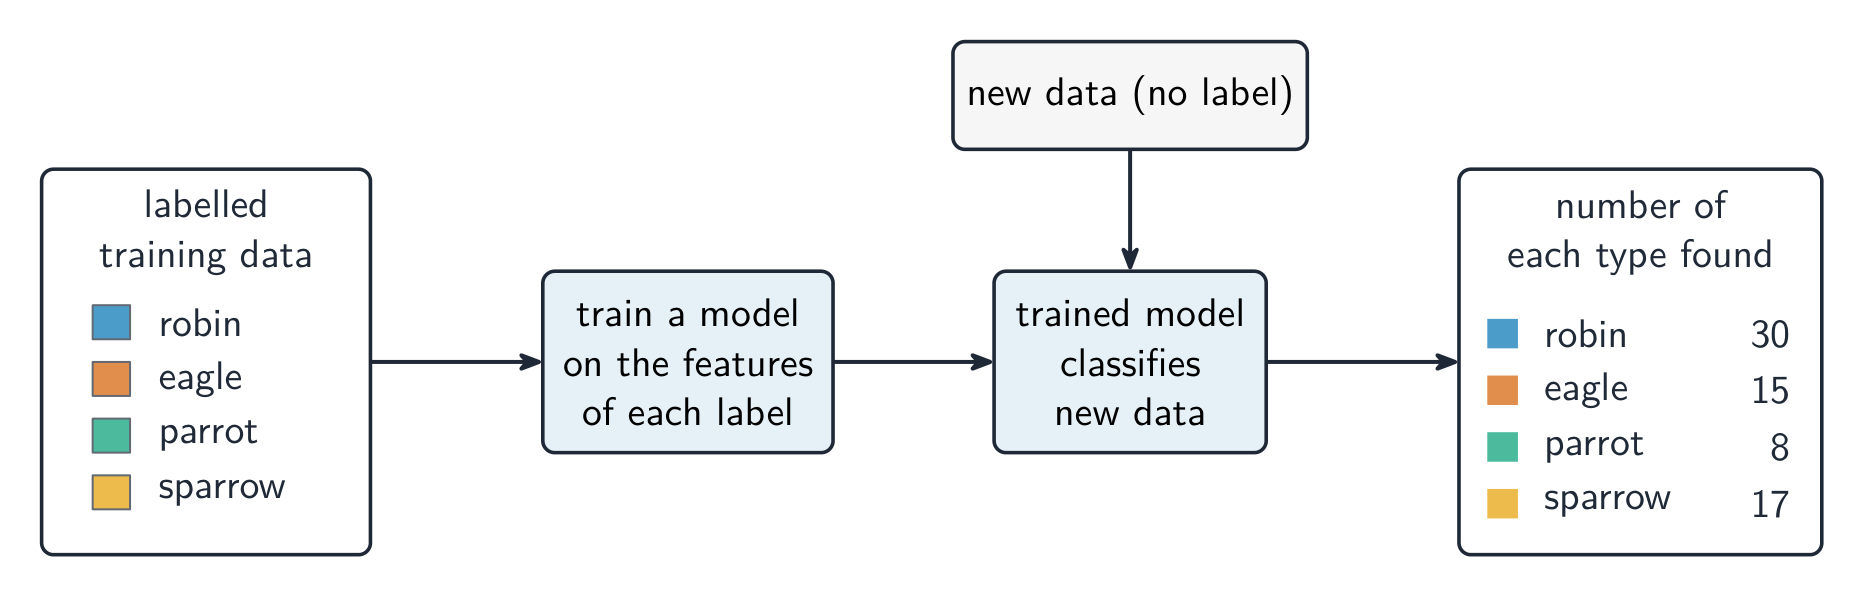
Entrada de ejemplos etiquetados, salida de un modelo, y luego entradas sin etiquetar
Supervised learning uses:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Supervised learning trains on labelled examples (e.g. images tagged cat/dog).
Aprendizaje no supervisado
- El aprendizaje no supervisado 无监督学习 recibe datos sin etiquetas y se le pide que encuentre estructura en ellos.
- El uso más común es el agrupamiento (clustering): formar grupos 聚类 de elementos similares, como clientes que compran cosas parecidas, sin que nadie decida de antemano cuáles deben ser esos grupos.
- Esa es su fortaleza y su debilidad: puede descubrir una agrupación de la que nadie sospechaba, pero no puede explicarte qué significa dicha agrupación.
Unsupervised learning is used to:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
With no labels, unsupervised learning discovers patterns/clusters in the data.
Aprendizaje por refuerzo
- El aprendizaje por refuerzo 强化学习 tiene un agente 智能体 actuando en un entorno. Cada acción cambia el estado y devuelve una recompensa 奖励, que puede ser cero durante mucho tiempo.
- El agente aprende una política 策略, una estrategia para elegir acciones, que maximiza su recompensa total a lo largo del tiempo. Aprende mediante ensayo y error, sin ningún ejemplo etiquetado.
- Es adecuado para problemas que consisten en una secuencia de decisiones donde el movimiento correcto solo se revela mediante el resultado final: juegos, control robótico, coches autónomos. Ese es exactamente el caso de AlphaGo Zero.
In reinforcement learning, the agent learns by:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
The agent tries actions, receives rewards, and learns a policy that maximises long-term reward.
In reinforcement learning the agent learns a ____ that maximises its total reward over time.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
It learns by trial and error from rewards, with no labelled examples at all, which is why it suits sequences of decisions.
Ejemplo resuelto: elegir el paradigma
- Diez mil escaneos médicos, cada uno etiquetado por un médico como que muestra un tumor o no, se utilizan para entrenar un sistema que marque nuevos escaneos. Supervisado: los datos tienen etiquetas y la tarea es aprender de entrada a etiqueta, específicamente una clasificación.
- Una tienda quiere saber si sus clientes caen en grupos naturales, sin decidir los grupos de antemano. No supervisado: no existen etiquetas y la tarea es encontrar estructura, específicamente agrupamiento.
- Un brazo robótico debe aprender a colocar componentes, juzgado solo por si cada intento tuvo éxito. Por refuerzo: un agente, una secuencia de acciones y una recompensa en lugar de una etiqueta.
- Nombra el paradigma y justifícalo basándote en los datos: etiquetados, no etiquetados o una señal de recompensa.
AI learning type lab
Classify AI examples by the type of learning or concern involved.
Match each ML paradigm to its data.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Supervised = labels; unsupervised = no labels; reinforcement = reward feedback.
Match each situation to the machine-learning paradigm it needs.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Labels, no labels, or a reward. The data decides the paradigm, not the difficulty of the task.
Entrenamiento mediante backpropagación
- Entrenar significa ajustar los pesos para que las salidas de la red coincidan con los objetivos. El método es la backpropagación con descenso de gradiente 梯度下降.
- Paso hacia adelante: introducir una entrada a través de la red y obtener su salida. Calcular el error usando una función de pérdida 损失函数, que mide cuánto se desvía la salida del objetivo.
- Paso hacia atrás: propagar ese error hacia atrás a través de las capas para encontrar el gradiente de cada peso, es decir, cuánto contribuyó ese peso al error.
- Actualización: cambiar cada peso dando un pequeño paso en dirección opuesta a su gradiente. El tamaño del paso es la tasa de aprendizaje.
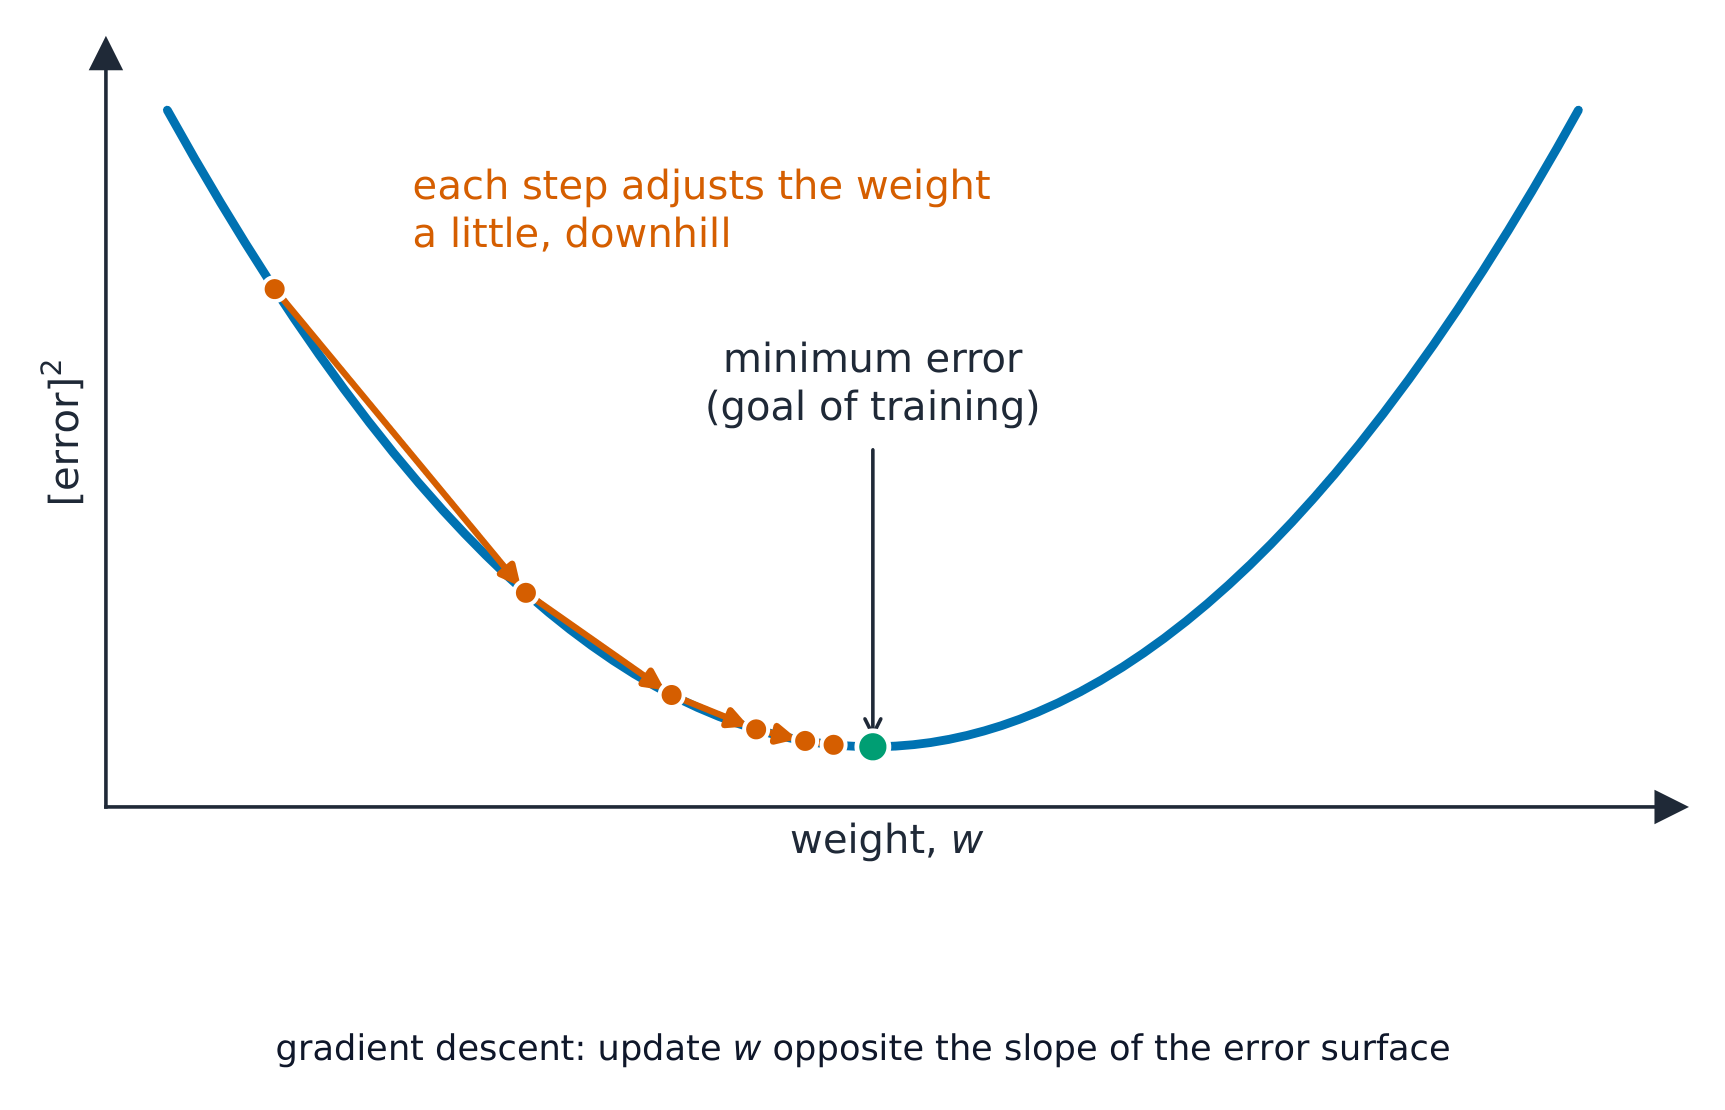
Bajando cuesta abajo, un pequeño paso a la vez
Backpropagation trains a network by:
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
The error flows from the output back through the network (chain rule) so every weight's gradient is found, then weights step downhill.
Put one round of backpropagation training in order.
Dificultad 3/5 · 200 monedas + un pequeño bono en el primer intento de hoy
Forward, error, backward, update, repeated over many epochs until the error stops falling.
Épocas y por qué importa la tasa de aprendizaje
- Un paso completo a través de todo el conjunto de entrenamiento es una época 训练轮次. El entrenamiento se repite durante muchas épocas hasta que el error deja de descender.
- Una tasa de aprendizaje demasiado grande sobrepasa el mínimo y el error salta; demasiado pequeña y el entrenamiento tarda mucho más de lo necesario.
- Después del entrenamiento, usar el modelo consiste únicamente en un paso hacia adelante, por eso una red entrenada responde instantáneamente aunque el entrenamiento haya tardado días.
In gradient descent the learning rate sets how big a step each weight update takes — too large overshoots the minimum, too small makes training slow.
Dificultad 1/5 · 100 monedas + un pequeño bono en el primer intento de hoy
Backpropagation finds each weight's gradient; the learning rate scales how far down that gradient the weight moves.
Which statements about training are correct? Select todos that apply.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
The learning rate is the size of each weight update. That is why training can take days while a prediction takes milliseconds.
Puntos clave que se pierden fácilmente
- Justifica un paradigma basándote en los datos: datos etiquetados significan supervisado, datos no etiquetados significan no supervisado, una señal de recompensa significa aprendizaje por refuerzo.
- El aprendizaje por refuerzo no tiene etiquetas. Llamar "etiqueta" a su recompensa es la confusión clásica.
- La backpropagación es hacia adelante, error, hacia atrás, actualización, repetido. Nombrar solo "ajusta los pesos" es solo la mitad de la respuesta.
- La tasa de aprendizaje es el tamaño de cada paso, no la velocidad del entrenamiento ni el número de épocas.
Lo has entendido
- El supervisado aprende de entrada a etiqueta a partir de datos etiquetados, para clasificación o regresión · el no supervisado encuentra estructura como grupos en datos no etiquetados · el por refuerzo tiene un agente que aprende una política a partir de recompensas mediante ensayo y error
- Elige el paradigma según lo que ofrecen los datos, no según la dificultad de la tarea
- Backpropagación: un paso hacia adelante, un error de la función de pérdida, un paso hacia atrás que da el gradiente de cada peso, seguido de una actualización cuyo tamaño está definido por la tasa de aprendizaje
- El entrenamiento se repite durante muchas épocas; usar el modelo entrenado requiere un solo paso hacia adelante