Compresión de datos
¿Por qué comprimir datos
- Los datos ocupan espacio para almacenarse y tiempo para transmitirse.
- La compresión hace que un archivo sea más pequeño, lo que reduce el costo de almacenamiento y acelera su distribución.
- Existen dos tipos: sin pérdida y con pérdida.
Compresión sin pérdida
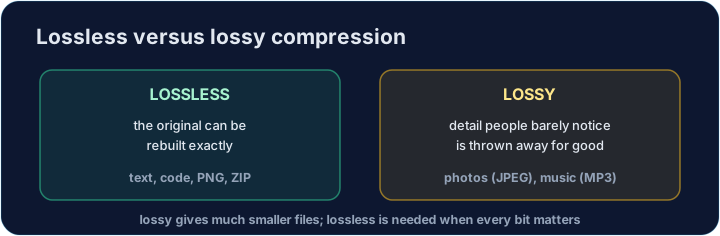
- La compresión sin pérdida reduce el tamaño del archivo pero conserva todos los bits de los datos.
- Al abrir el archivo, se recupera la exacta versión original.
- Funciona identificando patrones y escribiéndolos de una forma más corta.
Original:  AAAAAAAA-BBB
Shorter:   8A-3B          (8 A's, then 3 B's)
Open it:   AAAAAAAA-BBB   (exactly the same again)
Compresión con pérdida
- La compresión con pérdida reduce mucho el tamaño del archivo eliminando parte de los datos.
- Descarta detalles que las personas apenas pueden ver u oír.
- No se puede recuperar la exacta versión original — pero queda "suficientemente cerca".
Photo (large)  --lossy-->  Photo (small)
A few colors and fine details are gone,
but your eye hardly notices.
El compromiso: tamaño vs. calidad
- La compresión sin pérdida mantiene la calidad total, pero el archivo sigue siendo más grande.
- La compresión con pérdida produce un archivo mucho más pequeño, pero la calidad disminuye ligeramente.
- Se elige según lo que importe más: datos perfectos o tamaño reducido.
Cuándo usar cada una
- Use sin pérdida cuando cada detalle debe ser exacto.
- Use con pérdida cuando una pequeña reducción en la calidad es aceptable y el tamaño reducido es prioritario.
Lossless:  text, code, a .zip file, a spreadsheet
Lossy:     photos (JPEG), music (MP3), video
Idea clave
- La compresión intercambia tamaño contra calidad (o contra el esfuerzo necesario para revertirla).
- Sin pérdida = más pequeño y perfecto; con pérdida = mucho más pequeño pero no exacto.
- Los buenos ingenieros eligen el tipo adecuado para cada tarea.
Codificación por recurrencias
- La codificación por recurrencias (RLE, por sus siglas en inglés) es un método simple sin pérdida.
- Una recurrencia es una secuencia de caracteres idénticos repetidos. RLE almacena un contador en lugar de las repeticiones.
- Almacenaremos cada recurrencia como un par
[character, count]dentro de una lista.
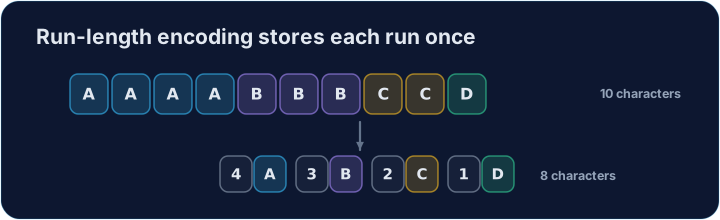
"AAAB"                ->  [["A", 3], ["B", 1]]     (3 A's, then 1 B)
[["A", 3], ["B", 1]]  ->  "AAAB"                   (decode it back — exact again)
Errores comunes
- La compresión sin pérdida puede revertirse exactamente; la con pérdida elimina detalles.
- Mayor compresión puede implicar menor calidad.
Ahora tú prueban
- Construye RLE tú mismo: un codificador, un decodificador y una función auxiliar de longitud.
- Cada tarea verifica tus funciones con varias entradas. Presiona Comprobar respuesta.
Compresión sin pérdida
La codificación por recuento de repeticiones reemplaza una secuencia de repeticiones con recuento + símbolo.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Escriba encode(text) para codificación por longitudes de carrera. Devuelva una lista de pares [character, count], uno por cada serie de repeticiones. Ejemplo: encode("AAAB") → [['A', 3], ['B', 1]]. Para la cadena vacía devuelva [].
Haz clic en Ejecutar para ver la salida aquí.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Escriba decode(pairs) que invierta el codificador: dada una lista de pares [character, count], reconstruya la cadena original. Ejemplo: decode([['A', 3], ['B', 1]]) → 'AAAB'. Para [] devuelva ''.
Haz clic en Ejecutar para ver la salida aquí.
Dificultad 2/5 · 140 monedas + un pequeño bono en el primer intento de hoy
Sin decodificar, escribe original_length(pairs) que devuelva cuántos caracteres tenía el texto original — simplemente suma los recuentos. Ejemplo: original_length([['A', 3], ['B', 1]]) → 4.
Haz clic en Ejecutar para ver la salida aquí.