Machine learning types and training
مُقدَّم| English | المعنى |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | تعلم الآلة |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | انتشار عكسي |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | التعلم الإشرافي |
| classification/ˌklæsɪfɪˈkeɪʃn/ | التصنيف |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | التعلم غير الإشرافي |
| clusters/ˈklʌstəz/ | تجمعات |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | التعلم المعزز |
| agent/ˈeɪdʒənt/ | وكيل |
| reward/rɪˈwɔːd/ | مكافأة |
| policy/ˈpɒlɪsi/ | سياسة |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | الانحدار التدريجي |
| loss function/lɒs ˈfʌŋkʃn/ | دالة الخسارة |
| epoch/ˈiːpɒk/ | جولة التدريب |
البرنامج الذي تعلّم نفسه فتحة لم يلعبها أي إنسان
- مُنح AlphaGo Zero قواعد لعبة الغو ولا شيء آخر. لا ألعاب بشرية، لا كتاب فتحات، لا نصائح. لعب ضد نفسه، بدءًا من حركات عشوائية.
- خلال ثلاثة أيام تفوق على النسخة التي هزمت بطل العالم. وخلال ذلك أعاد اكتشاف قرون من نظريات الفتحات البشرية، ثم تخلص من أجزائها باعتبارها أدنى جودة.
- تعلم من رقم واحد بعد كل لعبة: الفوز أو الخسارة. هذا نوع مختلف تمامًا من التعلم عن عرض مليون صورة مصنّفة.
- هذه الدرس هو النماذج الثلاثة لـ تعلم الآلة، والبيانات التي يحتاجها كل نموذج، وكيف تتغير أوزان الشبكة فعليًا بواسطة انتشار التراجع.
التعلم الإشرافي
- التعلم الإشرافي يتدرب على بيانات تحمل تسميات: صور مصنّفة "قط" أو "كلب"، رسائل بريد إلكتروني محددة كرسائل مزعجة أو غير ذلك، منازل بأسعار بيعها.
- يتعلم النموذج العلاقة من المدخل إلى التسمية، ثم تُعطى له مدخلات لم يرَ من قبل ويُطلب منه إنتاج التسمية.
- ينقسم إلى تصنيف، حيث يكون المخرج فئة، وانحدار، حيث يكون المخرج رقمًا.
- تكلفته هي التسميات: يجب على شخص ما إنتاجها، وهو عمل بشري ضخم بالنسبة لمليون صورة.
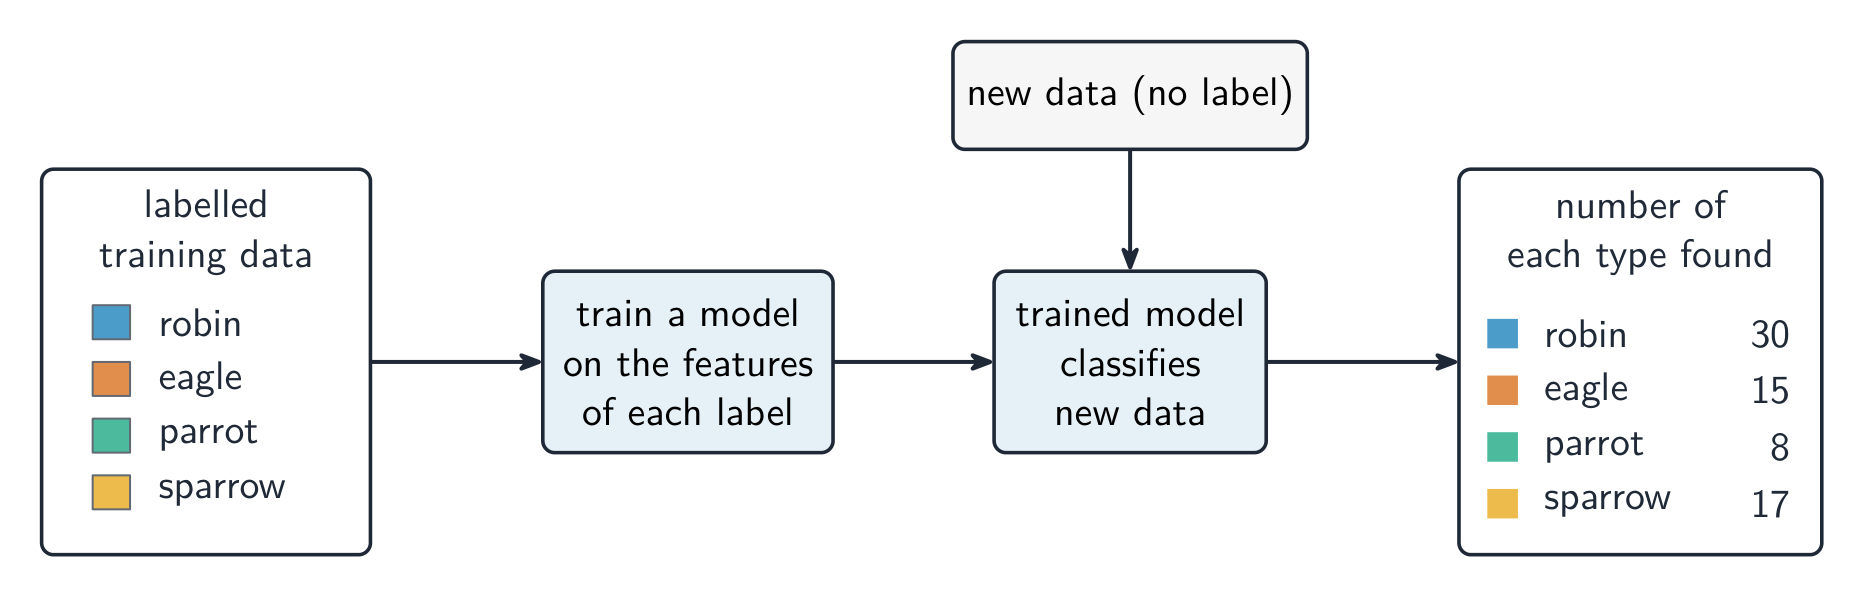
أمثلة مصنّفة الداخلة، نموذج الخارج، ثم مدخلات غير مصنّفة
Supervised learning uses:
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
Supervised learning trains on labelled examples (e.g. images tagged cat/dog).
التعلم غير الإشرافي
- التعلم غير الإشرافي يُعطى بيانات بدون تسميات ويُطلب منه إيجاد البنية فيها.
- الاستخدام الأكثر شيوعًا هو التجميع: تجميع العناصر المتشابهة في مجموعات، مثل العملاء الذين يشترون أشياء متشابهة، دون أن يقرر أحد مسبقًا ماهية المجموعات.
- هذه هي قوته وعيبه: يمكنه اكتشاف تجميع لم يشك به أحد، ولا يستطيع أن يخبرك بماذا يعني التجميع.
Unsupervised learning is used to:
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
With no labels, unsupervised learning discovers patterns/clusters in the data.
التعلم المعزز
- التعلم المعزز لديه وكيل يتصرف في بيئة. كل إجراء يغير الحالة ويعيد مكافأة، قد تكون صفرًا لفترة طويلة.
- يتعلم الوكيل سياسة، وهي استراتيجية لاختيار الإجراءات، لتعظيم إجمالي مكافأته بمرور الوقت. يتعلم عن طريق التجربة والخطأ، بدون أي أمثلة مصنّفة على الإطلاق.
- يناسب المشكلات التي تكون تسلسلًا من القرارات حيث يظهر الخيار الصحيح فقط من خلال النتيجة النهائية: الألعاب، التحكم في الروبوت، السيارات ذاتية القيادة. هذه بالضبط حالة AlphaGo Zero.
In reinforcement learning, the agent learns by:
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
The agent tries actions, receives rewards, and learns a policy that maximises long-term reward.
In reinforcement learning the agent learns a ____ that maximises its total reward over time.
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
It learns by trial and error from rewards, with no labelled examples at all, which is why it suits sequences of decisions.
مثال محلول: اختر النموذج
- عشرة آلاف فحص طبي، كل منها مصنف من قبل طبيب بأنه يظهر ورمًا أو لا، تُستخدم لتدريب نظام على تحديد الفحوصات الجديدة. إشرافي: البيانات تحتوي على تسميات والمهمة هي تعلم المدخل إلى التسمية، وتحديدًا التصنيف.
- متجر يريد معرفة ما إذا كان عملاؤه ينتمون إلى مجموعات طبيعية، دون تحديد المجموعات مسبقًا. غير إشرافي: لا توجد تسميات، والمهمة هي إيجاد البنية، تحديدًا التجميع.
- ذراع روبوتية يجب أن تتعلم وضع المكونات، يُحكم عليها فقط بنجاح كل محاولة. معزز: وكيل، تسلسل من الإجراءات، ومكافأة بدلاً من تسمية.
- سمِّ النموذج، ثم برر من البيانات: مصنّفة، غير مصنّفة، أو إشارة مكافأة.
AI learning type lab
Classify AI examples by the type of learning or concern involved.
Match each ML paradigm to its data.
الصعوبة 2/5 · 140 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
Supervised = labels; unsupervised = no labels; reinforcement = reward feedback.
Match each situation to the machine-learning paradigm it needs.
الصعوبة 2/5 · 140 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
Labels, no labels, or a reward. The data decides the paradigm, not the difficulty of the task.
التدريب بانتشار التراجع
- Training يعني ضبط الأوزان بحيث تطابق مخرجات الشبكة الأهداف. الطريقة هي انتشار التراجع مع ** descent التدرج**.
- التمرير الأمامي: إدخال مدخل عبر الشبكة والحصول على مخرجاتها. حساب الخطأ باستخدام دالة الخسارة، التي تقاس مدى تباعد المخرجات عن الهدف.
- التمرير العكسي: انتشار هذا الخطأ للخلف عبر الطبقات لإيجاد التدرج لكل وزن، أي مقدار مساهمة ذلك الوزن في الخطأ.
- التحديث: تغيير كل وزن بخطوة صغيرة عكس اتجاه تدرجه. حجم الخطوة هو معدل التعلم.
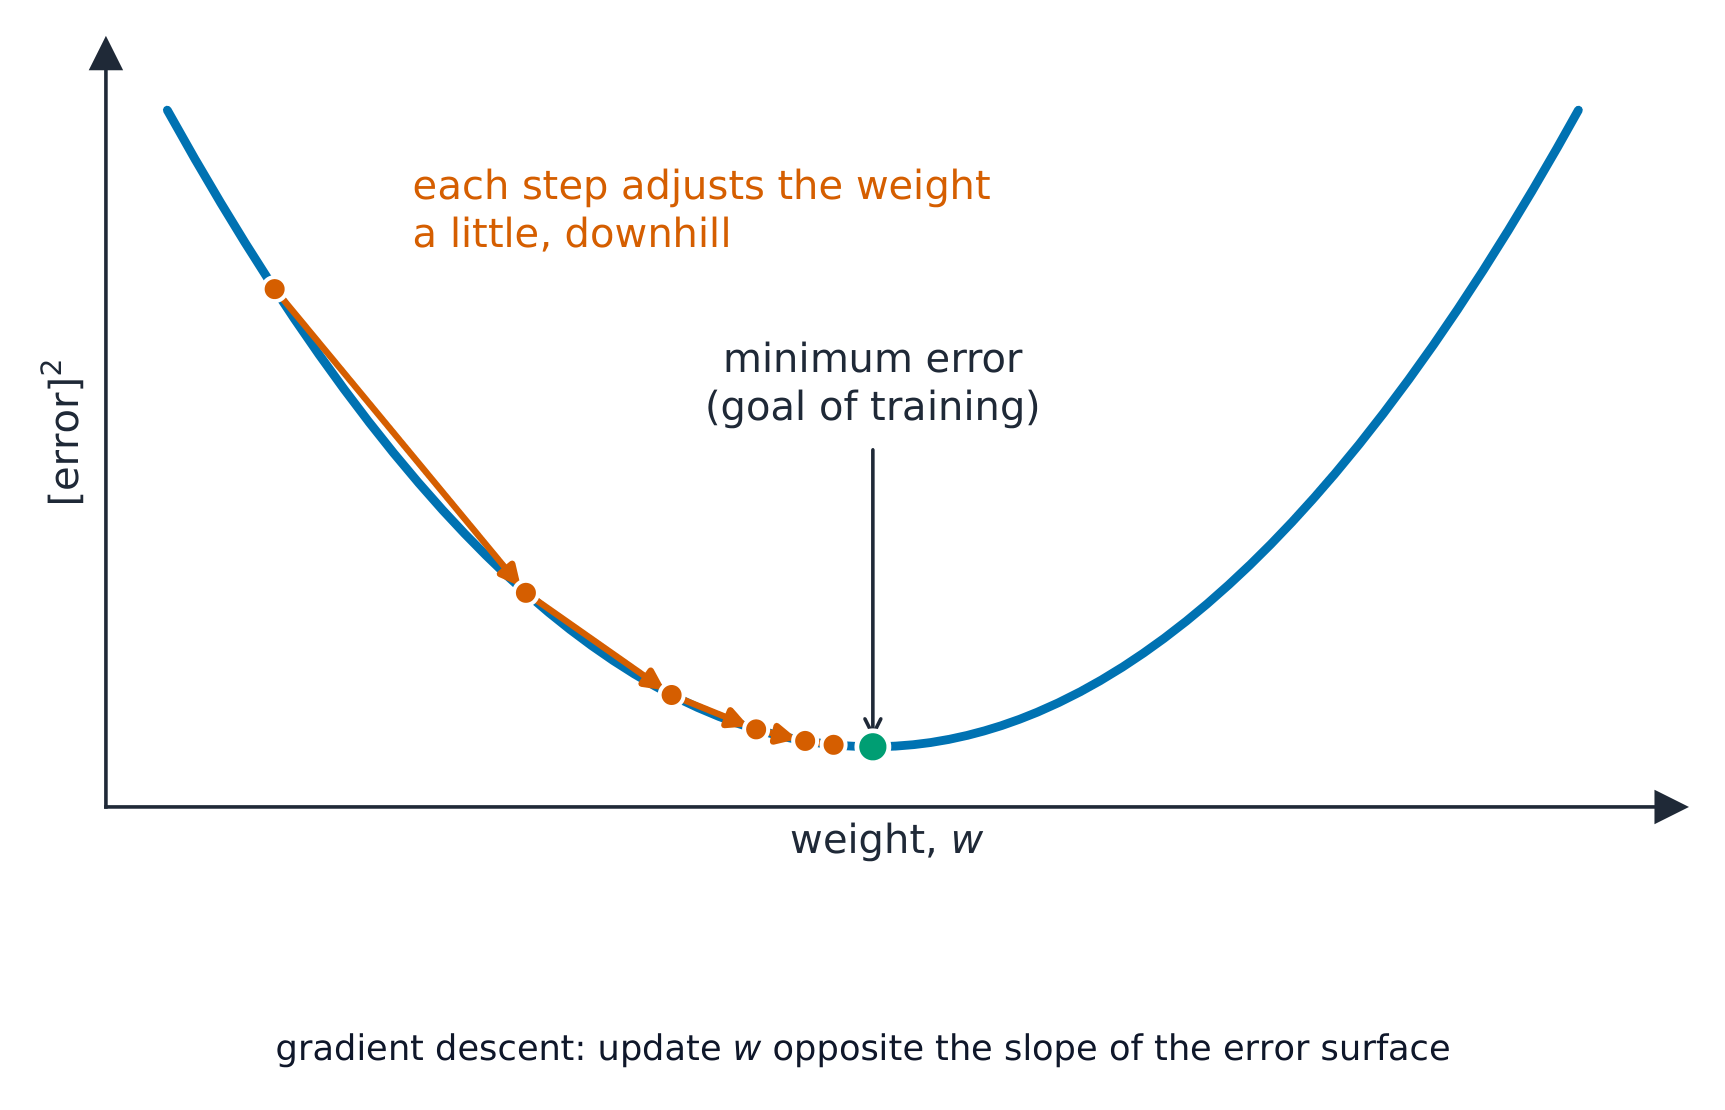
نزولاً للأسفل، خطوة صغيرة واحدة في كل مرة
Backpropagation trains a network by:
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
The error flows from the output back through the network (chain rule) so every weight's gradient is found, then weights step downhill.
Put one round of backpropagation training in order.
الصعوبة 3/5 · 200 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
Forward, error, backward, update, repeated over many epochs until the error stops falling.
epochs، ولماذا يُعد معدل التعلم مهمًا
- تمر واحد عبر مجموعة التدريب بأكملها يُسمى epoch. تتكرر عملية التدريب لعدة epochs حتى يتوقف الانخفاض في الخطأ.
- إذا كان كبيرًا جدًا، يتجاوز معدل التعلم الحد الأدنى ويقفز الخطأ حول؛ وإذا كان صغيرًا جدًا، تستغرق عملية التدريب وقتًا أطول بكثير مما يجب أن تستغرقه.
- بعد التدريب، استخدام النموذج هو مجرد مرور أمامي، ولهذا السبب يجيب الشبكة المدربة فورًا على الرغم من أن التدريب استغرق أيامًا.
In gradient descent the learning rate sets how big a step each weight update takes — too large overshoots the minimum, too small makes training slow.
الصعوبة 1/5 · 100 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
Backpropagation finds each weight's gradient; the learning rate scales how far down that gradient the weight moves.
Which statements about training are correct? Select جميعها that apply.
الصعوبة 2/5 · 140 عملة + مكافأة صغيرة عند الإنجاز الأول اليوم
The learning rate is the size of each weight update. That is why training can take days while a prediction takes milliseconds.
علامات ضائعة
- برر النماذج من خلال البيانات: البيانات الموصوفة تعني تعلمًا مشرفًا، والبيانات غير الموصوفة تعني تعلمًا غير مشرف، والإشارة التعويضية تعني التعلم المعزز.
- لا يوجد للتعلم المعزز أي تصنيفات. تسمية مكافأته بتصنيف هي ارتباك كلاسيكي.
- الانتشار العكسي هو أمامي، خطأ، عكسي، تحديث، مكرر. تسميته فقط "يعدّل الأوزان" هو نصف إجابة.
- معدل التعلم هو حجم كل خطوة، وليس سرعة التدريب أو عدد الepochs.
لقد فهمت الأمر
- المشرف يتعلم الإدخال إلى التصنيف من بيانات موصوفة، للتصنيف أو الانحدار · غير المشرف يكتشف البنية مثل العناقيد في بيانات غير موصوفة · المعزز له عامل يتعلم سياسة من مكافآت عن طريق التجربة والخطأ
- اختر النموذج من ما توفره البيانات، وليس من صعوبة المهمة
- الانتشار العكسي: مرور أمامي، خطأ من دالة الخسارة، مرور عكسي يعطي تدرج كل وزن، ثم تحديث بحجم تحدد بواسطة معدل التعلم
- تتكرر عملية التدريب لعدة epochs؛ استخدام النموذج المدرب هو مرور أمامي واحد