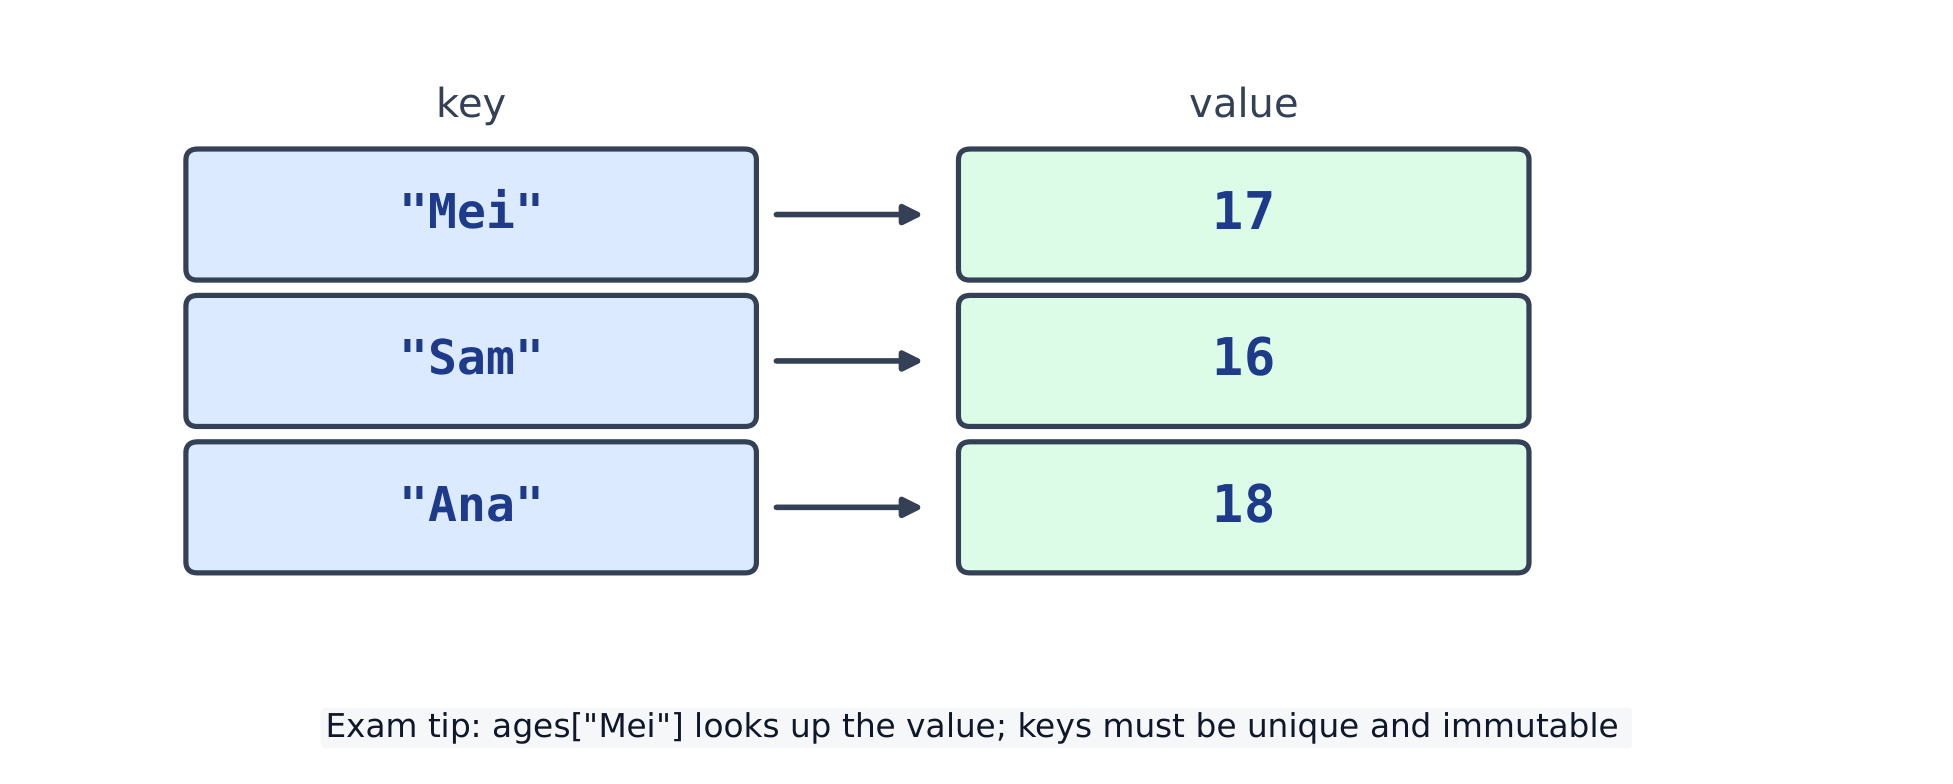
student = {"name": "Mei"}
student["score"] = 88      # add a new key
student["score"] = 90      # update the value
print(student)             # {'name': 'Mei', 'score': 90}
التحقق والتكرار
استخدم in لاختبار وجود مفتاح. كرر فوق المفاتيح، أو فوق .items() للحصول على المفتاح والقيمة معًا.
student = {"name": "Mei", "score": 90}
print("score" in student)  # True
for key, value in student.items():
    print(key, "=", value)
# name = Mei
# score = 90
يُرجع .get(key, default) افتراضيًا عند عدم وجود المفتاح — بدون خطأ.
يمكن للكود أن يفشل بثلاث طرق. خطأ في بناء الجملة يكسر قواعد بايثون، لذا لا يعمل أبداً. خطأ وقت التشغيل يحدث أثناء التنفيذ، مثل القسمة على صفر. خطأ منطقي يعمل لكن يعطي إجابة خاطئة.
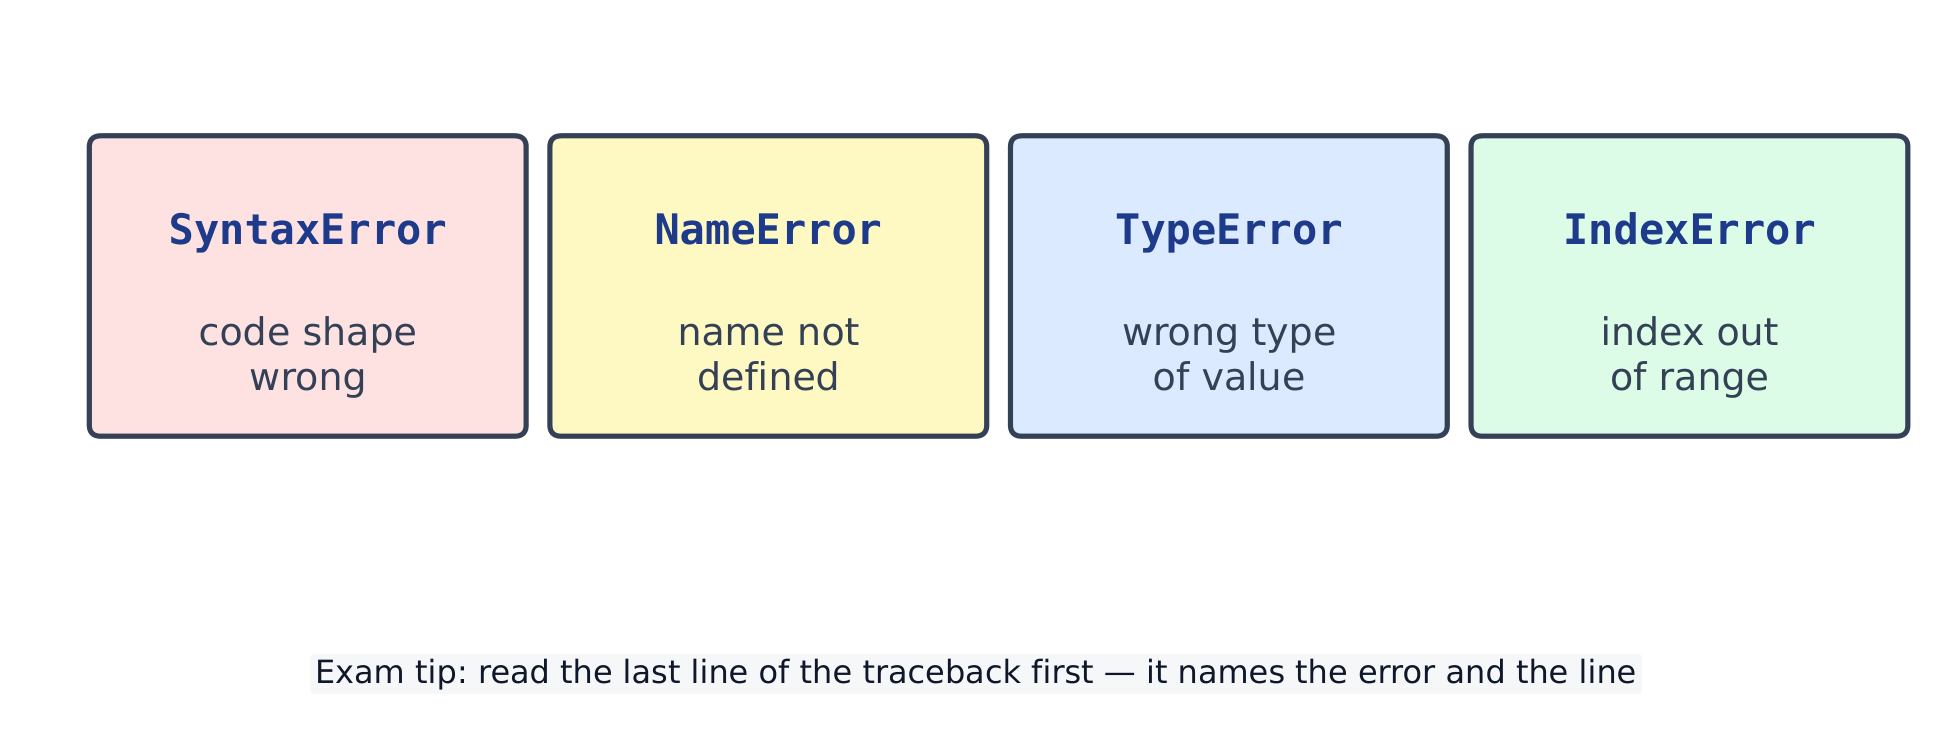
أخطاء بايثون الشائعة: بناء الجملة، الاسم، النوع، الفهرس
# A runtime error, caught so this block still finishes:
try:
    print(10 / 0)
except ZeroDivisionError:
    print("cannot divide by zero")
# cannot divide by zero
يطبع بايثون تتبعاً للخطأ يوضح مكان الفشل. اقرأه من الأسفل إلى الأعلى.
9.2
try / except / raise
ضع الكود الخطير في try؛ إذا فشل، يلتقط except الاستثناء بدلاً من انهيار البرنامج.
def set_age(age):
    if age < 0:
        raise ValueError("age cannot be negative")
    return age

try:
    set_age(-1)
except ValueError as err:
    print("error:", err)
# error: age cannot be negative
9.3
الاختبار والصلابة
الاختبار يتحقق من أن الكود يعطي الإجابة الصحيحة. جرب الحالات العادية و حالات الحواف — إدخال فارغ، صفر، قيم كبيرة جداً.
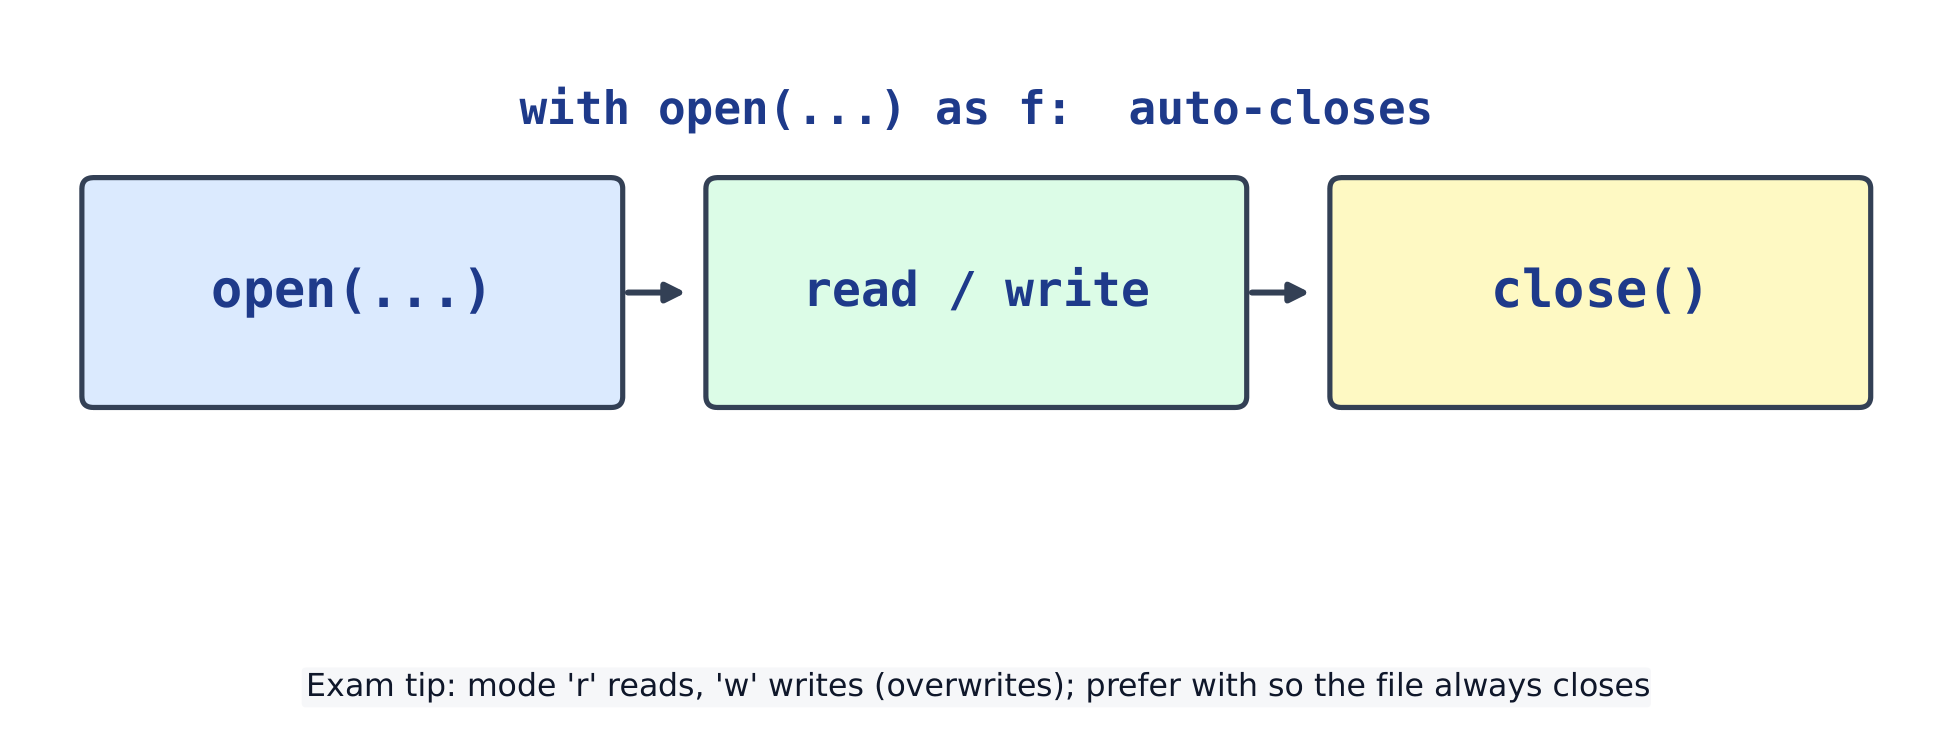
ملف نصي يخزن النص على القرص. افتحه باستخدام open(name, mode) حيث يشير الوضع إلى القراءة أو الكتابة. استخدم دائماً with، الذي يغلق الملف عنك.
الكتابة
وضع "w" يكتب ملفاً جديداً ويمسح أي ملف قديم.
with open("notes.txt", "w") as f:
    f.write("first line\n")
    f.write("second line\n")
print("saved")            # saved
القراءة
وضع "r" (الافتراضي) يقرأ. .read() يُرجع الملف بأكمله كسلسلة واحدة.
with open("notes.txt", "w") as f:
    f.write("hello\nworld\n")
with open("notes.txt") as f:
    print(f.read().strip())   # hello / world
سطراً بسطر
مرر على الملف للحصول على سطر واحد في كل مرة. .strip() يزيل السطر الجديد في النهاية.
with open("data.txt", "w") as f:
    f.write("Mei,88\nSam,71\n")
with open("data.txt") as f:
    for line in f:
        name, score = line.strip().split(",")
        print(name, "scored", score)
# Mei scored 88
# Sam scored 71
الإضافة
وضع "a" يُضيف — يضيف في النهاية دون مسح.
with open("log.txt", "w") as f:
    f.write("line 1\n")
with open("log.txt", "a") as f:
    f.write("line 2\n")
with open("log.txt") as f:
    print(f.read().strip())   # line 1 / line 2
الوضع
المعنى
"r"
قراءة (افتراضي)
"w"
كتابة (يمسح أولاً)
"a"
إضافة (إضافة في النهاية)
أخطاء شائعة
أغلق الملف دائماً، أو استخدم with open(...) as f: الذي يغلقه عنك.
تُعيد read() الملف كاملاً كنص واحد، ولا تزال كل سطر ينتهي بـ \n.
فتحه بـ "w" يمسح الملف أولاً؛ استخدم "a" للإضافة في النهاية.
الخوارزمية هي قائمة واضحة من الخطوات تحل مشكلة. التفكيك يعني تقسيم مشكلة كبيرة إلى أجزاء أصغر يمكنك حلها واحداً تلو الآخر.
# Algorithm: find the largest number in a list
def largest(nums):
    best = nums[0]
    for n in nums:
        if n > best:
            best = n
    return best

print(largest([3, 9, 2, 7]))   # 9
التجريد يعني تجاهل التفاصيل: تستخدم largest(...) دون إعادة قراءة كيفية عملها.
11.2
الكود الوهمي والمخططات الانسيابية
الكود الوهمي هو لغة إنجليزية بسيطة ومنظمة لخوارزمية، تُكتب قبل الكود الحقيقي. لا يتم تشغيله.
SET best TO first number
FOR Each number n
    IF n > best
      THEN
        SET best TO n
OUTPUT best
المخطط الانسيابي يرسم نفس المخطط: مربع لكل خطوة، معين لكل قرار، وأسهم للترتيب.
11.3
الاستدعاء الذاتي ومكدس الاستدعاءات
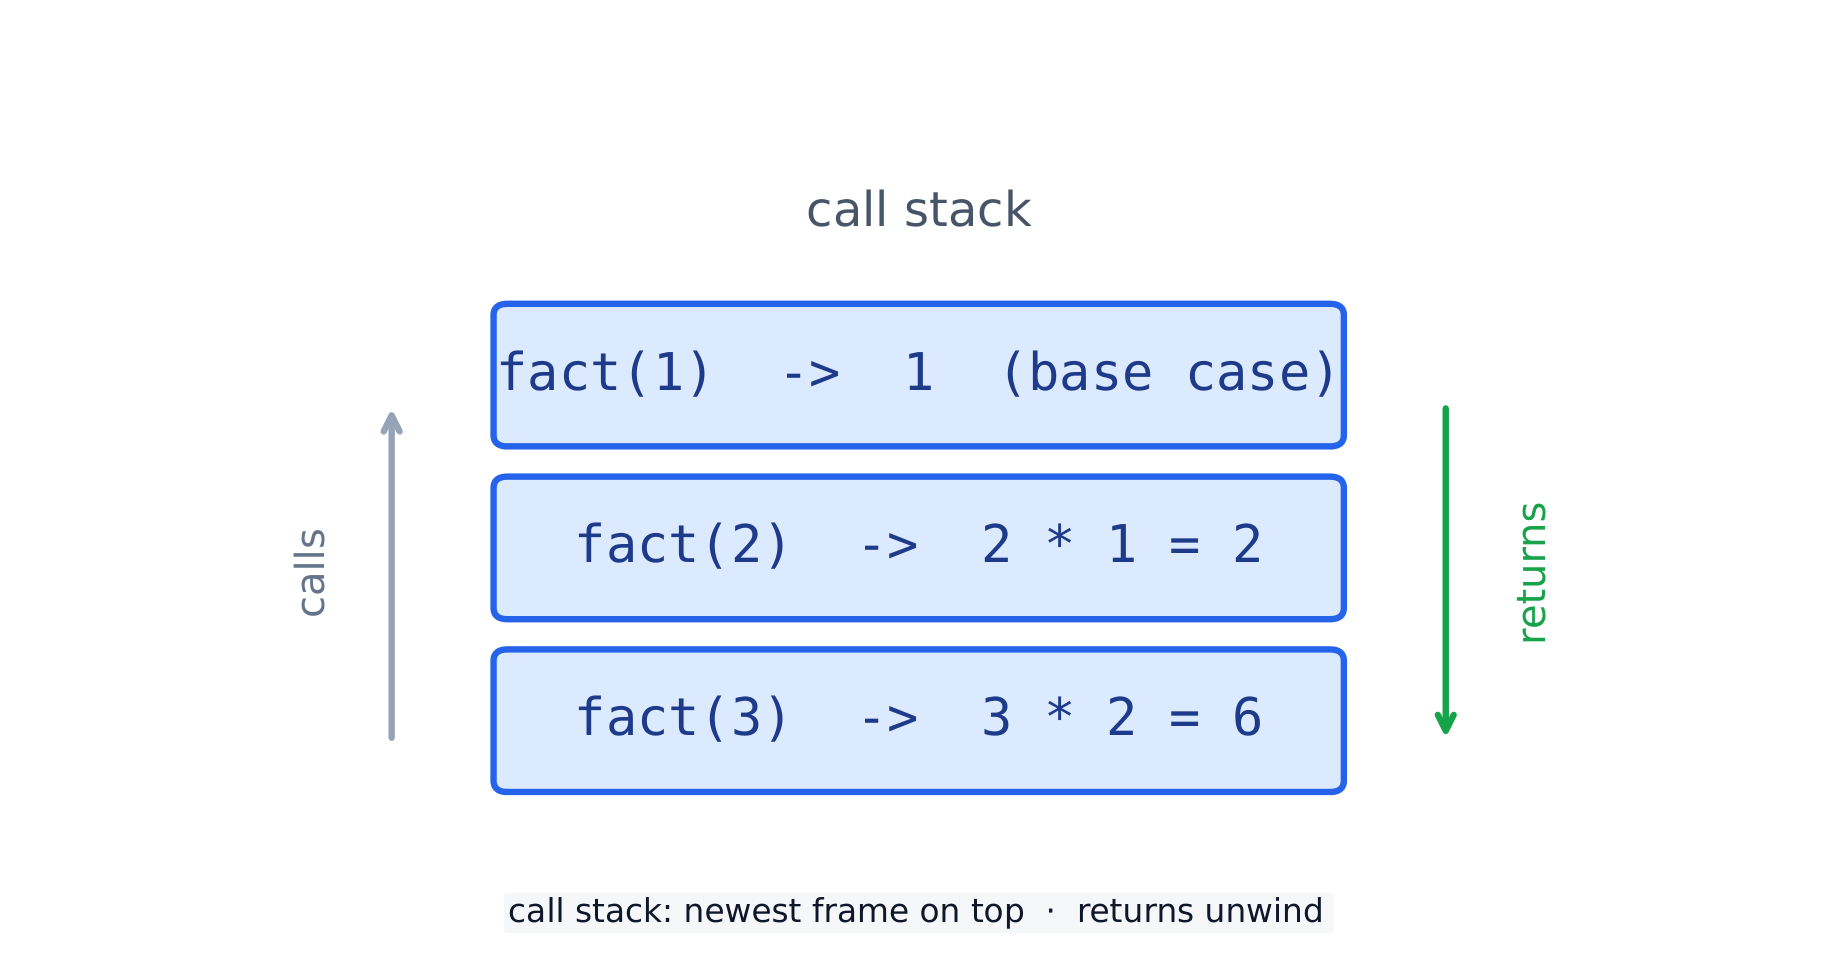
الاستدعاء الذاتي هو عندما تستدعي الدالة نفسها. تحتاج إلى حالة أساسية (مدخل بسيط يُرجع فوراً) وحالة استدعاء ذاتي (تستدعي نفسها على مدخل أصغر).
مكدس الاستدعاءات لـ factorial(3): كل استدعاء ينتظر ثم يُعيد النتيجة بالعكس
def fact(n):
    return 1 if n <= 1 else n * fact(n - 1)

print(fact(5))     # 120
كل استدعاء متوقف يجلس على مكدس الاستدعاءات حتى يرجع الاستدعاء الذي فوقه.
أخطاء شائعة
الاستدعاء الذاتي يحتاج لحالة أساسية، وإلا يستدعي نفسه إلى ما لا نهاية ويُسبب انهيار مكدس الاستدعاءات.
الكود الوهمي للتخطيط — لا يجب أن يعمل، لكن كل خطوة يجب أن تكون غير غامضة.
قسّم مشكلة كبيرة إلى خطوات صغيرة مسماة قبل كتابة أي كود.
نوع بيانات تجريدي (ADT) يصف بعض البيانات بالإضافة إلى العمليات عليها، منفصلة عن كيفية بنائها. تستخدمه من خلال عملياته، وليس من خلال تخزينه الداخلي.
# A stack ADT, built on a list
s = []
s.append(1)        # add
s.append(2)
print(s.pop())     # 2  (remove the most recent)
12.2
المكدسات
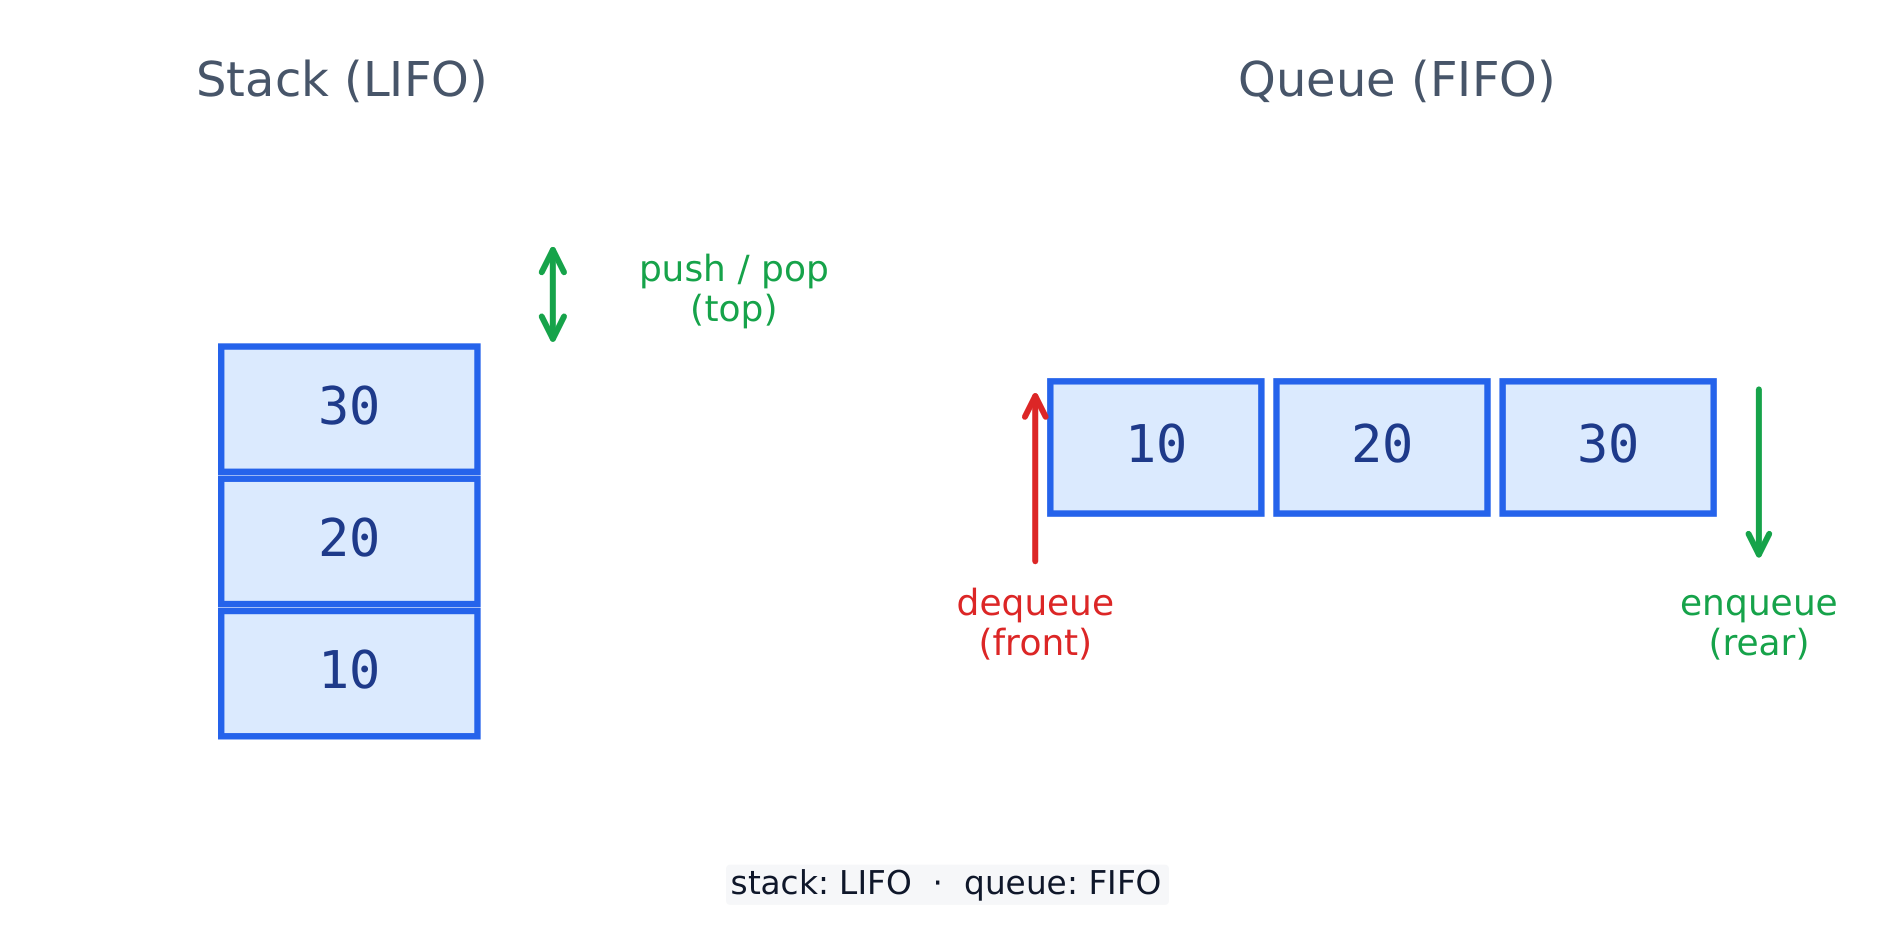
المكدس هو آخر الداخل، أول الخارج (LIFO). تدفع للأعلى وتُخرج من الأعلى.
يتم إزالة العنصر من الأعلى في المكدس (LIFO)؛ وفي الطابور يتم الإزالة من الأمام (FIFO)
stack = []
stack.append("a")
stack.append("b")
print(stack.pop())   # b
print(stack.pop())   # a
12.3
الطوابير
الطابور هو أول الداخل، أول الخارج (FIFO). تضيف في الخلف وتُخرج من الأمام.
queue = []
queue.append("a")     # enqueue
queue.append("b")
print(queue.pop(0))   # a  (dequeue the front)
print(queue.pop(0))   # b
12.4
القوائم المترابطة
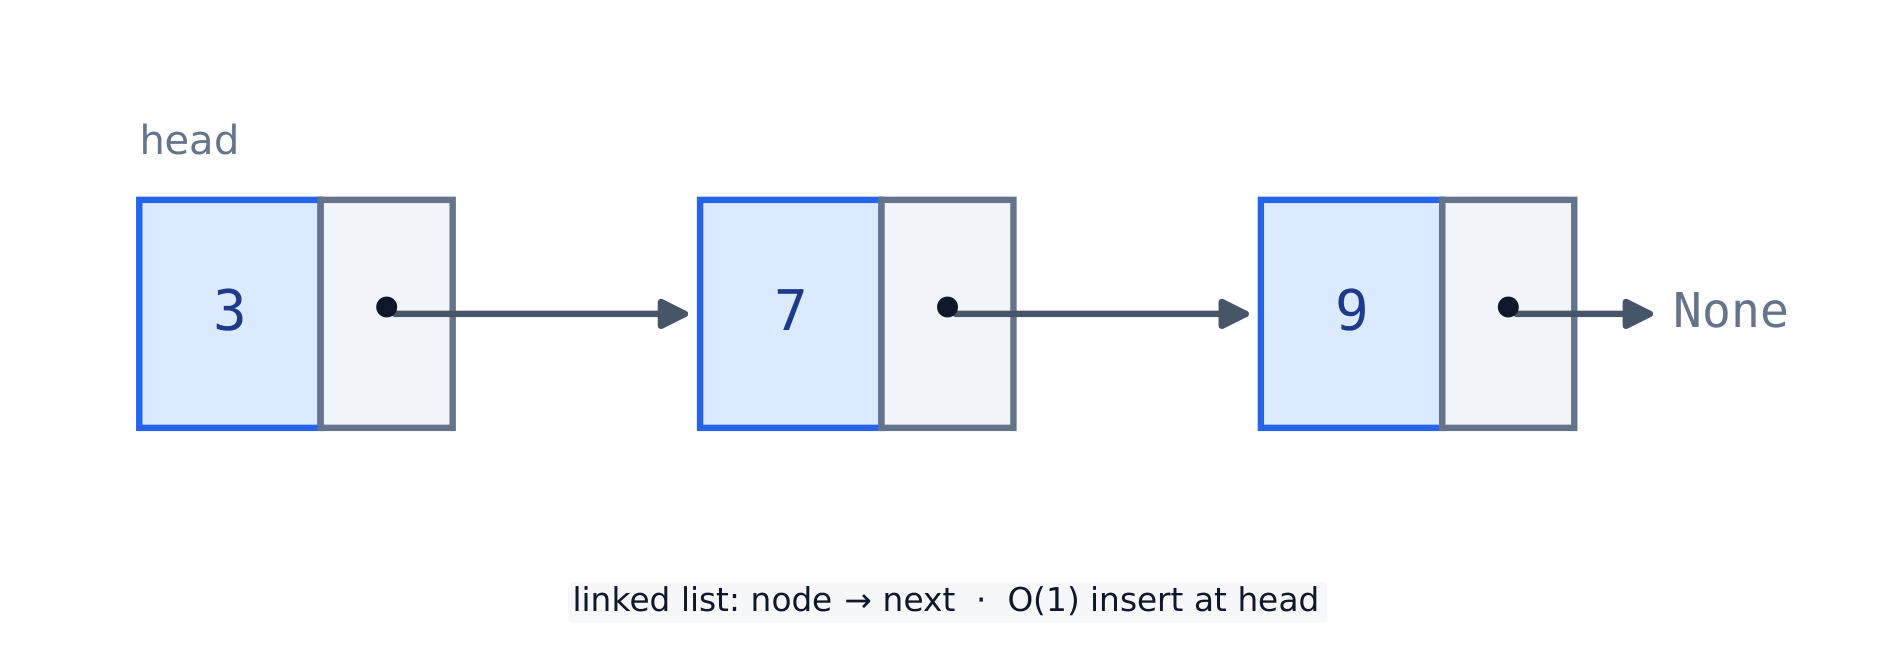
قائمة مترابطة هي سلسلة من العقد. كل عقدة تحتوي على بيانات ومؤشر للعقدة التالية؛ الأخيرة تشير إلى None.
قائمة مرتبطة: كل عقدة تحتوي على بيانات ومؤشر إلى العقدة التالية، وتنتهي بـ None
n3 = {"data": 3, "next": None}
n2 = {"data": 2, "next": n3}
n1 = {"data": 1, "next": n2}
node = n1
while node is not None:      # traverse to the end
    print(node["data"])
    node = node["next"]
# 1 2 3
12.5
الجداولIMATION
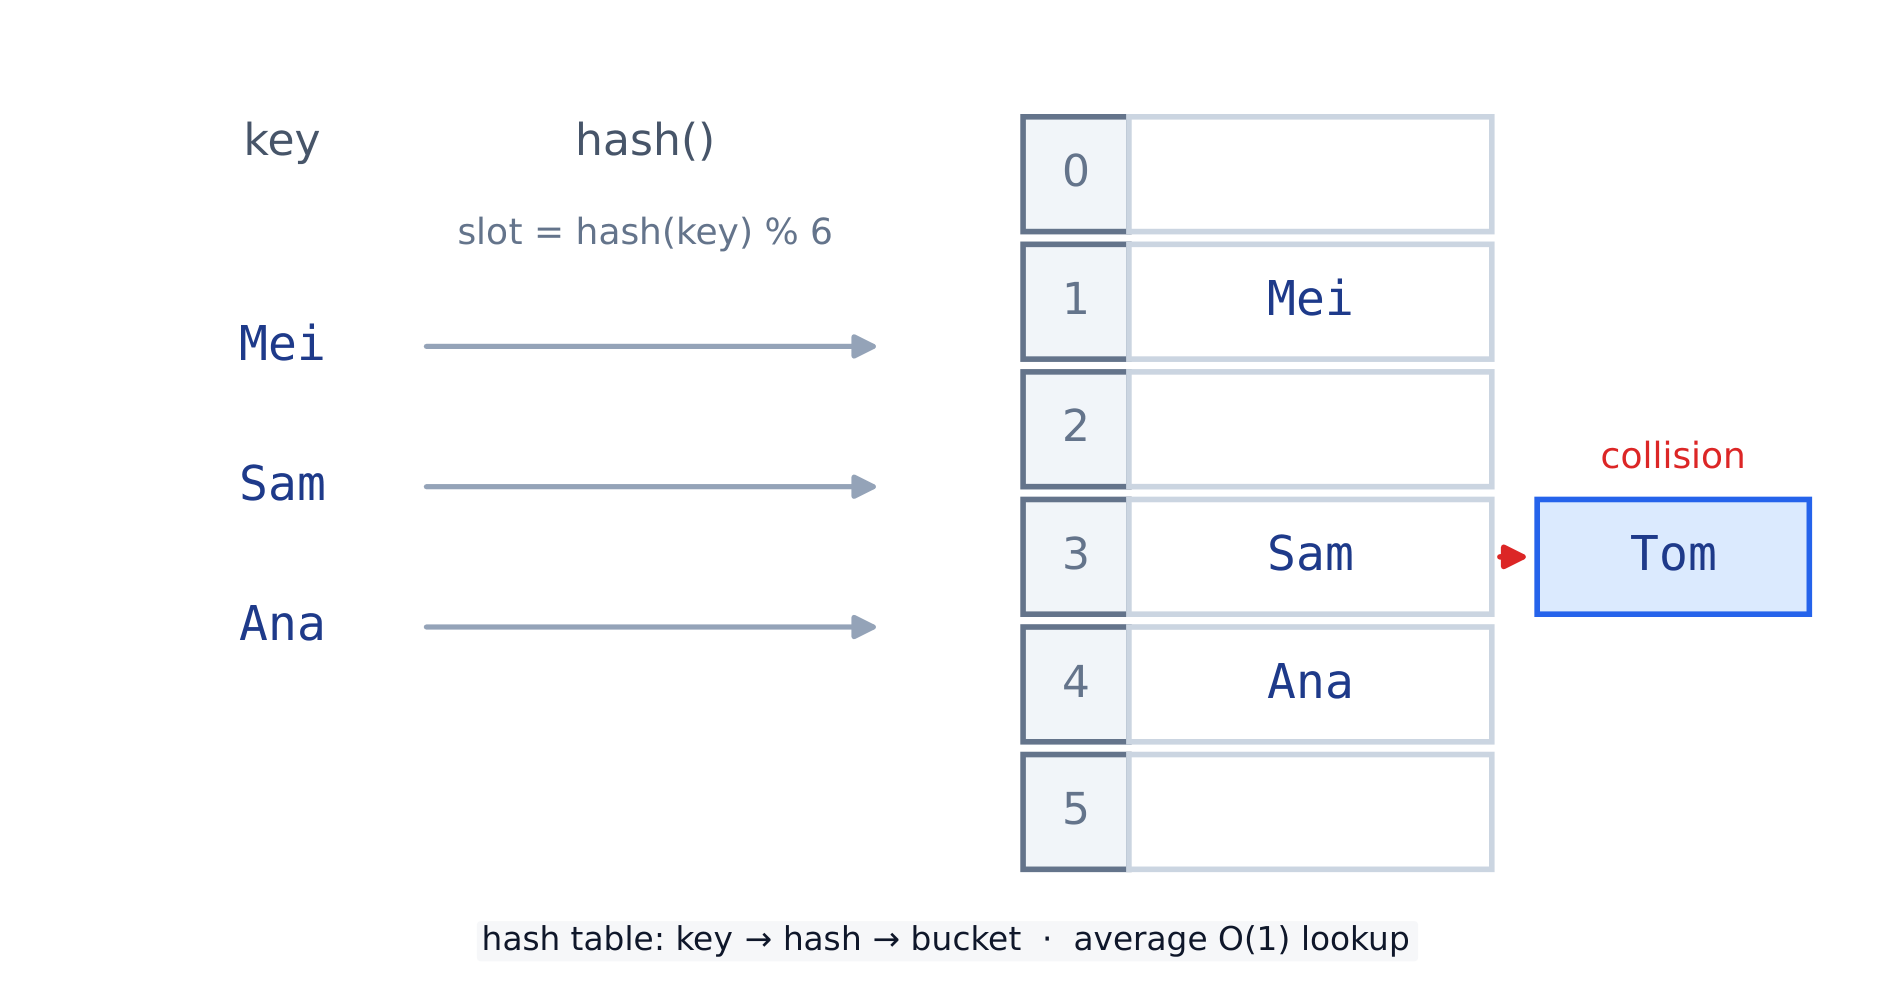
جدول الIMATION يربط مفتاحاً بمكان باستخدام دالة الIMATION. يمكن لمفتاحين أن يسقطا في نفس المكان — تصادم. dict الخاص ببايثون هو جدولIMATION، لذا البحث سريع.
دالة التجزئة تربط كل مفتاح بمكان؛ يمكن أن يتصادم مفتاحان في نفس المكان
البحث يعثر على مكان قيمة ما. البحث الخطي يفحص كل عنصر بالتتابع، لذا يعمل على أي قائمة.
def linear_search(items, target):
    for i in range(len(items)):
        if items[i] == target:
            return i
    return -1     # not found

print(linear_search([4, 8, 2, 9], 2))   # 2
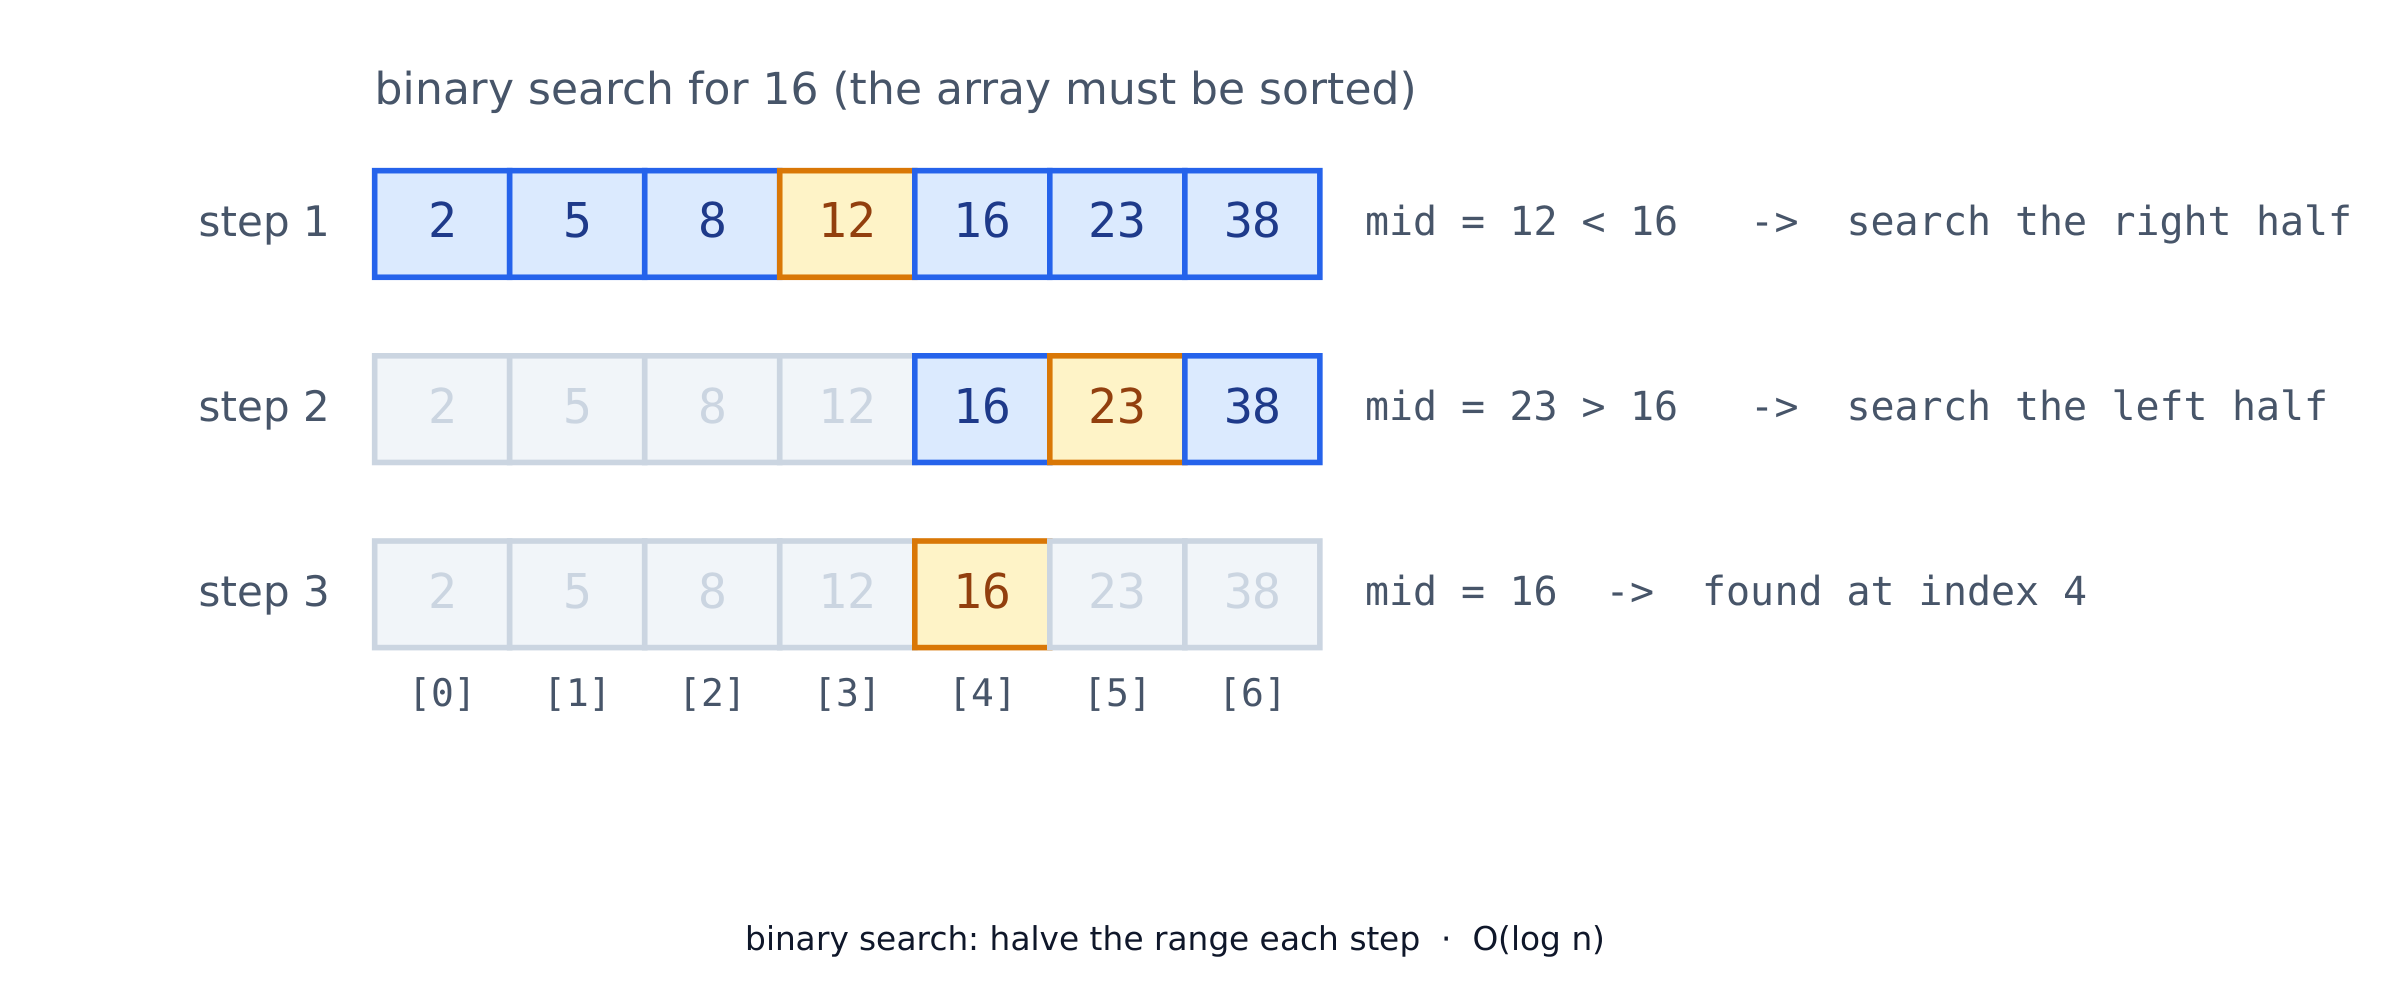
البحث الثنائي أسرع بكثير لكنه يتطلب قائمة مرتبة. يقسم النطاق إلى نصفين في كل خطوة.
def binary_search(items, target):
    lo, hi = 0, len(items) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if items[mid] == target:
            return mid
        elif items[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

print(binary_search([1, 3, 5, 7, 9], 7))   # 3
البحث الثنائي يقسم النطاق إلى نصفين في كل خطوة — O(log n) على قائمة مرتبة
13.2
الفرز (فقاعي وإدراج)
الفرز هو وضع العناصر في ترتيب. الفرز الفقاعي يقوم بتبديل الأقران المتتاليين اللذين ليسا في الترتيب الصحيح بشكل متكرر.
def bubble_sort(a):
    a = a[:]                          # work on a copy
    for i in range(len(a)):
        for j in range(len(a) - 1 - i):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
    return a

print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
فرز الإدراج يبني جزءاً مرتباً عن طريق عنصر واحد في كل مرة، مزاحاً كل عنصر جديد للخلف إلى مكانه:
def insertion_sort(a):
    a = a[:]                           # work on a copy
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:   # shift bigger values right
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key                 # drop key into the gap
    return a

print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
في الكود الفعلي، استخدم الدالة المدمجة Python sorted():
print(sorted([5, 2, 4, 1])) # [1, 2, 4, 5]
13.3
كفاءة الخوارزميات
الكفاءة تسأل كيف ينمو العمل مع نمو المدخلات. نصفها باستخدام Big-O.
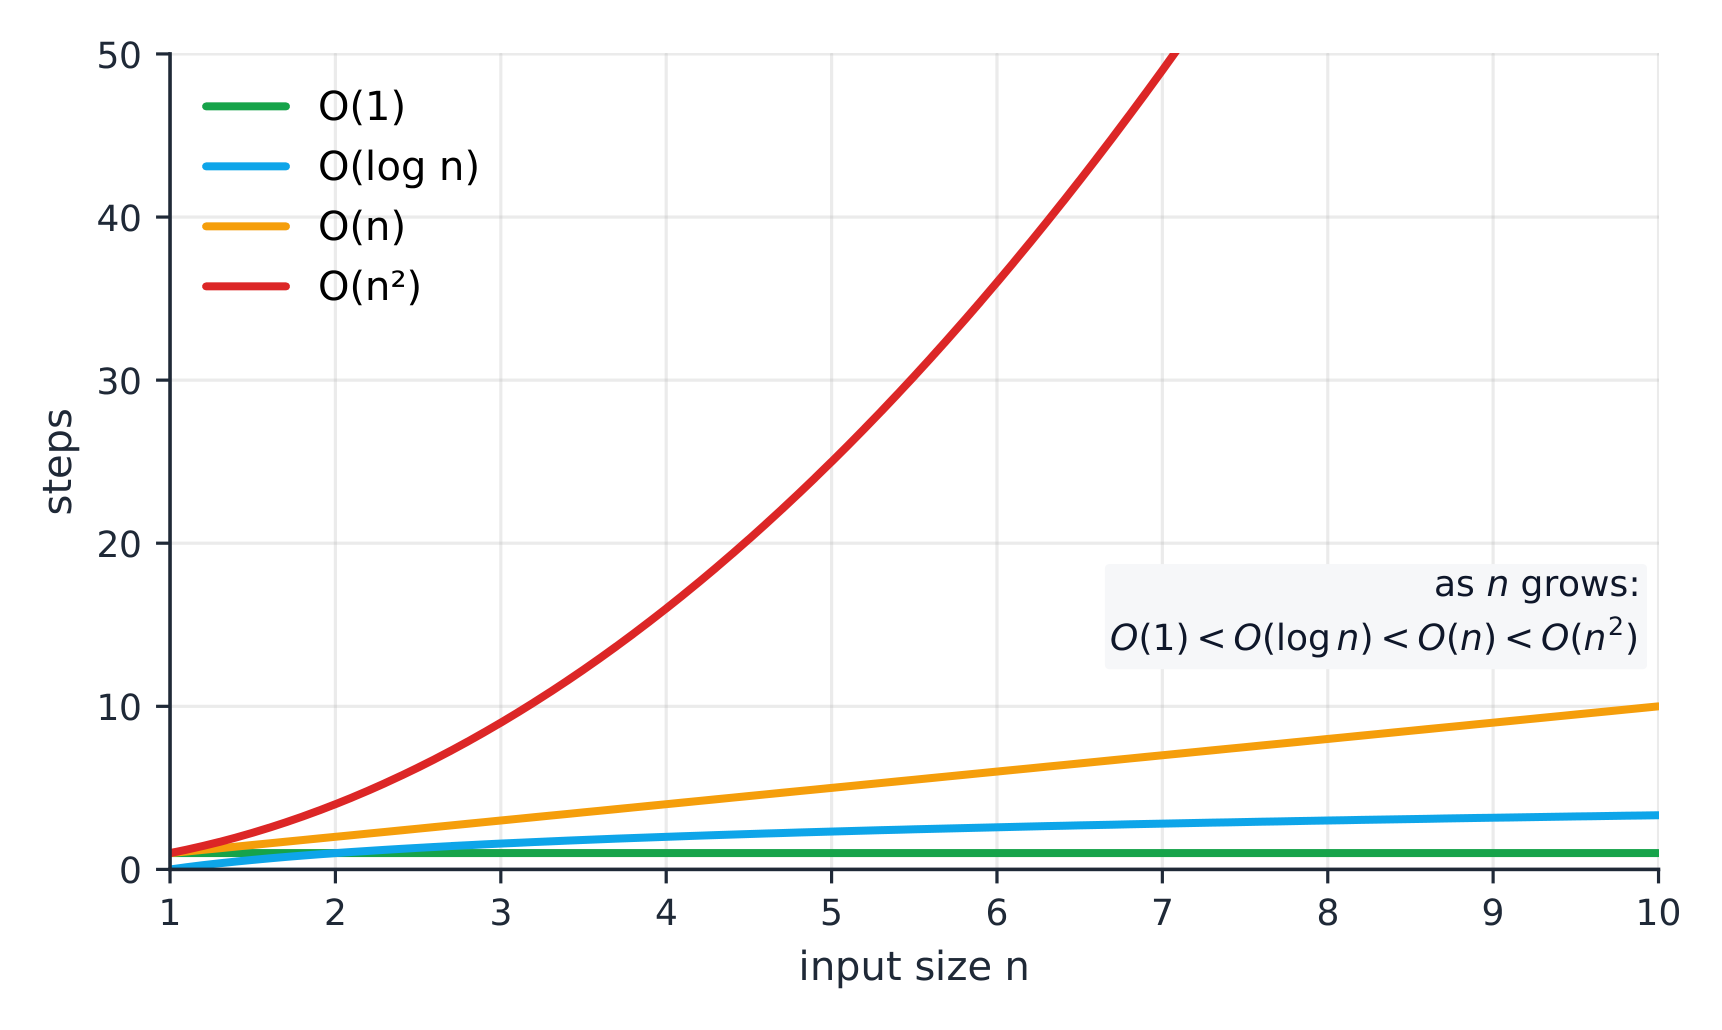
كيف ينمو عدد الخطوات مع حجم المدخلات للتعقيدات الشائعة
Big-O
الاسم
مثال
$O(1)$
ثابت
البحث عن مفتاح في قاموس
$O(\log n)$
لوغاريتمي
البحث الثنائي
$O(n)$
خطي
البحث الخطي
$O(n^2)$
تربيعي
الفرز الفقاعي
def steps(n):           # how many steps a linear scan takes
    count = 0
    for i in range(n):
        count = count + 1
    return count

print(steps(100))       # 100  -> O(n)
13.4
العشوائية والمحاكاة
وحدة random تولد أرقاماً عشوائية. استخدم بذرة لجعل النتائج قابلة للتكرار. المحاكاة تشغل تجارب عشوائية عديدة لتقدير إجابة.
import random
random.seed(0)
rolls = [random.randint(1, 6) for _ in range(1000)]
print(rolls.count(6))   # about 1/6 of 1000
أخطاء شائعة
البحث الثنائي يعمل فقط على قائمة مرتبة.
Big-O يخبرك بكيفية نمو الوقت، وليس الوقت الدقيق؛ طريقة O(n²) تفوق O(n) فقط للمدخلات الصغيرة جداً.
الفرز الفقاعي هو O(n²) — جيد للتعلم، لكن بطيء على القوائم الكبيرة.
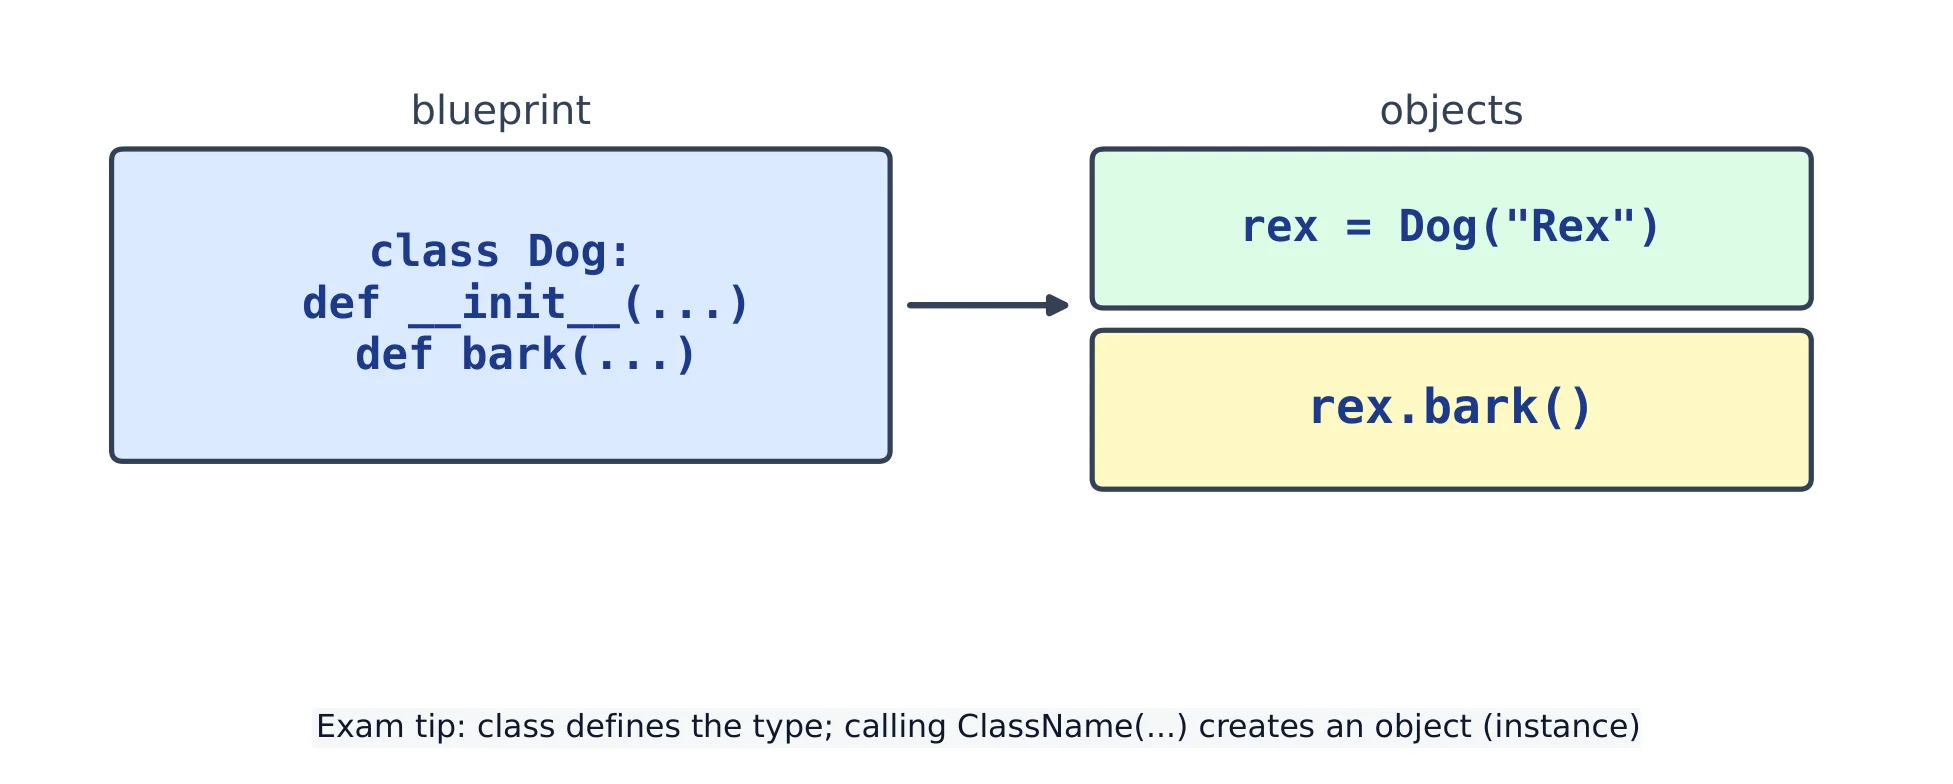
الفئة هي مخطط. الكائن هو شيء مبني منها (مثيل). __init__ هو البناء الذي يُعدّ كل كائن؛ self هو الكائن نفسه.
class Dog:
    def __init__(self, name):
        self.name = name            # an attribute
    def speak(self):
        return self.name + " says woof"

d = Dog("Rex")
print(d.speak())     # Rex says woof
name هو سمة (بيانات على الكائن)؛ speak هي دالة (عمل).
أضف __str__ للتحكم في عرض print(obj):
class Dog:
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return f"Dog named {self.name}"

print(Dog("Rex"))    # Dog named Rex
الفئة هي مخطط؛ استدعاؤها تنشئ كائناً
14.2
الوراثة، التغليف، والتعدد الشكل
الوراثة تسمح للفئة الفرعية بإعادة استخدام الفئة الأب. استخدم super() لاستدعاء الأب؛ عدّل دالة لتغييرها.
class Animal:
    def speak(self):
        return "some sound"

class Cat(Animal):
    def speak(self):                # override
        return "meow"

print(Cat().speak())   # meow
التغليف يجمع البيانات مع الدوال ويكشف عن واجهة مقصودة. في بايثون، يشير الشريط السفلي البادئ إلى اسم غير عام (يُطلق عليه غالباً خاص) بالعرف فقط؛ ولا يمنع الكود الخارجي من الوصول إليه. تداخل الأسماء المزدوج الشريط السفلي يساعد في تجنب تصادم أسماء الوراثة العرضي، وليس لفرض الأمان.
class Account:
    def __init__(self):
        self._balance = 0           # non-public by convention
    def deposit(self, n):
        self._balance += n
    def balance(self):
        return self._balance

a = Account()
a.deposit(50)
print(a.balance())     # 50
التعدد الشكل يعني اسماً واحداً، سلوكيات متعددة — الدالة speak الصحيحة تعمل لكل كائن.
class Cat:
    def speak(self):
        return "meow"

class Cow:
    def speak(self):
        return "moo"

for animal in [Cat(), Cow()]:
    print(animal.speak())   # meow, then moo
14.3
نماذج البرمجة
النمط هو أسلوب في كتابة البرامج. الكود الإجرائي هو سلسلة من الخطوات والدوال. الكود الموجه للكائنات يجمع البيانات والدوال في كائنات. الكود التصريحي يقول ماذا تريد، لا كيف (استيعاب قائمة أو SQL).
def total(nums):           # procedural
    t = 0
    for n in nums:
        t += n
    return t
print(total([1, 2, 3]))    # 6

print(sum([1, 2, 3]))      # 6  (declarative: same result)
أخطاء شائعة
كل دالة تحتاج self كمعامل أول.
__init__ يُعدّ كائناً جديداً ويعمل تلقائياً عند إنشائه.
كائنان من نفس الفئة لديهما سمات منفصلة؛ تغيير أحدهما لا يغير الآخر.
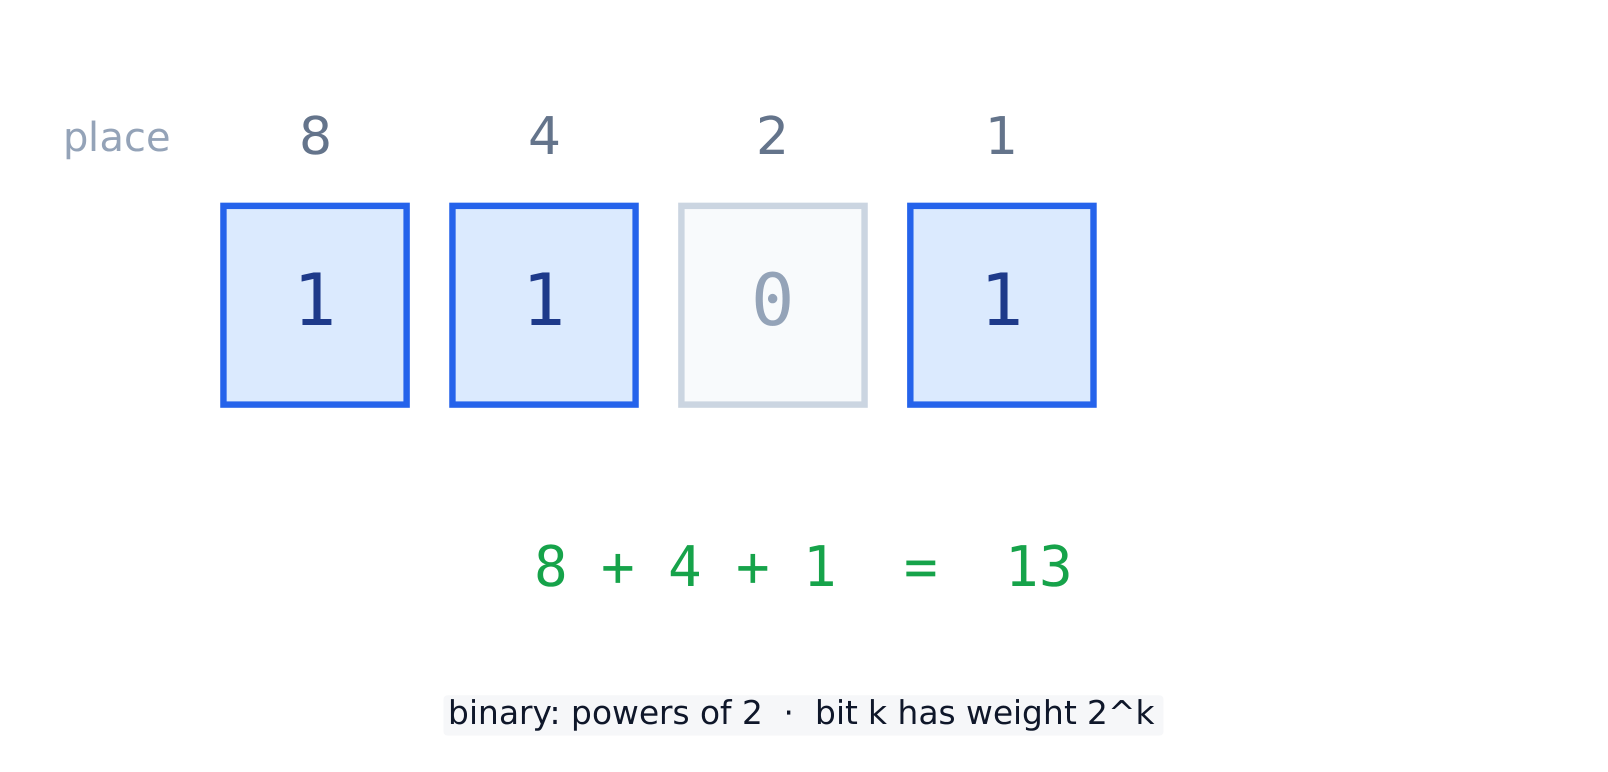
البيت هو 0 أو 1 فردي. النظام الثنائي هو نظام العد ذو الأساس 2: قيمة كل خانة ضعف ما على يمينها (1، 2، 4، 8، …). النظام العشري (الأساس 10) هو أرقامنا العادية.
قيم خانات النظام الثنائي: 1101 تعني 8 + 4 + 1 = 13
الضغط يجعل البيانات أصغر. الضغط بدون فقدان يحفظ كل بت، لتعيد بناء الأصل بدقة. الضغط بفقدان يزيل التفاصيل — أصغر ولكن ليس دقيقاً — ويستخدم للصور والموسيقى.
ترميز المسارات المتتالية هو طريقة ضغط بدون فقدان بسيطة: تخزن المسار (التكرار) كعدد تكرارات وقيمة.
def rle(text):
    out = ""
    i = 0
    while i < len(text):
        run = 1
        while i + run < len(text) and text[i + run] == text[i]:
            run += 1
        out += str(run) + text[i]
        i += run
    return out

print(rle("AAAABBBCCD"))   # 4A3B2C1D
أخطاء شائعة
n بتات تخزن 2**n قيم مختلفة، من 0 حتى 2**n - 1.
الضغط بفقدان يزيل التفاصيل ولا يمكن عكسه؛ الضغط بدون فقدان يمكن عكسه بدقة.
الحوسبة تعني حل المشكلات باستخدام الحواسيب: إدخال، معالجة، إخراج. البرمجيات الجيدة تُبنى في دورة تصميم — تخطيط، كتابة، اختبار، تحسين — تتكرر مرات عديدة.
قسم المشكلة، بِنِ جزءاً صغيراً، اختبره، ثم أضف المزيد.
المبرمجون يعملون في فرق ويعيدون استخدام أكواد بعضهم البعض.
16.2
الإنترنت
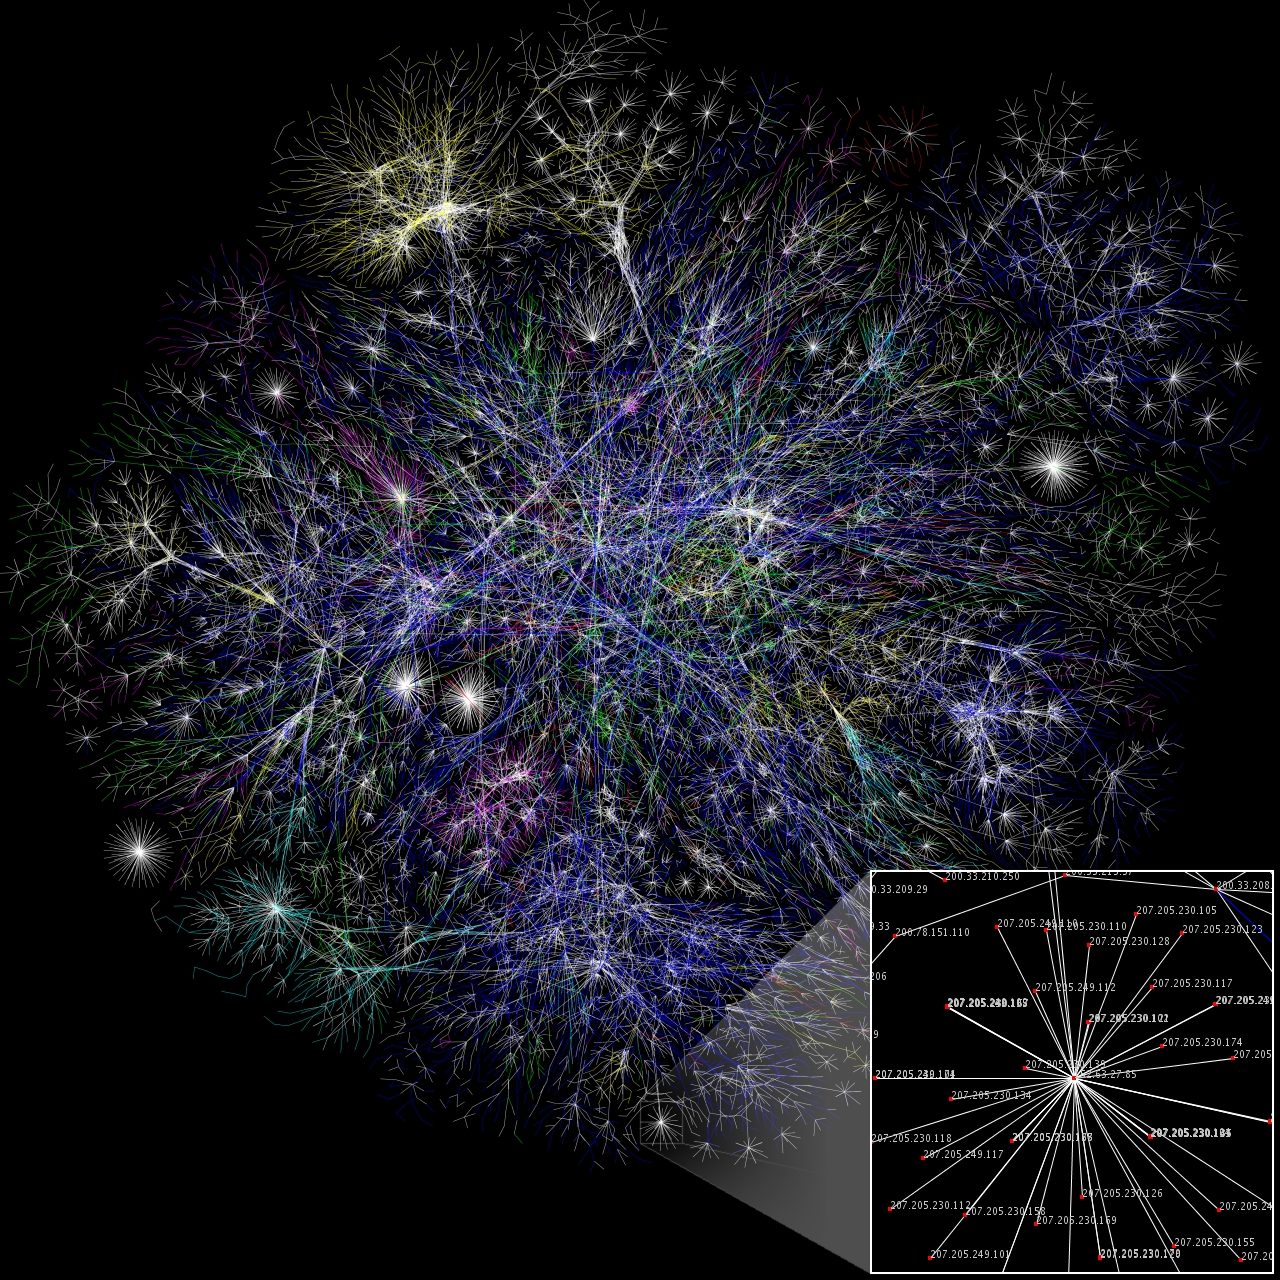
إنترنت هو شبكة شبكات. البيانات مقسمة إلى حزم تسافر بشكل منفصل وتُعاد تجميعها في الطرف الآخر. قواعد مشتركة تسمى بروتوكولات (مثل TCP/IP) تجعل هذا ممكنًا. إذا تعطل مسار، تأخذ الحزم طريقاً آخر — وهذا redundancy، والذي يمنح تحمل الأخطاء.
خريطة للإنترنت: كل خط هو مسار بين شبكتين
الطبقة
المهمة
HTTP
طلب وإرسال صفحات الويب
TCP
توصيل موثوق، بالترتيب
عنوان IP
والتوجيه
16.3
الحوسبة المتوازية والموزعة
الكود التسلسلي ينفذ خطوة واحدة في كل مرة. الحوسبة المتوازية تنفذ عدة خطوات في آنٍ واحد على عدد من الأنوية، مما قد يوفر زيادة في السرعة. الحوسبة الموزعة توزع العمل عبر أجهزة حاسوب متعددة، مثل ساحة الحوسبة السحابية.
لا يمكن تشغيل كل شيء بالتوازي: بعض الخطوات يجب أن تنتظر نتيجة سابقة.
16.4
تأثير الحوسبة
تجلب الحوسبة فوائد وأضراراً معاً. يعني الفاصل الرقمي عدم امتلاك الجميع وصولاً متساوياً إليها. قد يحمل البرمجيات تحيزاً مستمداً من البيانات التي تتعلم منها. احترم الملكية الفكرية (التراخيص)، واحمِ البيانات الشخصية للأنظمة والخصوصية.
أخطاء شائعة
الإنترنت وشبكة المعلومات العالمية (World Wide Web) ليسا نفس الشيء: الشبكة هي خدمة واحدة تعمل فوق الإنترنت.
زيادة عدد أنوية المعالج تساعد فقط إذا كان العمل قابلاً للتقسيم إلى أجزاء تعمل في نفس الوقت.
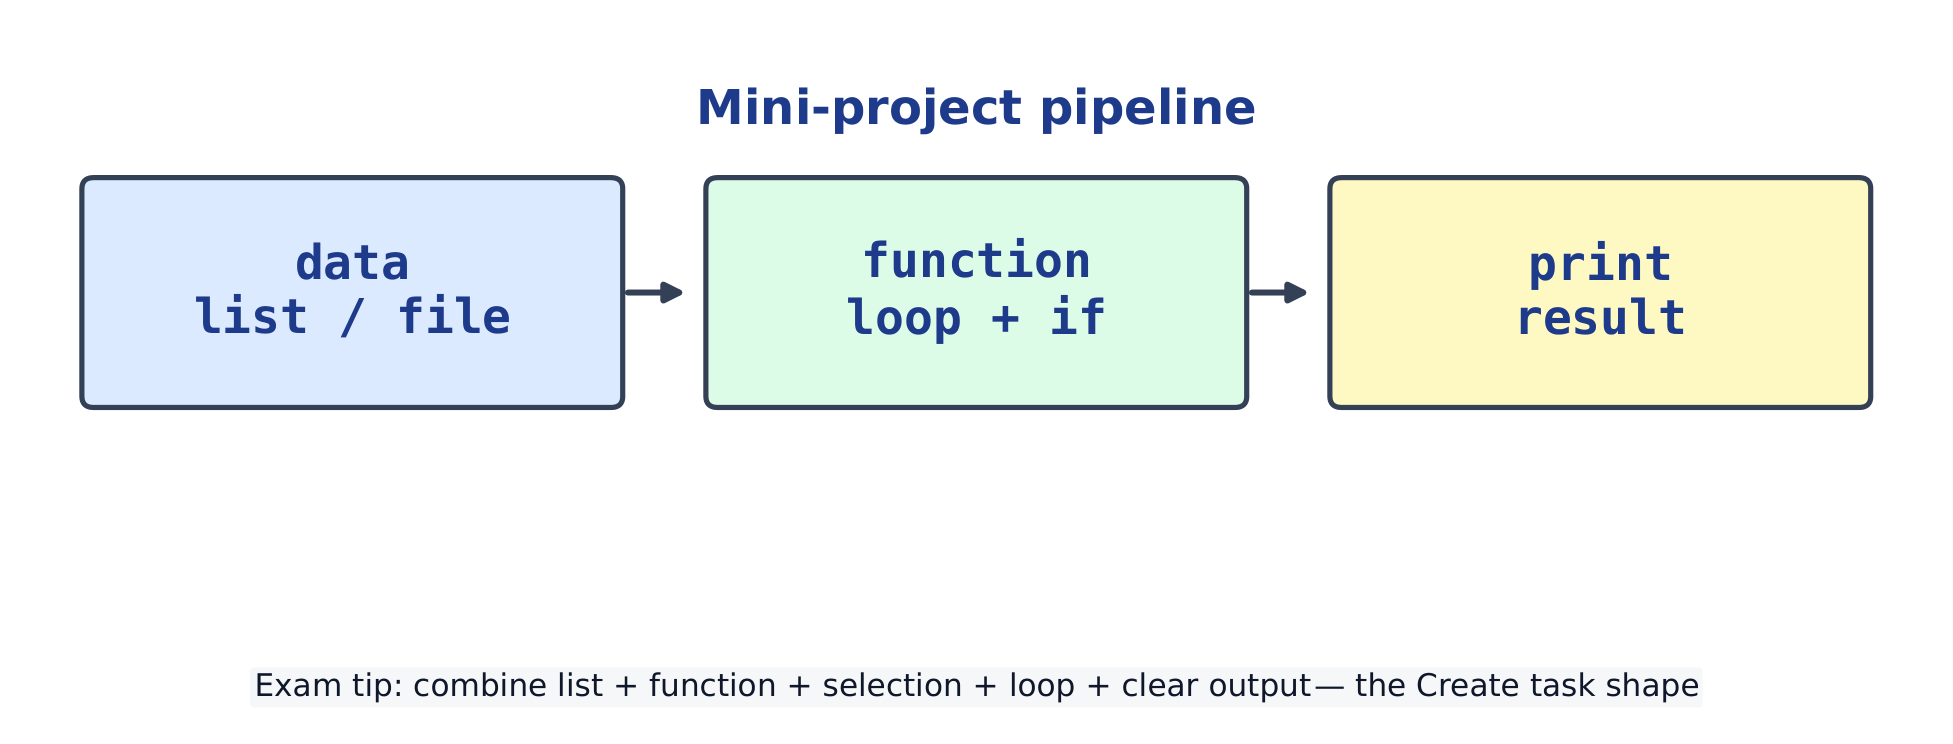
يجمع المشروع المصغر بين الأفكار السابقة: بيانات في قائمة، ودالة تحتوي على اختيار داخل حلقة، ومخرجات مطبوعة. هذا هو أيضاً شكل مهمة الأداء الإبداعي (AP Create Performance Task).
def count_passes(marks, pass_mark=60):
    passes = 0
    for m in marks:                 # iteration
        if m >= pass_mark:          # selection
            passes += 1
    return passes

print(count_passes([88, 50, 95, 60]))   # 3
مشروع: تصفية إلى قائمة جديدة
def merit(marks):
    return [m for m in marks if m >= 80]

print(merit([88, 71, 95, 60]))     # [88, 95]
تطلب مهمة AP إبداع قائمة، وإجراء معلمات يستخدم فيه الاختيار والتكرار، وبعض المدخلات/المخرجات. كل مشروع أعلاه يأخذ هذا الشكل تماماً — بنِ قطعاً صغيرة، ثم ادمجها.
أخطاء شائعة
بنِ بخطوات صغيرة واختبر كل جزء قبل الانتقال إليه — لا تكتب الكود بالكامل دفعة واحدة.
اقرأ المهمة كاملة أولاً، ثم خطط للمدخلات → المعالجة → المخرجات قبل كتابة الكود.