此页面需较新浏览器(支持 SharedArrayBuffer)。请升级 Chrome、Edge、Firefox 或 Safari 至最新版本。
为什么要压缩数据
- 数据存储需要空间,发送需要时间。
- 压缩(compression)让文件变小,这样保存更便宜、分享更快。
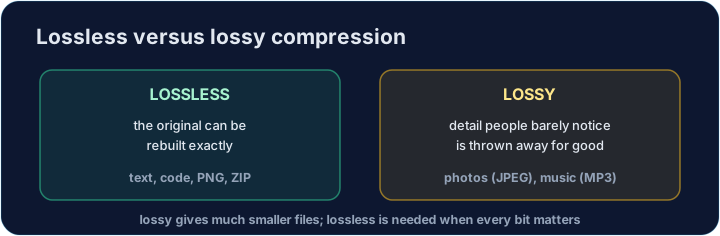
- 压缩有两种:无损(lossless)和有损(lossy)。
无损压缩
- 无损让文件变小,但保留数据的每一个比特。
- 当你打开文件时,你得到完全相同的原始数据。
- 它的做法是找出规律,然后用更短的方式写出来。
English
Original:  AAAAAAAA-BBB
Shorter:   8A-3B          (8 A's, then 3 B's)
Open it:   AAAAAAAA-BBB   (exactly the same again)
有损压缩
- 有损通过丢掉一些数据让文件小得多。
- 它丢掉的是人们几乎看不到或听不到的细节。
- 你无法拿回完全一样的原始数据 —— 但它"足够接近"。
English
Photo (large)  --lossy-->  Photo (small)
A few colors and fine details are gone,
but your eye hardly notices.
取舍:大小 vs 质量
- 无损保留完整质量,但文件仍然较大。
- 有损给出小得多的文件,但质量会下降一点。
- 你根据哪个更重要来选择:完美的数据还是更小的体积。
何时使用哪一种
- 当每个细节都必须精确时,使用无损。
- 当质量稍微下降也没关系、而且体积很重要时,使用有损。
English
Lossless:  text, code, a .zip file, a spreadsheet
Lossy:     photos (JPEG), music (MP3), video
核心思想
- 压缩用大小来换质量(或换还原它所需的工作)。
- 无损 = 更小且完美;有损 = 小得多但不精确。
- 优秀的工程师会为任务挑选合适的种类。
游程编码
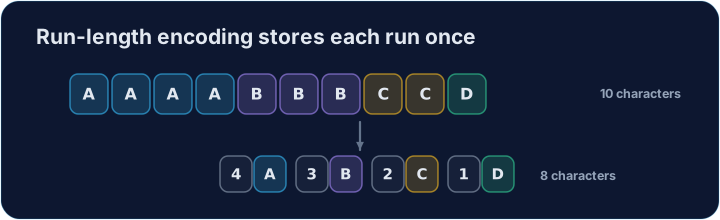
- 游程编码(run-length encoding, RLE)是一种简单的无损方法。
- 游程(run)是同一个字符连续重复的一段。RLE 用一个计数来代替这些重复。
- 我们将把每次运行存储为列表中的二元组
[character, count]。
English
"AAAB"                ->  [["A", 3], ["B", 1]]     (3 A's, then 1 B)
[["A", 3], ["B", 1]]  ->  "AAAB"                   (decode it back — exact again)
常见错误
- 无损压缩能精确还原;有损压缩会丢掉细节。
- 压缩得越多,质量可能越低。
现在轮到你
- 自己实现 RLE:一个编码器、一个解码器,再加一个求长度的辅助函数。
- 每个任务都会用多个输入检查你的函数。按检查答案。
探索
无损压缩
Run-length encoding replaces a run of repeats with count + symbol.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Write encode(text) for run-length encoding. Return a list of [character, count] pairs, one per run of repeats. Example: encode("AAAB") → [['A', 3], ['B', 1]]. For the empty string return [].
点击“运行”查看此处输出。
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Write decode(pairs) that reverses the encoder: given a list of [character, count] pairs, rebuild the original string. Example: decode([['A', 3], ['B', 1]]) → 'AAAB'. For [] 回报 ''.
点击“运行”查看此处输出。
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Without decoding, write original_length(pairs) that returns how many characters the original text had — just add up the counts. Example: original_length([['A', 3], ['B', 1]]) → 4.
点击“运行”查看此处输出。