Khóa học này là gì và cách sử dụng nó
Đây là khóa học thứ tám trong Khoa học Máy tính Đại học: cơ sở dữ liệu — cách mô hình hóa miền domain dưới dạng quan hệ, truy vấn chúng một cách chính xác, duy trì tính nhất quán dưới tải, và quản lý ai được xem gì.
Phạm vi giới hạn, nêu rõ một lần: một khóa học nghiên cứu, không phải bằng cấp; giáo trình dạy là cơ sở dữ liệu đăng ký đại học gốc, và mỗi truy vấn và kết quả trong tài liệu này đều được thực thi trên đó bởi bộ công cụ khóa học (SQLite, xác định).
- Các đơn vị 8.1–8.3 mô hình hóa và định hình dữ liệu: ER, đại số quan hệ và SQL, chuẩn hóa.
- Các đơn vị 8.4–8.5 giúp nó nhanh và an toàn: chỉ mục với kế hoạch truy vấn, giao dịch với tính đồng thời.
- Đơn vị 8.6 quản lý nó: bảo mật và quản trị dữ liệu.
Thói quen cơ sở dữ liệu: mọi tuyên bố về dữ liệu đều là một truy vấn bạn có thể chạy — các con số của mỗi đơn vị đều đến từ sơ đồ mẫu đã được tài liệu hóa.
Mô hình hóa quan hệ
Tại sao nó quan trọng. Mô hình quyết định mọi thứ ở phía sau: những gì có thể hỏi, những gì cần kiểm tra, những gì có thể đi sai. Một schema tốt là một tập hợp các câu đúng về lĩnh vực.
Ý tưởng, kèm hình ảnh. Một thực thể là một vật chúng ta đếm (một Sinh viên); một liên kết nối các thực thể (một Sinh viên đăng ký vào một Khóa học). Độ đa của mỗi đầu — một, nhiều — trở thành khóa và bảng: một liên kết nhiều-đến-nhiều trở thành bảng riêng của nó chứa các cặp khóa ngoại.
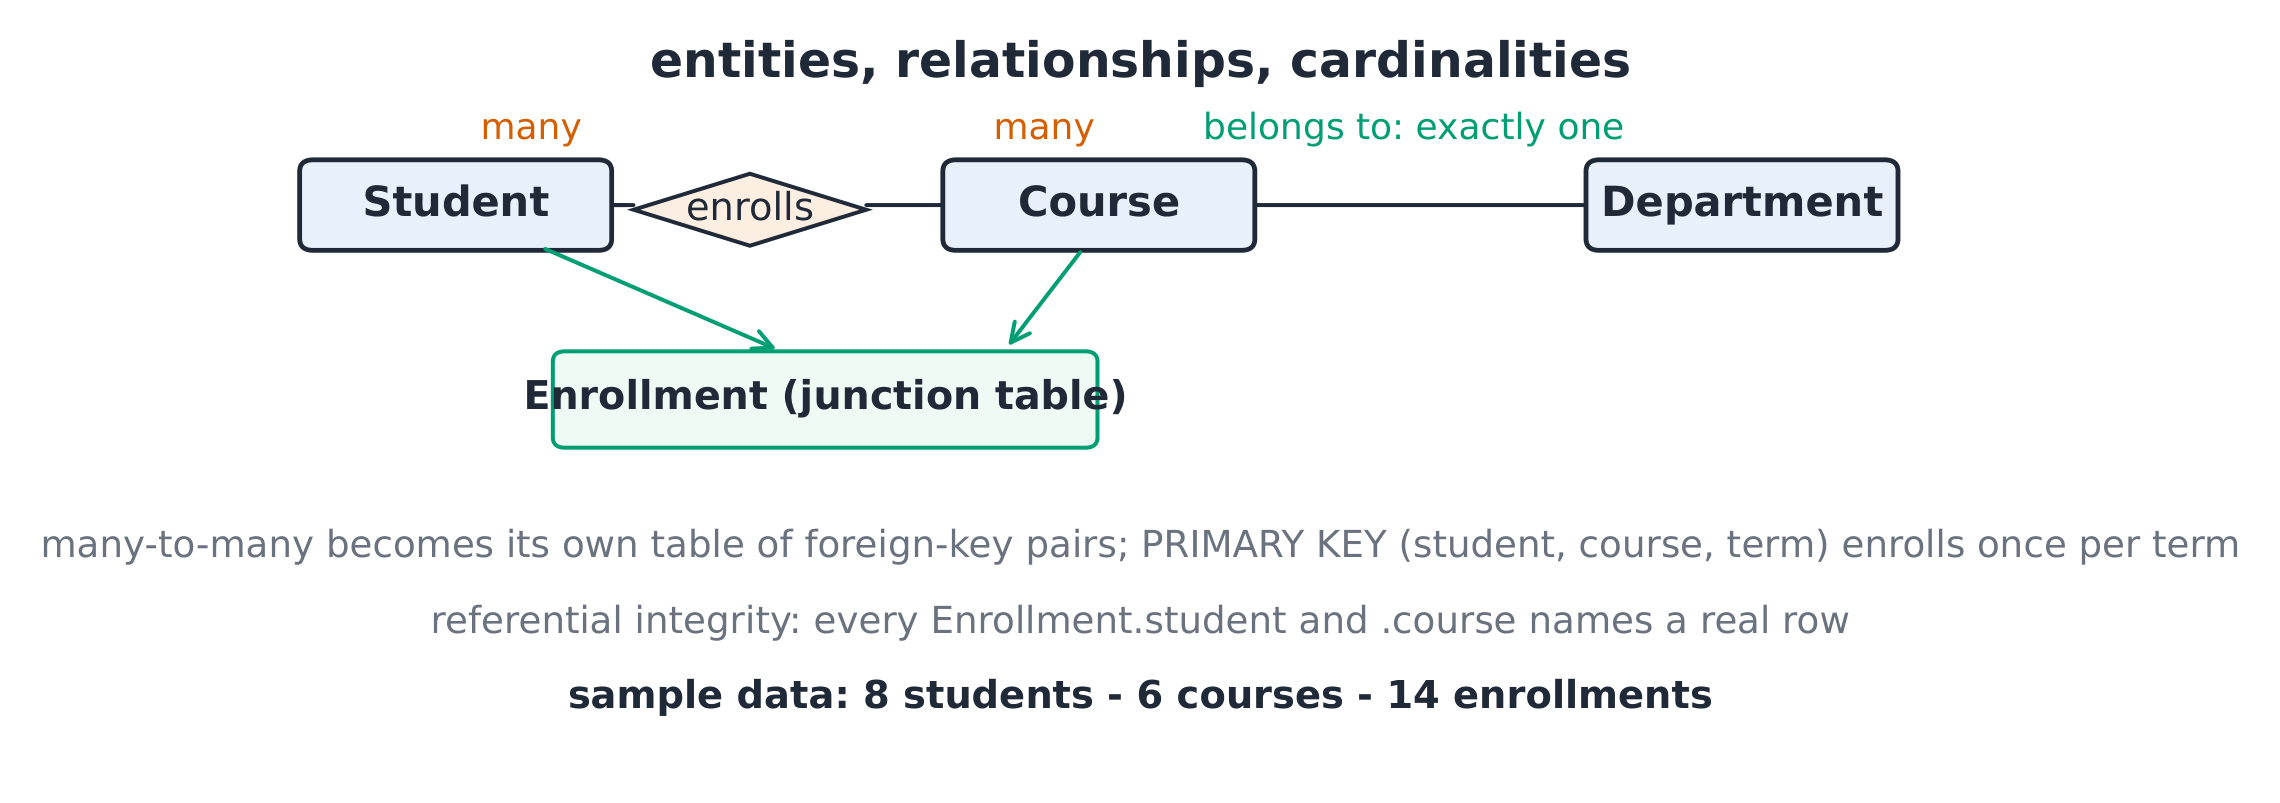
Sự suy diễn (tại sao khóa tồn tại). Một khóa chính xác định
một hàng duy nhất: student_id trong Bảng Sinh viên. Một khóa ngoại
tham chiếu đến nó: Enrollments.student_id phải chỉ đến một sinh viên thực —
cơ sở dữ liệu đảm bảo toàn vẹn tham chiếu, nên không
bản đăng ký nào có thể bị mất kết nối. Sơ đồ dạy học của chúng tôi:
Department(dept_id PK, name, building)
Student(student_id PK, name, dept_id FK)
Course(course_id PK, title, dept_id FK, credits)
Enrollment(student_id FK, course_id FK, term, grade,
           PRIMARY KEY (student_id, course_id, term))
Ví dụ minh họa 1 — mô hình hóa quy tắc. Một sinh viên có thể đăng ký
một khóa học tối đa một lần mỗi học kỳ. Quy tắc nằm ở khóa: Đăng ký
mang PRIMARY KEY (student_id, course_id, term) — việc chèn thêm
cùng một bộ ba sẽ bị từ chối bởi động cơ, chứ không phải ứng dụng.
Quy tắc trong sơ đồ là những quy tắc mà cơ sở dữ liệu giữ.
Ví dụ minh họa 2 — đường nối (join path). Những sinh viên nào đang học
các khóa thuộc khoa? Bảng Sinh viên nối với Bảng Đăng ký theo student_id,
Bảng Đăng ký nối với Bảng Khóa học theo course_id, Bảng Khóa học nối với Bảng Khoa theo
dept_id: ba phép nối, mỗi phép đều đi theo khóa ngoại. Bộ dữ liệu mẫu
dữ liệu mẫu: 8 sinh viên, 6 môn học, 14 đăng ký — đường nối
trả về 14 hàng trước khi lọc.
Lỗi thường gặp. Lưu tên sinh viên bên trong Bảng Đăng ký (tạo trùng lặp, cần cập nhật ở nhiều nơi). Mỗi mối quan hệ dùng một bảng riêng thay vì bảng trung gian cho quan hệ nhiều-nhiều. Chọn khóa có thể thay đổi (email di chuyển; ID giả không). thay đổi (email di chuyển; ID giả không thay đổi).
Tóm tắt. Thực thể thành bảng, quan hệ thành khóa ngoại hoặc bảng liên kết; tính đa một quyết định loại nào; khóa mang theo các quy tắc mà động cơ sau đó thực thi.
Đại số quan hệ và SQL
Tầm quan trọng. SQL là ngôn ngữ chuẩn của ngành công nghiệp, và trái tim nó gồm năm toán tử đại số với ngữ nghĩa chính xác — hãy thuộc đại số và mọi truy vấn đều có thể đọc được như một đường ống.
Ý tưởng, kèm hình ảnh. Đại số: lựa chọn σ giữ lại hàng ($\sigma_{\text{credits} = 15}$), phản chiếu π giữ lại cột ($\pi_{\text{name}}$), liên kết ⋈ kết hợp dựa trên điều kiện, tập hợp ∪ và hiệu tập hợp − kết hợp bảng. Mọi lệnh SELECT đều là năm việc này trong một đường ống.
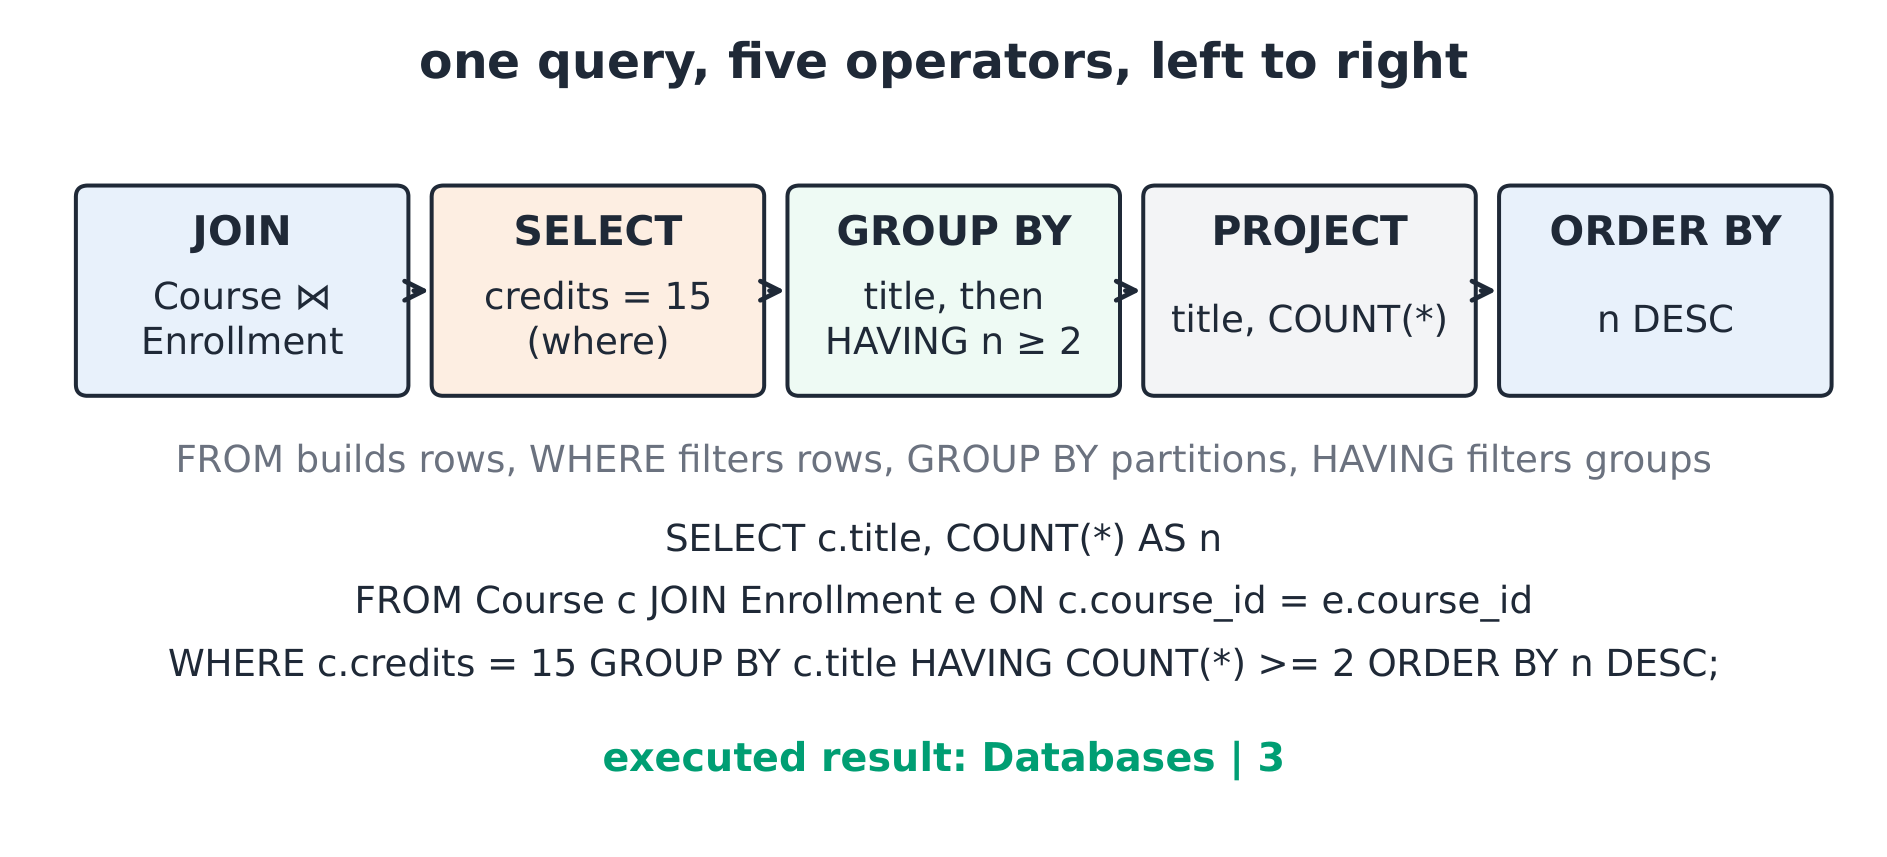
Quy trình suy diễn (WHERE trước GROUP BY trước HAVING). SQL's
các mệnh lệnh chạy theo thứ tự cố định: FROM xây dựng tập hàng, WHERE lọc
hàng, GROUP BY phân chia chúng, HAVING lọc nhóm, SELECT
phản chiếu, ORDER BY sắp xếp. Vậy WHERE grade = 'A' giữ lại hàng rồi
nhóm; HAVING COUNT(*) >= 2 chỉ giữ lại nhóm — lọc trên một
tổng hợp trong WHERE là lỗi phân loại mà động cơ từ chối.
Ví dụ minh họa 1 — một truy vấn, đọc dưới dạng đại số.
SELECT c.title, COUNT(*) AS n
FROM Course c JOIN Enrollment e ON c.course_id = e.course_id
WHERE c.credits = 15
GROUP BY c.title
HAVING COUNT(*) >= 2
ORDER BY n DESC;
Đại số: liên kết Course và Enrollment, chọn credits = 15, nhóm theo
Tiêu đề, giữ nhóm có kích thước $\ge 2$, tiêu đề dự án kèm số lượng. Trên
dữ liệu mẫu, kết quả là Databases | 3 — một môn học 15 tín chỉ
với ba lần đăng ký (bộ ghi chính xác đầu ra).
Ví dụ minh họa 2 — các ô trống được giữ lại trong phép nối ngoài. Liệt kê tất cả
môn học kèm theo các lần đăng ký: phép nối thông thường loại bỏ các 2 môn học không có
lần đăng ký; LEFT JOIN giữ lại chúng với số lượng NULL — 6 dòng, 2 có
n = 0 (SQLite chỉ đếm COUNT(e.student_id) giá trị hiện diện).
Kiểu nối là quyết định về ngữ nghĩa, không phải vấn đề phong cách.
Lỗi thường gặp. Lọc tập hợp trong WHERE (sử dụng HAVING).
Đếm dòng khi bạn muốn đếm giá trị (COUNT(*) so với COUNT(col) —
loại sau bỏ qua các giá trị NULL). Quên DISTINCT khi chiếu một
cột nhiều bên (14 dòng đăng ký chiếu 14 ID sinh viên, một số
bị lặp lại).
Tóm tắt. Năm toán tử, một đường ống; thứ tự mệnh đề mang tính ngữ nghĩa (WHERE lọc dòng, HAVING lọc nhóm); kiểu nối quyết định ai tồn tại sau khi khớp.
Chuẩn hóa
Tại sao điều này quan trọng. Bảng phi chuẩn hóa gợi mở ba bất thường: thêm, cập nhật, xóa — chuẩn hóa loại bỏ chúng bằng cách tách ra dựa trên sự phụ thuộc.
Ý tưởng, kèm hình ảnh. Một phụ thuộc hàm $A \to B$: mỗi giá trị A xác định một giá trị B. Chuẩn thứ hai yêu cầu chuẩn thứ nhất và không có thuộc tính không khóa phụ thuộc vào chỉ một phần của khóa ứng viên. Trong chuẩn thứ ba , mọi sự phụ thuộc phi tầm thường đều có bộ xác định là siêu khóa hoặc thuộc tính vế phải thuộc về một khóa ứng viên. Boyce–Codd BC yêu cầu bộ xác định là siêu khóa cho mọi sự phụ thuộc phi tầm thường.
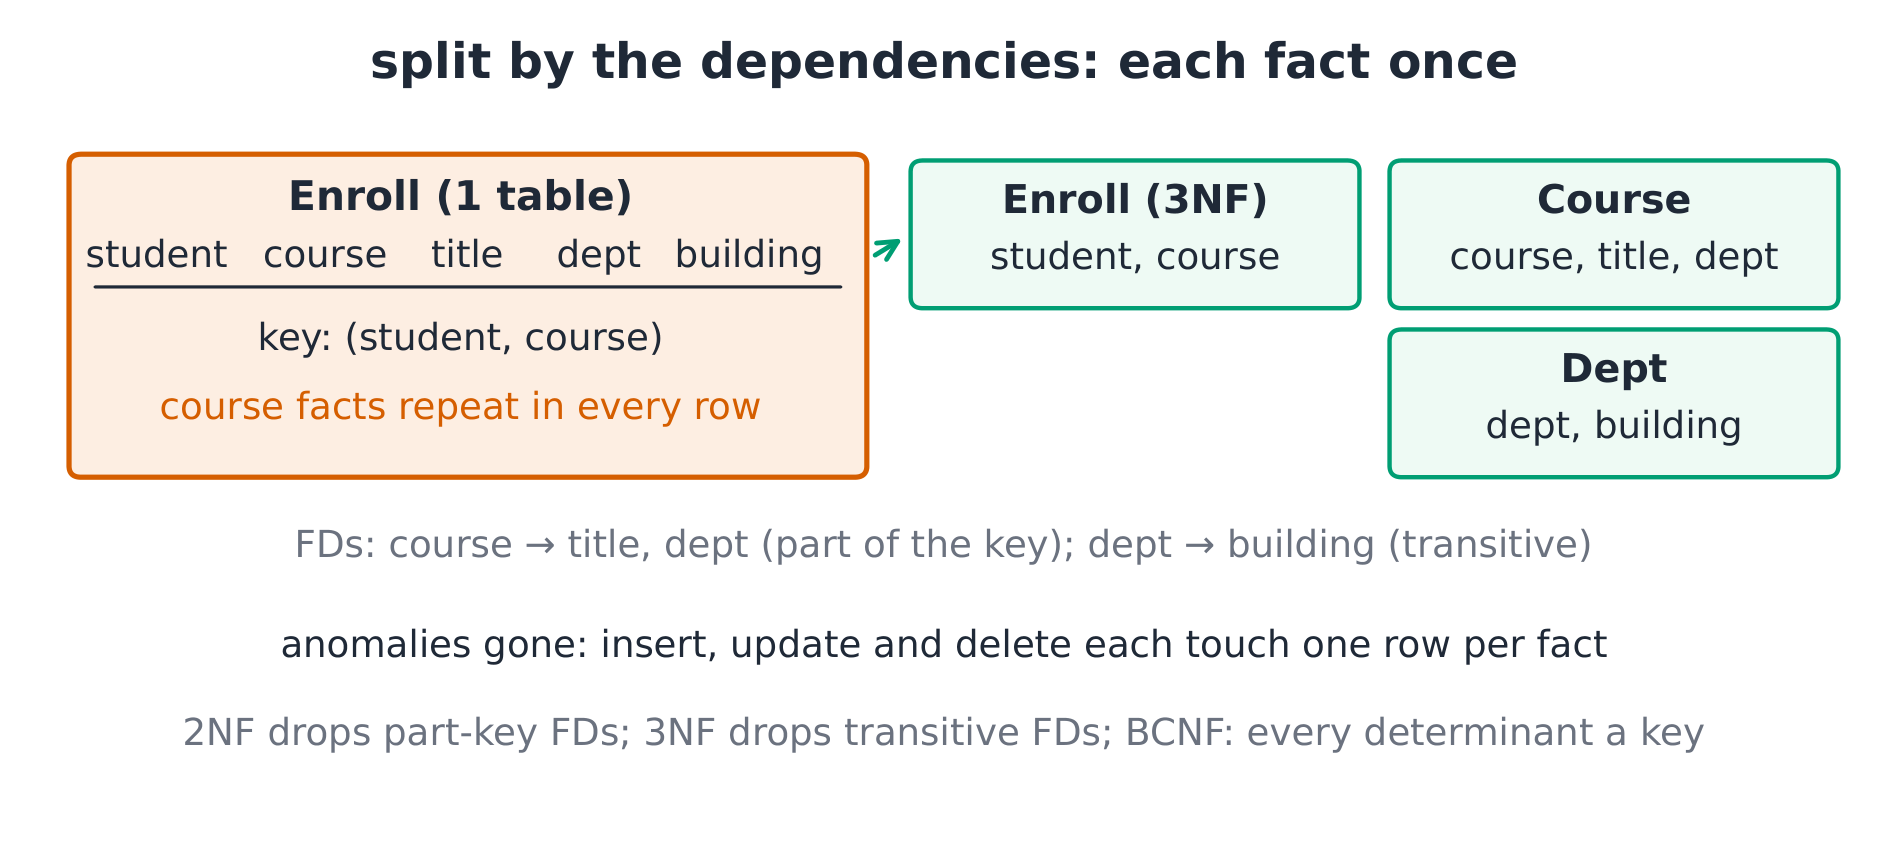
Sự suy diễn (tại sao 3NF loại bỏ các bất thường). Bảng chưa chuẩn hóa
Enroll(student, course, title, dept, building) với khóa
(sinh viên, môn học) chứa: course → title (phần khóa), title → dept → building (truyền dẫn). Bất thường cập nhật: tên một môn học xuất hiện trong
mọi hàng đăng ký — sửa một dòng, sẽ bỏ sót mười dòng. Tách theo các
sự phụ thuộc: Course(course, title, dept) và
Dept(dept, building) và Enroll(student, course): điều này loại bỏ
sự phụ thuộc phần khóa khỏi Đăng ký. Vì title → dept vẫn
đúng, Môn học chưa ở trong 3NF. Tách nó thêm thành
Course(course, title) và Title(title, dept). Với các sự phụ thuộc đã nêu,
bốn bảng thu được đều ở trong BCNF.
Ví dụ minh họa 1 — đánh giá dạng chuẩn. Room(building, room, capacity, projector_type) với khóa (tòa nhà, phòng): nếu tất cả các phòng trong
một tòa nhà chia sẻ một loại máy chiếu, FD tòa nhà → projector_type vi phạm 2NF và do đó 3NF: một thuộc tính không khóa
chỉ phụ thuộc vào một phần của khóa ứng viên. Chia nhỏ thành
Building(building, projector_type) và Room(building, room, capacity).
Điều này loại bỏ dữ liệu máy chiếu bị trùng lặp.
Ví dụ minh họa 2 — khi nào thì dừng. Một bảng báo cáo kho lưu trữ
order_line cộng với tổng lũy kế theo từng đơn hàng: tổng này có thể suy ra được,
nhưng việc tính toán lại cho mỗi bản xem trước tốn kém hơn so với rủi ro bất thường khi lưu trữ
nó — giảm chuẩn hóa có kiểm soát với bộ kích hoạt cập nhật là một lựa chọn kỹ thuật hợp lệ sau khi đã hiểu về các dạng chuẩn hóa. Chuẩn hóa vì lý do chính đáng; giảm chuẩn hóa dựa trên bằng chứng thực tế.
lựa chọn kỹ thuật khi đã hiểu chuẩn hóa. Chuẩn hóa vì
lý do; phi chuẩn hóa dựa trên bằng chứng.
Lỗi thường gặp. Gọi một bảng là 3NF trong khi một cột không khóa vẫn quy định một cột khác. Chia nhỏ quá mức đến mức mỗi truy vấn phải nối năm bảng mà chưa đo lường chi phí. Unforgotten that anomalies are triệu chứng — bệnh lý thực sự là dữ liệu bị trùng lặp.
Tóm tắt. FDs thúc đẩy việc phân tách: phần khóa ra ngoài để đạt 2NF, phụ thuộc truyền dẫn ra ngoài cho 3NF trong các ví dụ đơn giản có một khóa; đối với BCNF, mọi phụ thuộc phi tầm thường đều có bộ xác định là siêu khóa. Nêu rõ các phụ thuộc trước khi đánh giá việc phân rã. đánh giá sự phân tách.
Chỉ mục và kế hoạch truy vấn
Tại sao nó quan trọng. Một truy vấn quét một triệu dòng để tìm mười dòng một lỗi thiết kế, và cách khắc phục không phải là thêm phần cứng — mà là một chỉ mục người lập kế hoạch có thể sử dụng.
Ý tưởng, kèm hình ảnh. Một cây B B index giữ các khóa được sắp xếp trong cây đa phân cân bằng: cây giảng dạy của chúng ta (thứ tự 4, 15 khóa) tìm bất kỳ khóa nào trong $\lceil \log_4 15 \rceil = 2$ lần đọc nút so với 15 tuần tự. Kế hoạch truy vấn là ? đường ống được chọn: quét hoặc chỉ mục, thứ tự nối, chiến lược.
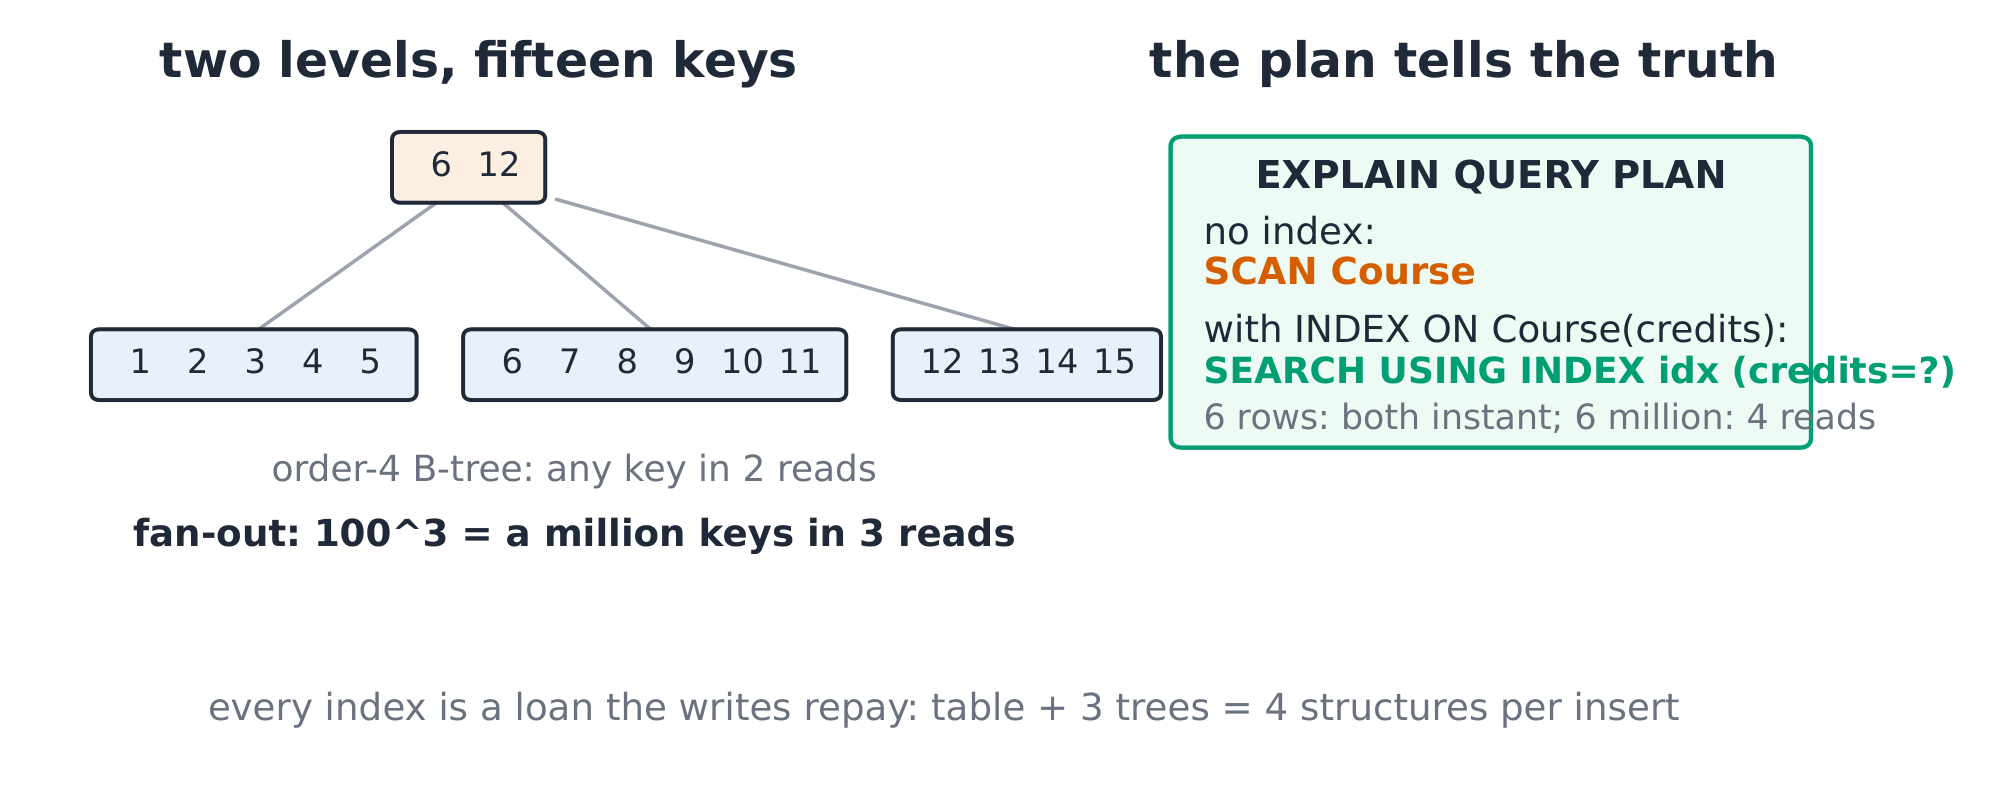
Sự suy diễn (toán học độ mở). Một node chứa $k$ khóa phân phối giữa $k + 1$ con: thứ tự $m$ tạo ra độ mở $\approx m$. Chiều cao $h$ bao phủ $m^h$ mục: độ mở 100, ba cấp bao phủ $100^3 = 10^6$ khóa — tra cứu một triệu hàng trong 3 node đọc. Mọi lệnh chèn đều giữ cho cây cân bằng (phân tách lan truyền lên trên), nên giới hạn áp dụng cho mọi khóa, không chỉ những khóa may mắn.
Ví dụ đã giải quyết 1 — một kế hoạch, đọc. EXPLAIN QUERY PLAN SELECT title FROM Course WHERE credits = 20: không có chỉ mục, kế hoạch đọc
SCAN Course; với CREATE INDEX idx ON Course(credits) nó đọc
SEARCH Course USING INDEX idx (credits=?). Trên 6 hàng cả hai đều
ngay lập tức; trên 6 triệu, quét đọc 6 triệu hàng và tìm kiếm
đọc 4 (độ mở 100 bao phủ $10^6$ khóa ở chiều cao 3 — sáu triệu
cần chiều cao 4) — kế hoạch, không phải câu truy vấn, định giá công việc.
Ví dụ minh họa 2 — ghi thuế. Mỗi chỉ mục thêm công việc vào mọi thêm và xóa: sơ đồ của chúng tôi với 3 chỉ mục ghi 4 cấu trúc mỗi lần thêm (bảng + 3 cây). Bảng nhật ký có 5 chỉ mục và 10 triệu lần thêm mỗi ngày duy trì 50 triệu mục chỉ mục hàng ngày — chỉ mục gì bạn truy vấn, bỏ cái bạn không dùng, và đo lường.
Lỗi thường gặp. Chỉ mục hóa mọi cột (ghi trả tiền cho đọc mà bạn
không bao giờ thực hiện). Kỳ vọng bộ lên kế hoạch sử dụng chỉ mục trên một cột
tính toán (WHERE UPPER(name) = … làm vô hiệu hóa chỉ mục thông thường). Đọc
câu truy vấn thay vì kế hoạch.
Tóm tắt. Cây B đổi lấy độ rộng bằng chiều cao: $m^h$ khóa trong $h$ lần đọc; kế hoạch nói lên sự thật; mỗi chỉ mục là khoản vay mà các lần ghi phải hoàn lại.
Giao dịch và đồng thời
Tại sao quan trọng. Hai nhân viên, một số dư, cập nhật đồng thời: không có giao dịch, cơ sở dữ liệu có thể cam kết cả hai phần của các chuyển tiền khác nhau và mất tiền một cách âm thầm.
Khái niệm, kèm hình ảnh. Một giao dịch là toàn bộ hoặc không gì: ACID — nguyên tử, nhất quán, tách biệt, bền vững. Dưới tính tuần tự hóa kết quả xen kẽ bằng với một thứ tự tuần tự nào đó; yếu hơn các mức cô lập đánh đổi tính chính xác để lấy song hành: đọc chưa cam kết, đọc đã cam kết, đọc lặp lại, có thể tuần tự hóa.
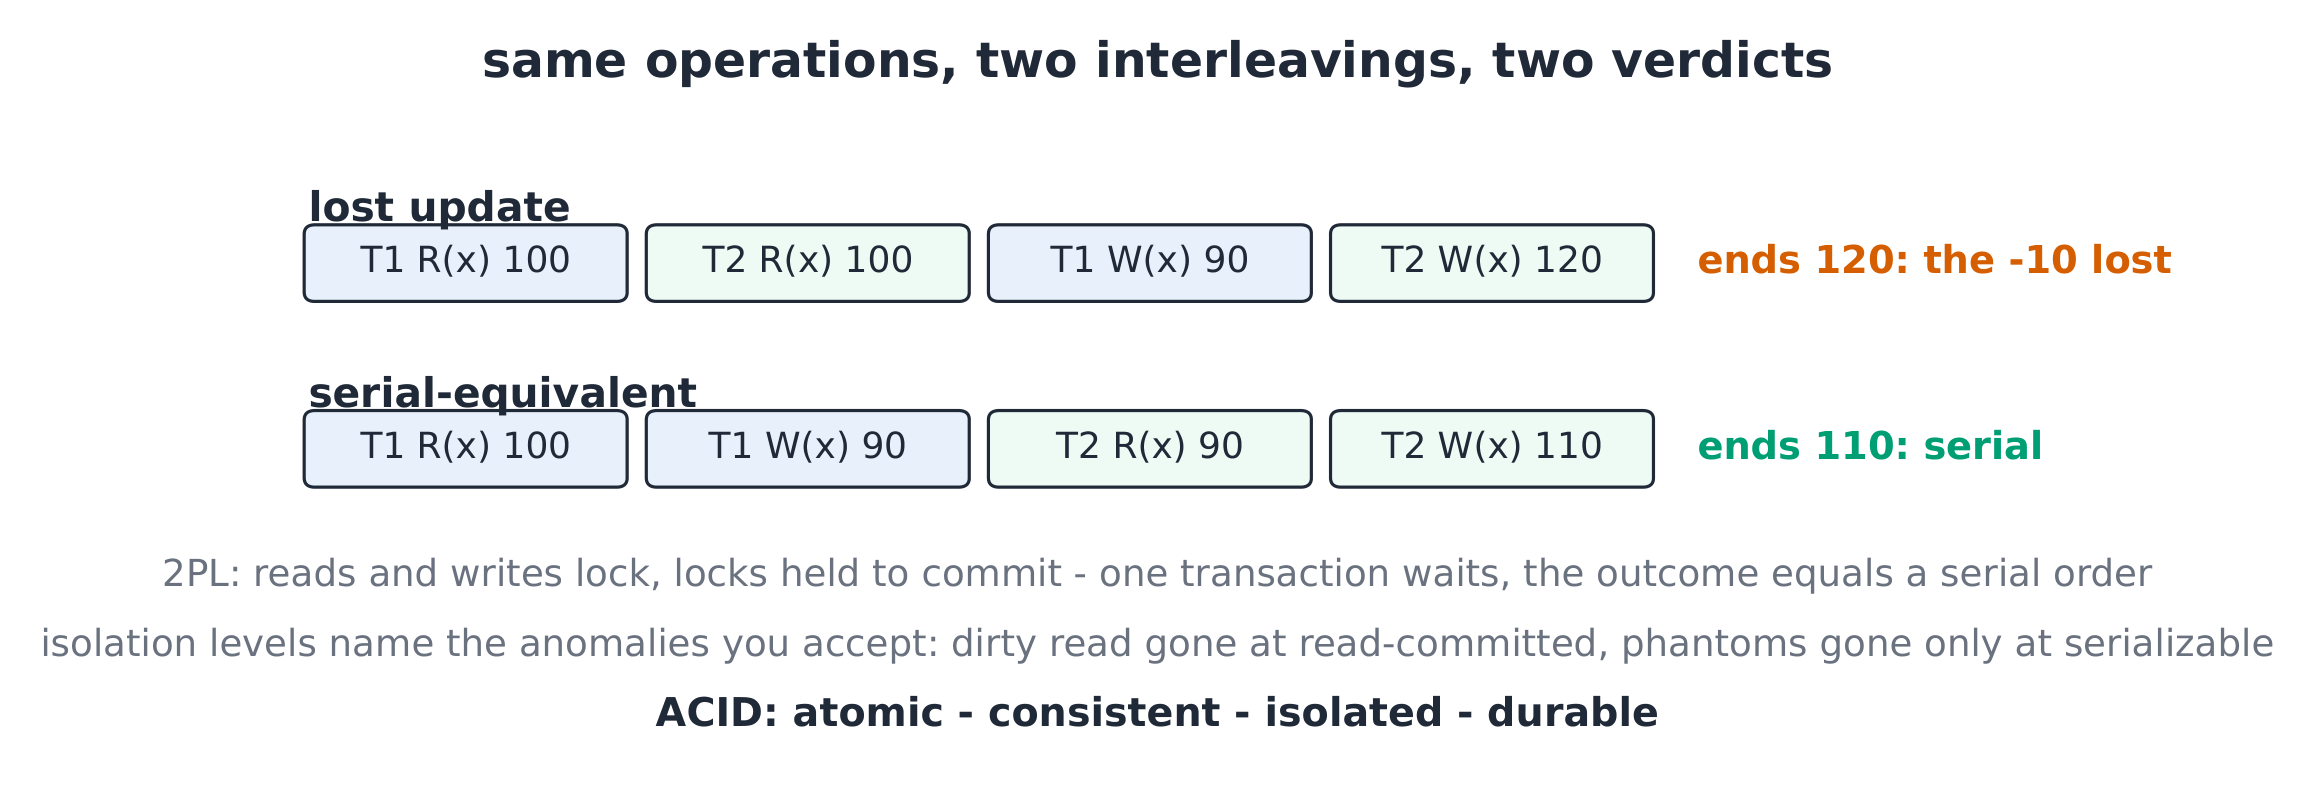
Sự suy diễn (lỗi mất cập nhật, lần nữa). T1 đọc số dư 100, T2 đọc 100, T1 ghi 90, T2 ghi 120: khoản rút 10-đơn vị đã biến mất — trường hợp ngân hàng của cuộc đua đơn vị 7.3. Khóa hai pha (2PL) đầu tiên thu được khóa, sau đó giải phóng chúng; sau lần giải phóng đầu tiên, không thể thu được khóa mới. Điều này đảm bảo tính tuần tự hóa xung đột cho các giao dịch tuân theo giao thức. Khóa hai pha 2PL mạnh mẽ thêm giữ tất cả khóa cho đến khi cam kết hoặc hủy bỏ. Các giao dịch có thể gây deadlock; trình phát hiện có thể hủy một giao dịch để nó có thể thử lại.
Ví dụ minh họa 1 — tính hợp lệ của lịch. Xen lẫn
R1(A) R2(A) W2(A) W1(A): Ghi của T1 ghi đè lên T2 — lỗi mất cập nhật,
không thể tuần tự hóa. Xen lẫn R1(A) W1(A) R2(A) W2(A): bằng với
tương đương tuần tự T1-sau-T2 — hợp lệ. Bộ công cụ kiểm tra cả hai lịch bằng
mô phỏng.
Ví dụ minh họa 2 — đọc dữ liệu bẩn. Ở chế độ đọc chưa cam kết, T2 đọc 90 chưa cam kết của T1; sau đó T1 hoàn tác — T2 đã tác động trên giá trị chưa từng tồn tại. Đọc đã cam kết ngăn chặn điều này (chỉ đọc những gì dữ liệu cam kết; repeatable-read thêm tính ổn định của việc đọc lại; serializable loại bỏ hiện tượng ma. Mỗi mức độ là một lời hứa về những bất thường nào vẫn còn tồn tại.
Lỗi thường gặp. Giao dịch dài giữ khóa xuyên qua đầu vào của người dùng (mồi nhử deadlock). Đồng nhất hóa isolation với consistency (C là ràng buộc; I là sự xen kẽ). Bỏ qua vòng lặp thử lại vì deadlock "th hiếm" xảy ra (nó xảy ra ở giờ cao điểm).
Tóm tắt. ACID: tất cả hoặc không có gì, ràng buộc được bảo toàn, xen kẽ tương đương với thứ tự tuần tự, các giao dịch cam kết sống sót sau lỗi sập; các mức độ isolation đặt tên cho những bất thường bạn chấp nhận; 2PL mua tính serializability với giá phải chờ đợi.
Bảo mật và quản trị dữ liệu
Tại sao nó quan trọng. Cơ sở dữ liệu chứa đựng những gì mà con người không thể afford để rò rỉ: các vụ rò rỉ trong thập kỷ qua là thất bại về mô hình truy cập, không phải về mã hóa.
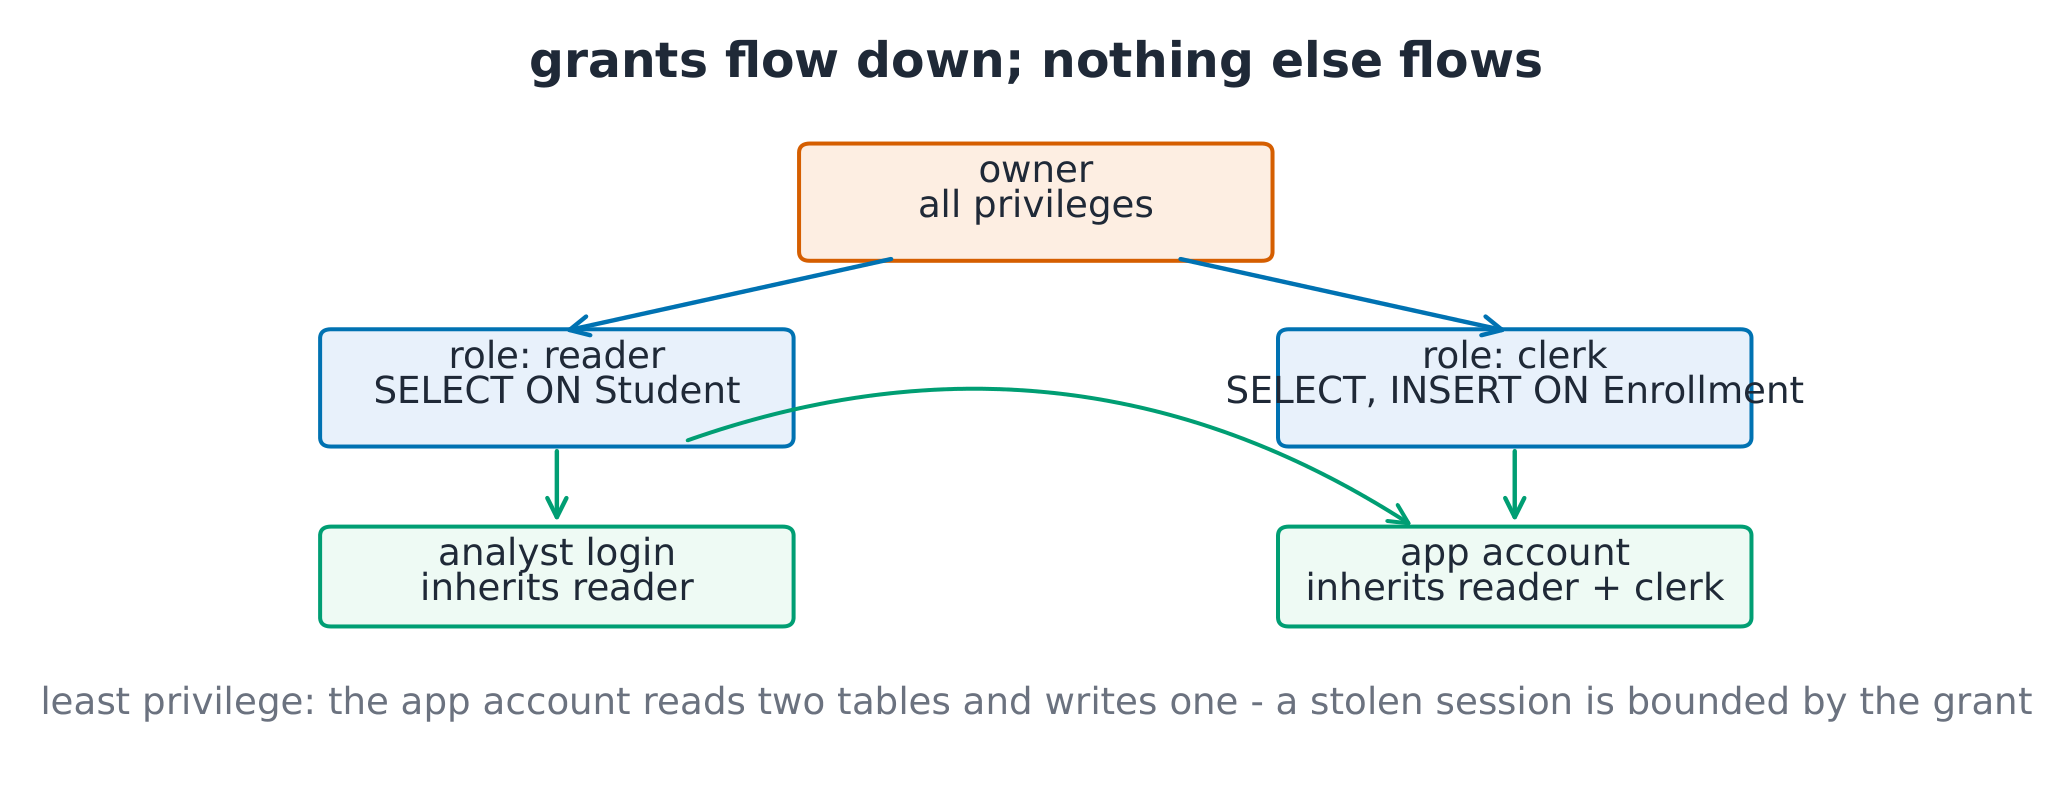
Khái niệm, kèm hình ảnh. Xác thực chứng minh ai bạn là; phân quyền chứng minh những gì bạn có thể làm; nguyên tắc đặc quyền tối thiểu định hình cả hai: tài khoản nhận được sự cấp quyền hẹp nhất cho phép công việc chạy.
Sự suy diễn (phép nhúng, và điểm kết thúc). Một truy vấn được xây dựng bằng cách
ghép nối văn bản người dùng: "... WHERE name = '" + input + "'" với đầu vào
' OR '1'='1 khớp với mọi hàng — và các đầu vào xấu hơn có thể xóa bảng.
Các câu lệnh tham số hóa gán giá trị riêng biệt với cú pháp SQL
nên văn bản trong một giá trị được gán không thể thay đổi cấu trúc truy vấn.
Tên bảng, tên cột và các SQL động khác cần các điều khiển riêng;
gán tham số không bảo vệ SQL vẫn được xây dựng bằng cách ghép nối.
Ví dụ minh họa 1 — các quyền phù hợp. Các khoản tài trợ giảng dạy:
GRANT SELECT ON Student TO reader; GRANT SELECT, INSERT ON Enrollment TO clerk; — tài khoản nhân viên hành chính không thể đọc lương mà
họ không được phép xem, không thể XÓA một lần đăng ký, và phiên làm việc bị đánh cắp của nhân viên hành chính
bị giới hạn bởi quyền cấp. Thu hồi khi thay đổi vai trò, không phải ngày kiểm toán.
Ví dụ minh họa 2 — quản trị là một vòng lặp. Quản trị dữ liệu
phân loại dữ liệu (công khai, nội bộ, nhạy cảm), chỉ định
chủ sở hữu, thiết lập thời gian lưu giữ, và kiểm tra truy cập: cột nhạy cảm grade
được mã hóa khi lưu trữ, truy cập của nó được ghi nhật ký, và cuộc xem xét hàng
quý sẽ thu hồi các quyền cấp đã lỗi thời. Mô hình tồn tại khi tiếp xúc với
thực tế chỉ vì vòng lặp này hoạt động.
Lỗi thường gặp. Kết nối ứng dụng dưới tài khoản chủ sở hữu (mọi lỗi sẽ chạy với toàn bộ quyền hạn). Kiểm toán đọc nhưng không thu hồi quyền cấp (tăng quyền hạn). Coi mã hóa là kiểm soát truy cập (nó bảo vệ dữ liệu khi lưu trữ, không phải chống lại đăng nhập hợp lệ).
Tóm tắt. Xác thực, sau đó cấp quyền theo nguyên tắc tối thiểu; tham số hóa mọi truy vấn; phân loại, sở hữu, lưu giữ, kiểm toán — quản trị là vòng lặp duy trì tính đúng đắn của mô hình.