Algorithmic efficiency
สิ่งที่เราจะทำ
- โปรแกรมสองตัวอาจถูกต้องทั้งคู่แต่ใช้เวลา ต่างกันมาก
- บทเรียนนี้เกี่ยวกับ ประสิทธิภาพ: การทำงานเพิ่มขึ้นอย่างไรเมื่ออินพุตเพิ่มขึ้น
- Read and think about the ideas; then a few short tasks let you count the steps yourself.
นับการทำงาน
- เราวัดอัลกอริทึมโดย จำนวนขั้นตอน ที่ทำได้ ไม่ใช่วินาที
- ขั้นตอนเป็นวินาทีขึ้นอยู่กับคอมพิวเตอร์; การนับขั้นตอนไม่
- อินพุตมากขึ้นมักหมายถึงขั้นตอนมากขึ้น คำถามคือ เพิ่มเท่าไหร่
เวลาทำงานที่ยอมรับได้ vs ไม่ยอมรับได้
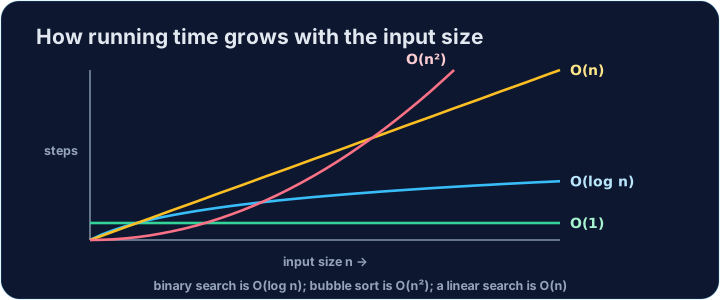
- เวลาที่ สมเหตุสมผล หมายความว่าจำนวนขั้นตอนเพิ่มขึ้นตามฟังก์ชันพหุนาม หรือช้ากว่านั้น: คงที่, เส้นตรง, สี่เหลี่ยมหรือลูกบาศก์
- ลูปเดียวเป็นเส้นตรง (linear) ลูปซ้อนลูปเป็นสี่เหลี่ยม (n × n) สี่เหลี่ยมเติบโตเร็วกว่าเส้นตรงแต่ยังถือเป็นเวลาสมเหตุสมผล
- เวลาที่ ไม่สมเหตุสมผล หมายความว่ามีการเติบโตแบบเอกซ์โพเนนเชียลหรือแฟกทอเรียล ข้อมูลเพิ่มเพียงเล็กน้อยทำให้ปริมาณงานพุ่งสูงขึ้นอย่างมหาศาล
Input size:      10          20          40
Search a list:   10          20          40          (linear - reasonable)
Nested loops:    100         400         1,600       (square - still reasonable)
Try all orders:  3,628,800   ...         48 digits   (factorial - unreasonable)
ตัวอย่างจำลอง: นับขั้นตอน
- ด้านล่างเรานับจำนวนการเปรียบเทียบที่การค้นหาเชิงเส้นทำ
- จำนวนเพิ่มขึ้นตาม ขนาดรายการ - เติบโตช้าและสม่ำเสมอ
- ลองเปลี่ยนขนาดเพื่อดูจำนวนที่ติดตามมัน
def count_steps(n):
    steps = 0
    data = list(range(n))
    target = -1            # not in the list, so we scan everything
    for item in data:
        steps = steps + 1
        if item == target:
            break
    return steps

print(count_steps(10))
print(count_steps(20))
print(count_steps(40))
เมื่อความเร็วไม่เพียงพอ
- ปัญหาบางประเภทไม่มีอัลกอริทึมใดที่มีเวลาสมเหตุสมผล
- วิธีที่แม่นยำอาจลองทุกความเป็นไปได้ นั่นคือการเติบโตแบบแฟกทอเรียล จึงไม่สมเหตุสมผลสำหรับข้อมูลขนาดใหญ่
- heuristics คือทางลัดที่อาจให้คำตอบที่พอใช้ได้ ไม่รับประกันว่าจะเป็นคำตอบที่ดีที่สุด ไม่ต้องจำ heuristic เฉพาะตัวใดตัวหนึ่ง
ปัญหาที่พิสูจน์ไม่ได้
- Worse than slow: Some problems cannot be solved by any algorithm at all.
- เหล่านี้เรียกว่า ปัญหาที่พิสูจน์ไม่ได้
- ไม่ว่าคอมพิวเตอร์จะเร็วแค่ไหน ก็ไม่มีโปรแกรมใดให้คำตอบที่ถูกต้องเสมอไป
Reasonable   : constant, linear, square or cube growth
Unreasonable : exponential or factorial growth
Undecidable  : no algorithm can solve it for every input
แนวคิดสำคัญที่ต้องจำ
- ประสิทธิภาพเกี่ยวข้องกับอัตราการเติบโตของจำนวนขั้นตอนเมื่อขนาดข้อมูลเพิ่มขึ้น ไม่ใช่จำนวนวินาทีที่คอมพิวเตอร์เครื่องหนึ่งใช้เวลา
- การเติบโตแบบพหุนามหรือต่ำกว่าคือเวลาสมเหตุสมผล ลูปซ้อน (n × n) ก็ยังถือได้ว่าสมเหตุสมผล
- การเติบโตแบบเอกซ์โพเนนเชียลหรือแฟกทอเรียลไม่สมเหตุสมผล บางปัญหายังเป็นปัญหาที่ยังหาคำตอบไม่ได้ด้วย
ข้อผิดพลาดที่พบบ่อย
- การเรียกการวนซ้ำซ้อนกันว่าไม่สมเหตุสมผล การเติบโตแบบกำลังสองและกำลังสามยังคงเป็นเวลาที่ยอมรับได้
- การใช้สัญลักษณ์ Big-O แบบเป็นทางการเป็นกฎในการสอบ Big-O ไม่ถูกทดสอบ เส้นกราฟคือพหุนามหรือต่ำกว่า เมื่อเทียบกับเลขยกกำลังหรือแฟกทอเรียล
ลองดูเลย
- เขียนฟังก์ชันเล็กๆ ที่ นับขั้นตอน เพื่อรู้สึก how the work grows
- เปรียบเทียบการวนซ้ำเดี่ยว การวนซ้ำซ้อน และ "ลองทุกความเป็นไปได้" การวนซ้ำซ้อนยังคงใช้เวลาที่ยอมรับได้ กด ตรวจสอบคำตอบ
Algorithm Scaling
การเติบโตแบบกำลังสองเพิ่มขึ้นเร็วกว่าเส้นตรง และเป็นเวลาที่ยังสมเหตุสมผล ส่วนการเติบโตแบบแฟกทอเรียลนั้นไม่สมเหตุสมผล
ความยาก 3/5 · 200 เหรียญ + บอนัสน้อยๆ เมื่อทำสำเร็จครั้งแรกในวันนี้
เขียน scan_compares(data, target) ที่คืนค่าจำนวนการเปรียบเทียบของ linear search เปรียบเทียบแต่ละรายการกับ target นับหนึ่งทุกครั้งที่ compares และ หยุดทันทีที่พบ หากไม่อยู่ในรายการ คุณ compared ทุกรายการ ตัวอย่าง: scan_compares([5, 8, 2], 8) → 2
คลิก Run เพื่อดูผลลัพธ์ที่นี่
ความยาก 3/5 · 200 เหรียญ + บอนัสน้อยๆ เมื่อทำสำเร็จครั้งแรกในวันนี้
เขียน pair_count(n) ที่ใช้ลูป ภายใน ลูป (ทั้งสองวนรอบ range(n)) และคืนค่าจำนวนครั้งที่ inner step ทำงาน นี่คือ n × n ตัวอย่าง: pair_count(3) → 9 grows เร็วกว่าลูปเดี่ยว
คลิก Run เพื่อดูผลลัพธ์ที่นี่
ความยาก 3/5 · 200 เหรียญ + บอนัสน้อยๆ เมื่อทำสำเร็จครั้งแรกในวันนี้
เขียน count_orderings(n) ที่คืนค่าจำนวนวิธีจัดเรียงที่แตกต่างกันของ n รายการ นั่นคือ 1 × 2 × ... × n (n factorial) count_orderings(0) คือ 1 ตัวอย่าง: count_orderings(3) → 6 Notice how fast it explodes: count_orderings(10) เกิน 3 ล้าน
คลิก Run เพื่อดูผลลัพธ์ที่นี่