Machine learning types and training
Introduzido| English | Significado |
|---|---|
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | Aprendizado de máquina |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | propagação reversa |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | aprendizado supervisionado |
| classification/ˌklæsɪfɪˈkeɪʃn/ | classificação |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | aprendizado não supervisionado |
| clusters/ˈklʌstəz/ | agrupamentos |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | aprendizado por reforço |
| agent/ˈeɪdʒənt/ | agente |
| reward/rɪˈwɔːd/ | recompensa |
| policy/ˈpɒlɪsi/ | política |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | descida do gradiente |
| loss function/lɒs ˈfʌŋkʃn/ | função de perda |
| epoch/ˈiːpɒk/ | época |
O programa que se ensinou uma abertura que nenhum humano jogou
- AlphaGo Zero recebeu as regras do Go e nada mais. Sem jogos humanos, sem livro de aberturas, sem conselhos. Jogou contra si mesmo, começando com movimentos aleatórios.
- Em três dias superou a versão que havia batido o campeão mundial. Ao longo do caminho redescobriu séculos de teoria de aberturas humanas e depois descartou partes dela como inferiores.
- Aprendeu a partir de um único número após cada jogo: venceu ou perdeu. Isso é um tipo completamente diferente de aprendizado do que ser mostrado um milhão de fotos rotuladas.
- Esta lição são os três paradigmas de machine learning, que dados cada um precisa e como os pesos de uma rede são realmente alterados por backpropagation 反向传播.
Aprendizado supervisionado
- Aprendizado supervisionado 监督学习 treina com dados que carregam rótulos: fotos marcadas "gato" ou "cachorro", e-mails marcados spam ou não, casas com seus preços de venda.
- O modelo aprende o mapeamento de entrada para rótulo, e então recebe entradas que nunca viu e é perguntado para produzir o rótulo.
- Divide-se em classificação 分类, onde a saída é uma categoria, e regressão, onde a saída é um número.
- Seu custo são os rótulos: alguém deve produzi-los, o que para um milhão de imagens é muito trabalho humano.
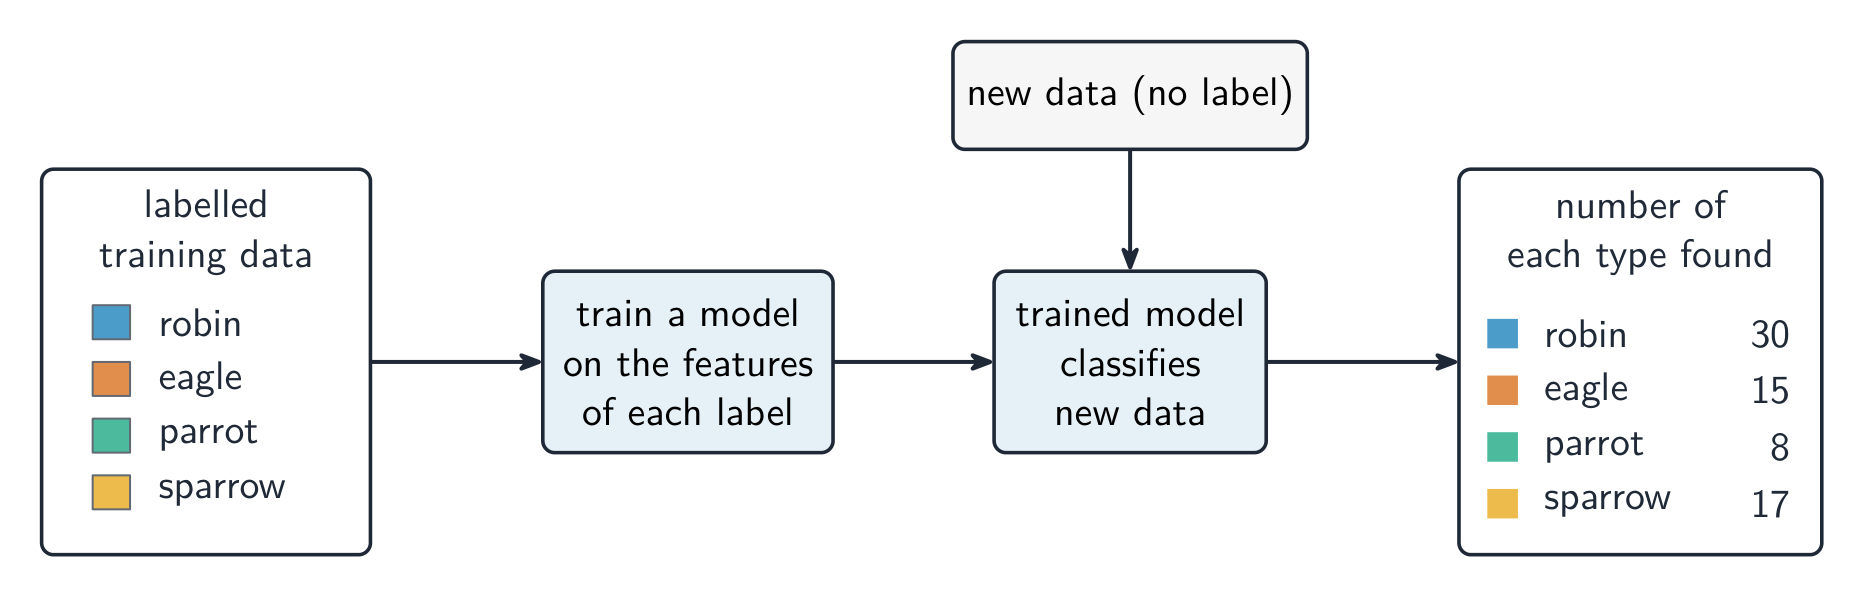
Exemplos rotulados entram, um modelo sai, então entradas não rotuladas
Supervised learning uses:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Supervised learning trains on labelled examples (e.g. images tagged cat/dog).
Aprendizado não supervisionado
- Aprendizado não supervisionado 无监督学习 recebe dados com sem rótulos e é pedido para encontrar estrutura neles.
- O uso mais comum é agrupamento: agrupar em clusters 聚类 de itens semelhantes, como clientes que compram coisas semelhantes, sem ninguém decidir antecipadamente quais devem ser os grupos.
- Essa é sua força e sua fraqueza: pode descobrir um agrupamento ninguém suspeitava, e não pode dizer o que o agrupamento significa.
Unsupervised learning is used to:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
With no labels, unsupervised learning discovers patterns/clusters in the data.
Aprendizado por reforço
- Aprendizado por reforço 强化学习 tem um agente 智能体 agindo em um ambiente. Cada ação muda o estado e retorna uma recompensa 奖励, que pode ser zero por muito tempo.
- O agente aprende uma política 策略, uma estratégia para escolher ações, que maximiza sua recompensa total ao longo do tempo. Aprende por tentativa e erro, sem exemplos rotulados.
- Adequa-se a problemas que são uma sequência de decisões onde o movimento certo só é revelado pelo resultado final: jogos, controle de robôs, carros autônomos. Esse é exatamente o caso do AlphaGo Zero.
In reinforcement learning, the agent learns by:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
The agent tries actions, receives rewards, and learns a policy that maximises long-term reward.
In reinforcement learning the agent learns a ____ that maximises its total reward over time.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
It learns by trial and error from rewards, with no labelled examples at all, which is why it suits sequences of decisions.
Exemplo resolvido: escolha o paradigma
- Dez mil exames médicos, cada um rotulado por um médico mostrando tumor ou não, são usados para treinar um sistema para sinalizar novos exames. Supervisionado: os dados têm rótulos e a tarefa é aprender entrada para rótulo, especificamente uma classificação.
- Uma loja quer saber se seus clientes formam grupos naturais, sem decidir os grupos com antecedência. Não supervisionado: não existem rótulos, e a tarefa é encontrar estrutura, especificamente agrupamento.
- Um braço robótico deve aprender a posicionar componentes, julgado apenas pelo sucesso de cada tentativa. Reforço: um agente, uma sequência de ações e uma recompensa em vez de um rótulo.
- Nomeie o paradigma, então justifique a partir dos dados: rotulados, não rotulados ou um sinal de recompensa.
AI learning type lab
Classify AI examples by the type of learning or concern involved.
Match each ML paradigm to its data.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Supervised = labels; unsupervised = no labels; reinforcement = reward feedback.
Match each situation to the machine-learning paradigm it needs.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
Labels, no labels, or a reward. The data decides the paradigm, not the difficulty of the task.
Treinamento por retropropagação
- Treinar significa ajustar os pesos para que as saídas da rede correspondam aos alvos. O método é retropropagação com descida do gradiente 梯度下降.
- Passagem frontal: passe uma entrada pela rede e obtenha sua saída. Calcule o erro usando uma função de perda 损失函数, que mede quão longe a saída está do alvo.
- Passagem traseira: propague esse erro para trás através das camadas para encontrar o gradiente de cada peso, isto é, quanto aquele peso contribuiu para o erro.
- Atualização: altere cada peso em um pequeno passo contra seu gradiente. O tamanho do passo é a taxa de aprendizado.
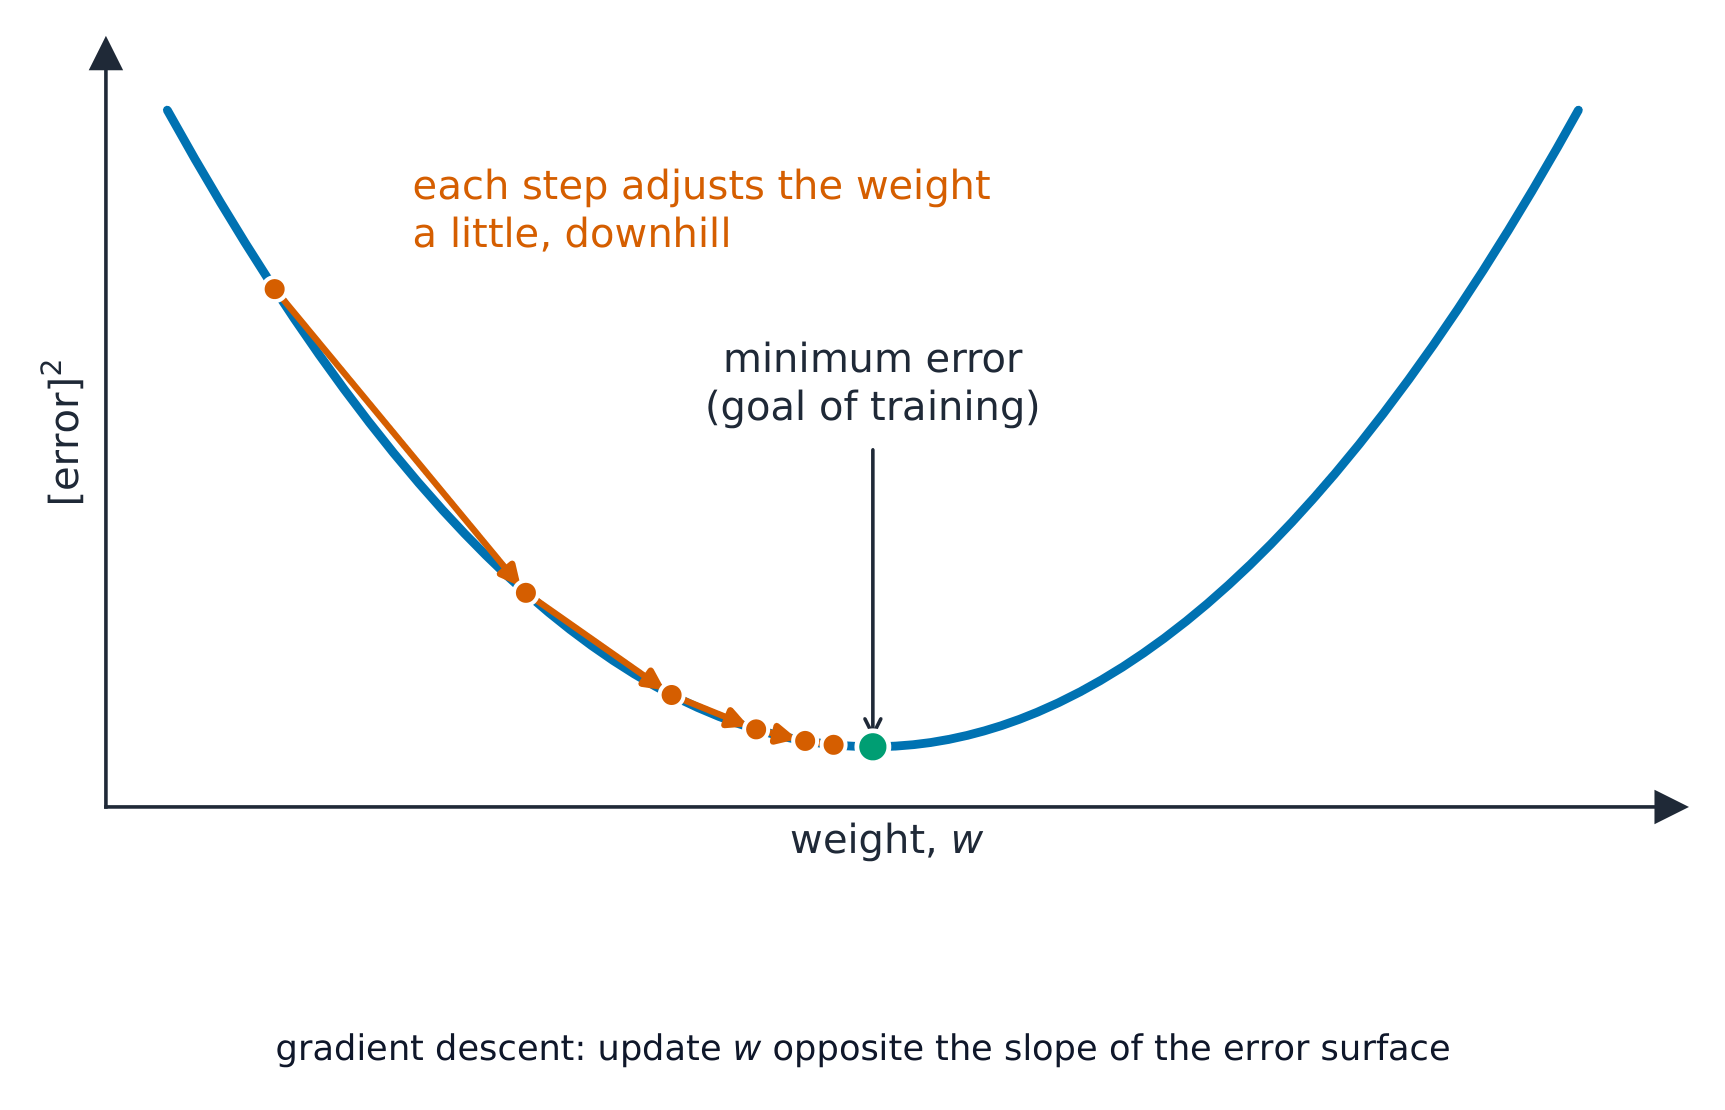
Borracho abaixo, um pequeno passo de cada vez
Backpropagation trains a network by:
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
The error flows from the output back through the network (chain rule) so every weight's gradient is found, then weights step downhill.
Put one round of backpropagation training in order.
Dificuldade 3/5 · Moedas 200 + pequeno bônus na primeira conclusão hoje
Forward, error, backward, update, repeated over many epochs until the error stops falling.
Épocas, e por que a taxa de aprendizado importa
- Uma passagem por todo o conjunto de treinamento é uma época 训练轮次. O treinamento repete-se por muitas épocas até que o erro pare de cair.
- Uma taxa de aprendizado muito grande ultrapassa o mínimo e o erro oscila; muito pequena e o treinamento leva muito mais tempo do que o necessário.
- Após o treinamento, usar o modelo é apenas uma passagem frontal, por isso uma rede treinada responde instantaneamente mesmo que o treinamento tenha levado dias.
In gradient descent the learning rate sets how big a step each weight update takes — too large overshoots the minimum, too small makes training slow.
Dificuldade 1/5 · Moedas 100 + pequeno bônus na primeira conclusão hoje
Backpropagation finds each weight's gradient; the learning rate scales how far down that gradient the weight moves.
Which statements about training are correct? Select todos that apply.
Dificuldade 2/5 · Moedas 140 + pequeno bônus na primeira conclusão hoje
The learning rate is the size of each weight update. That is why training can take days while a prediction takes milliseconds.
Marcas que escapam
- Justifique um paradigma a partir dos dados: rotulados significam supervisionado, não rotulados significam não supervisionado, um sinal de recompensa significam reforço.
- Aprendizado por reforço não tem rótulos. Chamar sua recompensa de rótulo é a confusão clássica.
- Retropropagação é passagem frontal, erro, passagem traseira, atualização, repetido. Nomina-se apenas "ele ajusta os pesos" como meia resposta.
- A taxa de aprendizado é o tamanho de cada passo, não a velocidade do treinamento nem o número de épocas.
Entendeu?
- supervisionado aprende entrada para rótulo a partir de dados rotulados, para classificação ou regressão · não supervisionado encontra estrutura como agrupamentos em dados não rotulados · reforço possui um agente aprendendo uma política a partir de recompensas por tentativa e erro
- escolha o paradigma a partir do que os dados fornecem, não da dificuldade da tarefa
- retropropagação: uma passagem frontal, um erro da função de perda, uma passagem traseira dando o gradiente de cada peso, então uma atualização de tamanho definido pela taxa de aprendizado
- treinamento repete-se por muitas épocas; usar o modelo treinado é uma única passagem frontal