Esta página precisa de um navegador recente (com suporte a SharedArrayBuffer). Por favor, atualize Chrome, Edge, Firefox ou Safari para a versão mais recente.
Python executa seu código uma linha por vez. Cada linha é uma declaração 语句. Um programa 程序 é apenas uma lista de declarações que rodam de cima para baixo.
A função print() exibe texto na tela. Isso é chamado output 输出. Texto entre aspas é uma string 字符串.
print("Hello, world!")
print("I am learning Python")
Cada print() inicia uma nova linha.
As aspas podem ser simples "double" ou duplas 'single' — ambas criam uma string.
Um programa não faz nada até você executá-lo.
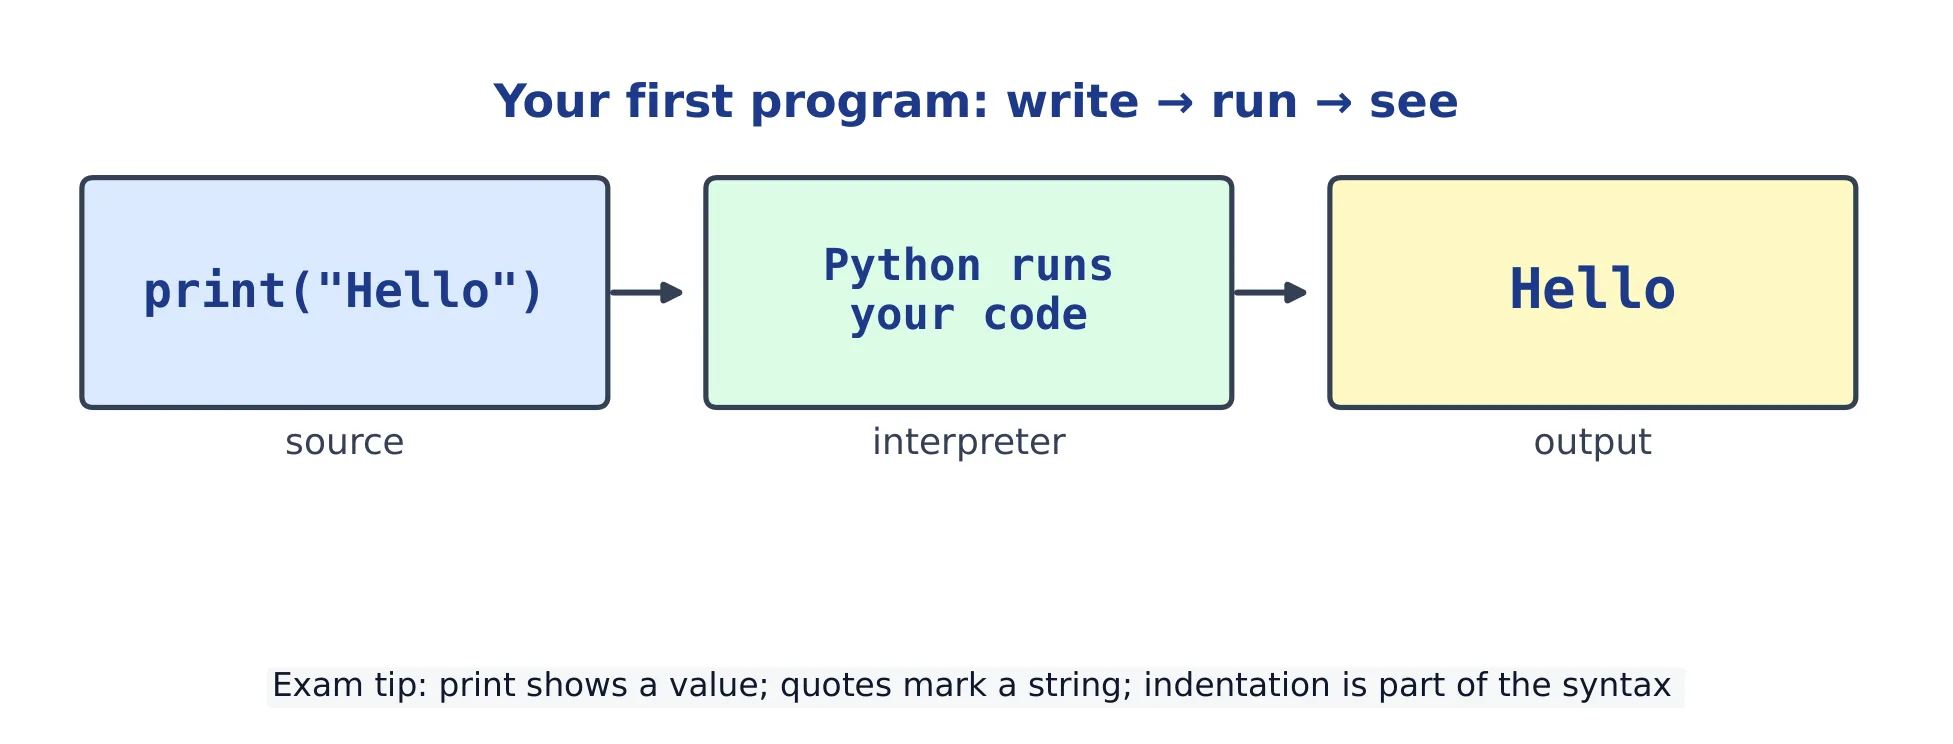
O código-fonte passa pelo interpretador para produzir output
1.2
Comentários & estilo de código
Um comentário 注释 começa com #. Python ignora tudo depois do # naquela linha. Comentários explicam seu código para pessoas; eles não mudam o que o código faz.
# This line is a note for humans
print("Hi")        # you can also comment at the end of a line
Bom estilo torna o código fácil de ler:
Use nomes claros que digam o que um valor significa.
Coloque uma declaração por linha.
Não adicione espaços no início de uma linha normal. Em Python, espaçamento no início (indentation 缩进) tem um significado especial, então um espaço errado gera um erro 错误.
1.3
Entrada, processamento, saída
Muitos programas seguem um plano simples: entrada 输入 → processo → saída. Você obtém alguns dados, faz algo com eles, depois mostra um resultado.
A função input() lê o texto que o usuário digita. Ela sempre retorna uma string.
name = input("What is your name? ")
print("Hello, " + name)
input() espera o usuário digitar e pressionar Enter.
Armazene o texto digitado em uma variável 变量 para usá-la depois.
Como input() retorna uma string, altere-a com int(...) primeiro se precisar de um número.
Erros comuns
Esquecer as aspas: print(Hello) procura uma variável chamada Hello e levanta um NameError. Texto precisa de aspas: print("Hello").
Um espaço solto no início de uma linha: Python lê a indentação como estrutura, então levanta um IndentationError.
Assumir que input() retorna um número. Ela sempre retorna uma string, então envolva-a em int(...) antes de fazer qualquer matemática.
Uma variável 变量 é um nome para um valor 值. Você cria uma com =, que é chamado de atribuição 赋值. O nome vai à esquerda; o valor vai à direita.
age = 17
name = "Mei"
price = 9.99
print(age, name, price)
Agora age contém 17. Use o nome onde quer que precise do valor, e altere-o depois:
age = 17
age = age + 1   # age is now 18
print(age)
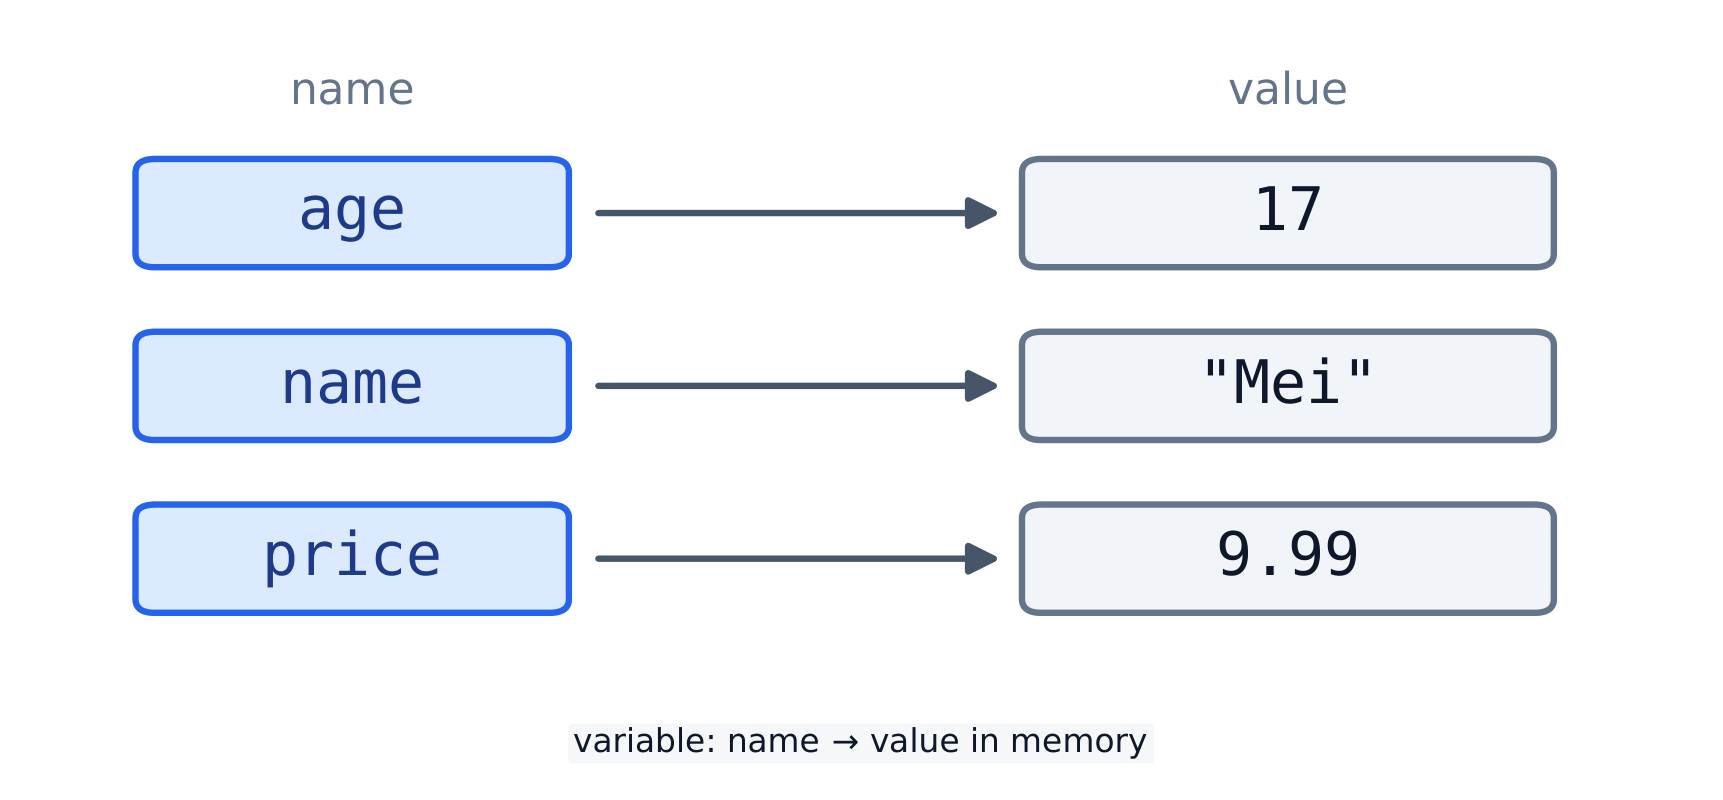
Cada nome de variável aponta para um valor na memória
O sinal = não significa "igual". Significa "armazenar o lado direito sob o nome da esquerda".
Para testar se dois valores são iguais, use == (veja abaixo).
2.2
Números: int & float
Python tem dois tipos principais de números. Um inteiro 整数 (int) é um número inteiro como 17. Um float 浮点数 (float) tem ponto decimal como 9.99.
Estes operadores 运算符 funcionam em números:
Operador
Significado
Exemplo
Resultado
+
somar
3 + 2
5
-
subtrair
3 - 2
1
*
multiplicar
3 * 2
6
/
dividir (sempre float)
7 / 2
3.5
//
divisão inteira
7 // 2
3
%
resto (módulo)
7 % 2
1
**
potência
2 ** 3
8
/ sempre dá um float, então 4 / 2 é 2.0.
// e % andam juntos: 17 // 5 é 3, e 17 % 5 é 2.
2.3
Expressões & conversão de tipo
Uma expressão 表达式 é qualquer coisa que tem um valor, como 3 + 4 * 2. Python usa a ordem matemática normal (* e / antes de + e -); adicione parênteses para deixar a ordem clara.
input() retorna uma string, então converta-a antes de fazer matemática. Mudar um valor de um tipo para outro é conversão de tipo 类型转换:
age = int("17")        # text "17" -> number 17
price = float("9.99")  # text -> 9.99
label = str(17)        # number -> text "17"
print(age, price, label)
int("abc") falha, então converta apenas texto que pareça um número.
Misturar tipos também falha: "age: " + 17 é um erro; escreva "age: " + str(17).
2.4
Booleanos & comparação
Um Boolean 布尔值 é um de apenas dois valores: True ou False. Uma comparação 比较 retorna um Boolean.
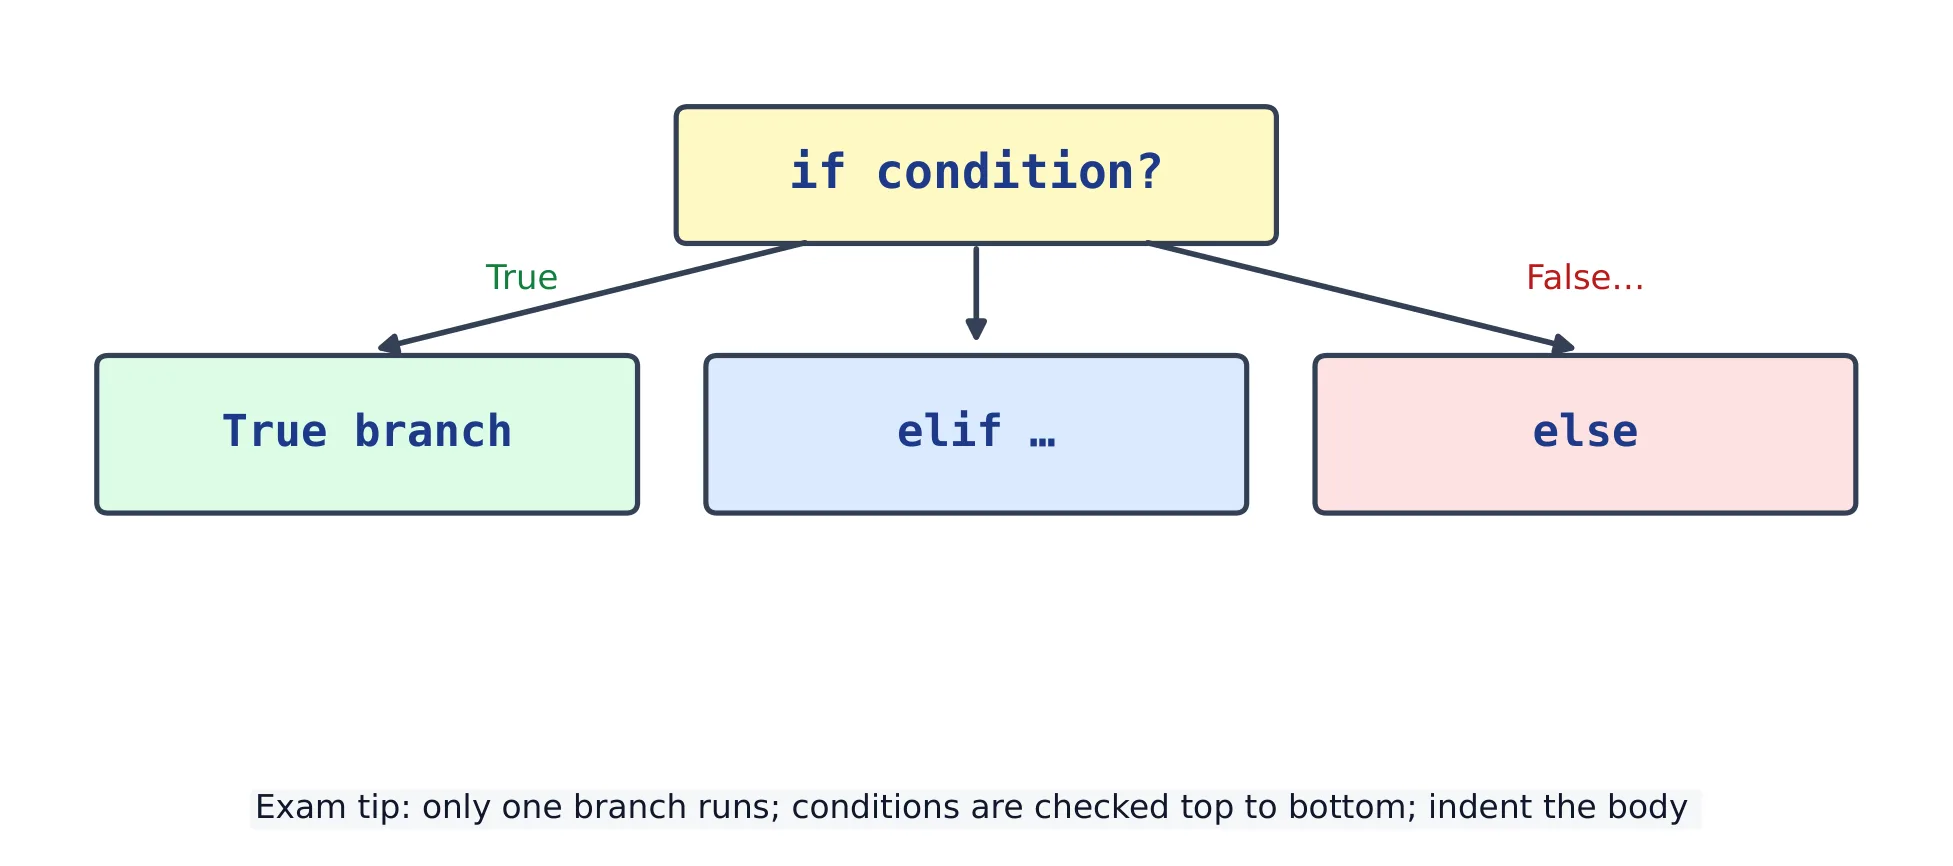
Um programa escolhe o que fazer com base em if. Ele executa um bloco indentado apenas quando uma condição é verdadeira. A linha if termina com dois-pontos.
score = 72
if score >= 60:
    print("pass")
# pass
Adicione elif (else-if) para mais casos e else para "qualquer outra coisa". Python executa apenas o primeiro ramo verdadeiro e ignora os demais.
score = 72
if score >= 80:
    print("A")
elif score >= 60:
    print("B")
else:
    print("fail")
# B
grid = [[1, 2], [3, 4]]
for row in grid:
    for value in row:
        print(value, end=" ")
print()               # 1 2 3 4
6.4
Compreensão de listas
Uma compreensão de lista constrói uma nova lista em uma linha: [expression for item in sequence].
squares = [x * x for x in range(5)]
print(squares)        # [0, 1, 4, 9, 16]
Adicione if para manter apenas alguns itens.
evens = [n for n in range(10) if n % 2 == 0]
print(evens)          # [0, 2, 4, 6, 8]
6.5
Tuplas & conjuntos
Uma tupla é uma sequência fixa entre parênteses. Não pode ser alterada após criada — use-a para valores que pertencem juntos e desempacote-os em nomes.
point = (3, 4)
x, y = point            # unpacking
print(x, y)             # 3 4
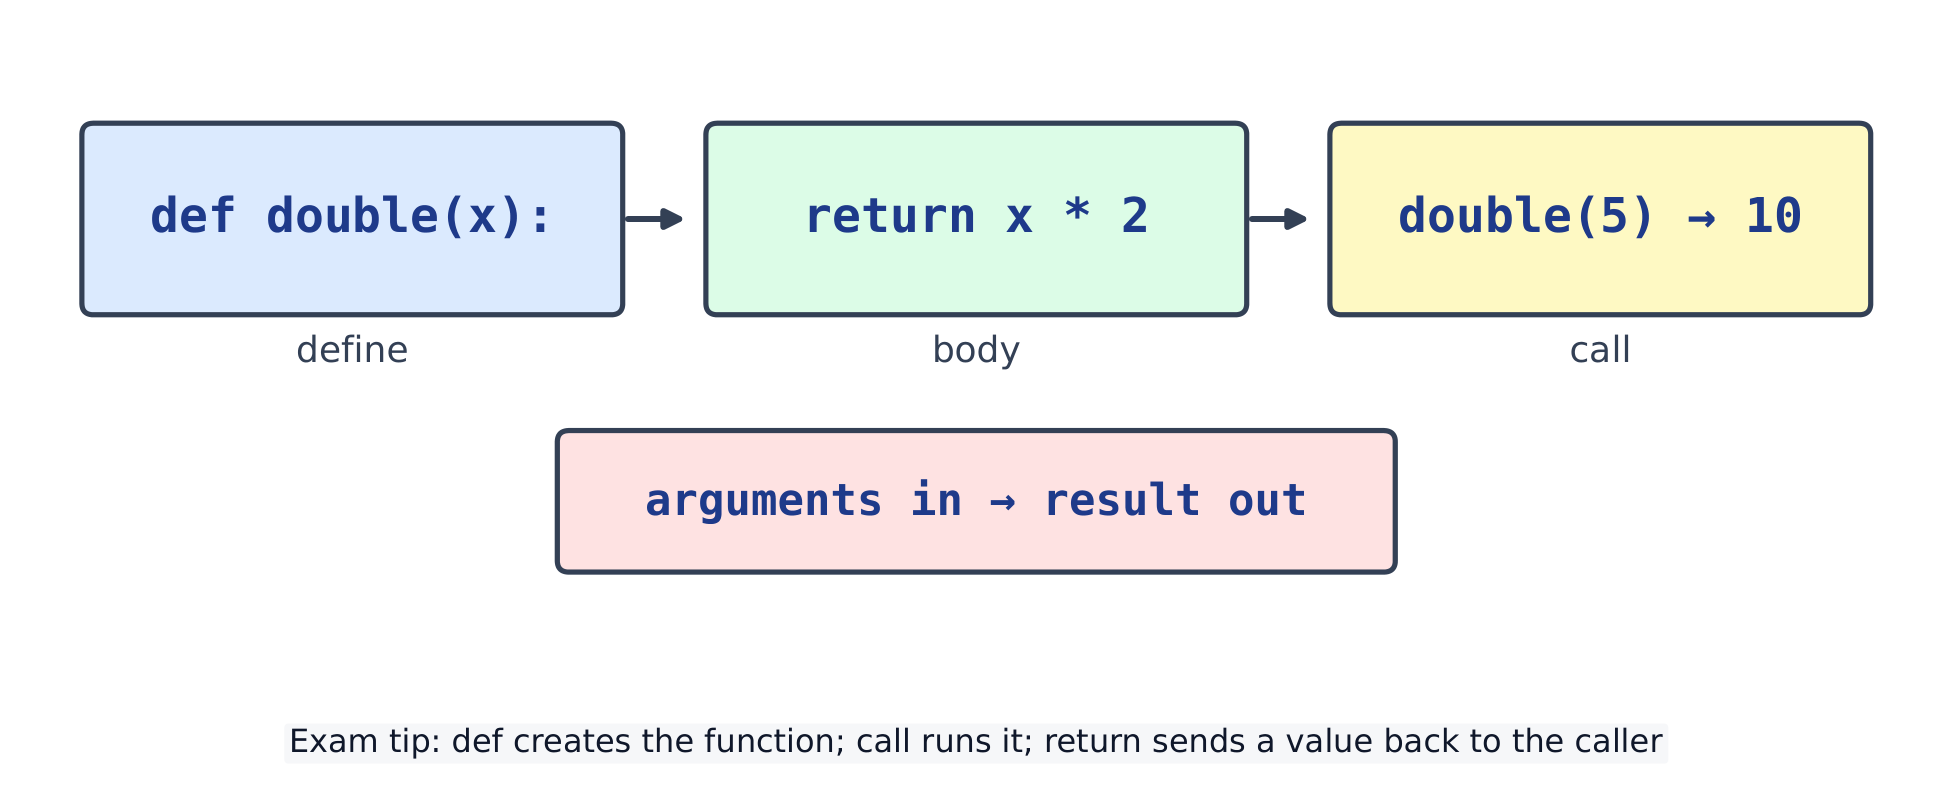
Uma função que precisa devolver dois resultados retorna um tuple:
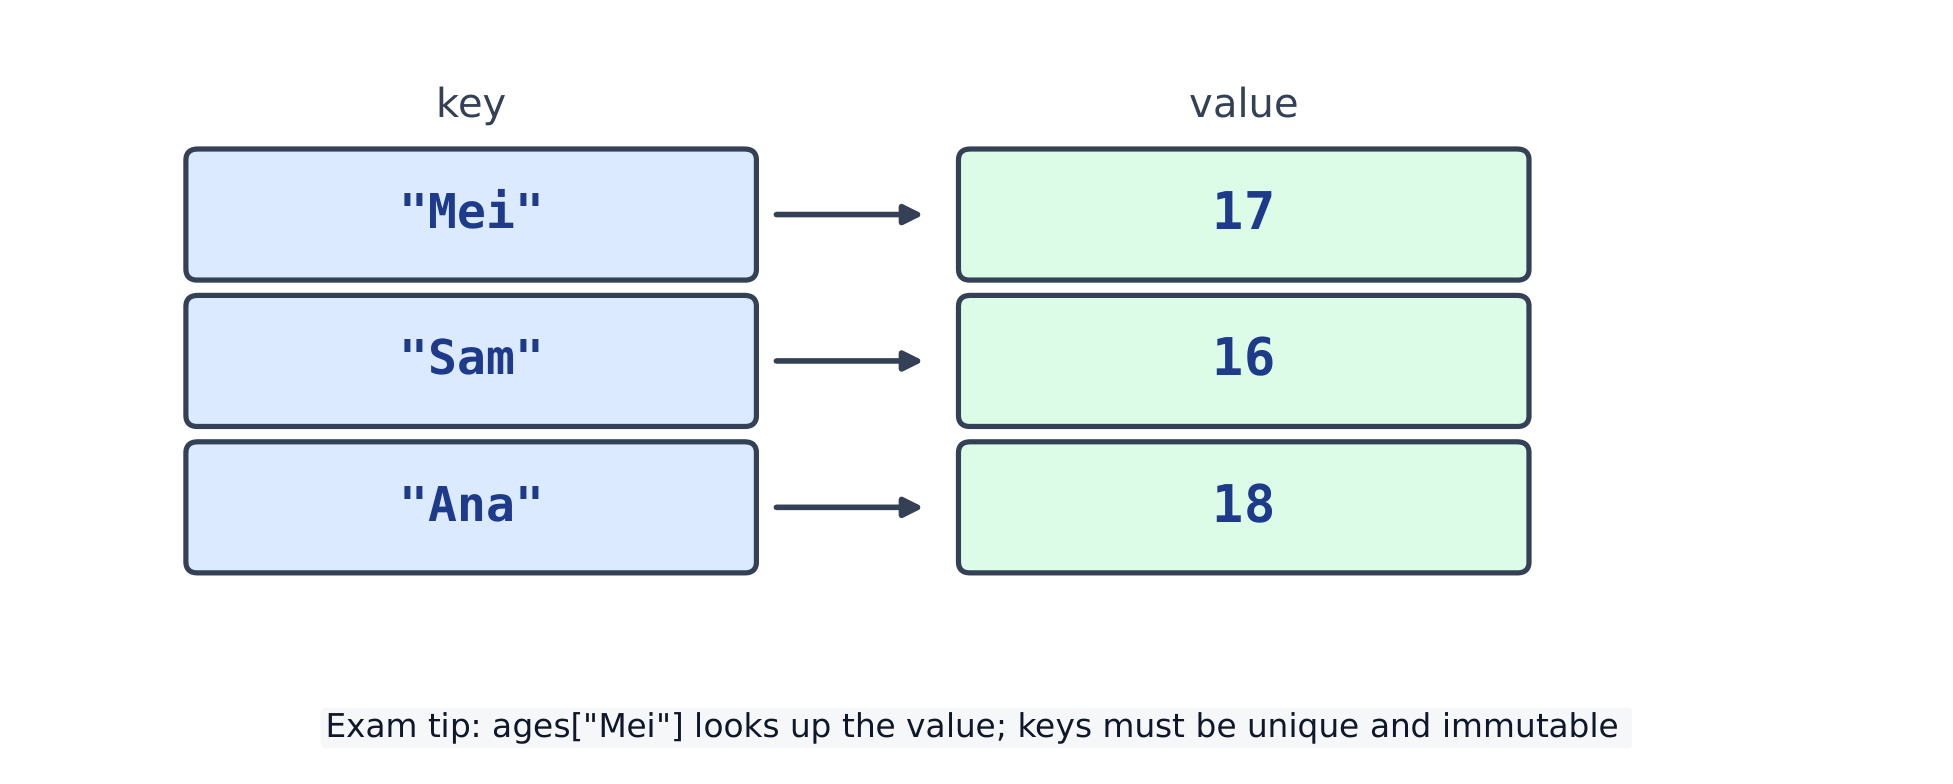
Atribua a uma chave para adicioná-la ou alterar uma existente.
student = {"name": "Mei"}
student["score"] = 88      # add a new key
student["score"] = 90      # update the value
print(student)             # {'name': 'Mei', 'score': 90}
Verificar e iterar
Use in para testar se uma chave existe. Itere sobre as chaves, ou sobre .items() para obter tanto a chave quanto o valor.
student = {"name": "Mei", "score": 90}
print("score" in student)  # True
for key, value in student.items():
    print(key, "=", value)
# name = Mei
# score = 90
.get(key, default) retorna um valor padrão quando a chave está ausente — sem erro.
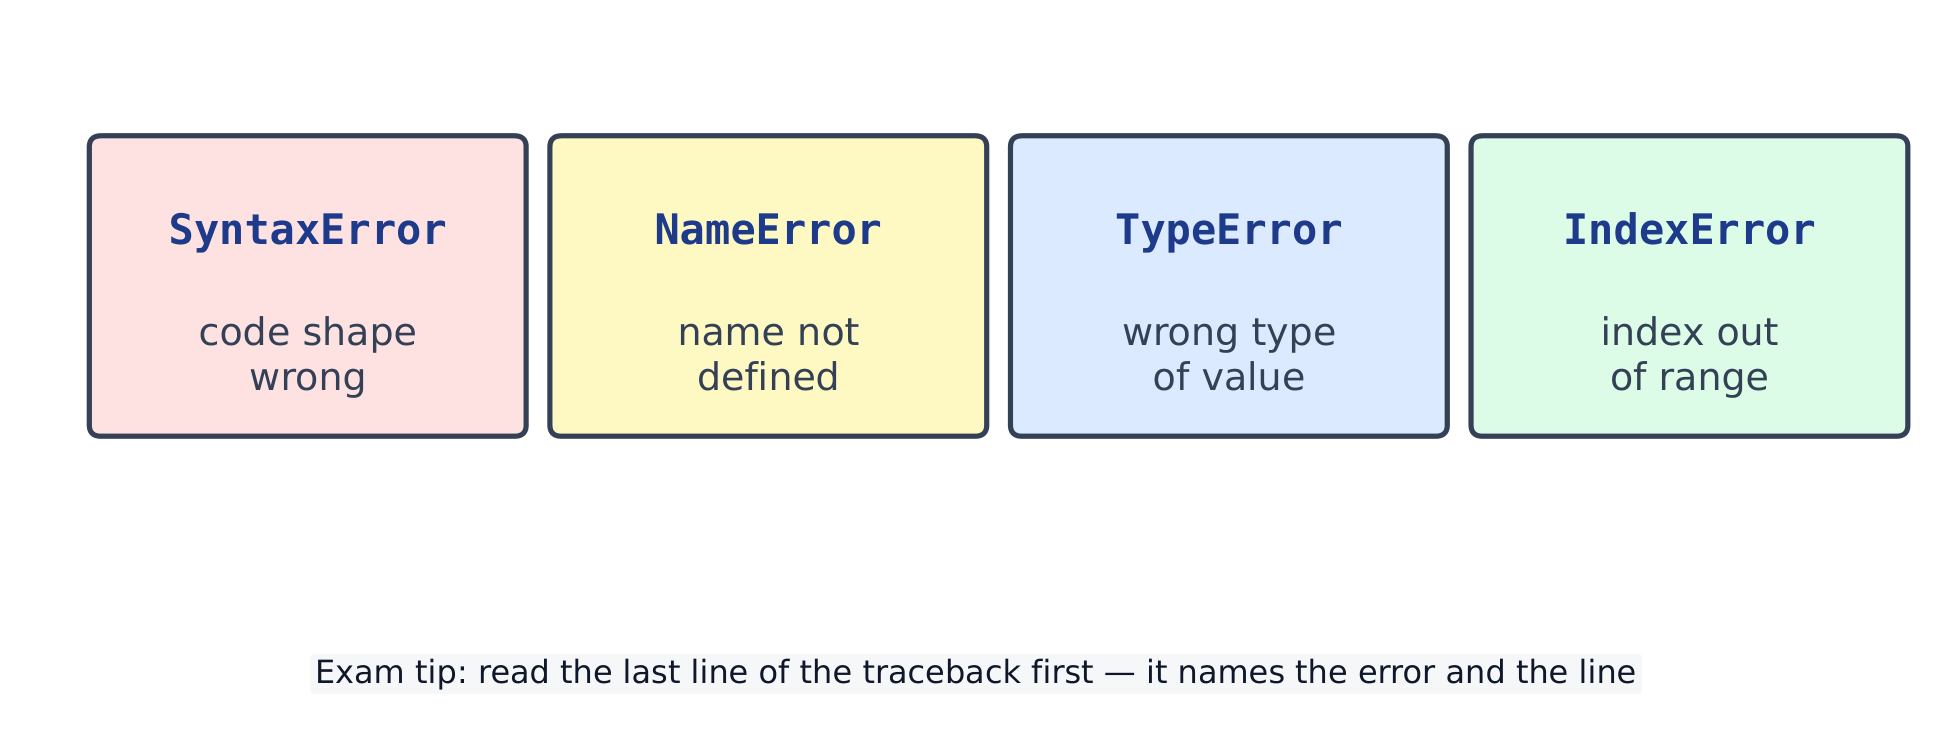
O código pode falhar de três formas. Um erro de sintaxe viola as regras do Python, então nunca é executado. Um erro de tempo de execução ocorre durante a execução, como divisão por zero. Um erro lógico executa, mas produz a resposta errada.
Erros comuns do Python: Syntax, Name, Type, Index
# A runtime error, caught so this block still finishes:
try:
    print(10 / 0)
except ZeroDivisionError:
    print("cannot divide by zero")
# cannot divide by zero
O Python imprime um rastreamento mostrando onde falhou. Leia-o de baixo para cima.
9.2
try / except / raise
Coloque o código arriscado em try; se falhar, except captura a exceção em vez de causar uma falha.
Capture um tipo específico (ValueError, ZeroDivisionError, …).
raise gera seu próprio erro propositalmente.
def set_age(age):
    if age < 0:
        raise ValueError("age cannot be negative")
    return age

try:
    set_age(-1)
except ValueError as err:
    print("error:", err)
# error: age cannot be negative
9.3
Testes & robustez
Um teste verifica se o código gera a resposta correta. Teste casos normais e casos extremos — entrada vazia, zero, valores muito grandes.
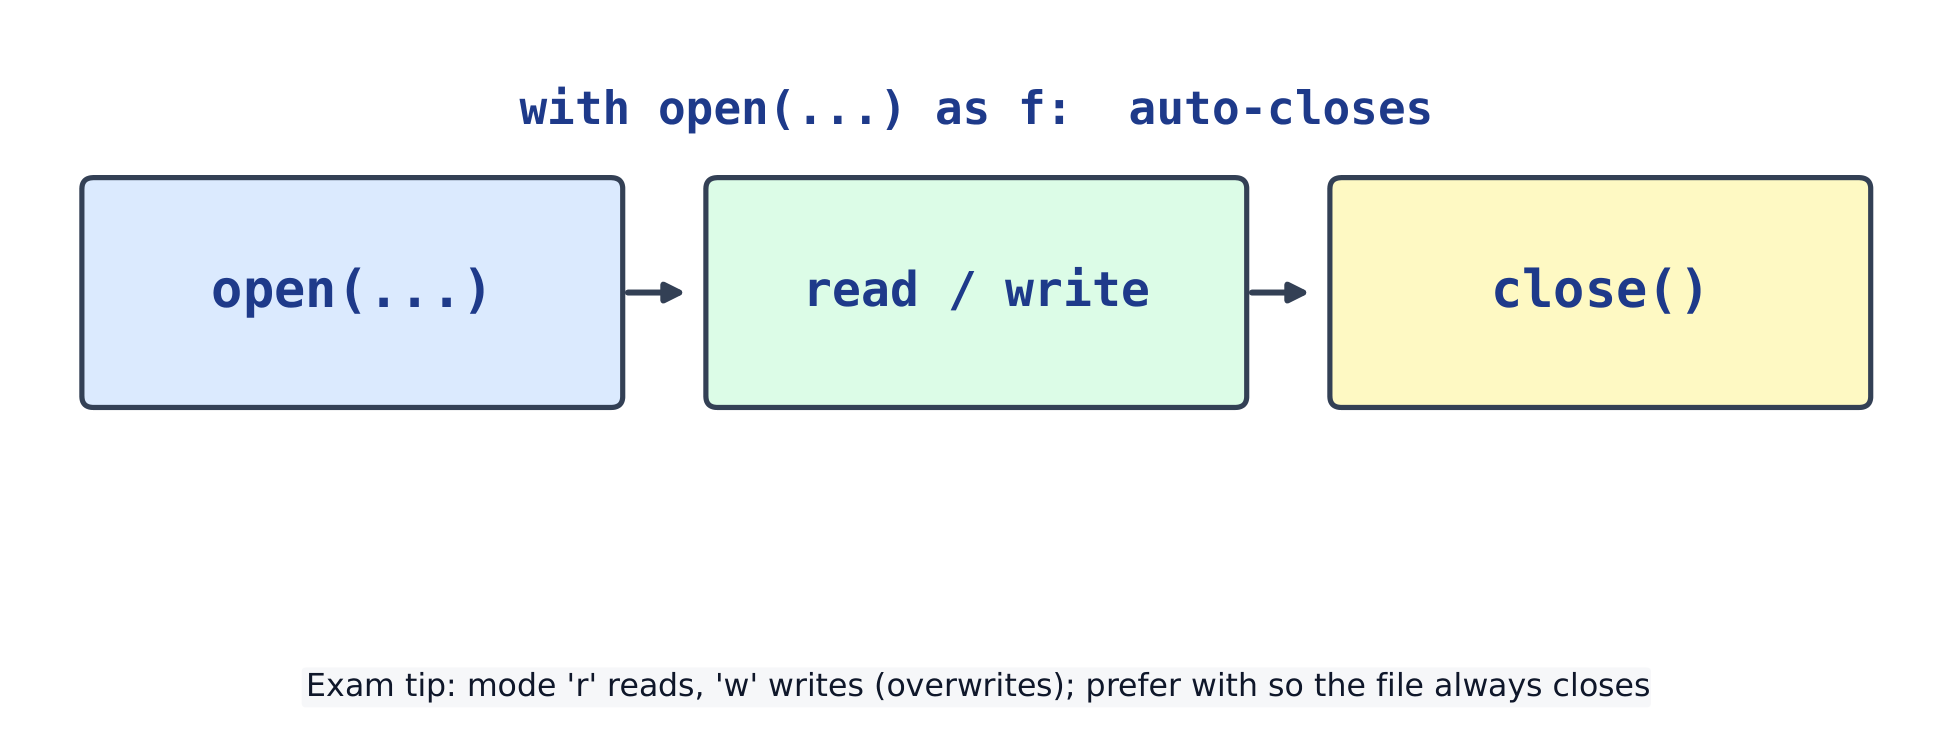
Um arquivo de texto 文本文件 armazena texto em disco. Abra-o com open(name, mode) onde mode 模式 diz para ler ou escrever. Sempre use with, que fecha o arquivo por você.
Escrevendo
Mode "w" escreve um novo arquivo e apaga qualquer antigo.
with open("notes.txt", "w") as f:
    f.write("first line\n")
    f.write("second line\n")
print("saved")            # saved
Lendo
Mode "r" (o padrão) lê. .read() retorna todo o arquivo como uma única string.
with open("notes.txt", "w") as f:
    f.write("hello\nworld\n")
with open("notes.txt") as f:
    print(f.read().strip())   # hello / world
Linha por linha
Faça loop sobre o arquivo para obter uma linha de cada vez. .strip() remove 去除 o newline 换行符 no final.
with open("data.txt", "w") as f:
    f.write("Mei,88\nSam,71\n")
with open("data.txt") as f:
    for line in f:
        name, score = line.strip().split(",")
        print(name, "scored", score)
# Mei scored 88
# Sam scored 71
Append
Mode "a" append 追加 — adiciona ao final sem apagar.
with open("log.txt", "w") as f:
    f.write("line 1\n")
with open("log.txt", "a") as f:
    f.write("line 2\n")
with open("log.txt") as f:
    print(f.read().strip())   # line 1 / line 2
Mode
Significado
"r"
read (padrão)
"w"
write (apaga primeiro)
"a"
append (adicionar ao final)
Erros comuns
Sempre feche um arquivo, ou use with open(...) as f: que o fecha por você.
read() dá todo o arquivo como uma única string, e cada linha ainda termina com \n.
Abrir com "w" apaga o arquivo primeiro; use "a" para adicionar ao final.
Um algoritmo é uma lista clara de passos que resolve um problema. Decomposição significa dividir um grande problema em partes menores que você pode resolver uma de cada vez.
# Algorithm: find the largest number in a list
def largest(nums):
    best = nums[0]
    for n in nums:
        if n > best:
            best = n
    return best

print(largest([3, 9, 2, 7]))   # 9
Abstração significa ignorar detalhes: você usa largest(...) sem reler como funciona.
11.2
Pseudocódigo & fluxogramas
Pseudocódigo é inglês estruturado simples para um algoritmo, escrito antes do código real. Ele não é executado.
SET best TO first number
FOR Each number n
    IF n > best
      THEN
        SET best TO n
OUTPUT best
Um fluxograma desenha o mesmo plano: uma caixa para cada passo, um losango para cada decisão e setas para a ordem.
11.3
Recursão & pilha de chamadas
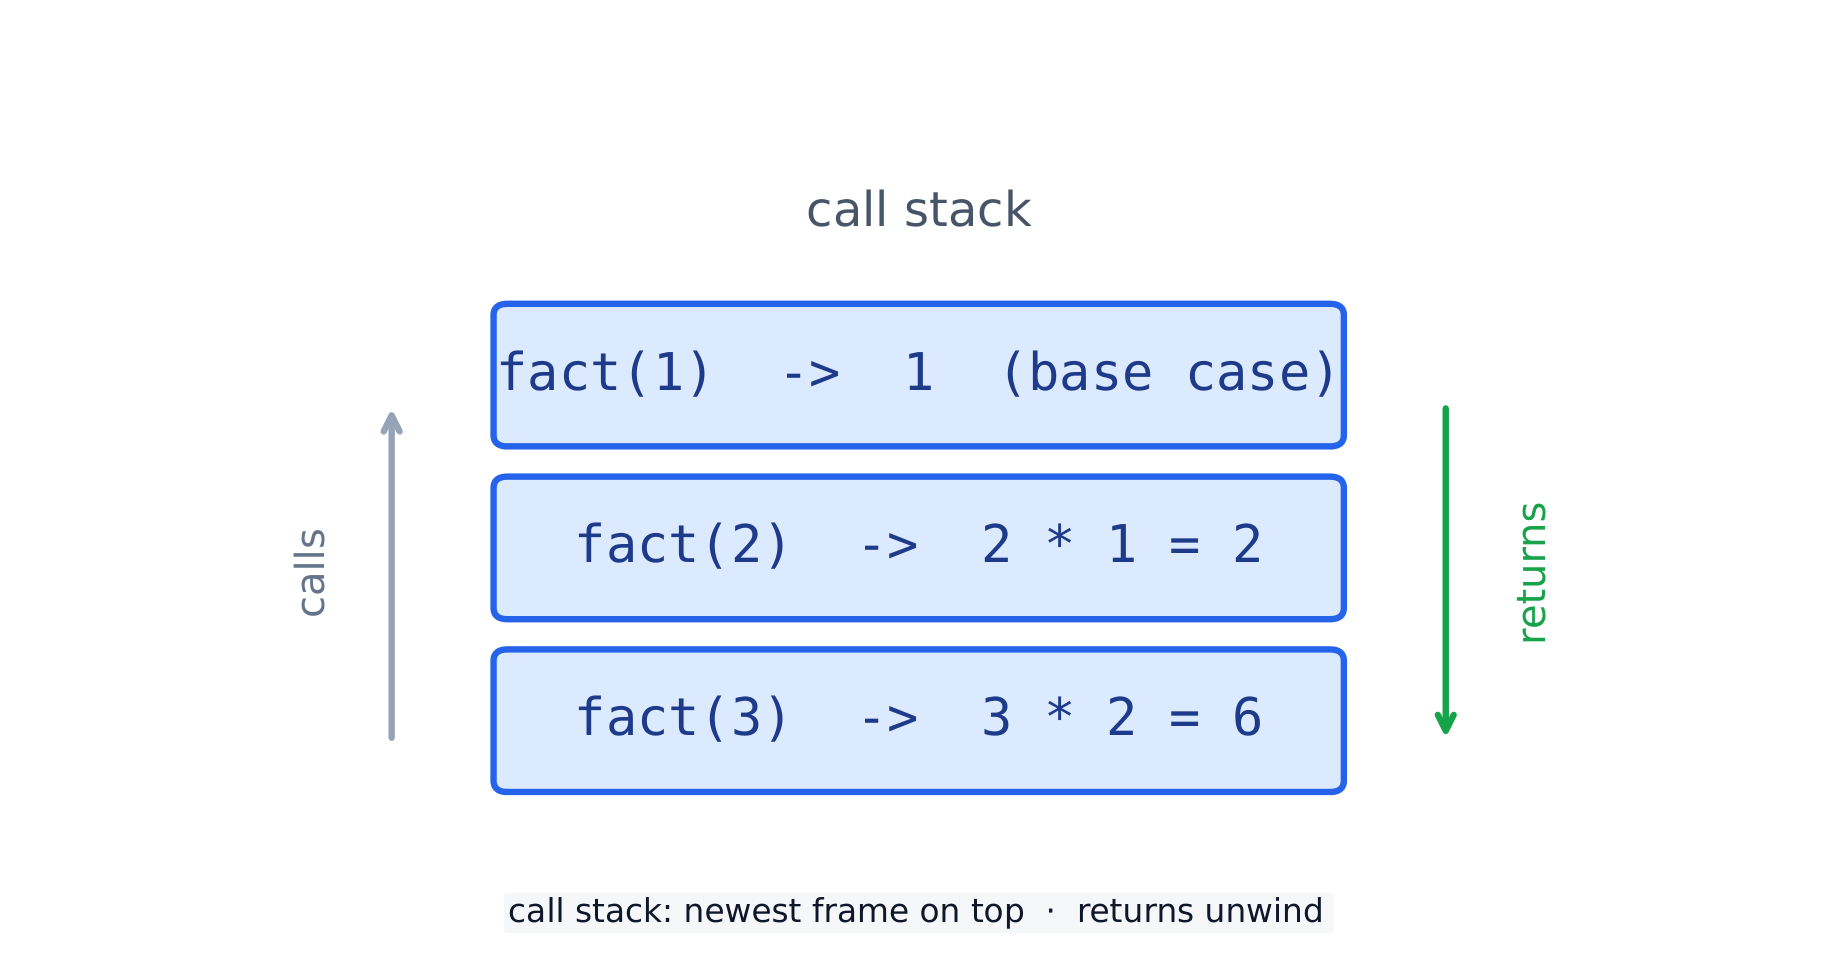
Recursão é quando uma função se chama. Precisa de um caso base (entrada simples que retorna imediatamente) e um caso recursivo (chama-se a si mesma com uma entrada menor).
A pilha de chamadas para factorial(3): cada chamada espera, depois retorna em ordem inversa
def fact(n):
    return 1 if n <= 1 else n * fact(n - 1)

print(fact(5))     # 120
Cada chamada em pausa permanece na pilha de chamadas até que a chamada acima dela retorne.
Erros comuns
Recursão precisa de um caso base, ou ela se chama infinitamente e quebra a call stack.
Pseudocódigo é para planejamento — ele não precisa rodar, mas cada passo deve ser inequívoco.
Quebre um grande problema em passos pequenos nomeados antes de escrever qualquer código.
Um tipo de dado abstrato 抽象数据类型 (ADT) descreve alguns dados mais as operações sobre eles, separado de como é construído. Você o usa através de suas operações, não através de seu armazenamento interno.
# A stack ADT, built on a list
s = []
s.append(1)        # add
s.append(2)
print(s.pop())     # 2  (remove the most recent)
12.2
Pilhas
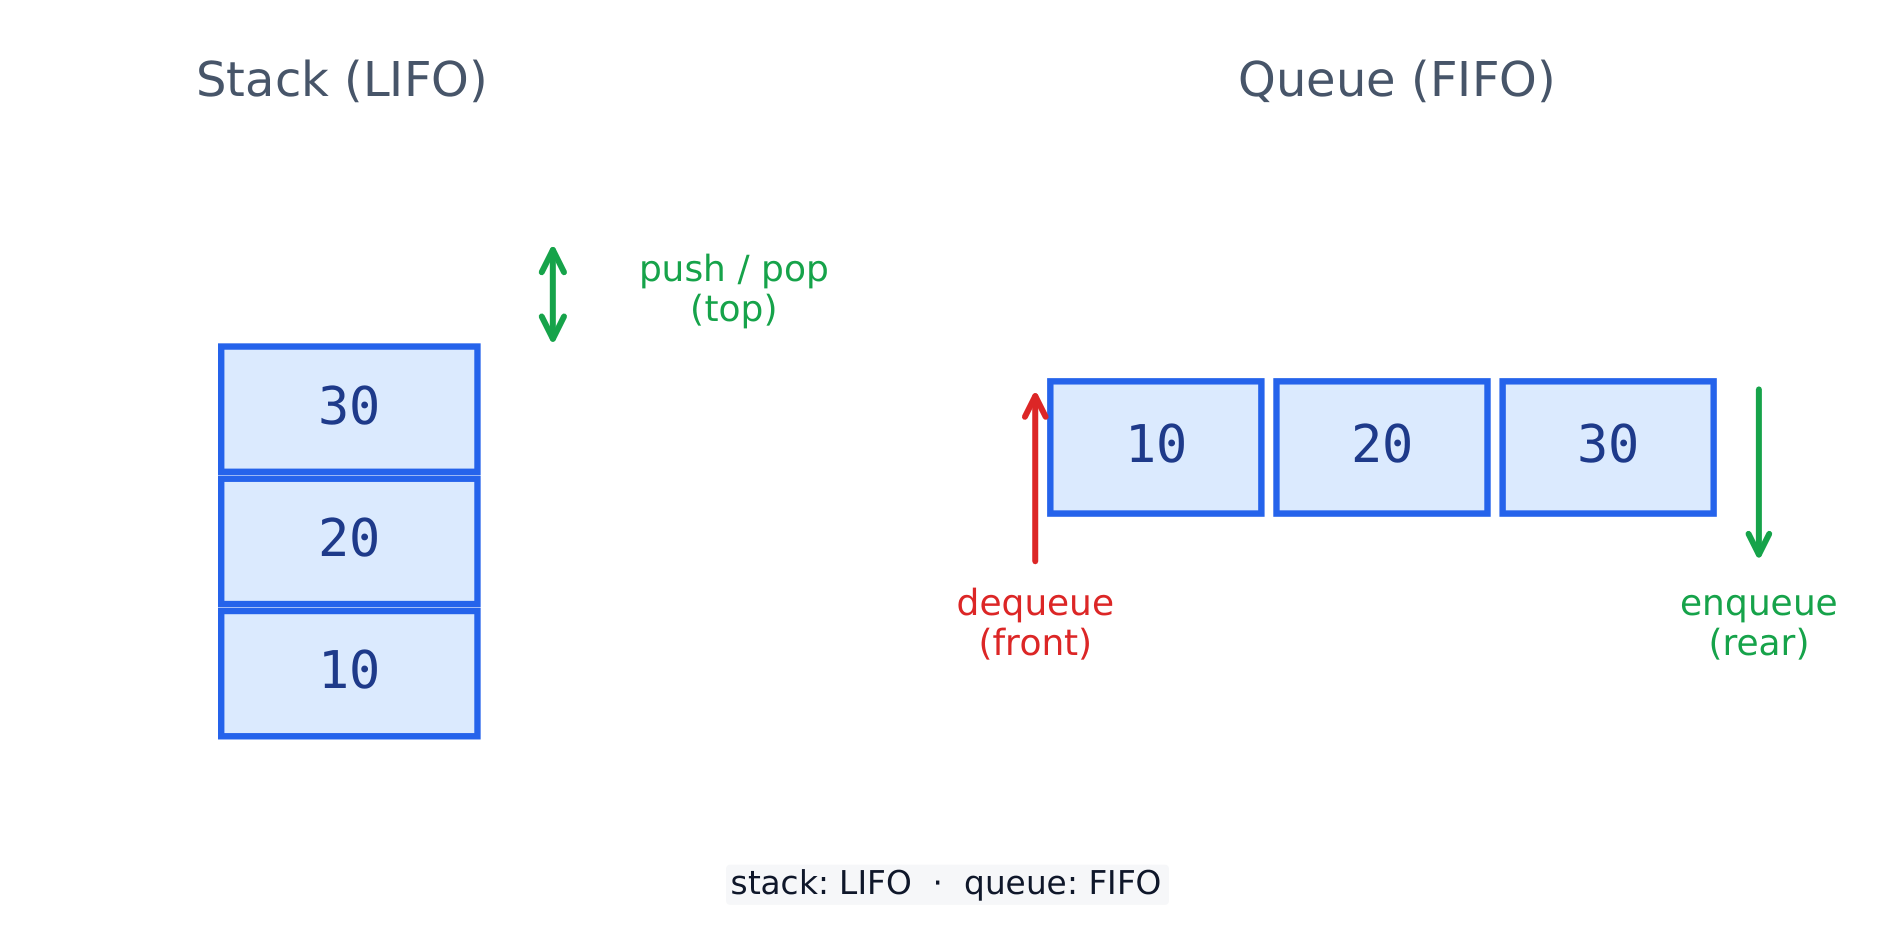
Uma pilha 栈 é last-in, first-out (LIFO 后进先出). Você push 压入 no topo e pop 弹出 do topo.
Uma pilha remove do topo (LIFO); uma fila remove da frente (FIFO)
stack = []
stack.append("a")
stack.append("b")
print(stack.pop())   # b
print(stack.pop())   # a
12.3
Filas
Uma fila 队列 é first-in, first-out (FIFO 先进先出). Você enqueue 入队 na traseira e dequeue 出队 da frente.
queue = []
queue.append("a")     # enqueue
queue.append("b")
print(queue.pop(0))   # a  (dequeue the front)
print(queue.pop(0))   # b
12.4
Listas encadeadas
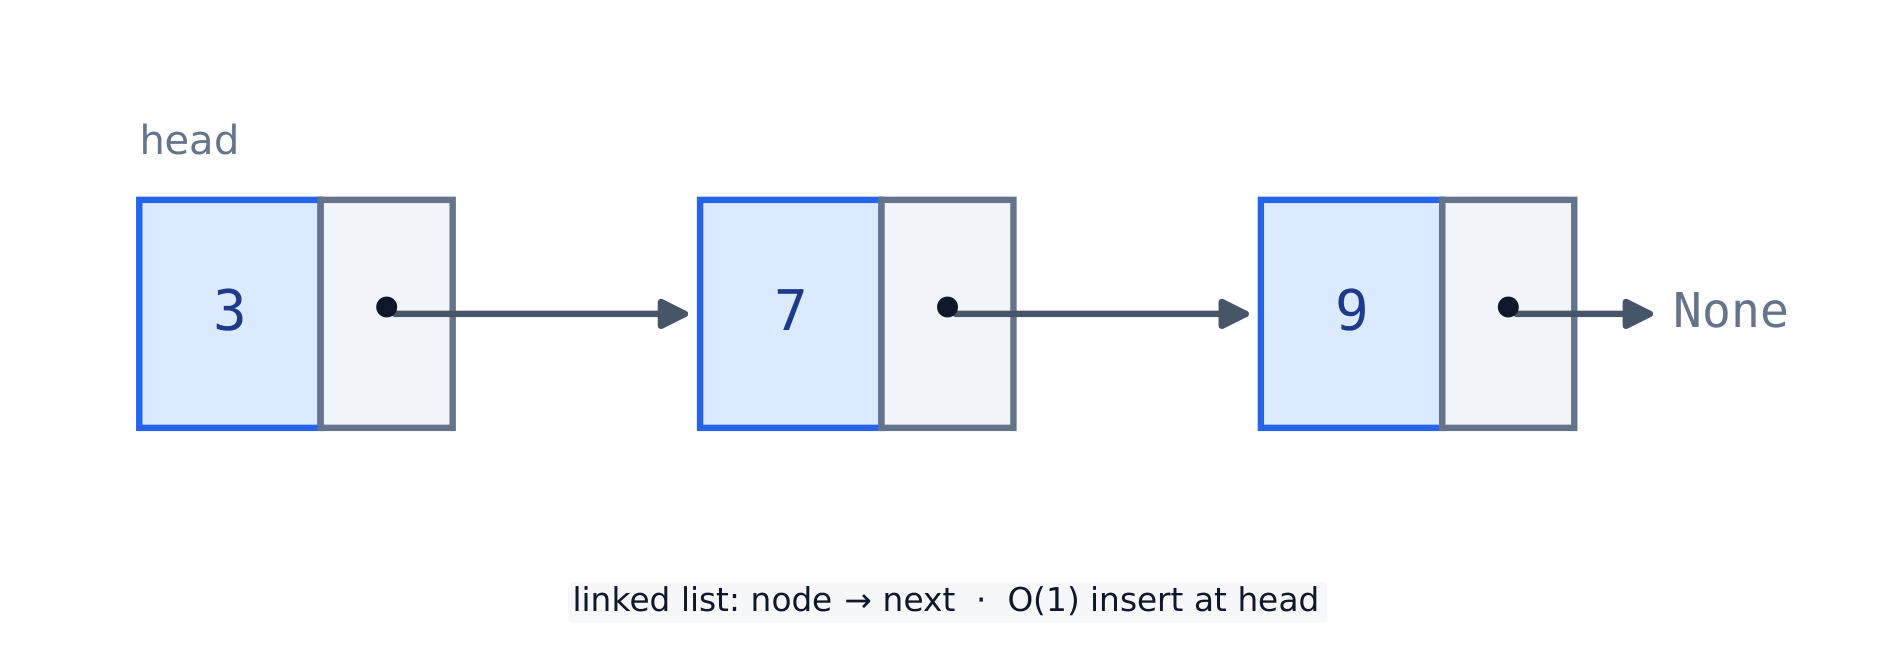
Uma linked list 链表 é uma cadeia de nodes 节点. Cada node segura dados e um pointer 指针 para o próximo node; o último aponta para None.
Uma lista encadeada: cada nó contém dados e um ponteiro para o próximo nó, terminando em None
n3 = {"data": 3, "next": None}
n2 = {"data": 2, "next": n3}
n1 = {"data": 1, "next": n2}
node = n1
while node is not None:      # traverse to the end
    print(node["data"])
    node = node["next"]
# 1 2 3
12.5
Tabelas hash
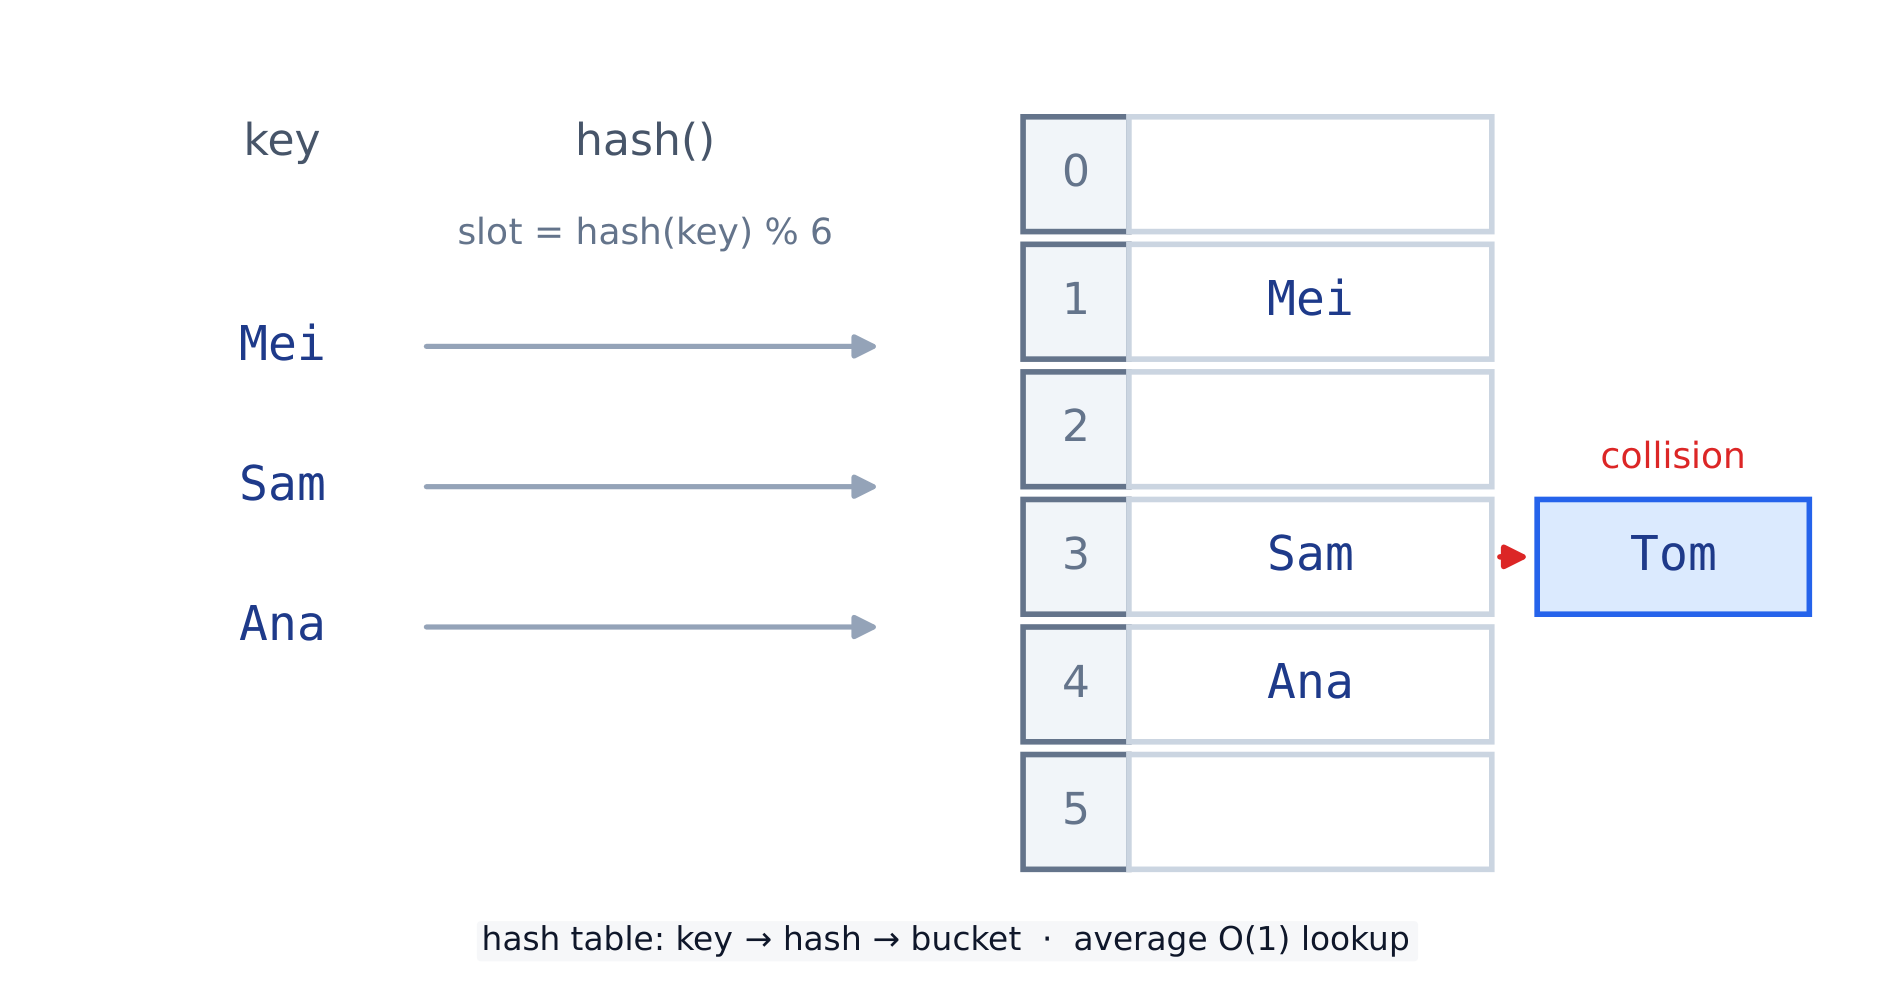
Uma tabela hash 哈希表 mapeia uma key para uma slot com uma hash function 哈希函数. Duas keys podem cair na mesma slot — uma collision 冲突. Python's dict é uma tabela hash, então lookup é rápido.
Uma função hash mapeia cada chave para um slot; duas chaves podem colidir em um único slot
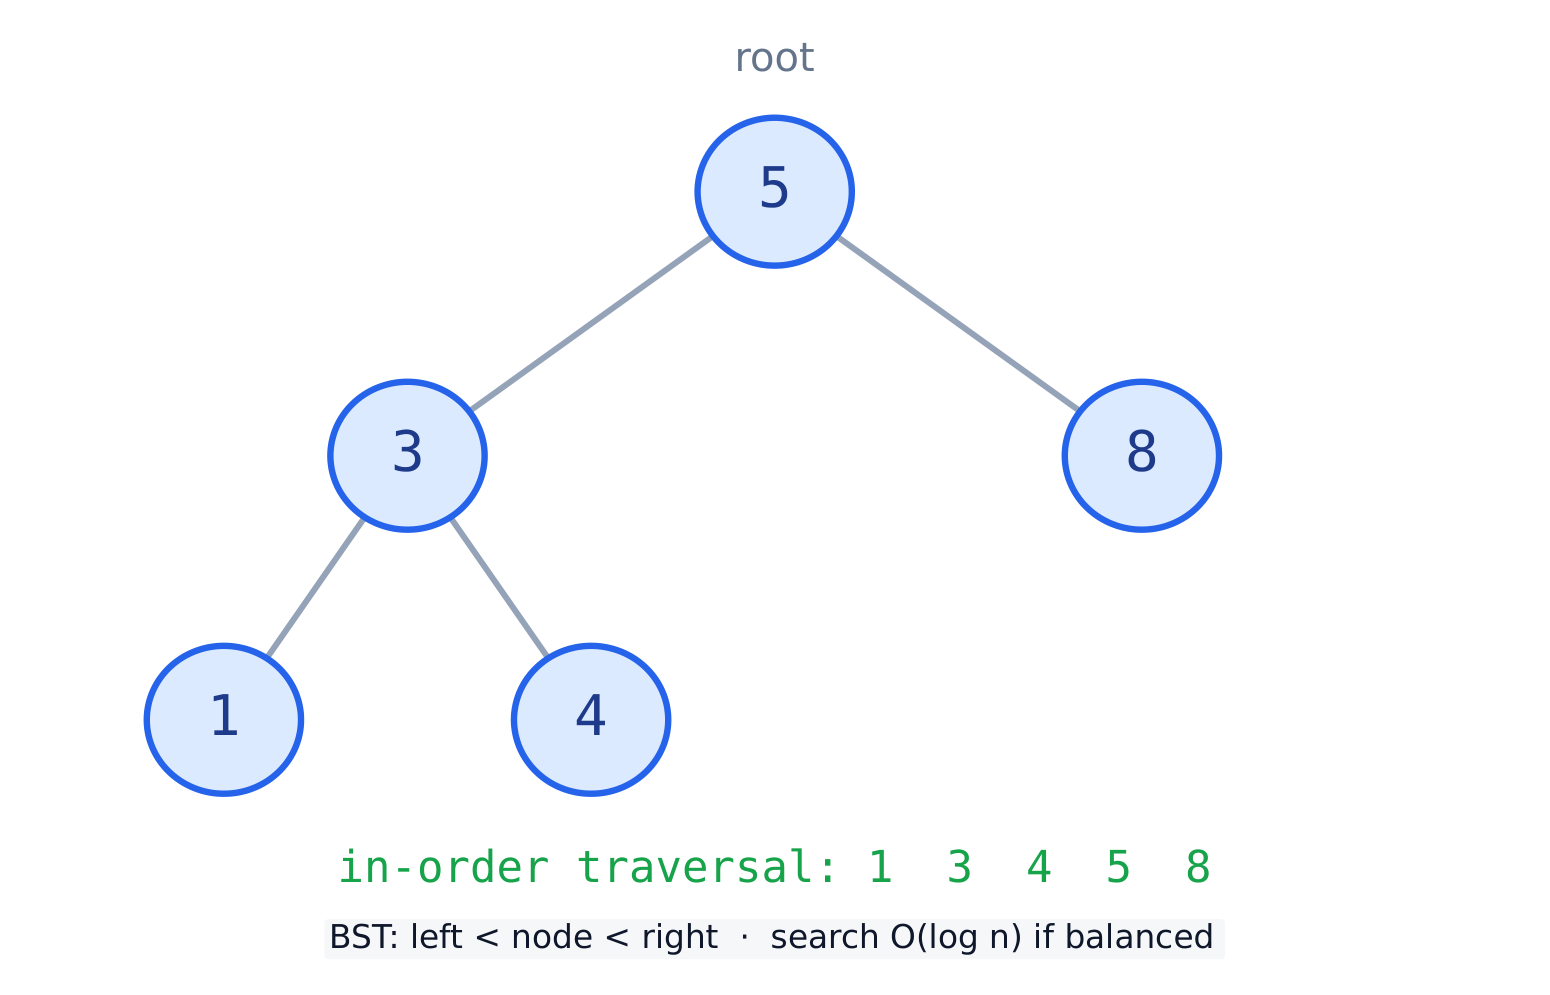
Uma binary search tree 二叉搜索树 (BST) mantém ordem: todo filho esquerdo é menor que seu nó, todo filho direito é maior. Search permanece rápido.
Uma árvore de busca binária: valores menores vão para a esquerda, valores maiores vão para a direita
def insert(root, val):
    if root is None:
        return {"val": val, "left": None, "right": None}
    if val < root["val"]:
        root["left"] = insert(root["left"], val)
    else:
        root["right"] = insert(root["right"], val)
    return root

def inorder(root):
    if root is None:
        return []
    return inorder(root["left"]) + [root["val"]] + inorder(root["right"])

tree = None
for v in [5, 3, 8, 1, 4]:
    tree = insert(tree, v)
print(inorder(tree))   # [1, 3, 4, 5, 8]
12.7
Grafos
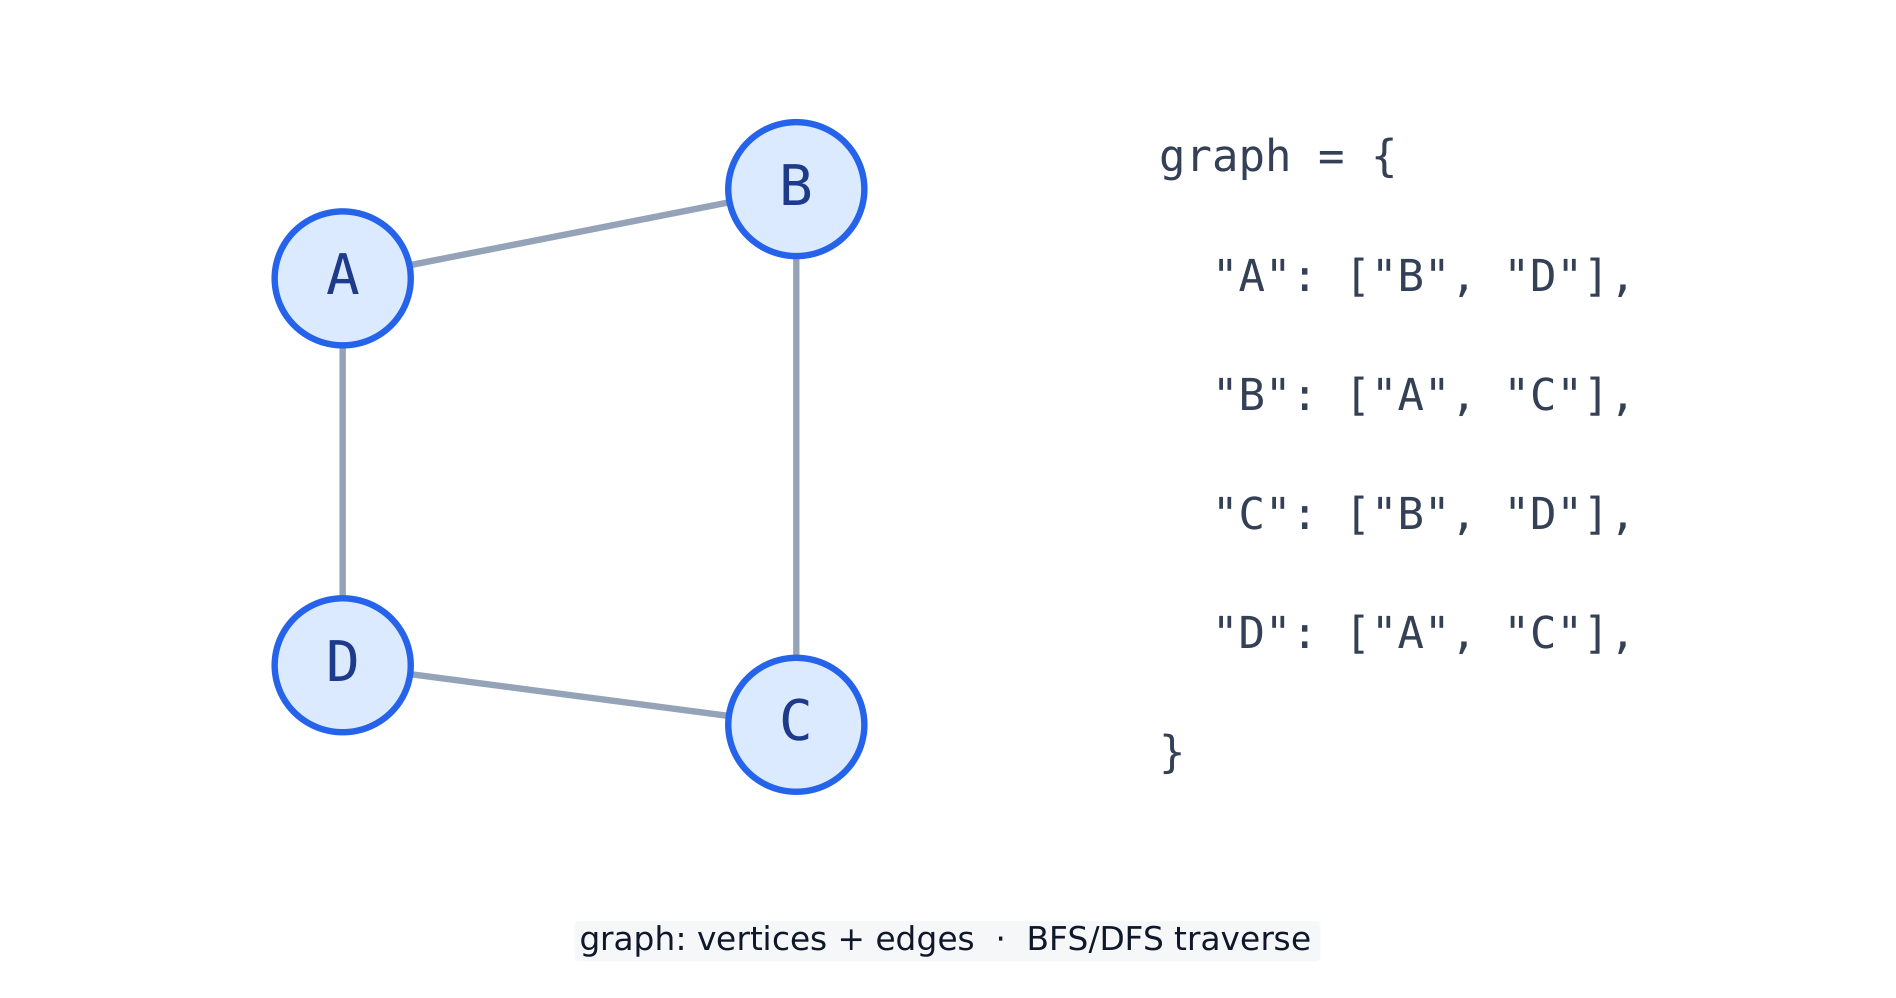
Um graph 图 é um conjunto de vertices 顶点 unidos por edges 边. Uma adjacency list 邻接表 — um dict de listas de vizinhos — é uma forma comum de armazenar uma.
Um gráfico de vértices e arestas, em sua forma de lista de adjacência
graph = {"A": ["B", "D"], "B": ["A", "C"], "C": ["B", "D"], "D": ["A", "C"]}
for vertex in graph:
    print(vertex, "->", graph[vertex])
# A -> ['B', 'D']  (and so on for B, C, D)
Erros comuns
A stack é last-in-first-out; a queue é first-in-first-out. Não as misture.
Verifique se uma estrutura está vazia antes de pop ou dequeue dela.
Em uma lista encadeada, perder o ponteiro head perde toda a lista.
Um search 查找 encontra onde um valor está. Linear search 线性查找 verifica cada item por vez, então funciona em qualquer lista.
def linear_search(items, target):
    for i in range(len(items)):
        if items[i] == target:
            return i
    return -1     # not found

print(linear_search([4, 8, 2, 9], 2))   # 2
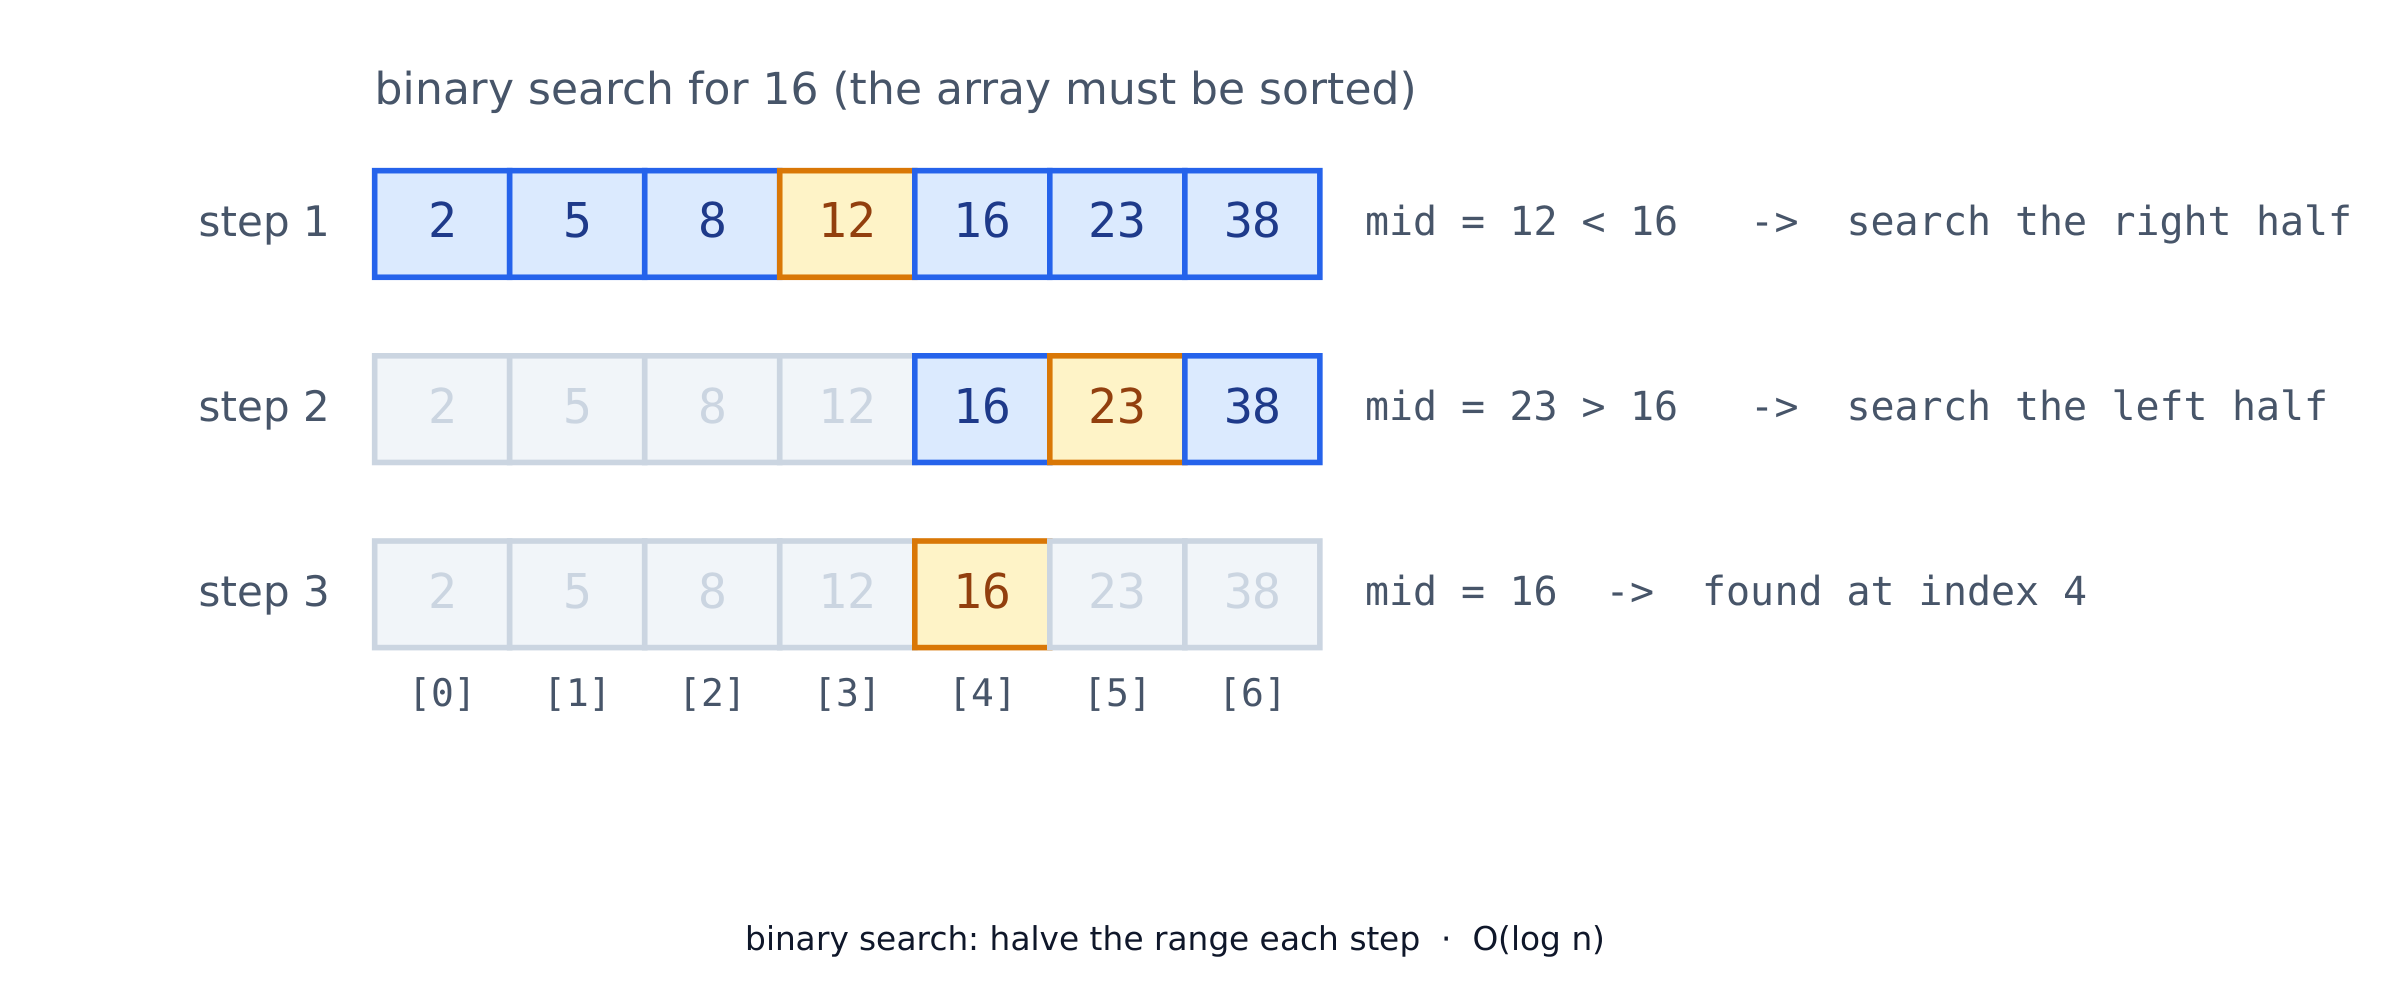
Binary search 二分查找 é muito mais rápido mas precisa de uma lista sorted. Ela divide o range pela metade a cada passo.
def binary_search(items, target):
    lo, hi = 0, len(items) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if items[mid] == target:
            return mid
        elif items[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

print(binary_search([1, 3, 5, 7, 9], 7))   # 3
A busca binária reduz o intervalo pela metade a cada etapa — O(log n) em uma lista ordenada
13.2
Ordenação (bubble & insertion)
Ordenar 排序 é colocar itens em ordem. Bubble sort 冒泡排序 troca repetidamente neighbours que estão na ordem errada.
def bubble_sort(a):
    a = a[:]                          # work on a copy
    for i in range(len(a)):
        for j in range(len(a) - 1 - i):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
    return a

print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
Insertion sort 插入排序 constrói uma parte sorted item por item, deslizando cada novo item de volta para seu lugar:
def insertion_sort(a):
    a = a[:]                           # work on a copy
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:   # shift bigger values right
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key                 # drop key into the gap
    return a

print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
Em código real, use o built-in Python sorted():
print(sorted([5, 2, 4, 1])) # [1, 2, 4, 5]
13.3
Eficiência algorítmica
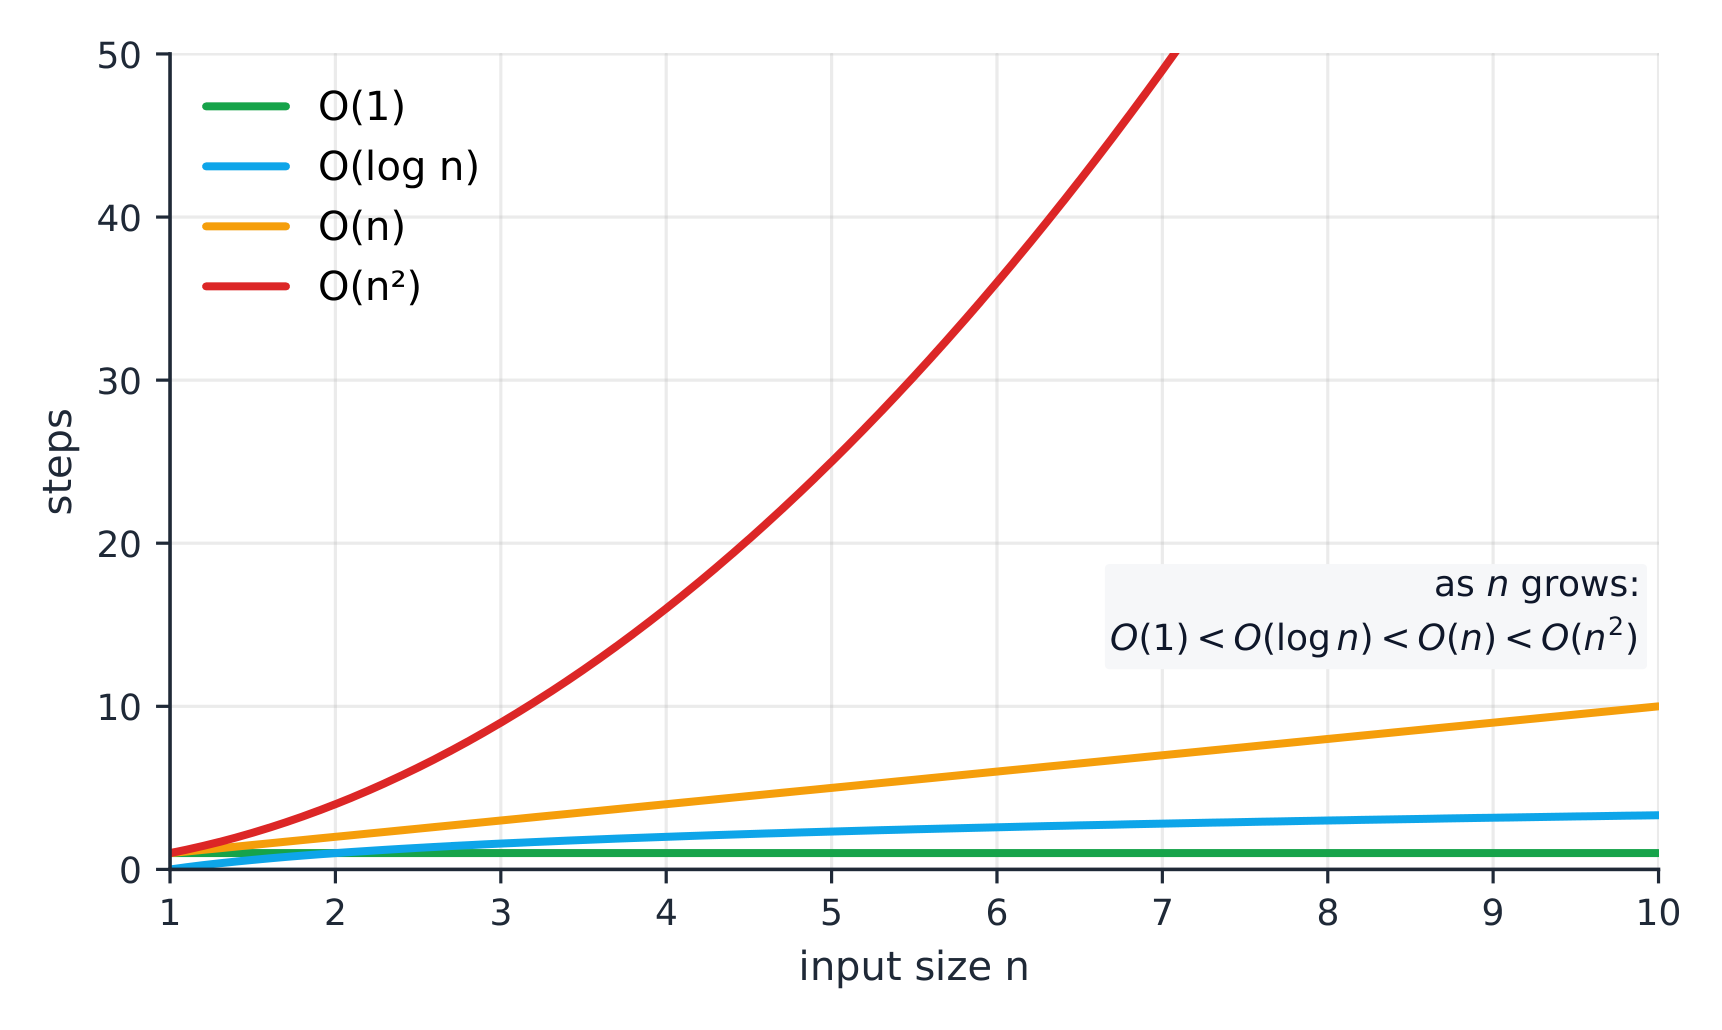
Eficiência 效率 pergunta como o trabalho cresce conforme a entrada cresce. Descrevemos isso com Big-O 大O记号.
Como o número de etapas cresce com o tamanho da entrada para complexidades comuns
Big-O
Nome
Exemplo
$O(1)$
constant
look up a dict key
$O(\log n)$
logarithmic
binary search
$O(n)$
linear
linear search
$O(n^2)$
quadratic
bubble sort
def steps(n):           # how many steps a linear scan takes
    count = 0
    for i in range(n):
        count = count + 1
    return count

print(steps(100))       # 100  -> O(n)
13.4
Aleatoriedade & simulação
O módulo random faz números aleatórios. Use um seed 种子 para tornar resultados reprodutíveis. Uma simulation 模拟 roda muitos trials aleatórios para estimar uma resposta.
import random
random.seed(0)
rolls = [random.randint(1, 6) for _ in range(1000)]
print(rolls.count(6))   # about 1/6 of 1000
Erros comuns
Binary search só funciona em uma lista sorted.
Big-O diz como o tempo CRESCE, não o tempo exato; um método O(n²) bate O(n) apenas para entradas minúsculas.
Bubble sort é O(n²) — bom para aprender, mas lento em listas grandes.
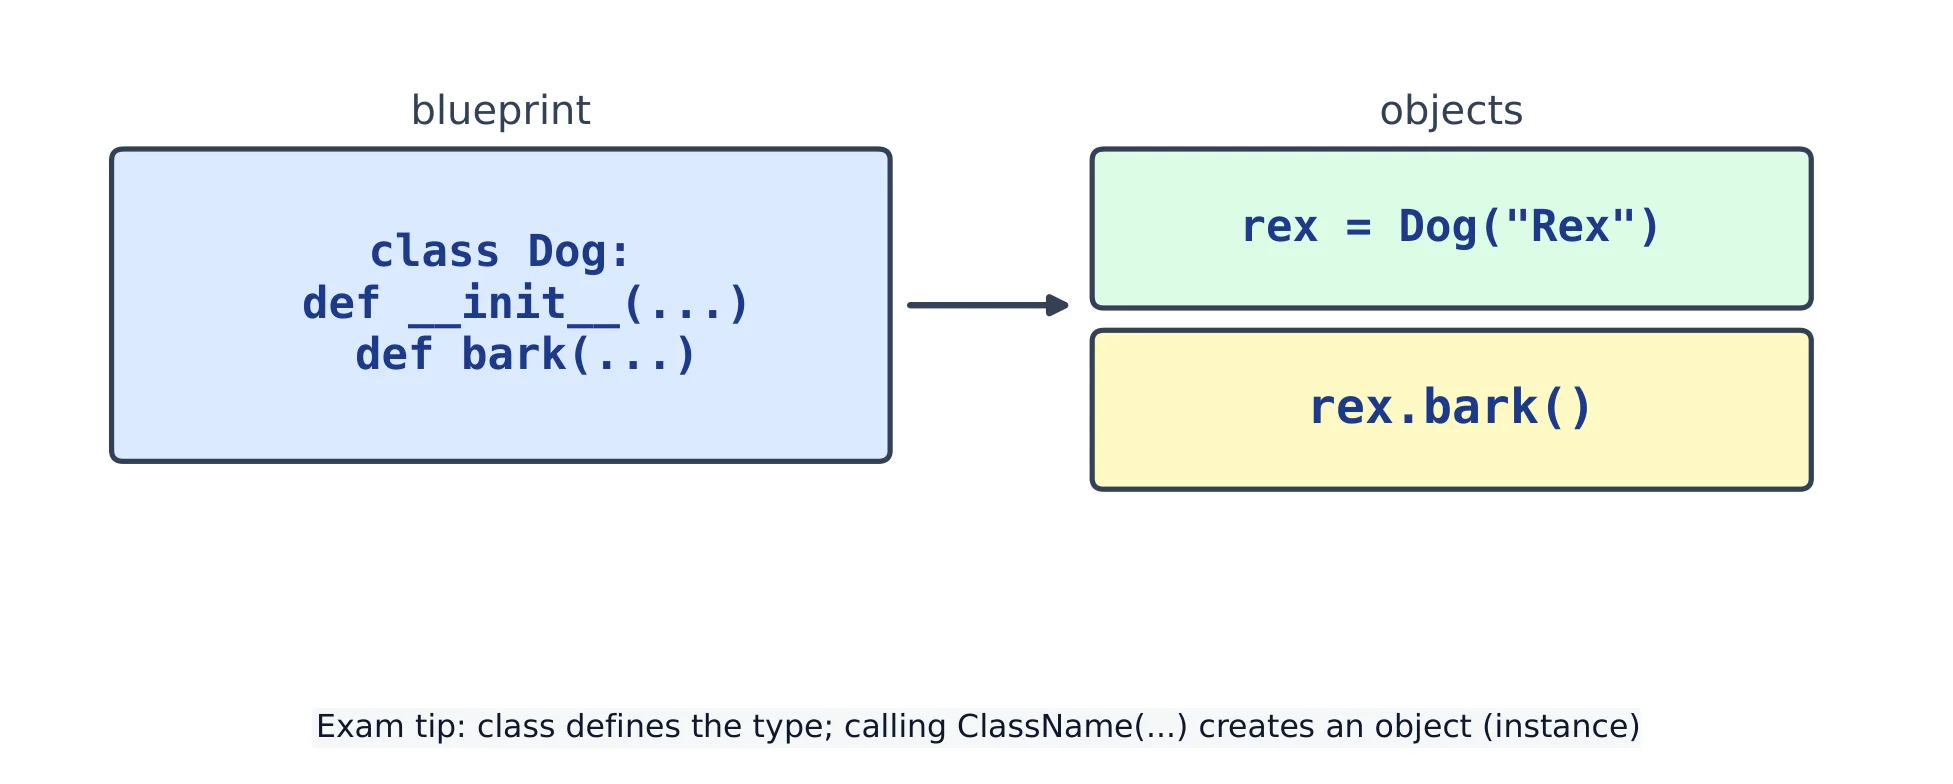
Uma classe é um modelo. Um objeto é uma instância construída a partir dele. __init__ é o construtor que configura cada objeto; self é o próprio objeto.
class Dog:
    def __init__(self, name):
        self.name = name            # an attribute
    def speak(self):
        return self.name + " says woof"

d = Dog("Rex")
print(d.speak())     # Rex says woof
name é um atributo (dados sobre o objeto); speak é um método (uma ação).
Adicione __str__ para controlar o que print(obj) mostra:
class Dog:
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return f"Dog named {self.name}"

print(Dog("Rex"))    # Dog named Rex
Uma classe é um modelo; chamá-la cria um objeto
14.2
Herança, encapsulamento & polimorfismo
A herança permite que uma subclasse reutilize uma superclasse. Use super() para chamar o pai; sobrescreva um método para alterá-lo.
class Animal:
    def speak(self):
        return "some sound"

class Cat(Animal):
    def speak(self):                # override
        return "meow"

print(Cat().speak())   # meow
O encapsulamento agrupa dados com métodos e expõe uma interface pretendida. No Python, um sublinhado inicial marca um nome não público (frequentemente chamado de privado) conforme convenção; ele não impede que código externo acesse. A demanglação de nomes com duplo sublinhado inicial ajuda a evitar colisões acidentais entre subclasses, não a garantir segurança.
class Account:
    def __init__(self):
        self._balance = 0           # non-public by convention
    def deposit(self, n):
        self._balance += n
    def balance(self):
        return self._balance

a = Account()
a.deposit(50)
print(a.balance())     # 50
Polimorfismo significa um mesmo nome, muitos comportamentos — o speak correto é executado para cada objeto.
class Cat:
    def speak(self):
        return "meow"

class Cow:
    def speak(self):
        return "moo"

for animal in [Cat(), Cow()]:
    print(animal.speak())   # meow, then moo
14.3
Paradigmas de programação
Um paradigma é um estilo de escrita de programas. Código procedural é uma sequência de passos e funções. Código orientado a objetos agrupa dados e métodos em objetos. Código declarativo diz o que você quer, não como (uma list comprehension ou SQL).
def total(nums):           # procedural
    t = 0
    for n in nums:
        t += n
    return t
print(total([1, 2, 3]))    # 6

print(sum([1, 2, 3]))      # 6  (declarative: same result)
Erros comuns
Todo method precisa de self como seu primeiro parâmetro.
__init__ configura um novo objeto e roda automaticamente quando você cria um.
Dois objects da mesma class têm attributes separados; alterar um não altera o outro.
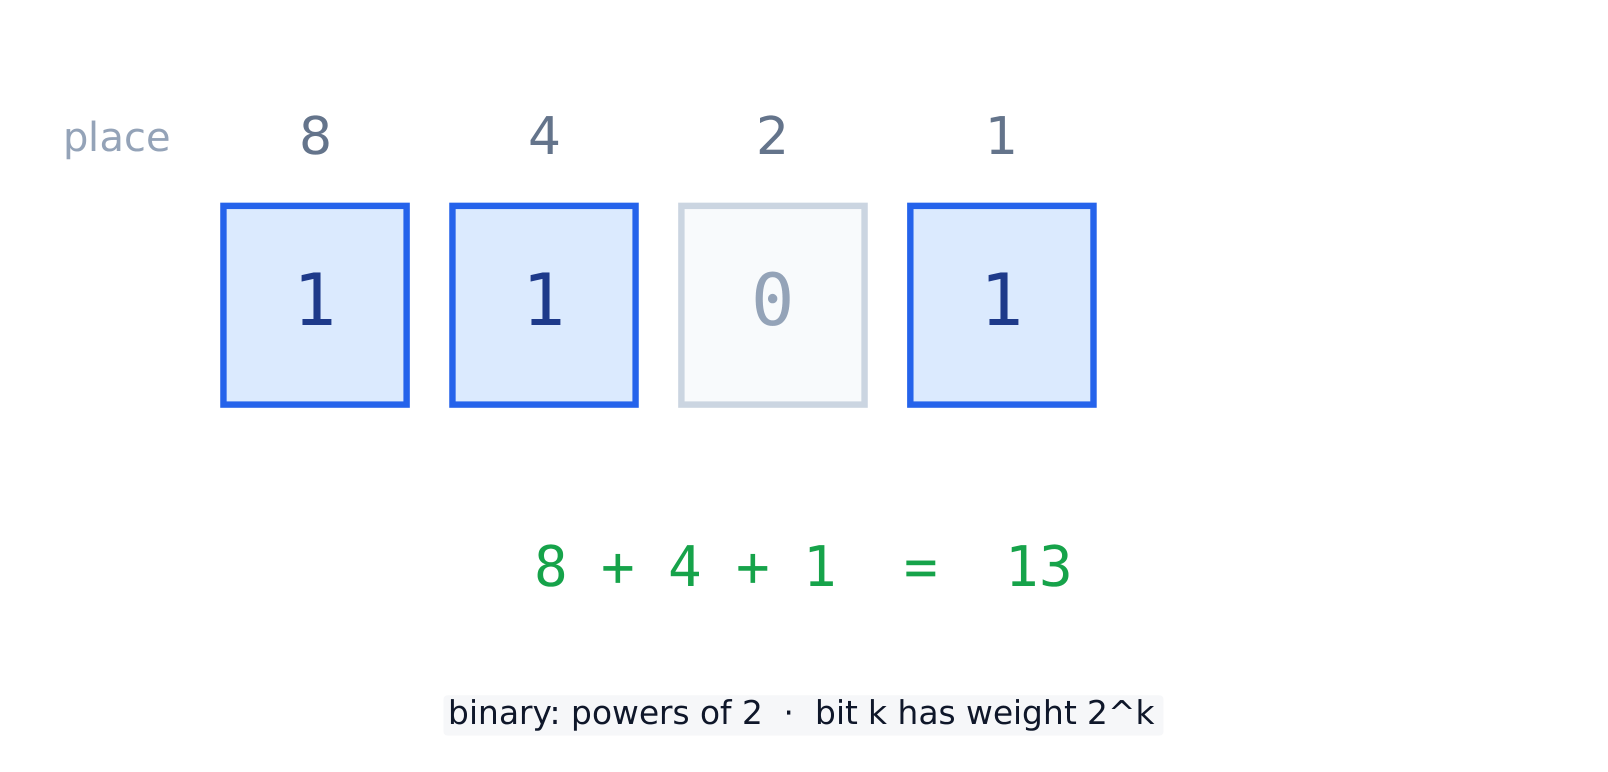
Um bit 比特 é um único 0 ou 1. Binário 二进制 é o sistema numérico base-2: cada posição vale o dobro da anterior à direita (1, 2, 4, 8, …). Decimal 十进制 (base-10) são nossos números normais.
Compression 压缩 torna dados menores. Lossless 无损 compression mantém todos os bits, então você reconstrói o original exatamente. Lossy 有损 compression joga fora detalhes — menor mas não exato — e é usado para fotos e música.
Run-length encoding 游程编码 é um método lossless simples: armazene um run 游程 (uma repetição) como um count mais o value.
def rle(text):
    out = ""
    i = 0
    while i < len(text):
        run = 1
        while i + run < len(text) and text[i + run] == text[i]:
            run += 1
        out += str(run) + text[i]
        i += run
    return out

print(rle("AAAABBBCCD"))   # 4A3B2C1D
Erros comuns
n bits armazenam 2**n valores diferentes, de 0 até 2**n - 1.
Lossy compression joga fora detalhes e não pode ser desfeito; lossless pode ser revertido exatamente.
Computação 计算 significa resolver problemas com computadores: input, process, output. Good software é construído em um design cycle 设计循环 — plan, write, test, improve — repetidas muitas vezes.
Quebre um problema, construa uma parte pequena, teste-a, depois adicione mais.
Programadores trabalham em equipe e reutilizam o código uns dos outros.
16.2
A Internet
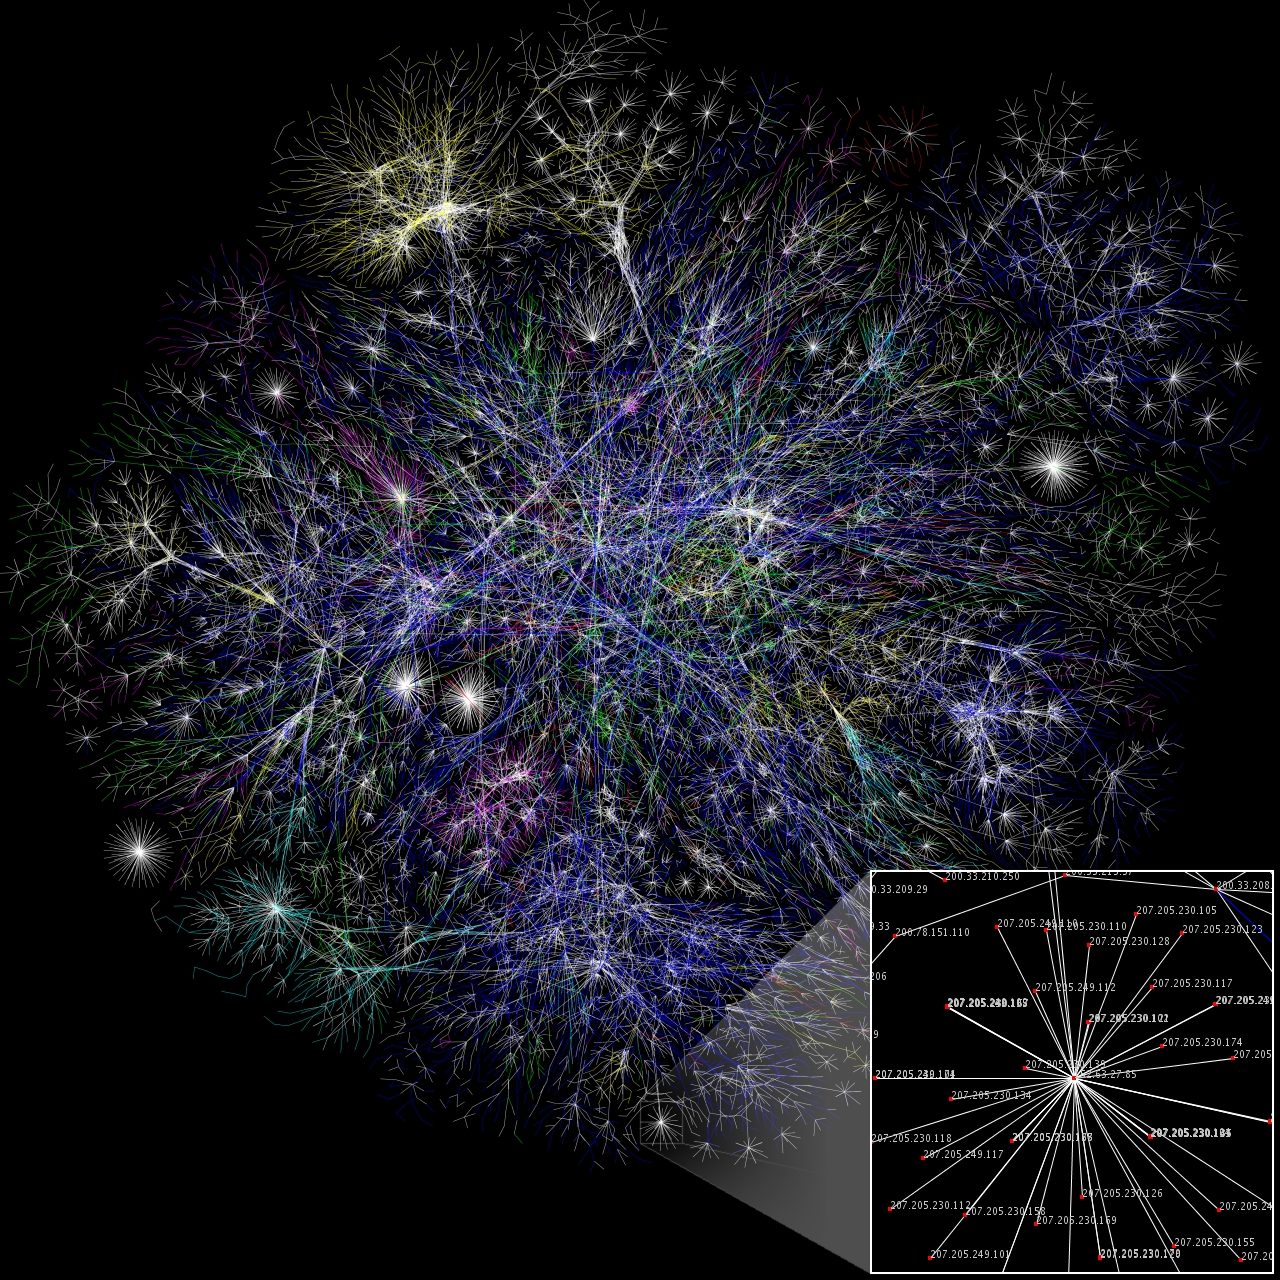
A Internet 互联网 es una red de redes. Los datos se dividen en paquetes 数据包 que viajan por separado y se recombinan en el otro extremo. Las reglas compartidas llamadas protocolos 协议 (como TCP/IP) hacen esto posible. Si un camino se interrumpe, los paquetes toman otra ruta: esto es redundancia 冗余, lo que proporciona tolerancia a fallos 容错.
Un mapa de la Internet: cada línea es un camino entre dos redes
Capa
Tarea
HTTP
solicitar y enviar páginas web
TCP
entrega confiable, en orden
IP
direccionamiento y enrutamiento
16.3
Cómputo paralelo y distribuido
El código secuencial 顺序 realiza un paso a la vez. El cómputo paralelo 并行 realiza varios pasos a la vez en muchos núcleos 核心, lo que puede proporcionar aceleración 加速. El cómputo distribuido 分布式 reparte el trabajo entre muchas computadoras, como en la nube.
No todo puede ejecutarse en paralelo: algunos pasos deben esperar un resultado anterior.
16.4
Impacto del cómputo
El cómputo trae tanto beneficios como perjuicios. La brecha digital 数字鸿沟 significa que no todos tienen acceso igualitario a él. El software puede transportar sesgo 偏见 proveniente de los datos con los que aprende. Respetar la propiedad intelectual 知识产权 (licencias), y proteger los datos personales 个人数据 y la privacidad 隐私 de las personas.
Erros comuns
La Internet y la World Wide Web no son lo mismo: la Web es un servicio que se ejecuta sobre la Internet.
Más núcleos de procesador ayudan solo si el trabajo puede dividirse en partes que se ejecuten al mismo tiempo.
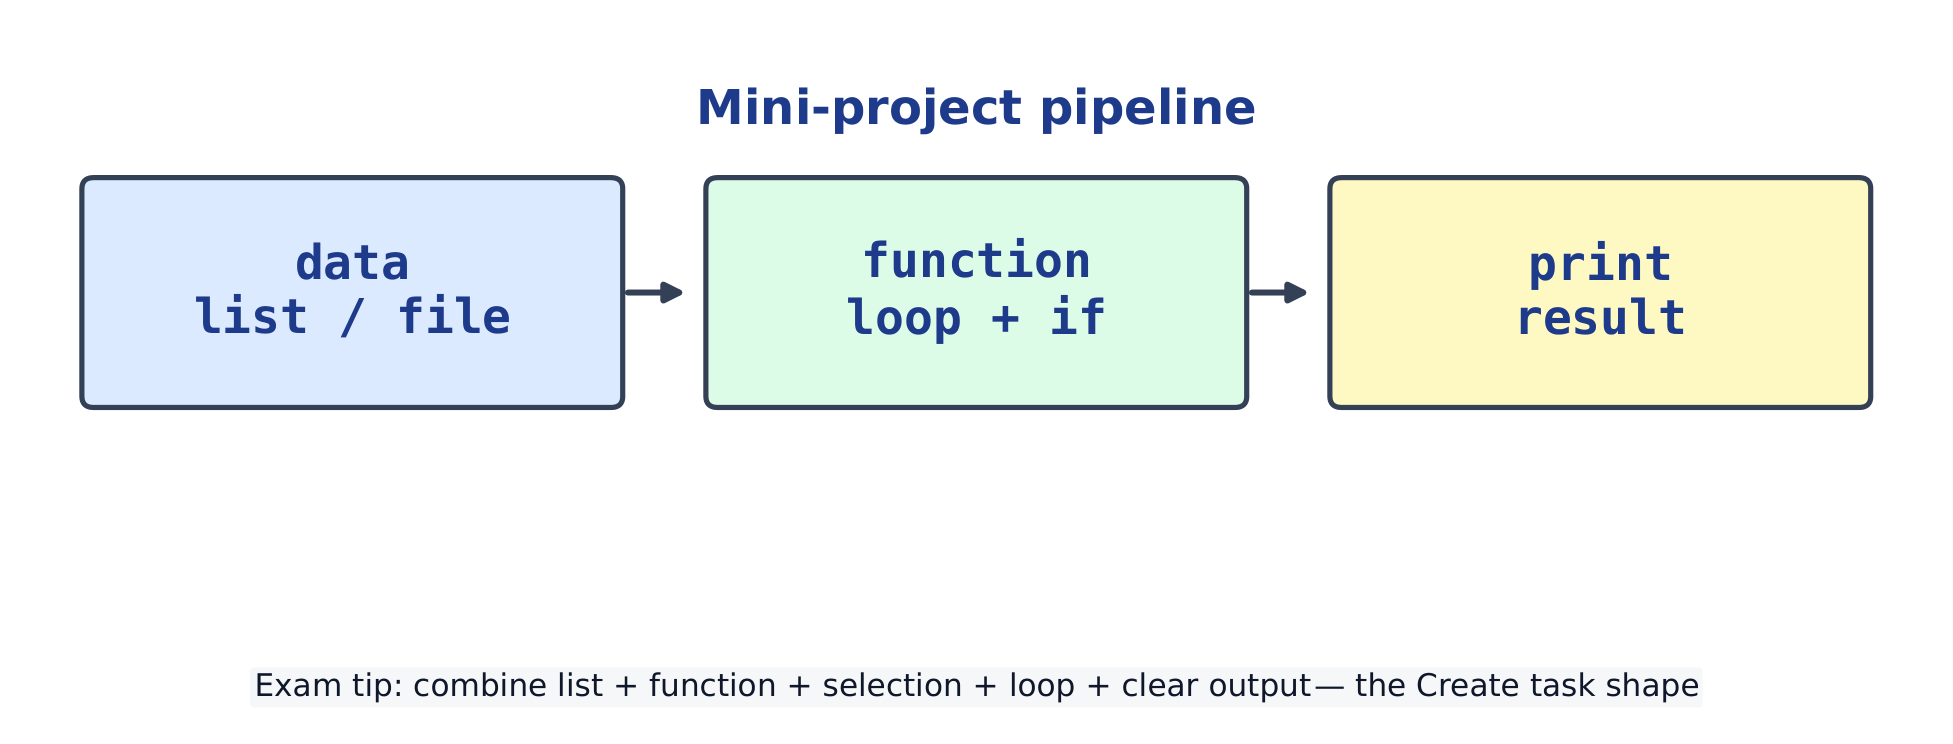
Un mini-proyecto 小项目 combina ideas anteriores: datos en una lista, una función con selección dentro de un bucle, y salida impresa. Esta también es la estructura de la Tarea de Rendimiento AP Create.
def count_passes(marks, pass_mark=60):
    passes = 0
    for m in marks:                 # iteration
        if m >= pass_mark:          # selection
            passes += 1
    return passes

print(count_passes([88, 50, 95, 60]))   # 3
Proyecto: filtrar a una nueva lista
def merit(marks):
    return [m for m in marks if m >= 80]

print(merit([88, 71, 95, 60]))     # [88, 95]
La Tarea AP Create pide una lista, un procedimiento parametrizado 过程 que use selección 选择 e iteración 迭代, y alguna entrada/salida. Cada proyecto arriba tiene exactamente esa forma: construya piezas pequeñas y luego únalas.
Erros comuns
Construya en pasos pequeños y pruebe cada parte antes de continuar; no escriba todo de una vez.
Lea toda la tarea primero, luego planifique la entrada → proceso → salida antes de codificar.
Mini-proyecto: datos → función → resultado impreso