본문 바로가기
과목
  • 1 초기 설정
    1.1

    첫 번째 프로그램

    Python은 코드를 줄 단위로 순차적으로 실행합니다. 각 줄은 명语句(statement)이며, 프로그램은 위에서 아래로 실행되는 명语句들의 목록일 뿐입니다.

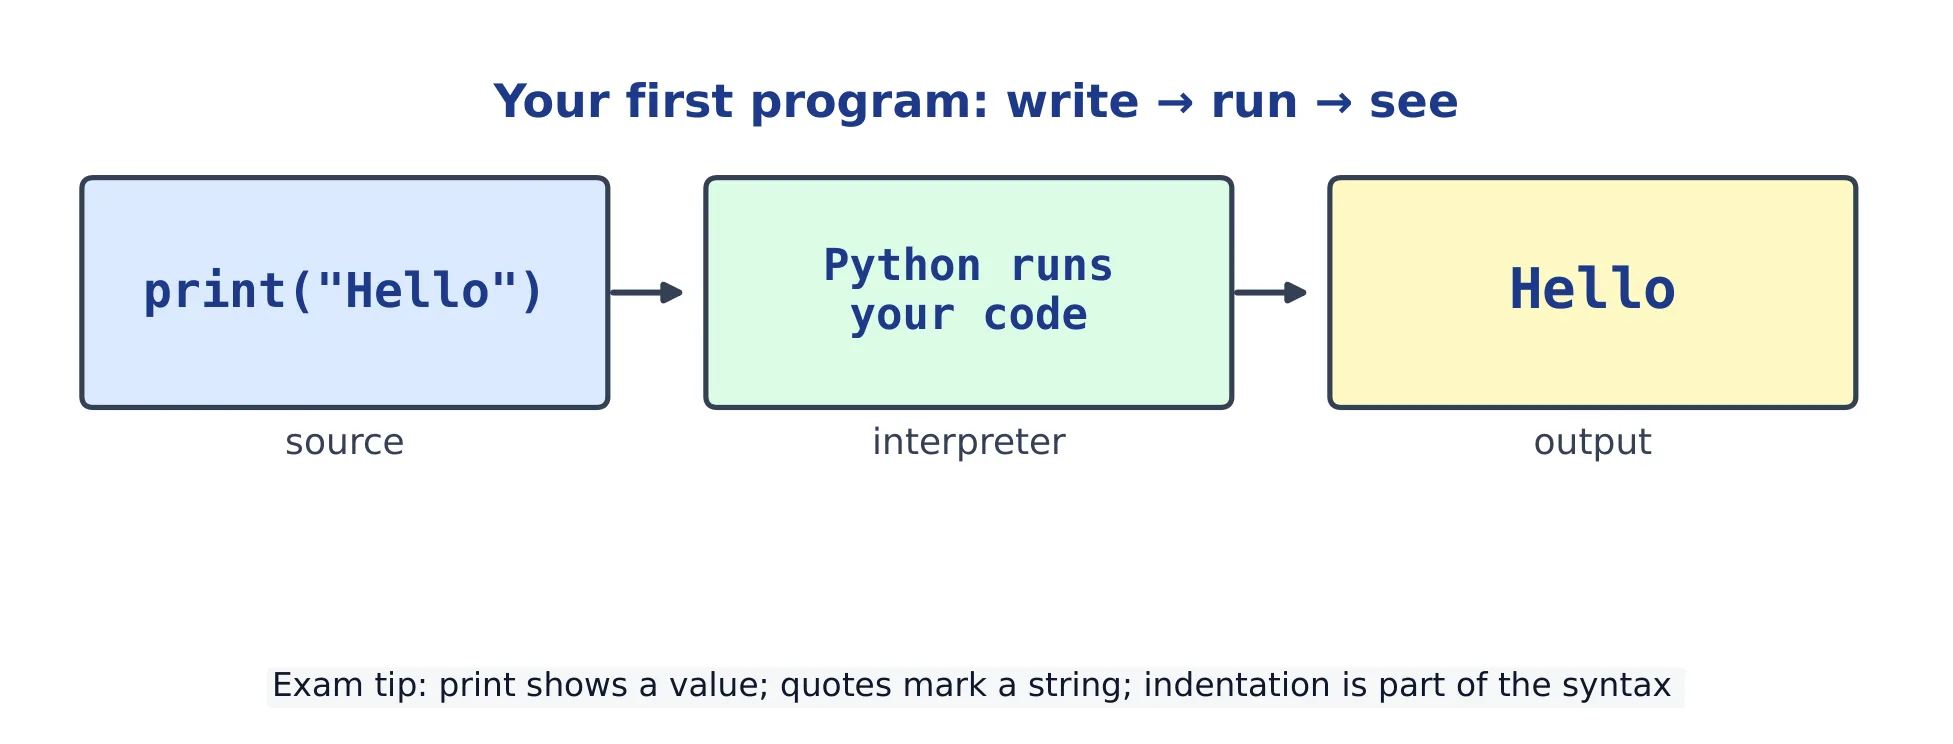
    print() 함수는 화면에 텍스트를 출력합니다. 이를 출력(output)이라고 합니다. 따옴표로 둘러싸인 텍스트는 문자열(string)입니다.

    print("Hello, world!")
    print("I am learning Python")
    
    • 각 print()는 새 줄을 시작합니다.
    • 따옴표는 "double" 또는 'single'일 수 있으며, 둘 다 문자열을 만듭니다.
    • 실행하지 않으면 프로그램은 아무것도 하지 않습니다.
    소스 코드가 인터프리터를 거쳐 출력을 생성함
    소스 코드가 인터프리터를 거쳐 출력을 생성함
    1.2

    주석 및 코드 스타일

    주석은 #로 시작합니다. Python은 해당 줄의 # 뒤에 오는 모든 것을 무시합니다. 주석은 코드를 사람들에게 설명하기 위한 것이지, 코드의 동작을 변경하지는 않습니다.

    # This line is a note for humans
    print("Hi")        # you can also comment at the end of a line
    

    좋은 스타일은 코드를 읽기 쉽게 만듭니다:

    • 값의 의미를 명확히 나타내는 이름을 사용하세요.
    • 한 줄에 하나의 문장을 작성하세요.
    • 일반 줄의 시작에 공백을 추가하지 마세요. Python에서 시작 부분의 간격(들여쓰기)은 특별한 의미를 가지므로, 잘못된 공백은 오류를 발생시킵니다.
    1.3

    입력, 처리, 출력

    대부분의 프로그램은 간단한 계획에 따릅니다: 입력 → 처리 → 출력. 데이터를 받아서 어떤 작업을 수행한 후 결과를 표시합니다.

    input() 함수는 사용자가 입력한 텍스트를 읽습니다. 항상 문자열을 반환합니다.

    name = input("What is your name? ")
    print("Hello, " + name)
    
    • input()는 사용자가 입력하고 Enter 키를 누를 때까지 대기합니다.
    • 입력한 텍스트를 변수에 저장하여 나중에 사용할 수 있게 하세요.
    • input()가 문자열을 반환하므로, 숫자가 필요한 경우 먼저 int(...)로 변환해야 합니다.

    Common mistakes

    • 따옴표 누락: print(Hello)는 Hello라는 이름의 변수를 찾으려 하여 NameError를 발생시킵니다. 텍스트에는 따옴표가 필요합니다: print("Hello").
    • 줄의 시작 부분에 여분의 공백이 있는 경우: Python은 들여쓰기를 구조로 해석하므로 IndentationError를 발생시킵니다.
    • input()가 숫자를 반환한다고 가정함. 항상 문자열을 반환하므로 수학 연산 전에 int(...)로 감싸야 합니다.
  • 2 변수, 타입 및 연산자
    2.1

    변수 및 할당

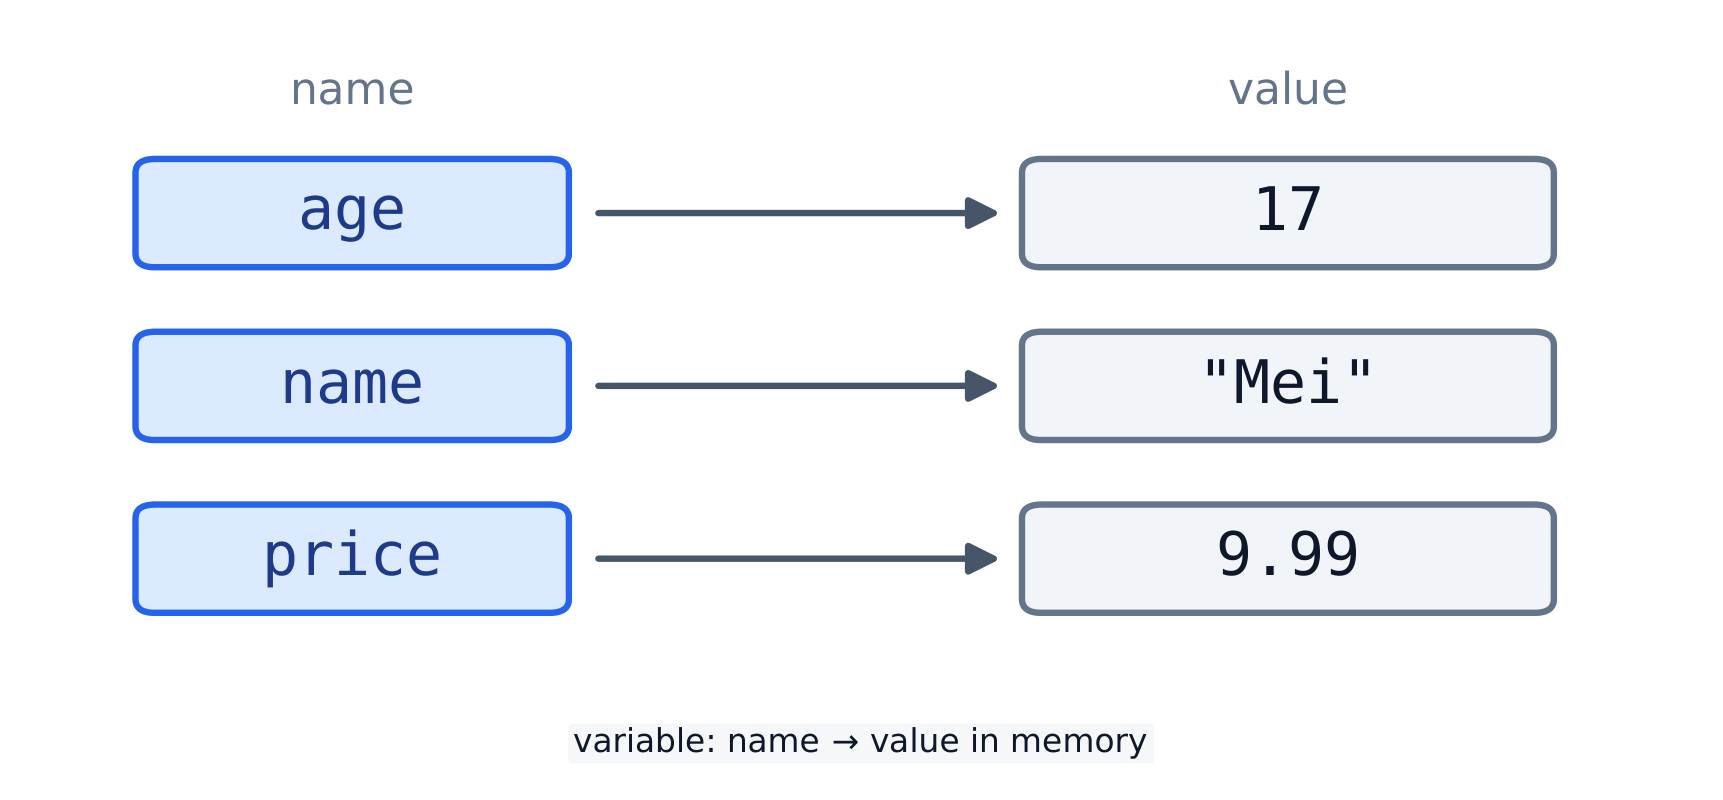
    변수는 값에 붙여 놓은 이름입니다. =를 사용하여 만들며, 이를 할당이라고 부릅니다. 이름은 왼쪽에, 값은 오른쪽에 배치합니다.

    age = 17
    name = "Mei"
    price = 9.99
    print(age, name, price)
    

    이제 age에 17이 저장되었습니다. 값이 필요한 곳에서 이 이름을 사용하고 나중에 변경할 수 있습니다:

    age = 17
    age = age + 1   # age is now 18
    print(age)
    
    변수는 저장된 값에 연결된 이름입니다
    각 변수명은 메모리 상의 값으로 가리킵니다
    • = 기호는 '같다'는 뜻이 아닙니다. '오른쪽을 왼쪽 이름 아래에 저장한다'는 의미입니다.
    • 두 값이 같은지 테스트하려면 ==를 사용하세요(아래 참고).
    2.2

    숫자: int & float

    Python에는 두 가지 주요 숫자 유형이 있습니다. 정수(int, int)는 17와 같은 전체 수입니다. 부동소수점(float, float)는 소수점이 있는 9.99과 같습니다.

    이 연산자는 숫자에 작동합니다:

    연산자 의미 예제 결과
    + 더하기 3 + 2 5
    - 빼기 3 - 2 1
    * 곱하기 3 * 2 6
    / 나누기 (항상 부동소수점) 7 / 2 3.5
    // 정수 나눈 나머지 7 // 2 3
    % 나머지 (모듈로) 7 % 2 1
    ** 제곱 2 ** 3 8
    • /는 항상 부동소수점을 제공하므로, 4 / 2은 2.0입니다.
    • //와 %은 함께 사용됩니다: 17 // 5은 3이며, 17 % 5은 2입니다.
    2.3

    식 및 타입 변환

    식(value를 가지는 것)은 3 + 4 * 2와 같습니다. Python은 일반적인 수학 순서를 사용합니다(*과 /이 +과 -보다 먼저); 순서를 명확히 하기 위해 괄호를 추가하세요.

    input()는 문자열을 반환하므로 수학 연산 전에 변환해야 합니다. 값을 한 타입에서 다른 타입으로 바꾸는 것을 타입 변환이라고 합니다:

    age = int("17")        # text "17" -> number 17
    price = float("9.99")  # text -> 9.99
    label = str(17)        # number -> text "17"
    print(age, price, label)
    
    • int("abc")는 실패하므로, 숫자처럼 보이는 텍스트만 변환하세요.
    • 타입을 섞는 것도 실패합니다: "age: " + 17은 오류입니다; "age: " + str(17)을 작성하십시오.
    2.4

    부울린 및 비교

    부울린(Boolean)은 오직 두 가지 값 중 하나인 True 또는 False입니다. 비교 연산은 부울린을 반환합니다.

    연산자 뜻
    == 같다
    != 다르다
    < > 작음 / 큼
    <= >= 작거나 같음 / 크거나 같음
    print(7 > 2)        # True
    print(3 == 3.0)     # True
    age = 20
    print(age >= 18)    # True
    

    비교를 and, or, not으로 연결하세요:

    age = 20
    print(age >= 13 and age <= 19)   # True only for a teenager
    

    Common mistakes

    • /는 항상 부동소수점을 반환하므로, Even if 4 / 2 is 2.0. 정수가 필요한 경우 //을 사용하세요.
    • =을 ==이 필요한 곳에 사용: =은 값을 할당하고, ==은 두 값이 같은지 테스트합니다.
    • 문자열과 숫자를 결합하는 경우: "age: " + 5는 TypeError를 발생시킵니다. 먼저 str(5)로 변환하세요.
    • 부동소수점은 정확하지 않으므로, 0.1 + 0.2는 정확히 0.3이 아닙니다 — 부동소수점 결과에 ==을 피하세요.
  • 3 문자열
    3.1

    인덱싱

    문자열은 따옴표 안의 텍스트입니다. 각 문자에는 위치가 있으며 이를 인덱스라고 합니다. 첫 번째 인덱스는 0이며, 1이 아닙니다.

    사각 괄호를 사용하여 한 문자를 읽으세요:

    word = "Python"
    print(word[0])    # P  (the first character)
    print(word[2])    # t
    print(len(word))  # 6  (how many characters)
    
    • 카운팅은 0에서 시작하므로, 마지막 인덱스는 len(word) - 1입니다.
    • 음수 인덱스는 끝에서 역순으로 세는 것입니다: word[-1]는 마지막 문자입니다.
    word = "Python"
    print(word[-1])   # n
    print(word[-2])   # o
    
    • 너무 큰 인덱스는 오류(An IndexError)를 발생시킵니다.
    s[start:stop]는 문자의 반개방 창(half-open window)입니다
    s[start:stop]는 문자의 반개방 창(half-open window)입니다
    3.2

    슬라이싱

    슬라이스(slice)는 문자열의 일부를 가져옵니다. word[start:end]를 작성하세요. 슬라이스는 start을 유지하지만 end 이전에 멈춥니다.

    word = "Python"
    print(word[0:3])   # Pyt   (positions 0, 1, 2)
    print(word[2:5])   # tho
    
    • start를 생략하면 0에서 시작하고, end을 생략하면 끝까지 갑니다.
    word = "Python"
    print(word[:3])    # Pyt
    print(word[3:])    # hon
    
    • 세 번째 숫자는 단계(step)입니다. word[::-1]는 문자열을 뒤집습니다.
    print("Python"[::-1])   # nohtyP
    
    3.3

    문자열 메서드 및 길이

    메서드는 값에 속한 함수입니다. 점(.)을 사용하여 호출합니다:

    name = "mei chen"
    print(name.upper())     # MEI CHEN
    print(name.title())     # Mei Chen
    print(len(name))        # 8
    

    문자열은 불변(immutable)합니다: 메서드는 새로운 문자열을 반환하며 원본을 변경하지 않습니다.

    name = "mei"
    print(name.upper())     # MEI  (the returned value)
    print(name)             # mei  (the original is unchanged)
    

    일반적인 메서드(각각 새로운 값을 반환):

    메서드 의미 예제 결과
    .upper() / .lower() 대소문자 변경 "Hi".lower() hi
    .strip() 양쪽 공간 제거 " hi ".strip() hi
    .replace(a, b) 텍스트 스왑 "cat".replace("c", "b") bat
    .split(sep) 목록으로 분할 "a,b".split(",") ['a', 'b']

    +로 문자열을 결합하세요. 이를.Method concatenation이라고 합니다:

    first = "Mei"
    last = "Chen"
    print(first + " " + last)   # Mei Chen
    
    3.4

    f-strings

    f-string은 값을 바탕으로 텍스트를 생성한다. 인용부호 앞에 f을 넣고 그 안에 값 주변에 {...}을 씌운다.

    name = "Mei"
    age = 17
    print(f"{name} is {age} years old")   # Mei is 17 years old
    
    • braces 내부에 어떤 식이나 expression도 올릴 수 있습니다.
    • {value:.2f}은 소수점 2 자리로 반올림합니다.
    price = 9.5
    print(f"Two cost {price * 2}")        # Two cost 19.0
    print(f"Pi is about {3.14159:.2f}")   # Pi is about 3.14
    

    Common mistakes

    • 문자열은 in-place으로 변경할 수 없습니다: s[0] = "x"는 오류를 발생시킵니다. 대신 새 문자열을 만드세요.
    • 인덱싱은 0에서 시작하며, 마지막 문자는 s[-1]이고, s[len(s)]은 범위를 벗어납니다.
    • 슬라이스 s[a:b]는 a을 포함하지만 b 이전에 멈춥니다.
    • 문자열 메서드는 NEW 문자열을 반환합니다:Unless you store the result, s.upper() does nothing.
  • 4 선택(Selection)
    4.1

    if / elif / else

    프로그램은 if에 대해 무엇을 할지 결정합니다. 조건이 참일 때만 들여쓰기된 블록을 실행합니다. if 줄은 콜론(:)로 끝납니다.

    score = 72
    if score >= 60:
        print("pass")
    # pass
    

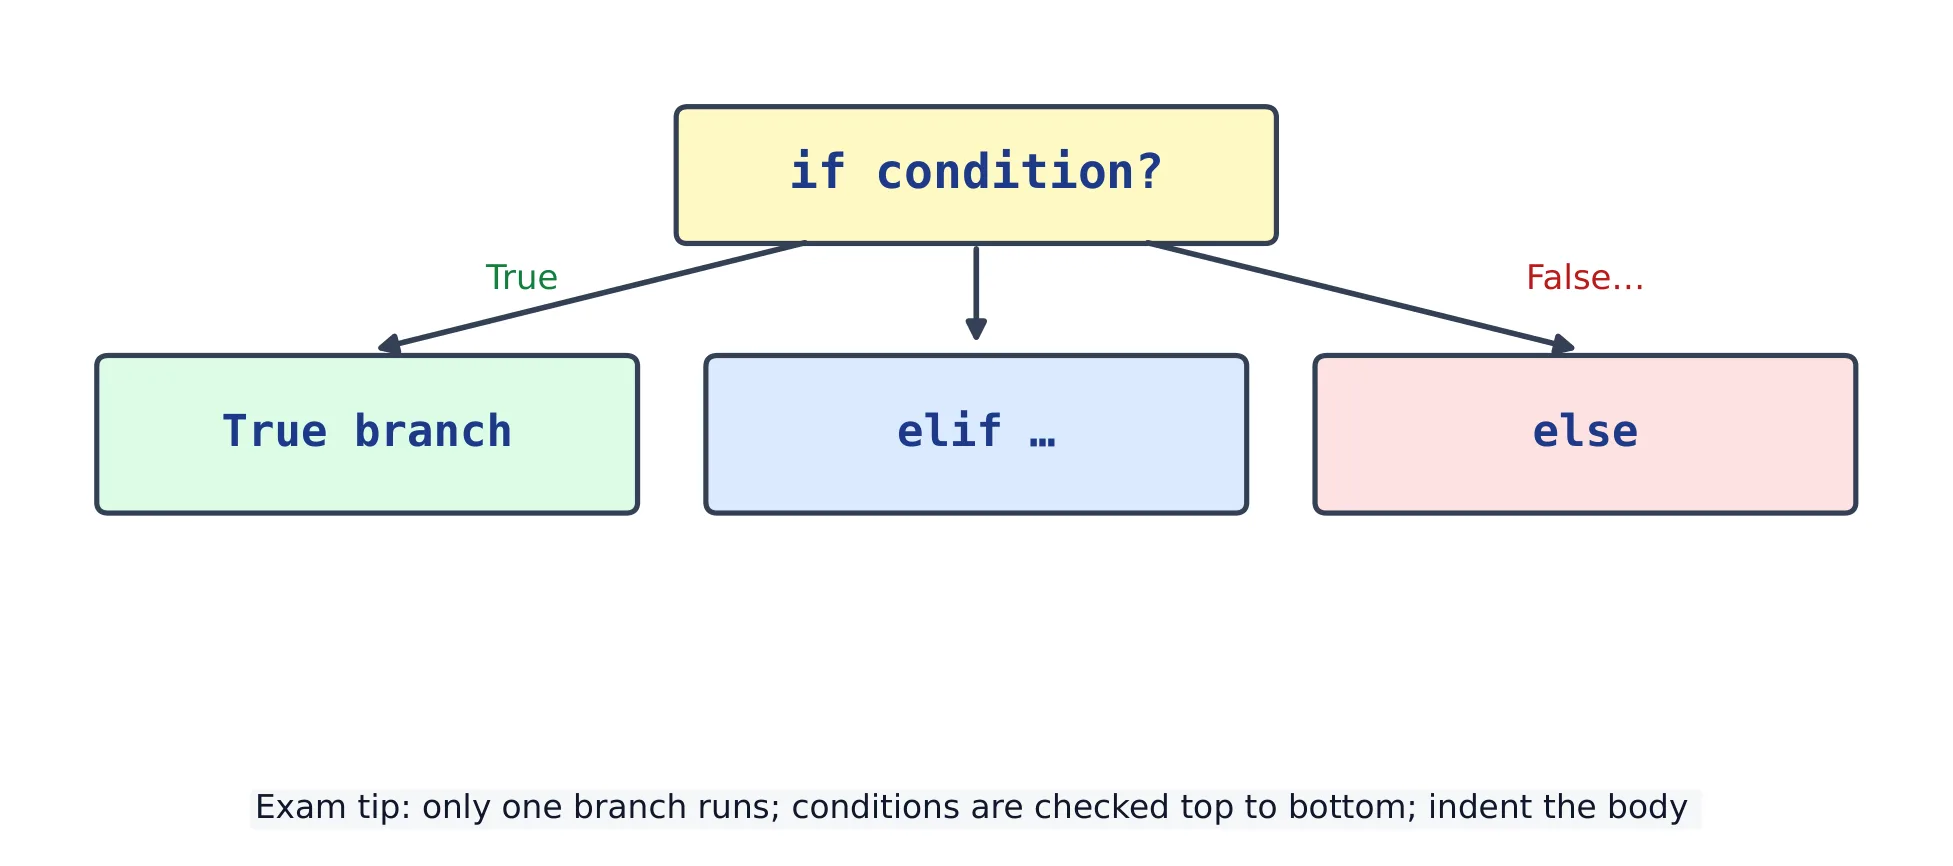
    더 많은 경우를 위해 elif(else-if)을 추가하고, "그 외의 모든 것"을 위해 else을 추가하세요. Python은 처음 참인 분기만 실행한 후 나머지는 건너뜁니다.

    score = 72
    if score >= 80:
        print("A")
    elif score >= 60:
        print("B")
    else:
        print("fail")
    # B
    
    • ==(같음), !=(다름), <, >, <=, >=으로 값을 비교하세요.
    • 비교 연산은 부울리(Boolean) 결과를 줍니다—either True 또는 False.
    if / elif / else: 하나의 분기만 실행됨
    if / elif / else: 하나의 분기만 실행됨
    4.2

    조건 결합하기

    조건을 and, or, not으로 연결하세요. and은 양쪽이 참이어야 하고; or은 어느 한쪽이 참이면 되며; not은 부울리를 반전시킵니다.

    age = 16
    has_ticket = True
    if age >= 18 and has_ticket:
        print("entry allowed")
    else:
        print("entry refused")
    # entry refused
    
    • 순서를 명확하게 하기 위해 괄호를 사용하세요: (a or b) and c.
    temp = 30
    if temp > 25 and not temp > 35:
        print("warm but ok")
    # warm but ok
    

    Common mistakes

    • elif을 입력하고, else if은 입력하지 마십시오.
    • 모든 if / elif / else 줄은 콜론 :으로 끝나며, 본체는 들여쓰기되어야 합니다.
    • if x = 5:은 오류입니다. 비교할 때는 ==을 사용하십시오.
    • else은 조건을 받지 않습니다. 조건이 필요한 것은 오직 if과 elif뿐입니다.
  • 5 반복(Iteration)
    5.1

    for 루프와 range

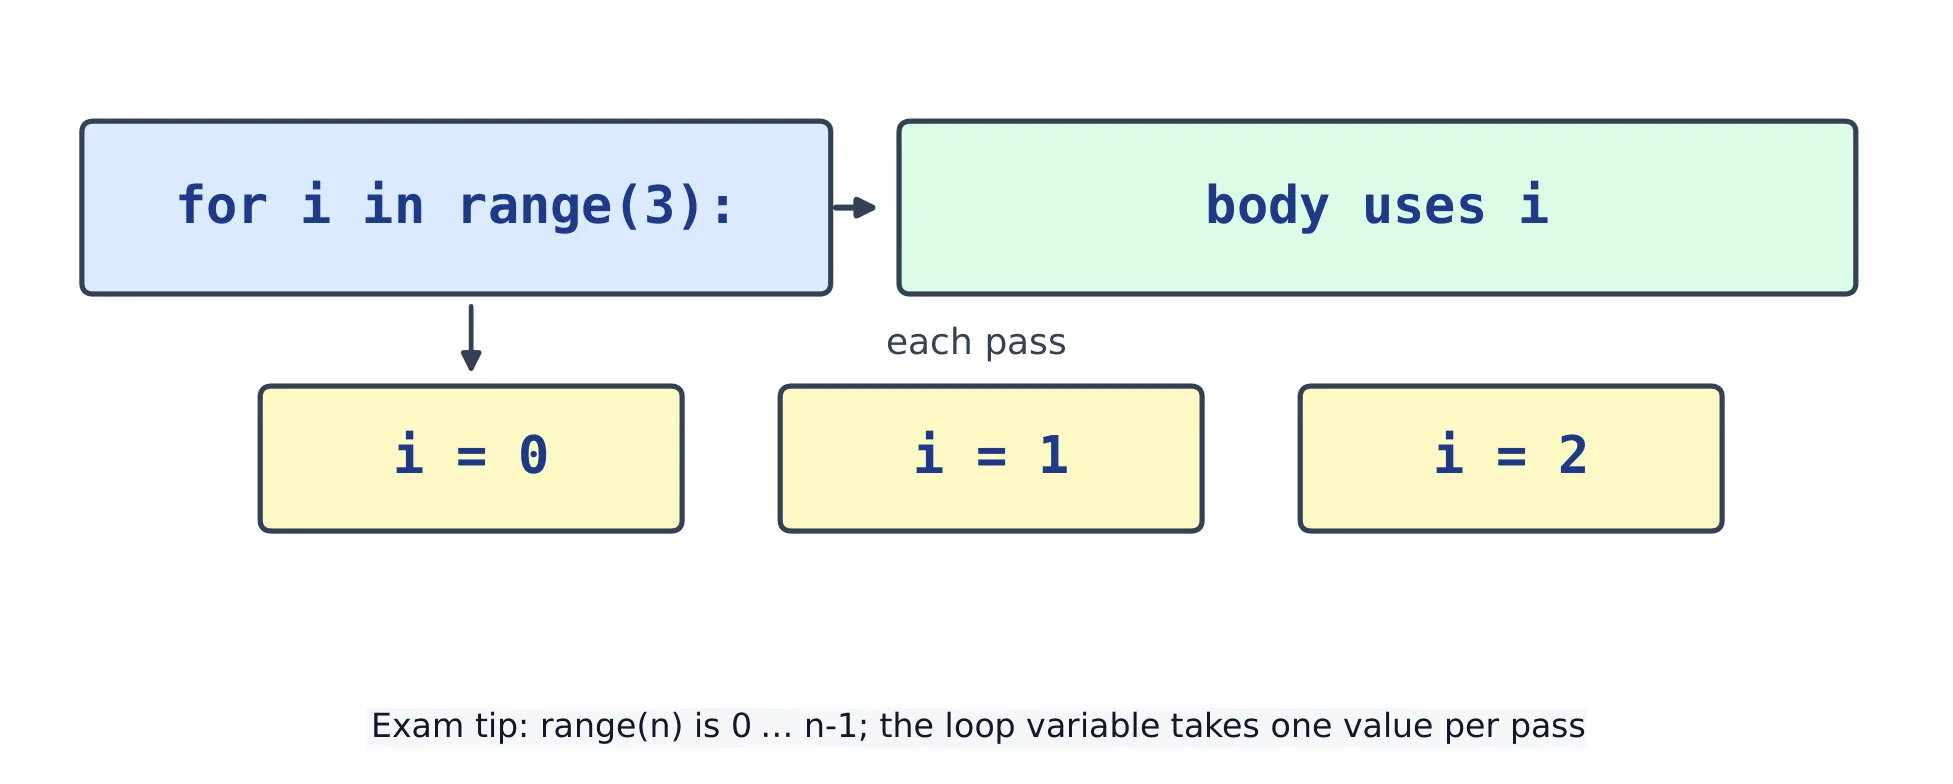
    루프는 코드를 반복합니다. for 루프는 시퀀스의 각 항목에 대해 한 번씩 반복됩니다. range(n)은 숫자 0부터 n - 1까지 제공합니다.

    for i in range(5):
        print(i)
    # 0, then 1, 2, 3, 4 (each on its own line)
    
    • range(a, b)은 a에서 시작하여 (포함하지 않고) b까지 갑니다.
    • range(a, b, step)은 매번 간격(step)을 추가합니다.
    for n in range(2, 11, 2):
        print(n)        # 2 4 6 8 10
    
    for i in range(n): body는 i = 0 … n-1로 실행됩니다
    for i in range(n): body는 i = 0 … n-1로 실행됩니다
    5.2

    accumulator 패턴

    루프를 통해 결과를 구축하려면 루프 전에 변수를 시작하고, 매 순환마다 업데이트하십시오. 이것이 accumulator 패턴입니다.

    total = 0
    for n in range(1, 6):
        total = total + n
    print(total)        # 15
    
    • 같은 원리는 테스트에 부합하는 항목의 개수를 세는 데도 적용됩니다.
    count = 0
    for letter in "banana":
        if letter == "a":
            count = count + 1
    print(count)        # 3
    
    5.3

    while 루프

    while 루프는 조건이 참인 한 반복합니다. 내부에서 무언가를 변경하지 않으면, 멈추지 않습니다 — 무한 루프가 됩니다.

    n = 1
    while n <= 3:
        print(n)
        n = n + 1
    # 1 2 3
    
    • break은 루프를 즉시 빠져나갑니다.
    total = 0
    while True:
        total = total + 10
        if total >= 30:
            break
    print(total)        # 30
    
    5.4

    중첩 루프

    루프 안에 다른 루프가 있는 것을 중첩 루프(nested loop)라고 합니다. 안쪽 루프는 바깥쪽 루프의 각 순환마다 완전히 실행됩니다.

    for row in range(3):
        line = ""
        for col in range(3):
            line = line + "*"
        print(line)
    # ***
    # ***
    # ***
    

    Common mistakes

    • range(n)은 0에서 n - 1까지 가며, 1에서 n까지 가지 않습니다 — 고전적인 off-by-one 오류입니다.
    • 루프 중 리스트를 변경하면 항목이 건너뛰어질 수 있으므로, 제거해야 할 경우 복사본을 루핑해야 합니다.
    • while에서 루프 변수를 변경하지 않으면 영원히 실행됩니다.
    • indentation(들여쓰기)가 루프 내부에 무엇이 포함될지 결정합니다. 잘못된 들여쓰기를 한 줄은 루프 실행 후 단 한 번만 실행됩니다.
  • 6 리스트 및 2D 리스트
    6.1

    목록

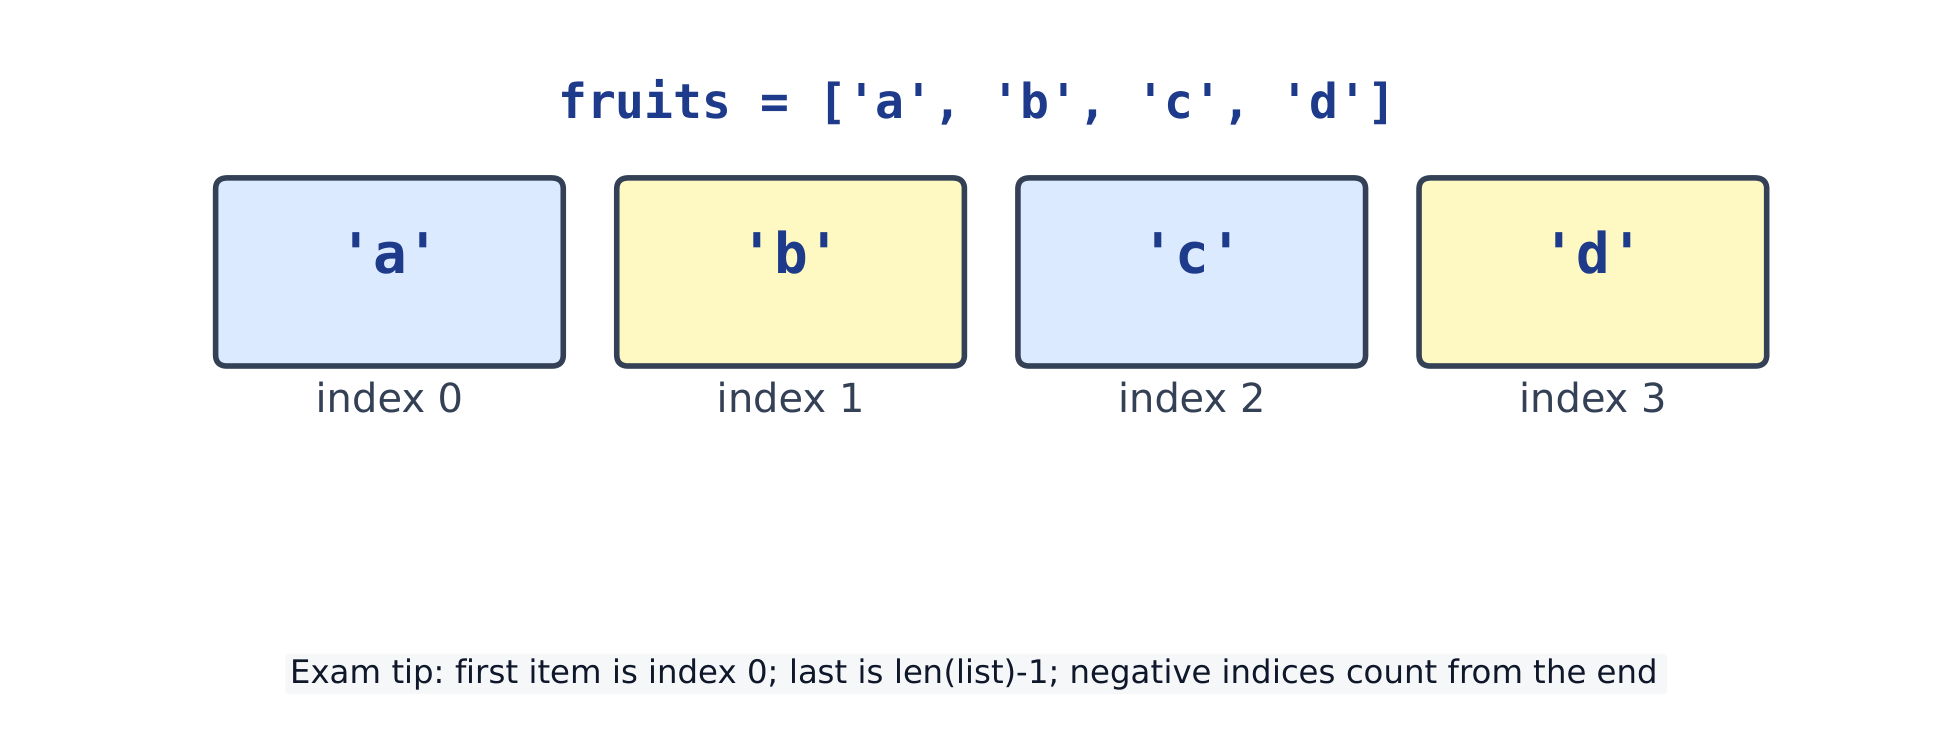
    리스트는 여러 값들을 [] 내부에 순서대로 저장합니다. 각 항목에는 인덱스(0부터 시작)가 있습니다.

    scores = [88, 71, 95]
    print(scores[0])      # 88
    print(len(scores))    # 3
    scores.append(60)     # add to the end
    print(scores)         # [88, 71, 95, 60]
    
    • 인덱스를 통해 항목 변경: scores[1] = 100.
    • 리스트는 커지거나 작아질 수 있지만, 문자열은 그렇지 않습니다.

    일상적인 리스트 도구들:

    도구 기능
    a.append(x) 맨 끝에 x 추가
    a.insert(i, x) x을 위치 i에 삽입합니다
    a.remove(x) 첫 번째 x 삭제
    a.pop() / a.pop(i) 마지막 항목 삭제 및 반환 / 항목 i 삭제 및 반환
    a.sort() 목록을 제자리에 정렬함
    sorted(a) 새로운 정렬된 리스트 반환
    x in a 목록에 x이 포함되었는가?
    len(a), sum(a), max(a), min(a) 크기 및 빠른 계산
    리스트 인덱스는 0부터 시작
    리스트 인덱스는 0에서 시작
    6.2

    리스트 순회하기

    리스트를 순회한다는 것은 각 항목을 방문하는 것입니다. 인덱스가 필요 없이 for 루프로 이를 수행할 수 있습니다.

    scores = [88, 71, 95]
    total = 0
    for s in scores:
        total = total + s
    print(total)          # 254
    
    • 인덱스도 필요한 경우 enumerate를 사용하십시오.
    for i, name in enumerate(["a", "b"]):
        print(i, name)    # 0 a  /  1 b
    
    6.3

    2차원 리스트 (격자)

    2차원 리스트는 리스트의 리스트입니다—행과 열로 구성된 격자입니다. 두 개의 인덱스 grid[row][col]를 사용합니다.

    grid = [[1, 2, 3],
            [4, 5, 6]]
    print(grid[0][2])     # 3
    print(grid[1][0])     # 4
    
    • 중첩 루프는 모든 셀을 방문합니다.
    grid = [[1, 2], [3, 4]]
    for row in grid:
        for value in row:
            print(value, end=" ")
    print()               # 1 2 3 4
    
    6.4

    리스트 컴프리헨션

    리스트 컴프리헨션은 한 줄로 새로운 리스트를 생성합니다: [expression for item in sequence].

    squares = [x * x for x in range(5)]
    print(squares)        # [0, 1, 4, 9, 16]
    
    • 특정 항목만 남기려면 if를 추가하십시오.
    evens = [n for n in range(10) if n % 2 == 0]
    print(evens)          # [0, 2, 4, 6, 8]
    
    6.5

    튜플 및 집합

    튜플은 호로 감싼 고정 순서입니다. 생성 후 변경할 수 없으므로, 함께 속하는 값들을 묶어두거나 이름으로 풀어서 사용하십시오.

    point = (3, 4)
    x, y = point            # unpacking
    print(x, y)             # 3 4
    

    두 개의 결과를 반환해야 하는 함수는 튜플을 반환합니다:

    def min_max(nums):
        return min(nums), max(nums)
    
    lo, hi = min_max([5, 2, 9])
    print(lo, hi)           # 2 9
    

    집합은 각 값을 한 번만 저장하며 순서가 없습니다. 중복 제거와 빠른 멤버십 테스트에 완벽합니다.

    votes = ["red", "blue", "red", "green", "red"]
    colours = set(votes)
    print(len(colours))         # 3  (duplicates removed)
    print("blue" in colours)    # True
    

    Common mistakes

    • b = a는 하나의 목록을 공유합니다. a.copy() 또는 a[:]는 새로운 외부 목록을 생성하지만, 중첩된 가변 항목은 여전히 공유됩니다(얕은 복사).
    • 마지막 항목은 a[-1]이며; a[len(a)]은 범위 밖입니다.
    • append는 항목을 하나만 추가합니다. 다른 리스트를 연결하려면 extend 또는 +을 사용하십시오.
    • [[0]*3]*3로 그리드를 만들면 같은 행을 세 번 복사하게 됩니다. 대신 루프 내에서 행을 생성하십시오.
    • 항목이 하나인 튜플에는 쉼표가 필요합니다: (5,), (5)이 아닙니다.
    • 집합은 순서가 없고 중복도 없으므로, s[0]으로 인덱스할 수 없습니다.
  • 7 딕셔너리
    7.1

    사전

    사전(dict)은 키 → 값 쌍을 저장합니다. 숫자 인덱스가 아닌 키를 통해 값을 찾아옵니다.

    student = {"name": "Mei", "score": 88}
    print(student["name"])     # Mei
    print(student["score"])    # 88
    

    추가 및 업데이트

    키에 할당하여 추가하거나 기존 값을 변경할 수 있습니다.

    student = {"name": "Mei"}
    student["score"] = 88      # add a new key
    student["score"] = 90      # update the value
    print(student)             # {'name': 'Mei', 'score': 90}
    

    확인 및 루프

    키 존재 여부를 테스트하려면 in를 사용하십시오. 키를 루프하거나, 키와 값을 모두 얻으려면 .items()을 루프하십시오.

    student = {"name": "Mei", "score": 90}
    print("score" in student)  # True
    for key, value in student.items():
        print(key, "=", value)
    # name = Mei
    # score = 90
    
    • .get(key, default)는 키가 없을 때 기본값을 반환하며, 오류를 발생시키지 않습니다.
    student = {"name": "Mei"}
    print(student.get("age", 0))   # 0
    

    고전적인 시험 유형 — 각 값이 나타나는 횟수를 세어보세요:

    word = "banana"
    counts = {}
    for letter in word:
        counts[letter] = counts.get(letter, 0) + 1
    print(counts)   # {'b': 1, 'a': 3, 'n': 2}
    
    • .get(letter, 0)는 키가 처음 보일 때 0를 제공하므로 KeyError이 발생하지 않습니다.

    Common mistakes

    • d[key]로 없는 키를 읽으려면 KeyError이 발생합니다; d.get(key)를 사용하거나 먼저 if key in d를 확인하십시오.
    • d[key]에 다시 할당하면 기존 값이 덮어씌워집니다. 키는 고유해야 합니다.
    • 키는 불변이어야 하며, 문자열이나 숫자 등입니다. 목록은 키로 사용할 수 없습니다.
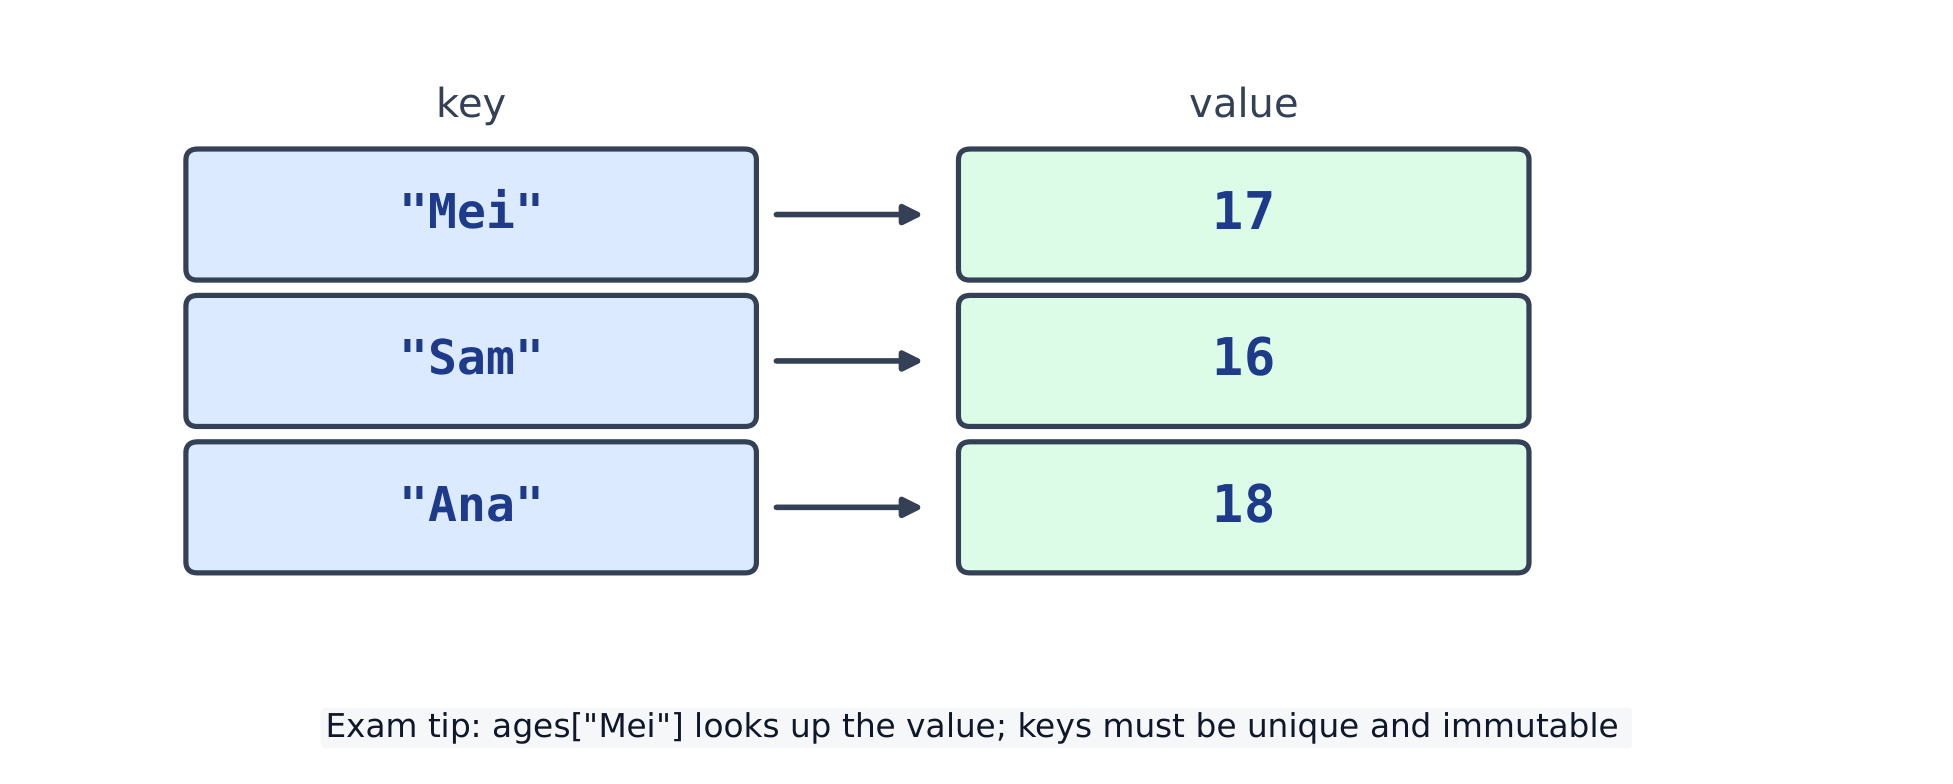
    Dictionary은 각 키를 하나의 값에 매핑합니다
    사전을 사용하면 각 키를 하나의 값에 매핑할 수 있습니다
  • 8 함수 및 추상화
    8.1

    함수 정의 및 호출

    함수는 재사용 가능한 이름이 붙은 코드 블록입니다. def으로 정의한 후 이름으로 호출하세요.

    def greet():
        print("Hello!")
    
    greet()        # Hello!
    greet()        # Hello!
    
    • 함수 내부의 코드는 함수를 호출할 때만 실행됩니다.
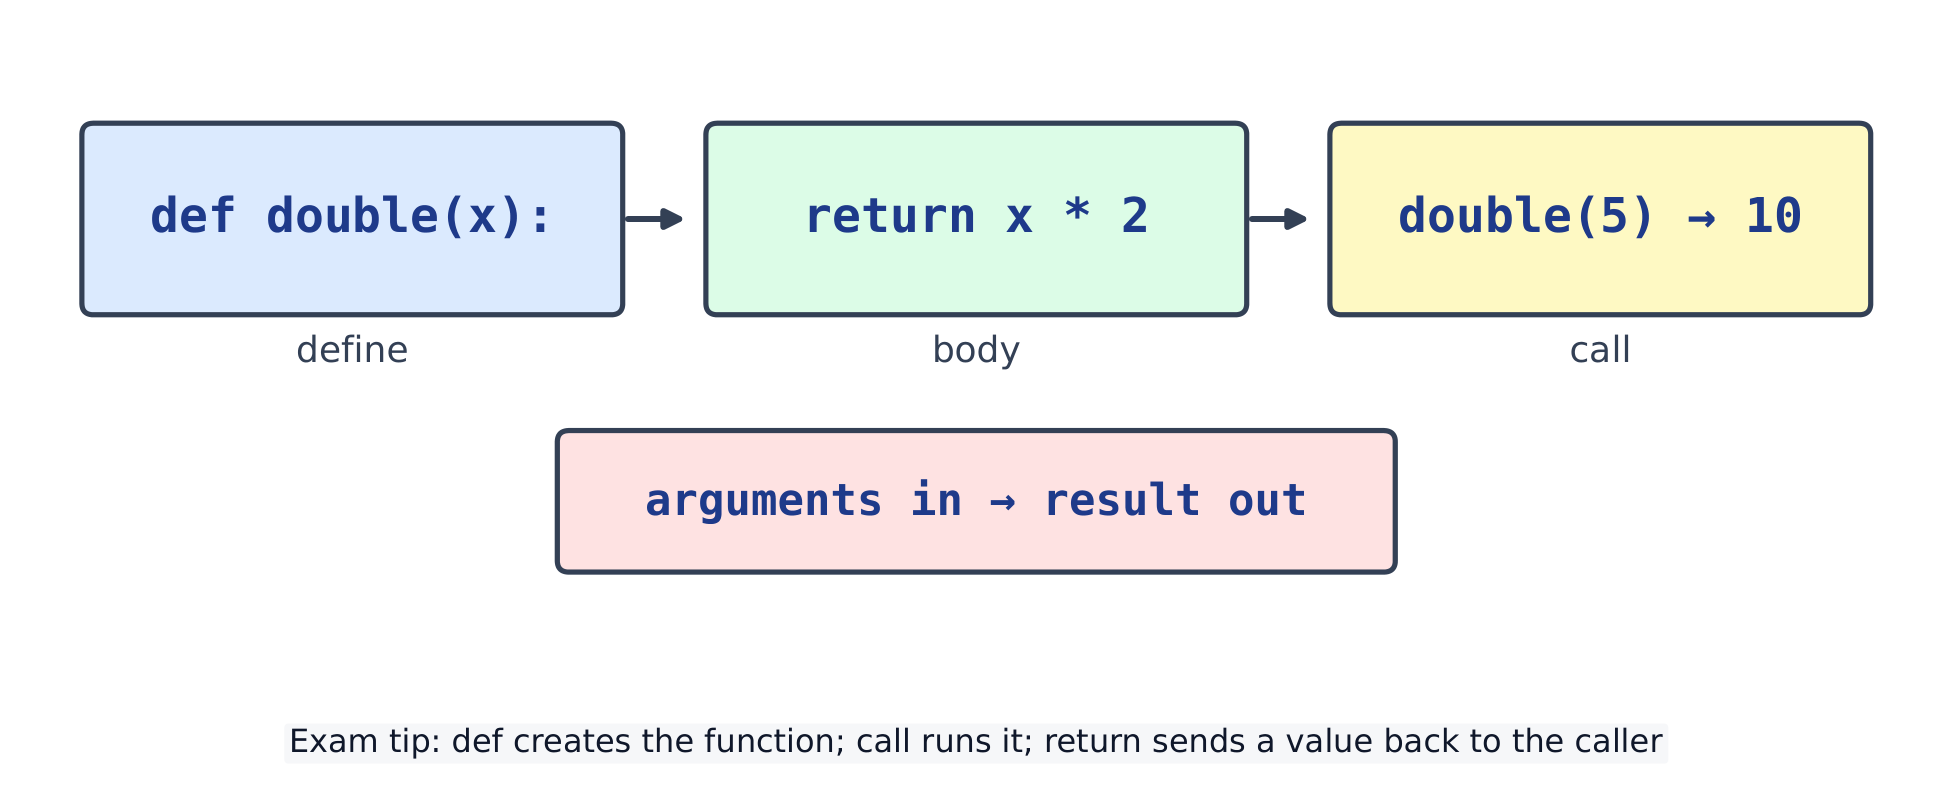
    def는 정의하고; call는 실행하며; return은 값을 되돌려 줍니다
    def는 함수를 정의합니다; 호출은 실행을 의미하며, return은 값을 반환합니다
    8.2

    반환 값

    함수는 return를 사용하여 값을 반환할 수 있습니다. 그러면 호출문은 그 값을 의미하게 됩니다.

    def square(n):
        return n * n
    
    print(square(5))          # 25
    print(square(3) + 1)      # 10
    
    • return은 즉시 함수를 종료합니다. return이 없는 함수는 None를 반환합니다.
    8.3

    매개변수, 인자 및 범위

    매개변수는 def에 있는 이름입니다. 인자는 전달하는 값입니다.

    def power(base, exp):         # base, exp are parameters
        return base ** exp
    
    print(power(2, 3))            # 8  (2 and 3 are arguments)
    

    함수 내부에서 생성된 변수는 로컬이며, 그곳에서만 존재합니다. 이 영역이 바로 scope(범위)입니다.

    def f():
        x = 10            # local to f
        return x
    
    print(f())            # 10
    # print(x) here would be an error: x is not defined outside f
    

    매개변수에는 기본값을 지정할 수 있으며, 호출자가 생략했을 때 사용됩니다:

    def greet(name, greeting="Hello"):
        return greeting + ", " + name
    
    print(greet("Mei"))              # Hello, Mei
    print(greet("Sam", "Welcome"))   # Welcome, Sam
    
    8.4

    절차적 추상화

    절차적 추상화는 이름을 통해 세부 사항을 숨기는 것입니다. 함수는 작동 방식이 아닌 이름과 역할로 사용합니다.

    def area_of_rectangle(w, h):
        return w * h
    
    print(area_of_rectangle(4, 5))   # 20
    
    • 좋은 함수는 한 가지 역할만 수행하고, 명확한 이름을 가지며, 코드의 중복을 피합니다.
    8.5

    모듈 & import

    모듈은 미리 만든 함수들이 들어있는 파일입니다. import으로 가져옵니다.

    import random
    random.seed(0)               # makes the result repeatable
    print(random.randint(1, 6))  # a dice roll
    
    import math
    print(math.sqrt(16))         # 4.0
    

    Common mistakes

    • None를 반환하지 않는 한 함수는 return을 반환합니다. 출력(print)은 반환(return)과 다릅니다.
    • mutable default인 def f(x=[])을 절대 사용하지 마십시오. 모든 호출에서 동일한 목록이 공유됩니다.
    • 함수 내부에서 생성된 변수는 로컬이며 외부에서는 볼 수 없습니다.
    • f()로 함수를 실행합니다; f을 단독으로 작성하면 단순히 이름만 지정됩니다.
  • 9 오류, 예외 및 테스트
    9.1

    오류 & 디버깅

    코드는 세 가지 방식으로 실패할 수 있습니다. 구문 오류(syntax error)는 Python 규칙을 위반하여 실행되지 않습니다. 런타임 오류(runtime error)는 실행 중 발생하며, 0으로 나누기 등이 포함됩니다. 논리 오류(logic error)는 실행되지만 잘못된 결과를 줍니다.

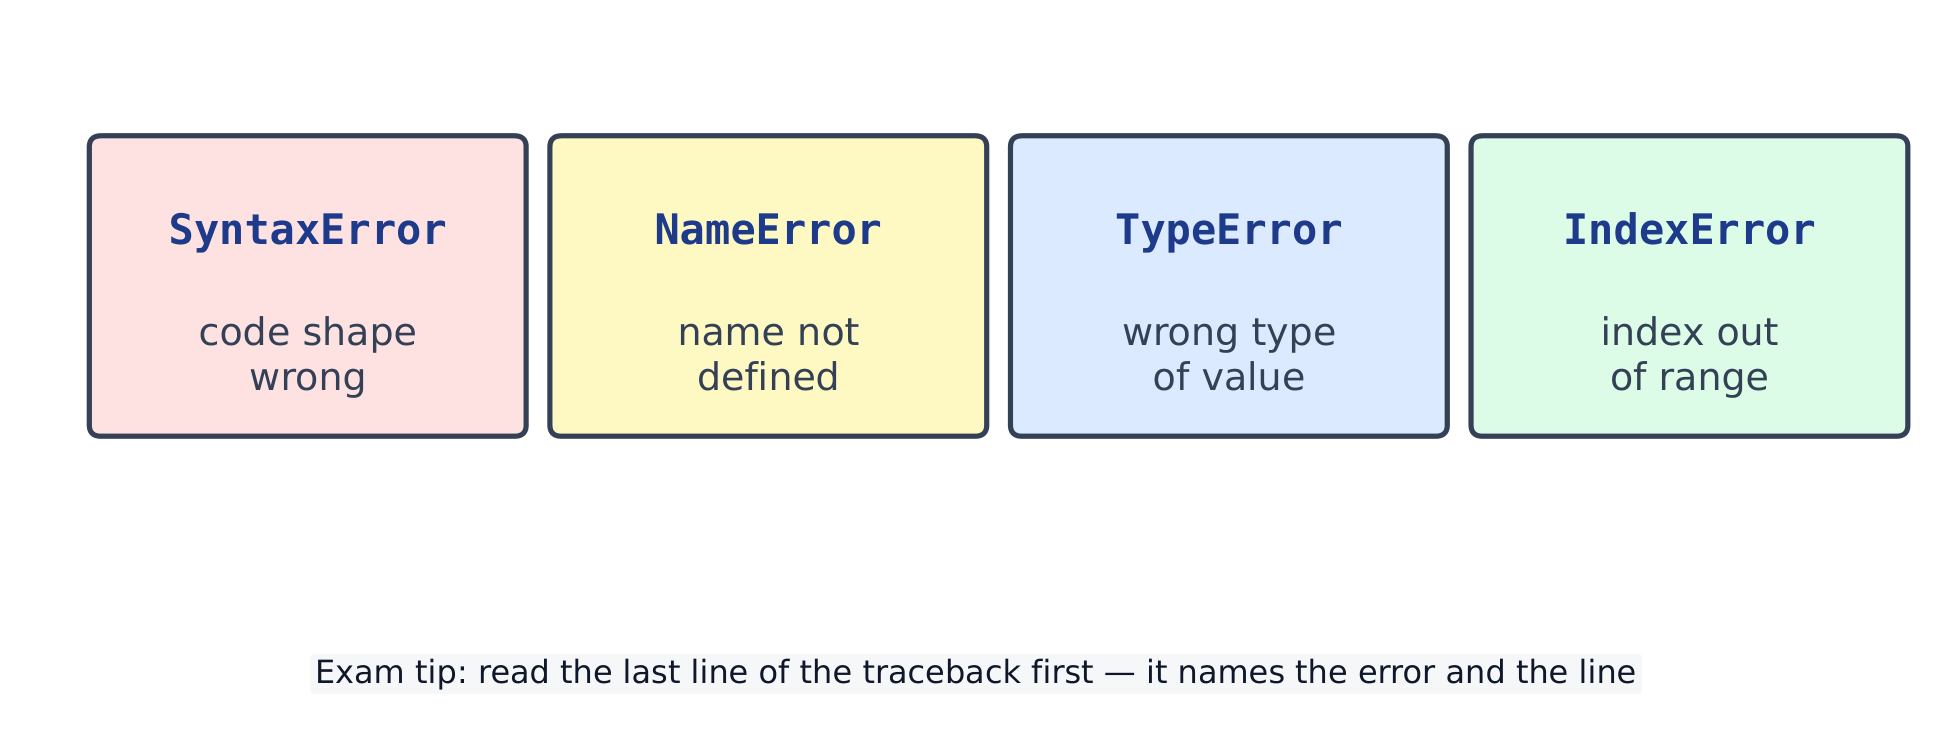
    Common Python errors: Syntax, Name, Type, Index
    Common Python errors: Syntax, Name, Type, Index
    # A runtime error, caught so this block still finishes:
    try:
        print(10 / 0)
    except ZeroDivisionError:
        print("cannot divide by zero")
    # cannot divide by zero
    
    • Python은 실패 지점을 보여주는 traceback을 출력합니다. 아래에서부터 읽으세요.
    9.2

    try / except / raise

    위험한 코드를 try에 넣으세요; 실패 시 except이 예외를 포착하여 프로그램이 종료되는 것을 방지합니다.

    def to_int(text):
        try:
            return int(text)
        except ValueError:
            return 0
    print(to_int("abc"))   # 0
    
    • 특정 타입의 예외를 catch합니다 (ValueError, ZeroDivisionError 등).
    • raise은 의도적으로 사용자 정의 오류를 발생시킵니다.
    def set_age(age):
        if age < 0:
            raise ValueError("age cannot be negative")
        return age
    
    try:
        set_age(-1)
    except ValueError as err:
        print("error:", err)
    # error: age cannot be negative
    
    9.3

    테스트 & 내구성

    테스트는 코드가 올바른 결과를 내놓는지 확인합니다. 정상적인 경우 와 가장자리(case edge case) — 빈 입력, 0, 매우 큰 값 — 모두 시도하십시오.

    def average(nums):
        if len(nums) == 0:        # edge case: empty list
            return 0
        return sum(nums) / len(nums)
    
    print(average([2, 4, 6]))     # 4.0
    print(average([]))            # 0
    
    • 견고한 코드는 crashed되지 않고 기묘한 입력을 매끄럽게 처리합니다.

    Common mistakes

    • bare except:을 사용하지 마십시오. 구체적인 오류를 catch하십시오. 예: except ValueError:.
    • 구문 오류는 실행 전에 전체 프로그램을 멈추므로 먼저 수정하십시오.
    • 쉬운 경우뿐만 아니라 가장자리 사례(빈 입력, 0, 최대값 등)도 테스트하세요.
  • 10 파일(File)
    10.1

    텍스트 파일 읽기 및 쓰기

    텍스트 파일은 디스크에 텍스트를 저장합니다. mode가 read 또는 write일 때 open(name, mode)으로 엽니다. 항상 with을 사용하십시오. 이는 파일을 자동으로 닫아줍니다.

    쓰기

    모드 "w"는 새 파일을 작성하며 기존 파일은 지워집니다.

    with open("notes.txt", "w") as f:
        f.write("first line\n")
        f.write("second line\n")
    print("saved")            # saved
    

    읽기

    mode "r"(기본값)은 읽습니다. .read()은 전체 파일을 하나의 문자열로 반환합니다.

    with open("notes.txt", "w") as f:
        f.write("hello\nworld\n")
    with open("notes.txt") as f:
        print(f.read().strip())   # hello / world
    

    줄 단위로

    Loop over the file to get one line at a time. .strip() removes the newline at the end.

    with open("data.txt", "w") as f:
        f.write("Mei,88\nSam,71\n")
    with open("data.txt") as f:
        for line in f:
            name, score = line.strip().split(",")
            print(name, "scored", score)
    # Mei scored 88
    # Sam scored 71
    

    추가하기

    Mode "a" appends — it adds to the end without erasing.

    with open("log.txt", "w") as f:
        f.write("line 1\n")
    with open("log.txt", "a") as f:
        f.write("line 2\n")
    with open("log.txt") as f:
        print(f.read().strip())   # line 1 / line 2
    
    Mode Meaning
    "r" read (default)
    "w" write (erases first)
    "a" append (add to the end)

    Common mistakes

    • 항상 파일을 닫거나, with open(...) as f:을 사용하여 자동으로 닫게 하십시오.
    • read()은 전체 파일을 하나의 문자열로 제공하며, 각 줄은 여전히 \n으로 끝납니다.
    • Opening with "w" erases the file first; use "a" to add to the end.
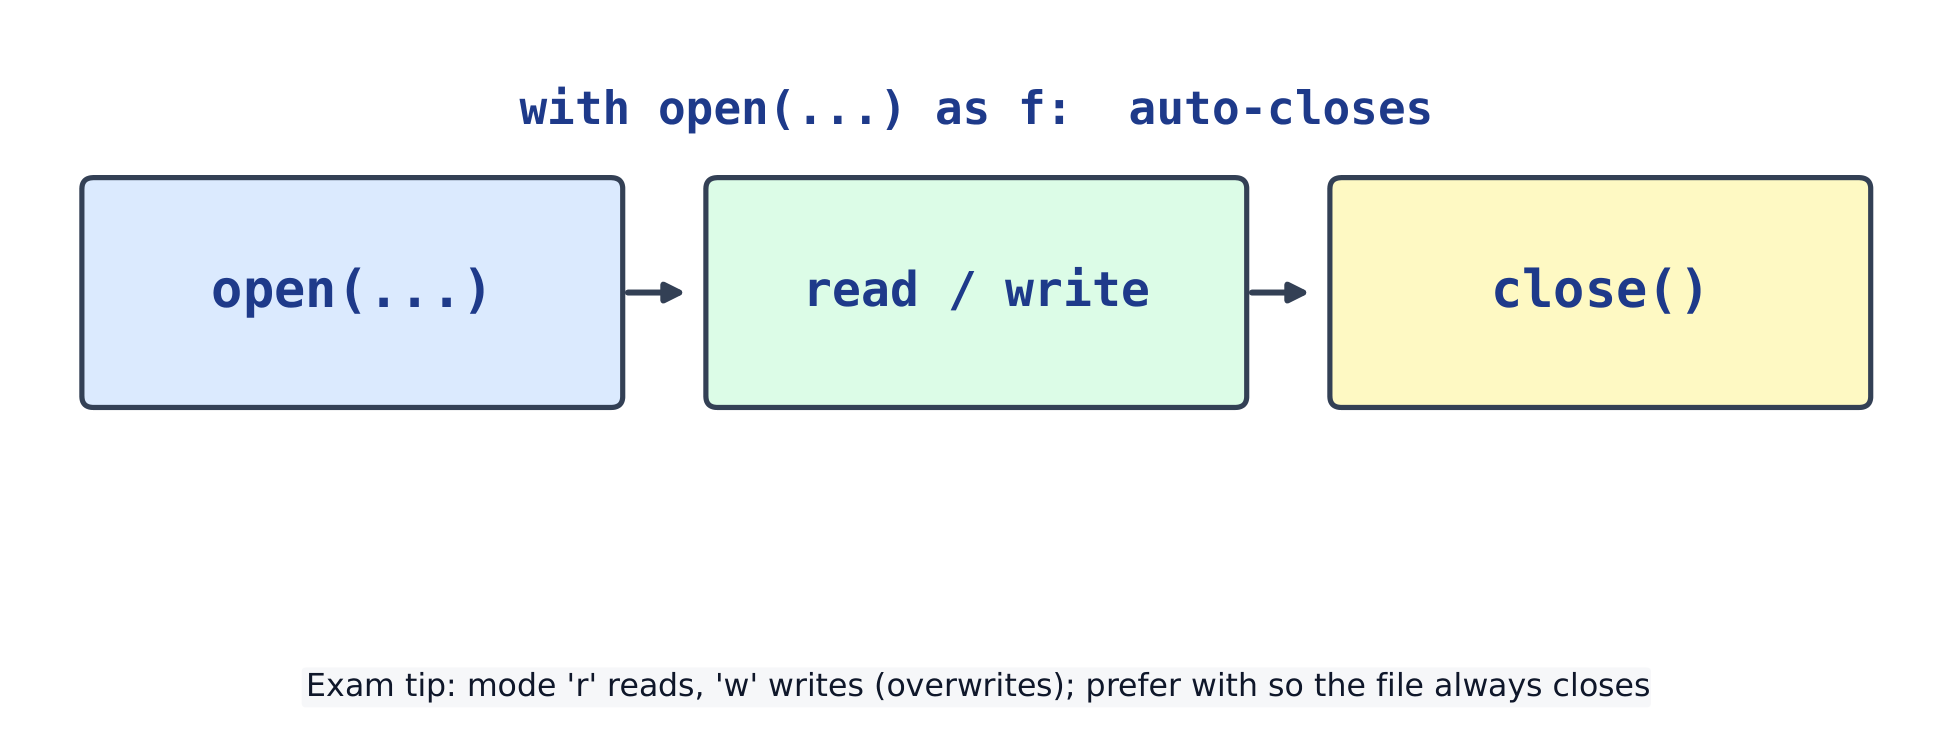
    open → read/write → close (with auto-closes)
    open → read/write → close (with auto-closes)
  • 11 알고리즘 설계(Algorithm design)
    11.1

    알고리즘 & 분해

    알고리즘은 문제를 해결하는 명확한 단계 목록입니다. 분해(decomposition)는 큰 문제를 작은 부분으로 나누어 하나씩 해결할 수 있게 하는 것입니다.

    # Algorithm: find the largest number in a list
    def largest(nums):
        best = nums[0]
        for n in nums:
            if n > best:
                best = n
        return best
    
    print(largest([3, 9, 2, 7]))   # 9
    
    • 추상화는 세부 사항을 무시하는 것입니다. largest(...)을 어떻게 작동하는지 다시 읽지 않고 사용합니다.
    11.2

    가상의 코드 & 흐름도

    가상의 코드는 실제 코드 이전에 작성되는 알고리즘을 위한plain, 구조화된 영어입니다. 실행되지 않습니다.

    SET best TO first number
    FOR Each number n
        IF n > best
          THEN
            SET best TO n
    OUTPUT best
    

    흐름도는 동일한 계획을그립니다: 각 단계마다 상자, 각 결정마다 마름모, 순서에 따라 화살표를 사용합니다.

    11.3

    재귀 & 호출 택

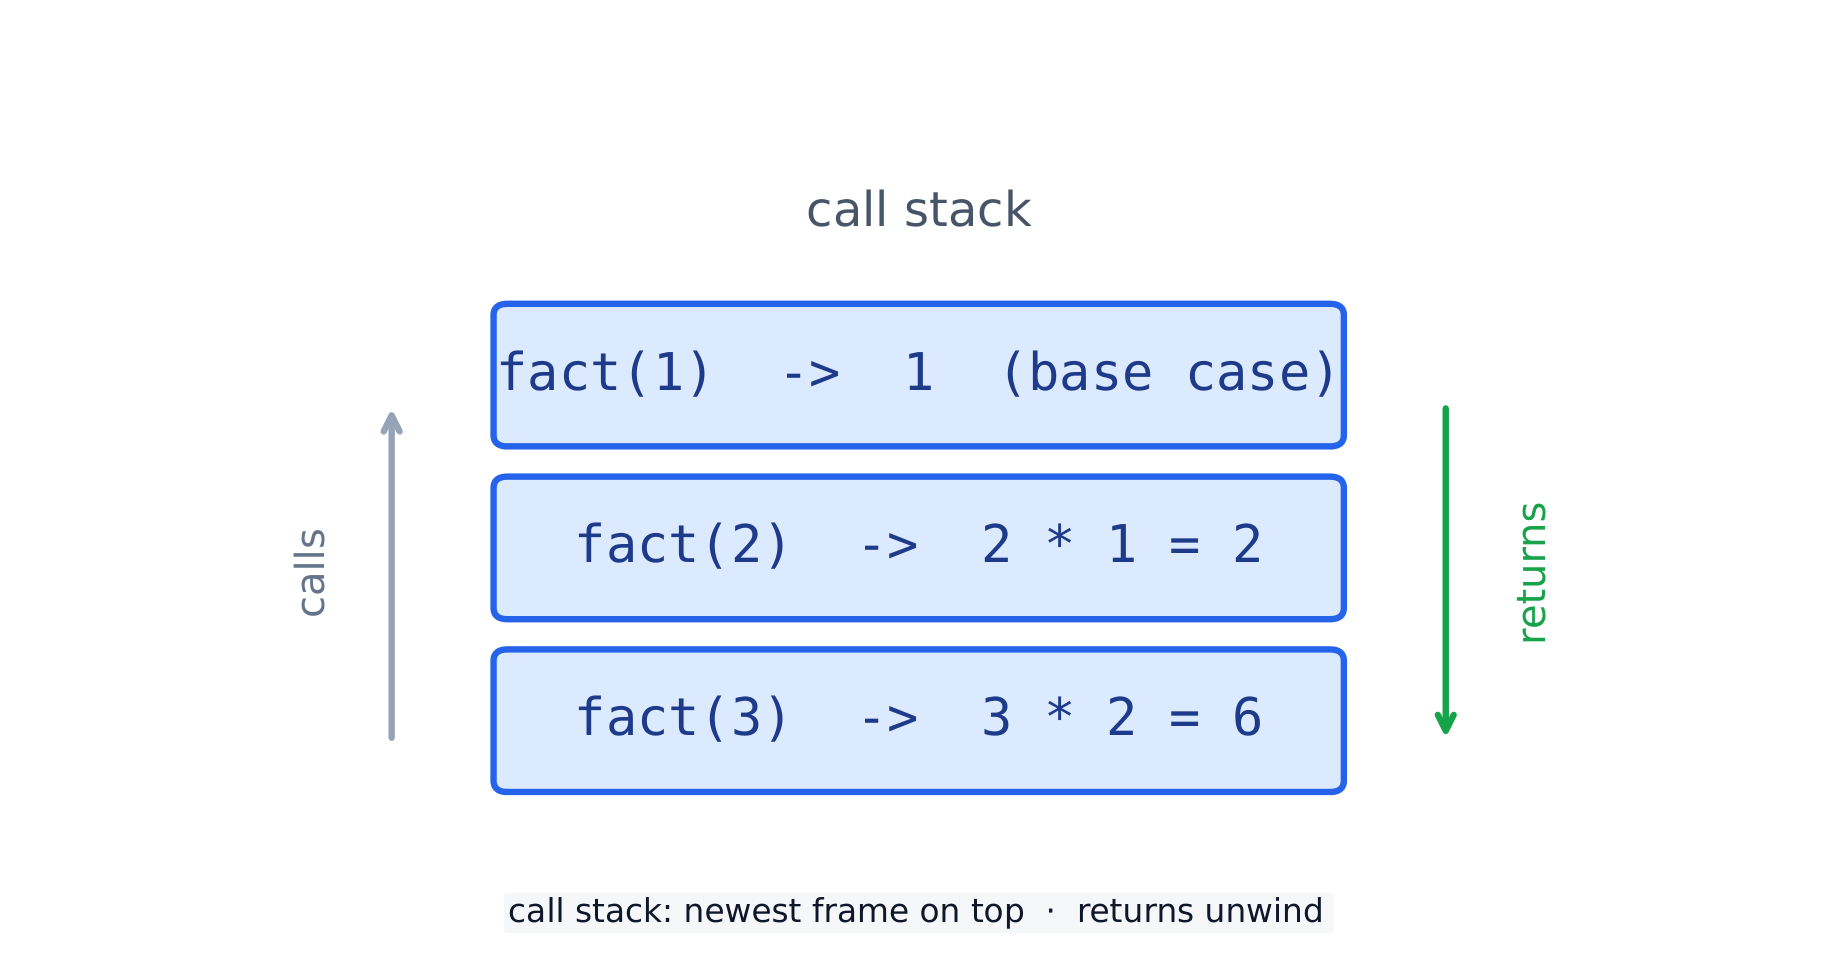
    재귀는 함수가 자신을 호출하는 것입니다. 기본 케이스(base case, 간단한 입력이 즉시 반환)와 재귀적 경우(recursive case, 더 작은 입력에서 자신을 호출)가 필요합니다.

    factorial(3)의 콜 스택: 각 호출이 대기했다가 역순으로 반환
    factorial(3)의 콜 스택: 각 호출이 대기했다가 역순으로 반환
    def fact(n):
        return 1 if n <= 1 else n * fact(n - 1)
    
    print(fact(5))     # 120
    
    • each paused call sits on the call stack until the call above it returns.

    Common mistakes

    • 재귀에는 기본 케이스가 필요하며, 그렇지 않으면 무한히 자신을 호출하여 호출 스택이 충돌합니다.
    • 가상의 코드는 계획용입니다. 실행될 필요는 없지만, 모든 단계는 모호하지 않아야 합니다.
    • 코드를 작성하기 전에 큰 문제를 작은 이름 붙은 단계로 나누십시오.
  • 12 데이터 구조
    12.1

    추상 데이터 타입(ADT)

    추상 데이터 유형(ADT)은 데이터와 그에 대한 연산을 설명하며, 구현 방식과는 분리됩니다. 내부 저장소가 아닌 연산을 통해 사용합니다.

    # A stack ADT, built on a list
    s = []
    s.append(1)        # add
    s.append(2)
    print(s.pop())     # 2  (remove the most recent)
    
    12.2

    스택

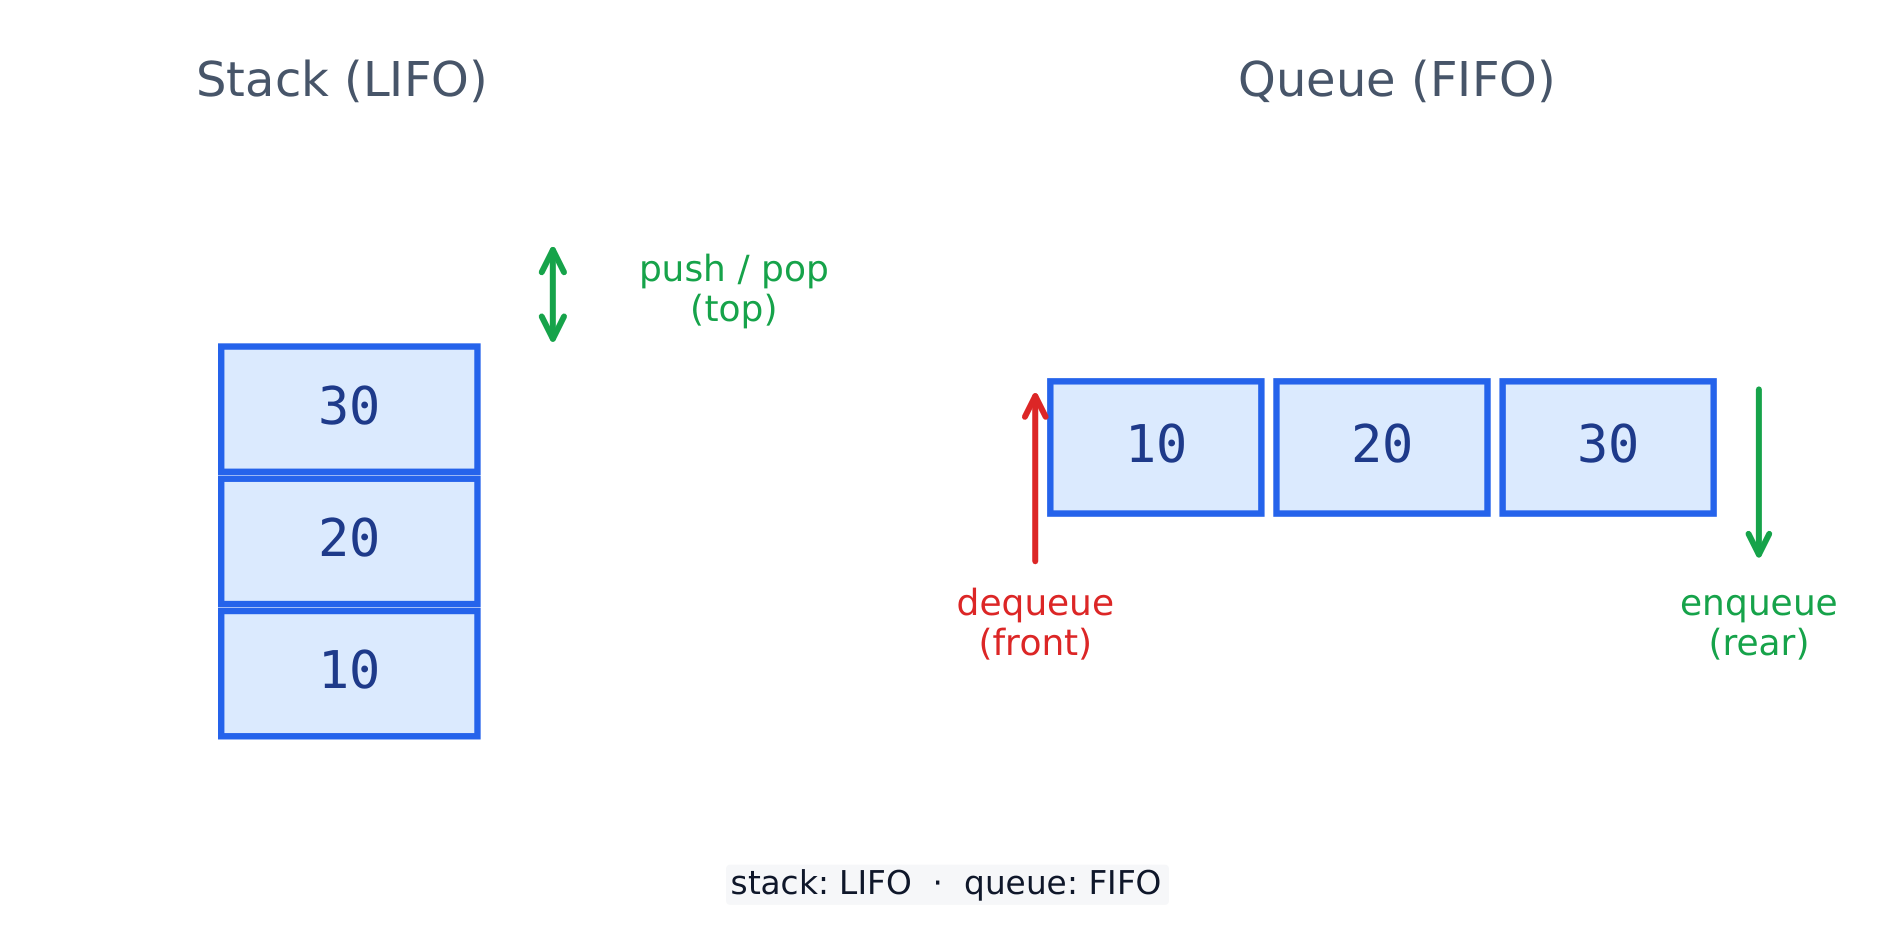
    스택은 Last-In, First-Out(LIFO)입니다. top에 push하고 top에서 pop합니다.

    스택은 상단에서 제거(LIFO); 큐는 앞쪽에서 제거(FIFO)
    스택은 상단에서 제거(LIFO); 큐는 앞쪽에서 제거(FIFO)
    stack = []
    stack.append("a")
    stack.append("b")
    print(stack.pop())   # b
    print(stack.pop())   # a
    
    12.3

    큐

    큐는 First-In, First-Out(FIFO)입니다. back에서 enqueue하고 front에서 dequeue합니다.

    queue = []
    queue.append("a")     # enqueue
    queue.append("b")
    print(queue.pop(0))   # a  (dequeue the front)
    print(queue.pop(0))   # b
    
    12.4

    링크드 리스트

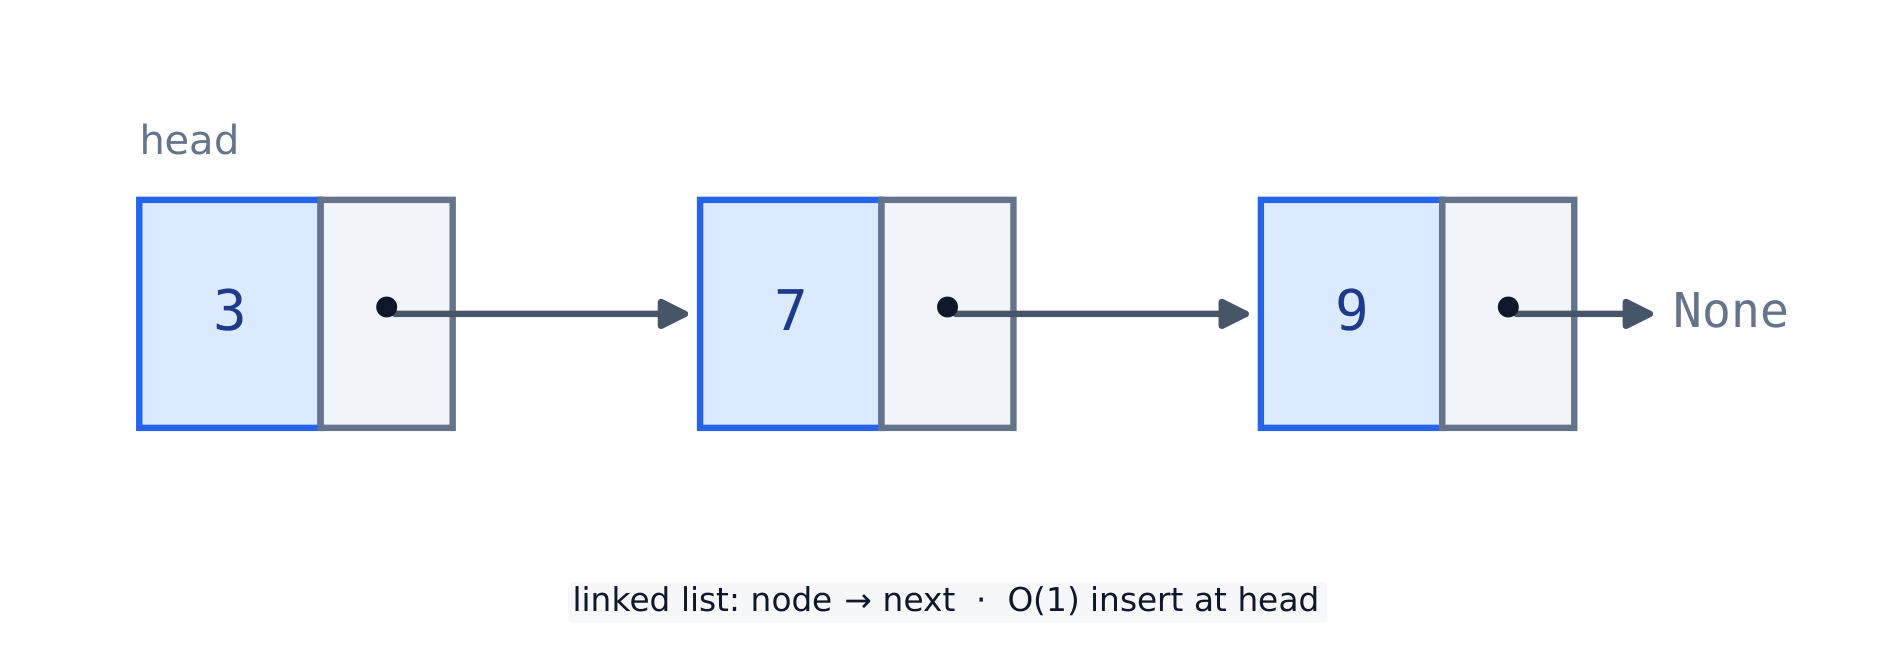
    연결 목록(linked list)은 노드들의 사슬입니다. 각 노드는 데이터와 다음 노드에 대한 포인터를 가지며, 마지막 노드는 None을 가리킵니다.

    A linked list: each node holds data and a pointer to the next node, ending at None
    A linked list: each node holds data and a pointer to the next node, ending at None
    n3 = {"data": 3, "next": None}
    n2 = {"data": 2, "next": n3}
    n1 = {"data": 1, "next": n2}
    node = n1
    while node is not None:      # traverse to the end
        print(node["data"])
        node = node["next"]
    # 1 2 3
    
    12.5

    해시 테이블

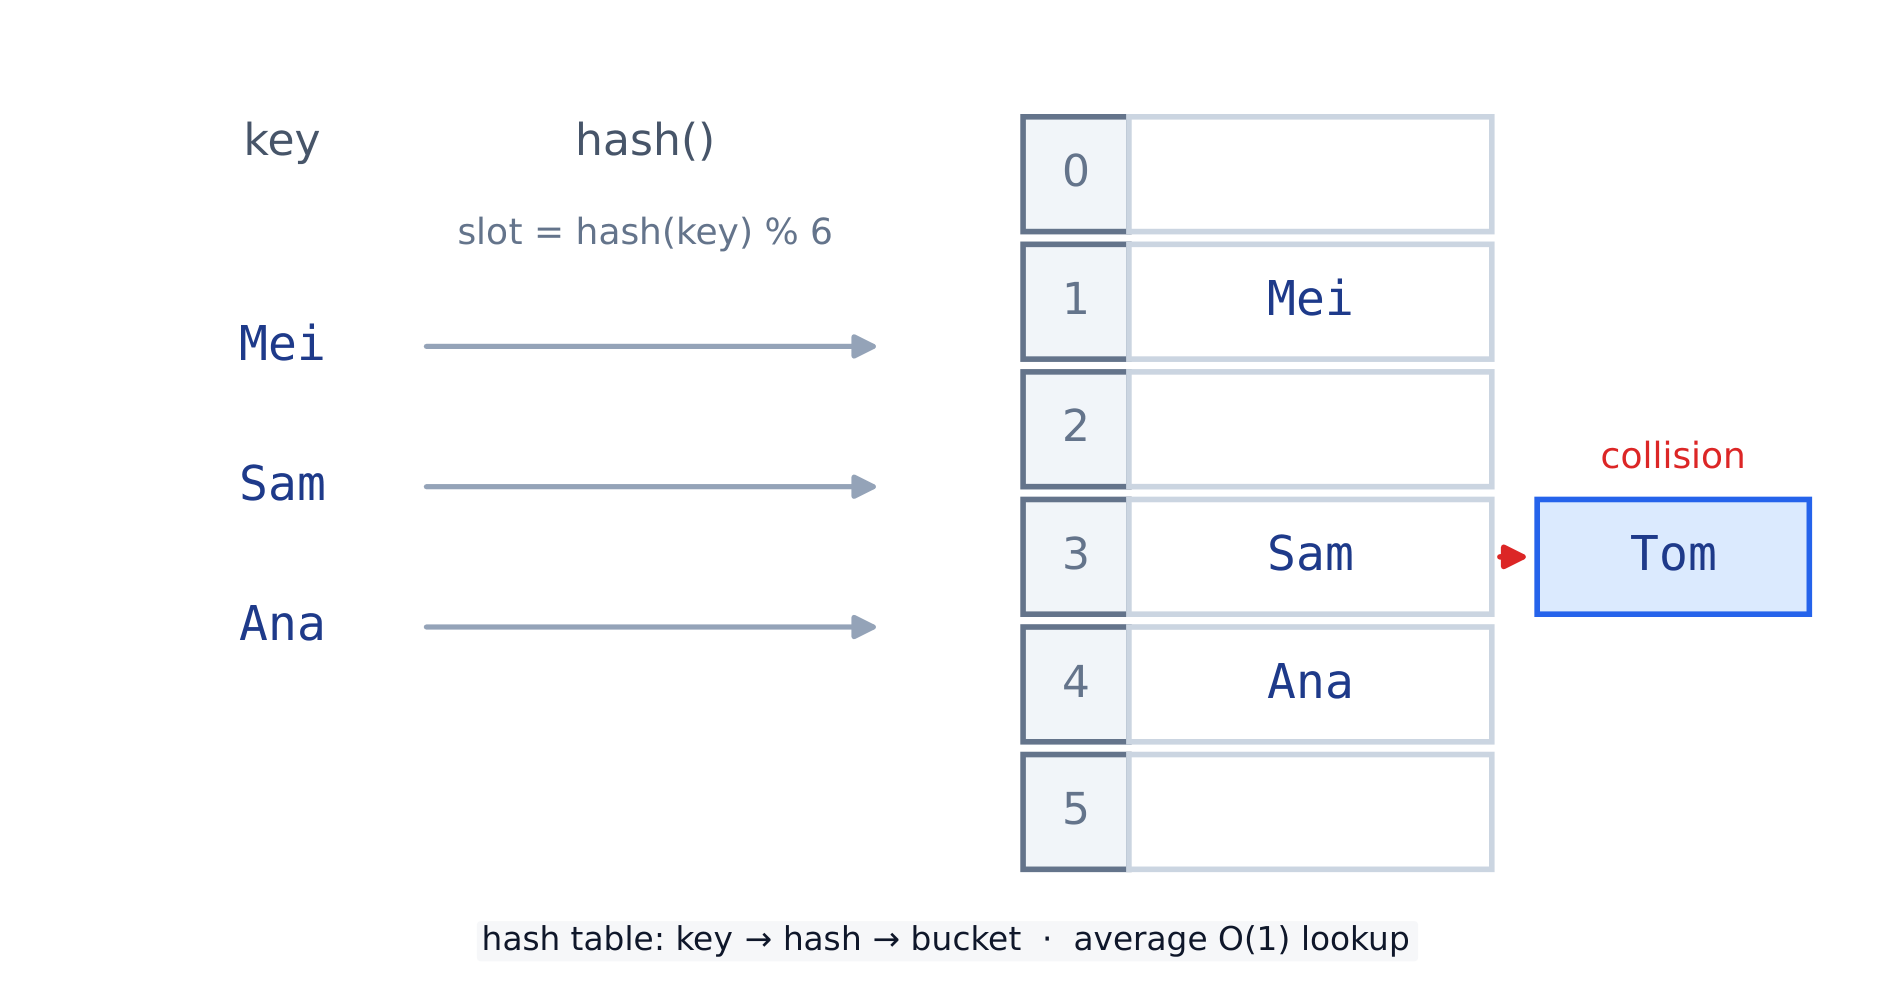
    해시 테이블은 해시 함수를 사용하여 키를 슬롯에 매핑합니다. 두 키가 같은 슬롯에 배치될 수 있는데, 이를 충돌(collision)이라고 합니다. Python의 dict은 해시 테이블이므로 검색이 빠릅니다.

    해시 함수는 각 키를 슬롯에 매핑하며, 두 개의 키가 하나의 슬롯에 충돌할 수 있습니다
    해시 함수는 각 키를 슬롯에 매핑합니다. 두 개의 키가 하나의 슬롯에서 충돌할 수 있습니다
    table = {}
    table["Mei"] = 88
    table["Sam"] = 71
    print(table["Mei"])   # 88  (fast lookup by key)
    
    12.6

    이진 탐색 트리

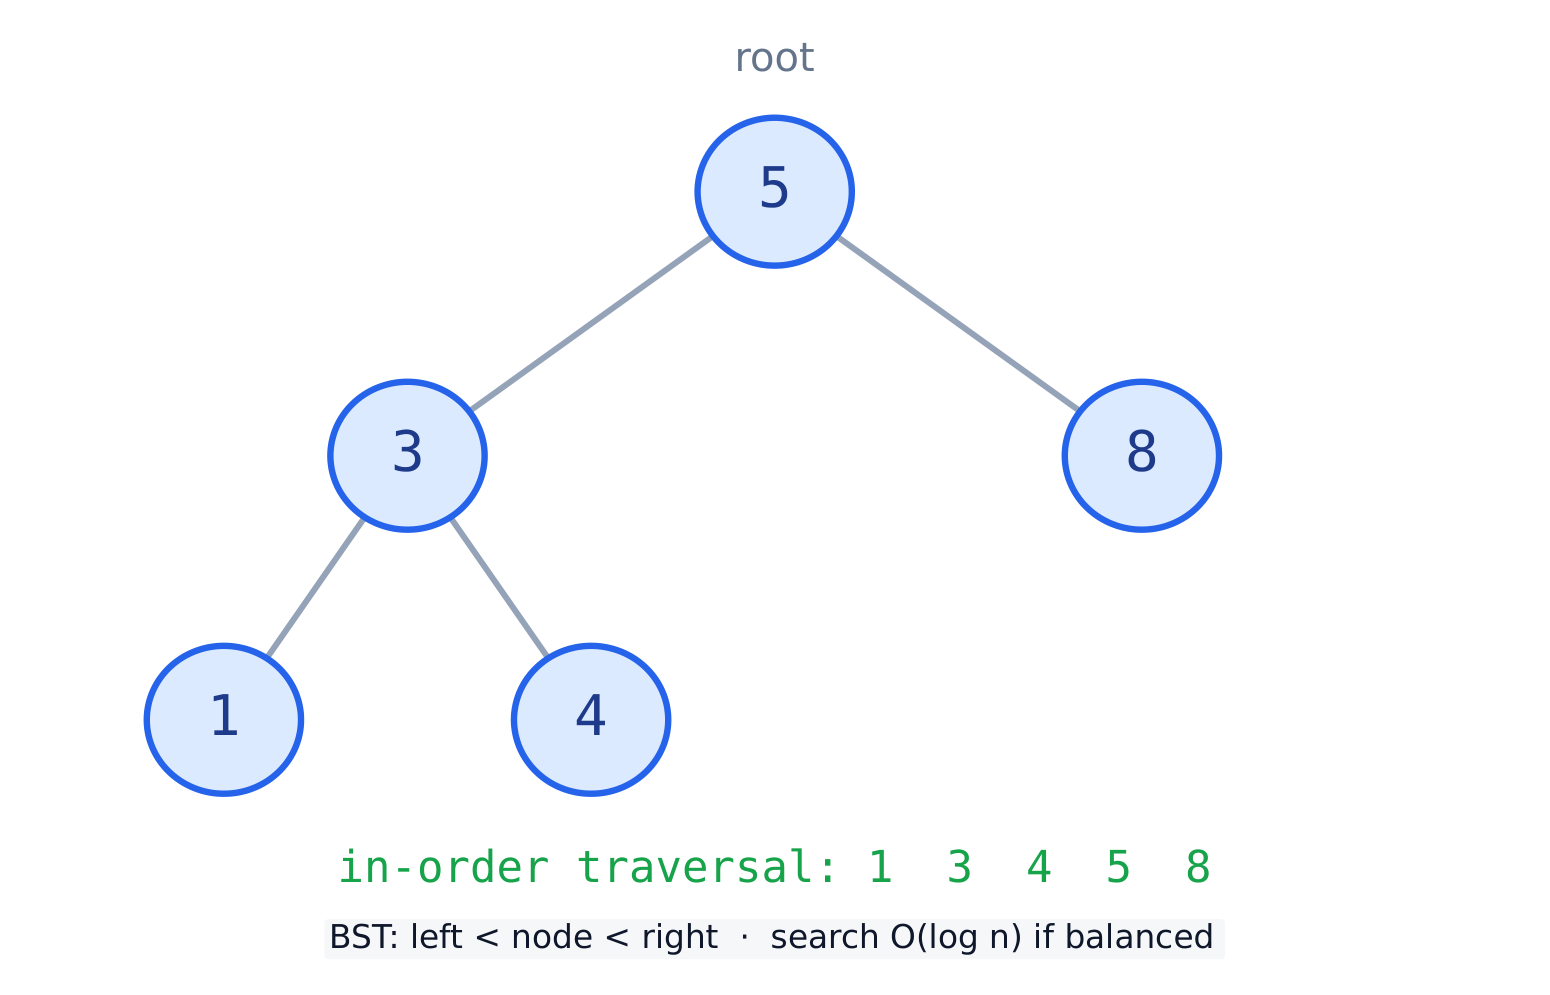
    이진 탐색 트리(BST)는 순서를 유지합니다: 모든 왼쪽 자식 노드는 부모보다 작고, 모든 오른쪽 자식 노드는 부모보다 니다. 검색 속도가 빠릅니다.

    이진 탐색 트리: 작은 값은 왼쪽으로, 큰 값은 오른쪽으로 배치됩니다
    이진 탐색 트리: 작은 값은 왼쪽으로, 큰 값은 오른쪽으로 배치됩니다
    def insert(root, val):
        if root is None:
            return {"val": val, "left": None, "right": None}
        if val < root["val"]:
            root["left"] = insert(root["left"], val)
        else:
            root["right"] = insert(root["right"], val)
        return root
    
    def inorder(root):
        if root is None:
            return []
        return inorder(root["left"]) + [root["val"]] + inorder(root["right"])
    
    tree = None
    for v in [5, 3, 8, 1, 4]:
        tree = insert(tree, v)
    print(inorder(tree))   # [1, 3, 4, 5, 8]
    
    12.7

    그래프

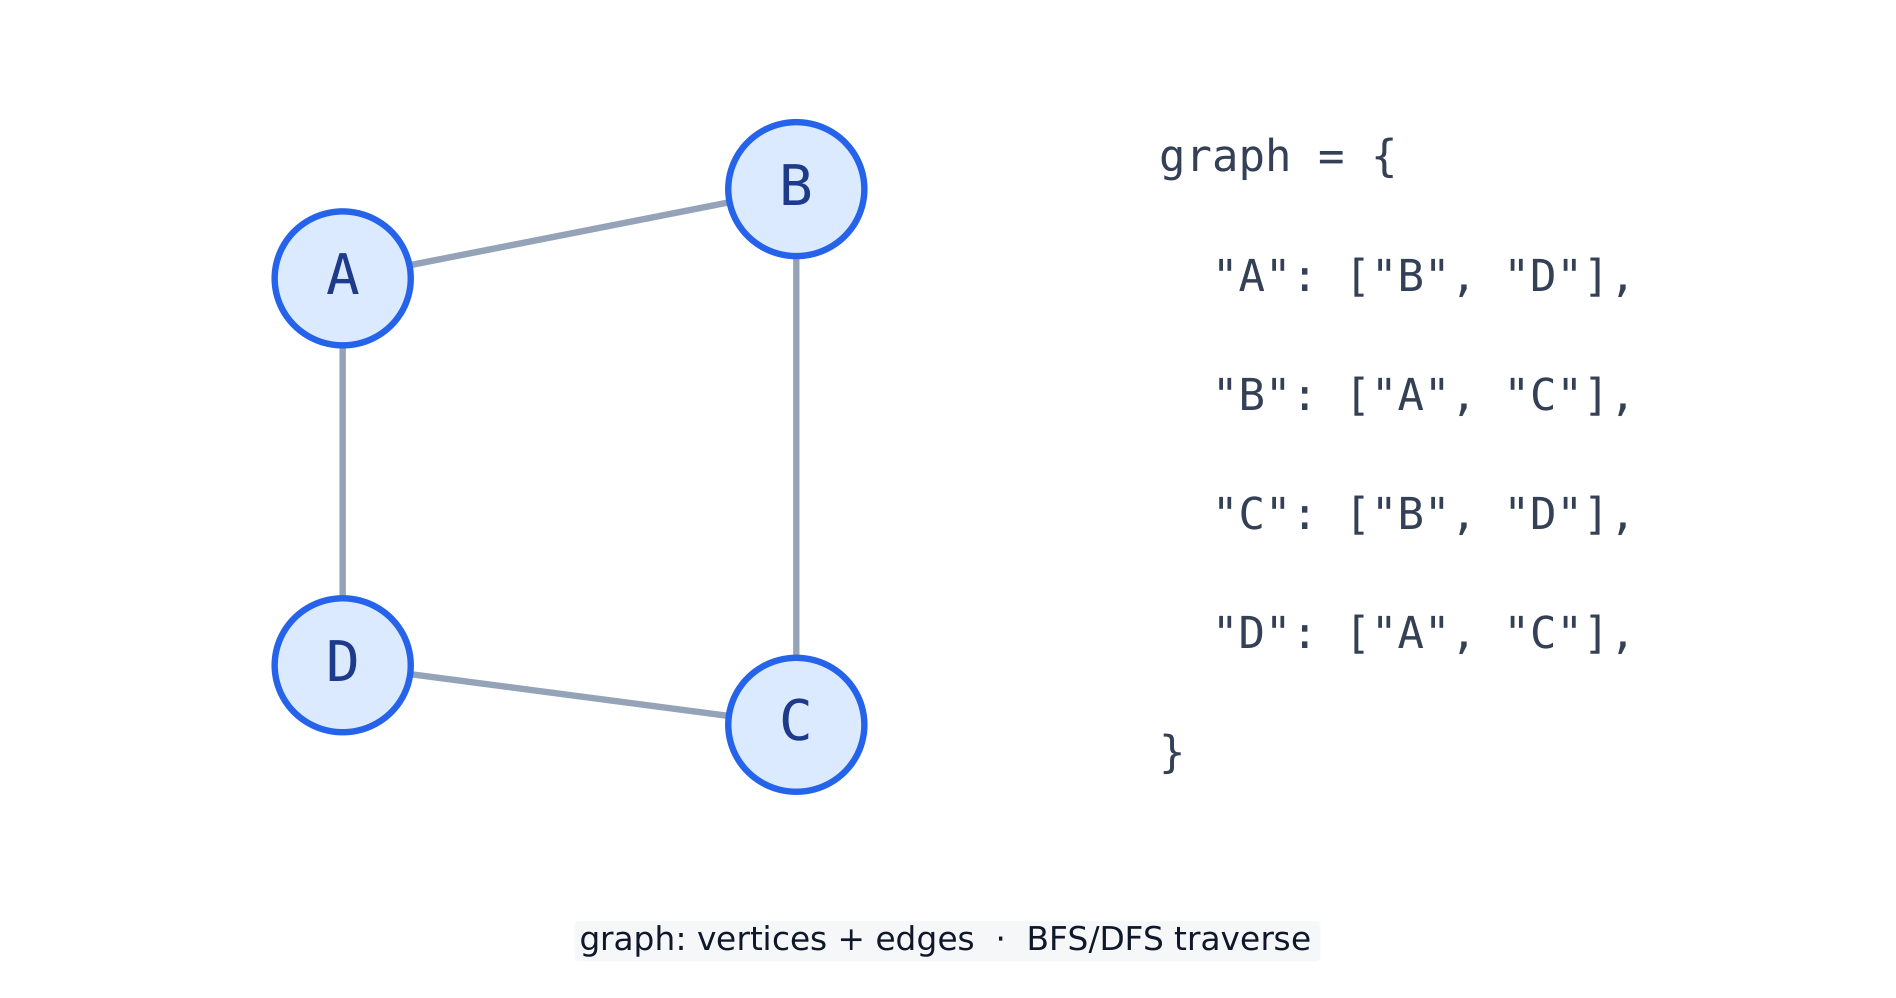
    그래프는 엣지(연결선)로 연결된 정점의 집합입니다. 인접 목록 — 이웃 목록을 저장하는 사전 데이터 구조 —은 이를 저장하는 일반적인 방법입니다.

    정점과 엣지로 구성된 그래프 및 그 인접 목록 형태
    정점과 엣지로 구성된 그래프 및 그 인접 목록 형태
    graph = {"A": ["B", "D"], "B": ["A", "C"], "C": ["B", "D"], "D": ["A", "C"]}
    for vertex in graph:
        print(vertex, "->", graph[vertex])
    # A -> ['B', 'D']  (and so on for B, C, D)
    

    Common mistakes

    • 스택은 Last-In-First-Out(LIFO), 큐는 First-In-First-Out(FIFO)입니다. 혼동하지 마십시오.
    • 스택이나 큐에서 값을 제거(popping/dequeuing)하기 전에 구조체가 비어 있는지 확인하십시오.
    • 링크드 리스트에서 head 포인터를 잃으면 전체 리스트를 잃게 됩니다.
  • 13 검색, 정렬 및 효율성
    13.1

    선형 탐색 및 이진 탐색

    검색은 값이 어디에 있는지 찾습니다. 선형 검색은 항목을 순차적으로 확인하므로 어떤 리스트에서도 작동합니다.

    def linear_search(items, target):
        for i in range(len(items)):
            if items[i] == target:
                return i
        return -1     # not found
    
    print(linear_search([4, 8, 2, 9], 2))   # 2
    

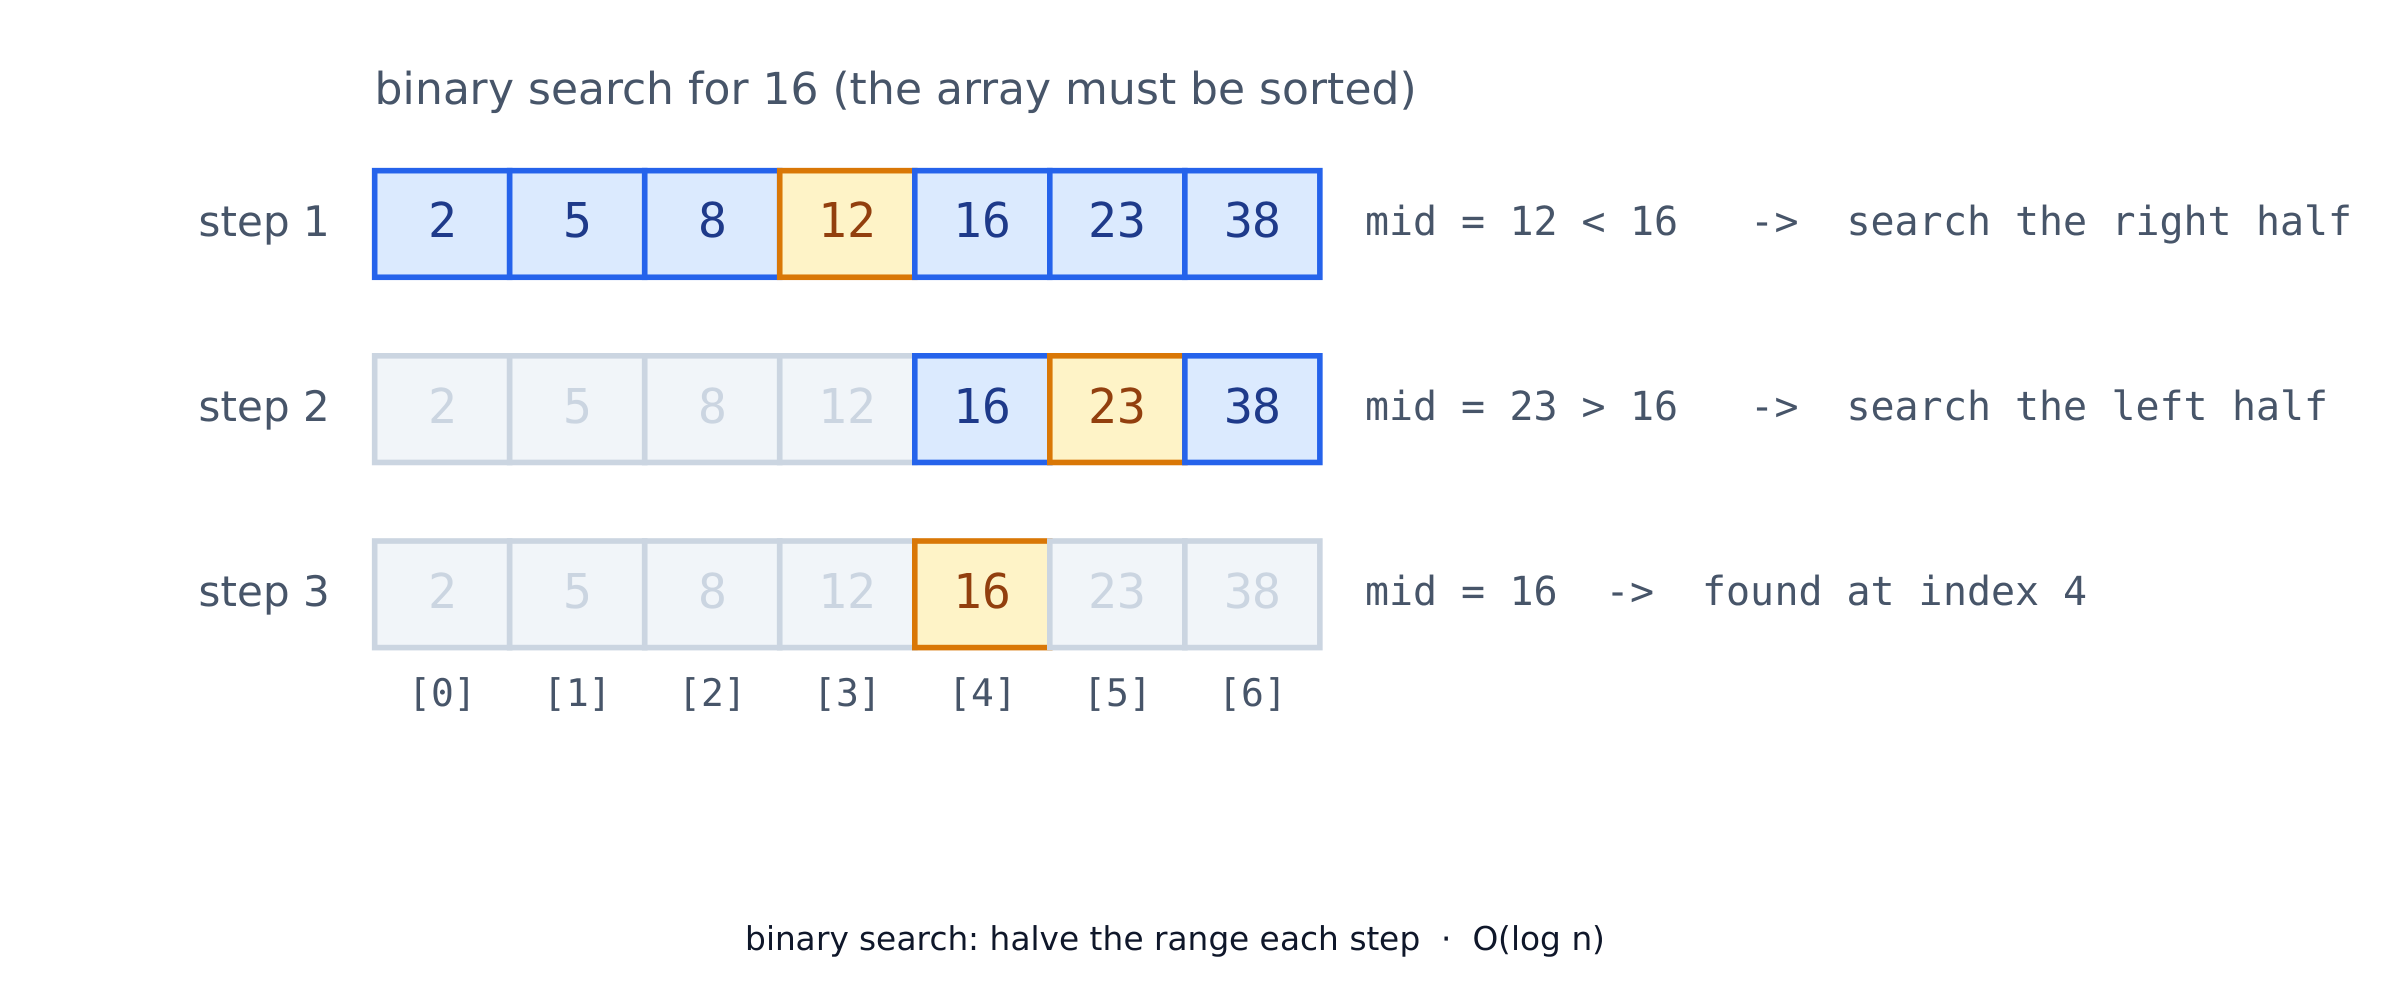
    이진 검색은 훨씬 빠르지만 정렬된 리스트가 필요합니다. 각 단계마다 범위를 절반으로 줄입니다.

    def binary_search(items, target):
        lo, hi = 0, len(items) - 1
        while lo <= hi:
            mid = (lo + hi) // 2
            if items[mid] == target:
                return mid
            elif items[mid] < target:
                lo = mid + 1
            else:
                hi = mid - 1
        return -1
    
    print(binary_search([1, 3, 5, 7, 9], 7))   # 3
    
    이진 검색은 각 단계마다 범위를 절반으로 줄임 — 정렬된 리스트에서 O(log n)
    이진 검색은 각 단계마다 범위를 절반으로 줄임 — 정렬된 리스트에서 O(log n)
    13.2

    정렬 (버블 & 삽입)

    정렬은 항목을 순서대로 나열하는 것입니다. 버블 정렬은 잘못된 순서의 인접한 항목을 반복해서 스왑합니다.

    def bubble_sort(a):
        a = a[:]                          # work on a copy
        for i in range(len(a)):
            for j in range(len(a) - 1 - i):
                if a[j] > a[j + 1]:
                    a[j], a[j + 1] = a[j + 1], a[j]
        return a
    
    print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
    

    삽입 정렬은 정렬된 부분을 하나씩 구축하며, 새로운 항목을 제자리에 밀어 넣습니다:

    def insertion_sort(a):
        a = a[:]                           # work on a copy
        for i in range(1, len(a)):
            key = a[i]
            j = i - 1
            while j >= 0 and a[j] > key:   # shift bigger values right
                a[j + 1] = a[j]
                j -= 1
            a[j + 1] = key                 # drop key into the gap
        return a
    
    print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
    
    • 실제 코드에서는 Python의 내장 sorted()을 사용하십시오:
    print(sorted([5, 2, 4, 1]))           # [1, 2, 4, 5]
    
    13.3

    알고리즘 효율성

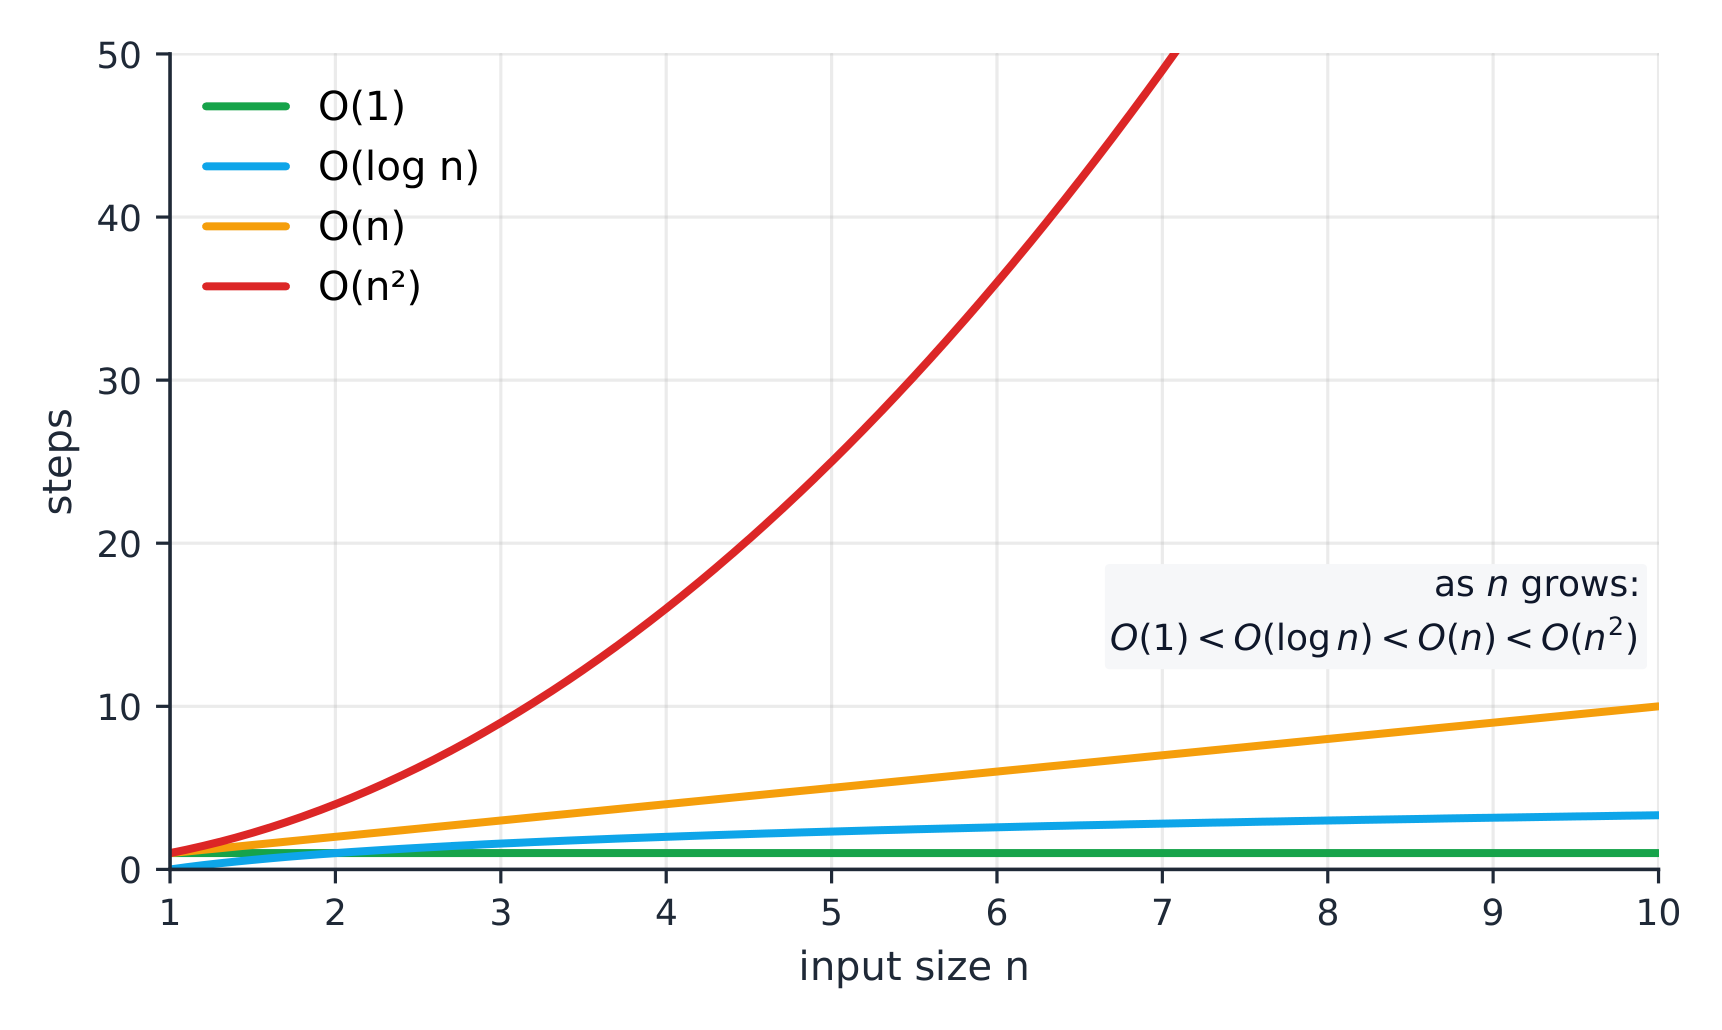
    효율성은 입력이 커질수록 작업량이 어떻게 증가하는지를 묻습니다. 이를 Big-O 표기법으로 설명합니다.

    일반적인 복잡도별 입력 크기 대비 단계 수 증가 추이
    일반적인 복잡도별 입력 크기 대비 단계 수 증가 추이
    Big-O 이름 예시
    $O(1)$ 상수 사전 데이터 구조의 키 조회
    $O(\log n)$ 로그(logarithmic) 이진 탐색(binary search)
    $O(n)$ 선형 선형 검색
    $O(n^2)$ 이차 버블 정렬
    def steps(n):           # how many steps a linear scan takes
        count = 0
        for i in range(n):
            count = count + 1
        return count
    
    print(steps(100))       # 100  -> O(n)
    
    13.4

    무작위성 및 시뮬레이션

    random 모듈은 무작위 숫자를 생성합니다. 결과를 재현 가능하게 하기 위해 시드(seed)를 사용하십시오. 시뮬레이션은 많은 무작위 시련(trial)을 수행하여 답을 추정합니다.

    import random
    random.seed(0)
    rolls = [random.randint(1, 6) for _ in range(1000)]
    print(rolls.count(6))   # about 1/6 of 1000
    

    Common mistakes

    • 이진 검색은 오직 정렬된 리스트에서만 작동합니다.
    • Big-O는 정확한 시간이 아니라 시간이 어떻게 증가하는지 알려줍니다. O(n²) 방식은 O(n)보다 작은 입력에서만 유리합니다.
    • 버블 정렬은 O(n²) — 학습용으로는 적절하지만, 큰 리스트에서는 느립니다.
  • 14 OOP 및 패러다임
    14.1

    클래스 및 객체

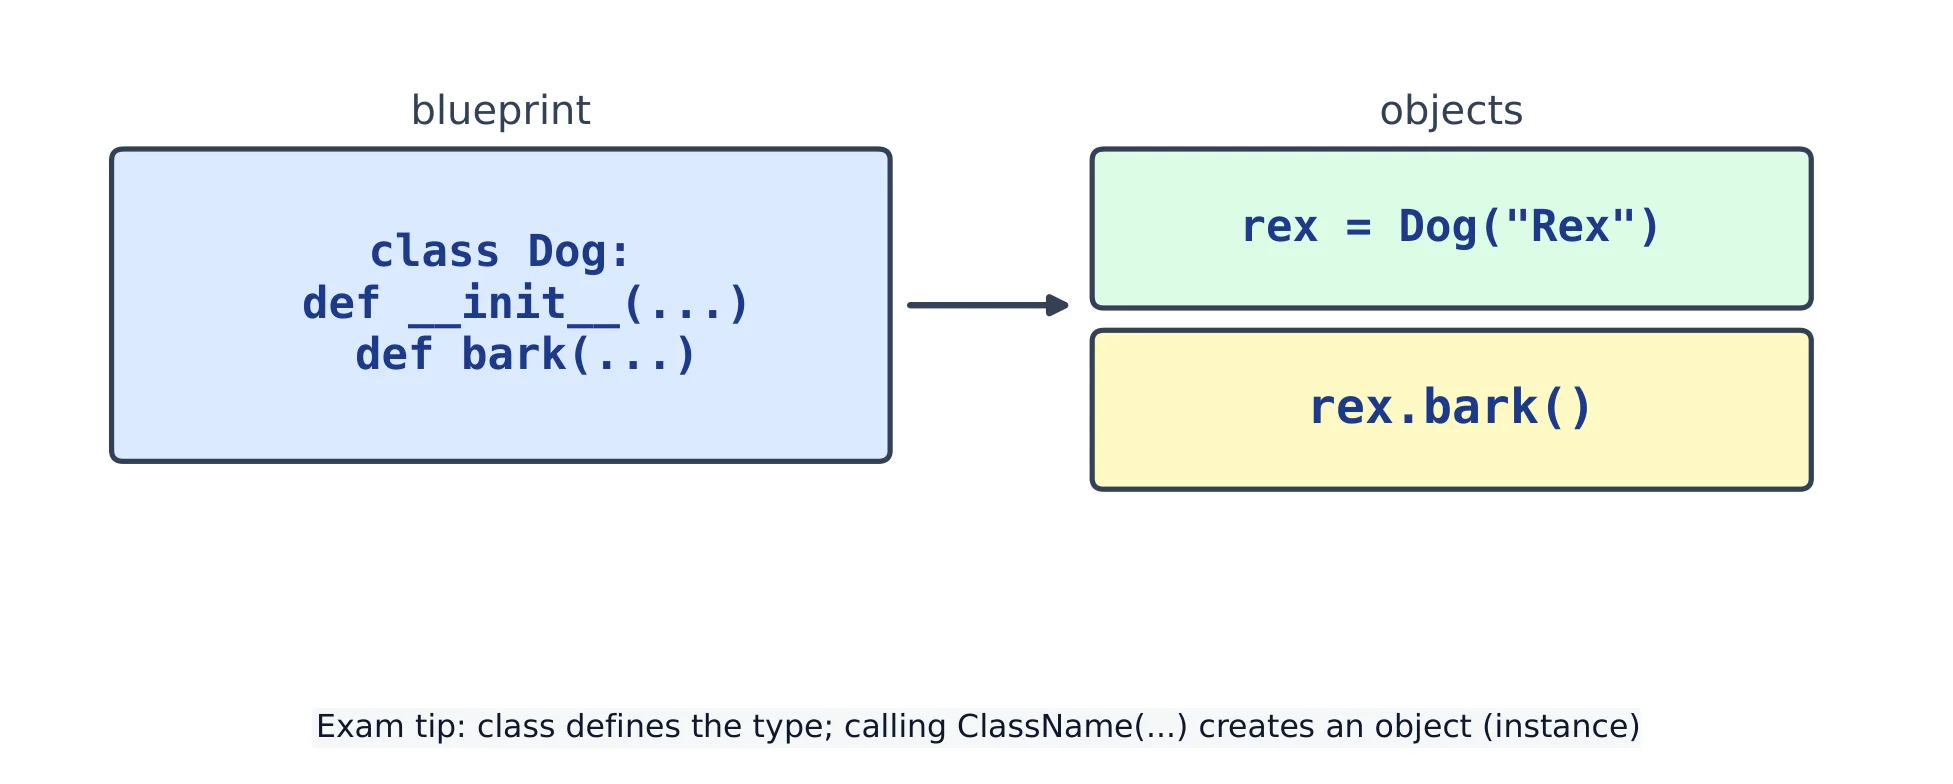
    클래스는 청사진입니다. 객체는 이를 바탕으로 만들어진 단일 인스턴스(instance)입니다. __init__는 각 객체를 설정하는 생성자(constructor)이며, self은 객체 자체입니다.

    class Dog:
        def __init__(self, name):
            self.name = name            # an attribute
        def speak(self):
            return self.name + " says woof"
    
    d = Dog("Rex")
    print(d.speak())     # Rex says woof
    
    • name은 속성(attribute, 객체의 데이터)이고, speak은 메소드(method, 행동)입니다.

    print(obj)의 출력을 제어하려면 __str__을 추가하십시오:

    class Dog:
        def __init__(self, name):
            self.name = name
        def __str__(self):
            return f"Dog named {self.name}"
    
    print(Dog("Rex"))    # Dog named Rex
    
    클래스는 설계도이며, 이를 호출하면 객체가 생성됩니다
    클래스는 설계도이며, 이를 호출하면 객체가 생성됩니다
    14.2

    상속, 캡슐화 및 다형성

    상속(subclass)은 superclass의 기능을 재사용할 수 있게 합니다. parent를 호출하려면 super()을 사용하고, 메소드를 오라이드(override)하여 변경할 수 있습니다.

    class Animal:
        def speak(self):
            return "some sound"
    
    class Cat(Animal):
        def speak(self):                # override
            return "meow"
    
    print(Cat().speak())   # meow
    

    캡슐화는 데이터를 메서드와 묶어 의도한 인터페이스를 노출합니다. Python에서는 앞쪽 언더스코어는 비공용(보통 ‘프라이빗’이라 불림)임을 관례로 표시하며, 외부 코드 접근을 막지는 않습니다. 더블 리딩 언더스코어 네임 맨글링은 보안 강화를 위한 것이 아니라 우발적인 서브클래스 네임 충돌을 피하기 위함입니다.

    class Account:
        def __init__(self):
            self._balance = 0           # non-public by convention
        def deposit(self, n):
            self._balance += n
        def balance(self):
            return self._balance
    
    a = Account()
    a.deposit(50)
    print(a.balance())     # 50
    

    다형성은 하나의 이름으로 여러 행동을 의미하며, 각 객체에 맞는 올바른 speak가 실행됩니다.

    class Cat:
        def speak(self):
            return "meow"
    
    class Cow:
        def speak(self):
            return "moo"
    
    for animal in [Cat(), Cow()]:
        print(animal.speak())   # meow, then moo
    
    14.3

    프로그래밍 패러다임

    파라다임(paradigm)은 프로그래밍 스타일입니다. 프로세듀럴 코드는 단계와 함수의 연속입니다. 객체 지향 코드는 데이터와 메소드를 객체로 묶습니다. 선언적(declarative) 코드는 '어떻게'가 아니라 **'무엇'**을 원하는지 명시합니다(예: 리스트 컴프리헨션 또는 SQL).

    def total(nums):           # procedural
        t = 0
        for n in nums:
            t += n
        return t
    print(total([1, 2, 3]))    # 6
    
    print(sum([1, 2, 3]))      # 6  (declarative: same result)
    

    Common mistakes

    • 모든 메서드는 첫 번째 매개변수로 self을 필요로 합니다.
    • __init__은 새 객체를 설정하고, 객체를 생성할 때 자동으로 실행됩니다.
    • Two objects of the same class have separate attributes; changing one does not change the other.
  • 15 데이터 표현
    15.1

    비트 및 이_Handle 진법

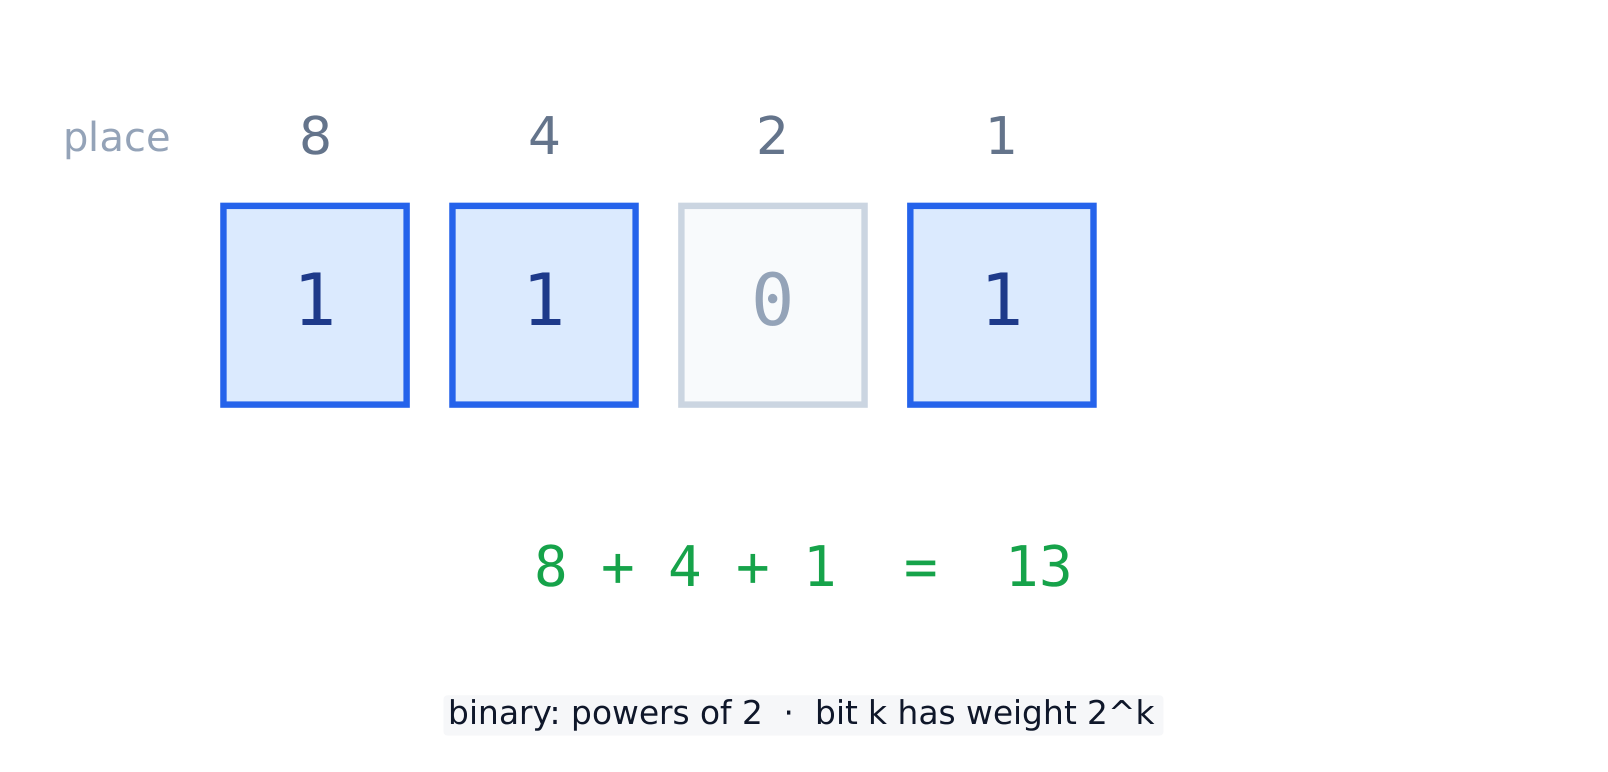
    비트는 단일 0 또는 1입니다. 이_Handle는 base-2 진법으로, 각 자릿수는 오른쪽 자릿수보다 두 배의 가치를 가집니다 (1, 2, 4, 8, …). 데나리(base-10)는 우리가 사용하는 일반 숫자 체계입니다.

    이_Handle 진법 자리 값: 1101은 8 + 4 + 1 = 13을 의미합니다
    이_Handle 진법 자리 값: 1101은 8 + 4 + 1 = 13을 의미합니다
    print(bin(13))         # 0b1101
    print(int("1101", 2))  # 13
    
    • 8개의 비트가 바이트(byte)를 구성합니다. 고정 폭(fixed width)에서 숫자가 너무 크면 오버플로우(wrap around)가 발생할 수 있습니다.
    x = 250
    x = (x + 10) % 256     # one byte wraps at 256
    print(x)               # 4
    

    HEXadecimal(16진법)은 이_Handle를 쉽게 읽기 위한 간결한 방법입니다. 한 HEX digit는 정확히 네 비트를 나타냅니다. Python은 0x으로 HEX을 출력합니다:

    print(hex(255))        # 0xff
    print(0xFF)            # 255
    print(int("ff", 16))   # 255
    
    15.2

    압축

    압축(compression)은 데이터를 작게 만듭니다. 무손실 압축(lossless compression)은 모든 비트를 보존하므로 원본을 정확히 복원할 수 있습니다. 무손실 압축(lossy compression)은 디테일을 제거하여 더 작지만 완벽하지 않으며, 사진과 음악에 사용됩니다.

    런-렌스 인코딩은 간단한 무손실 방법입니다: 연속된 값(반복)을 개수와 값으로 저장합니다.

    def rle(text):
        out = ""
        i = 0
        while i < len(text):
            run = 1
            while i + run < len(text) and text[i + run] == text[i]:
                run += 1
            out += str(run) + text[i]
            i += run
        return out
    
    print(rle("AAAABBBCCD"))   # 4A3B2C1D
    

    Common mistakes

    • n 비트는 0부터 2**n - 1까지 총 2**n가지 다른 값을 저장할 수 있습니다.
    • 무손실 압축(lossy compression)은 디테일을 제거하여 되돌릴 수 없으며, 무손실 압축(lossless compression)은 정확히 역행 가능합니다.
  • 16 컴퓨팅 개념
    16.1

    컴퓨팅의 정의 및 디자인 사이클

    컴퓨팅은 컴퓨터를 사용하여 문제를 해결하는 것: 입력, 처리, 출력. 좋은 소프트웨어는 디자인 사이클(계획, 작성, 테스트, 개선)을 여러 번 반복하여 구축됩니다.

    • 문제를 분해하고, 작은 부분을 만들고, 테스트한 후 더 추가하십시오.
    • 프로그래머는 팀으로 협력하며 서로의 코드를 재사용합니다.
    16.2

    인터넷(Internet)

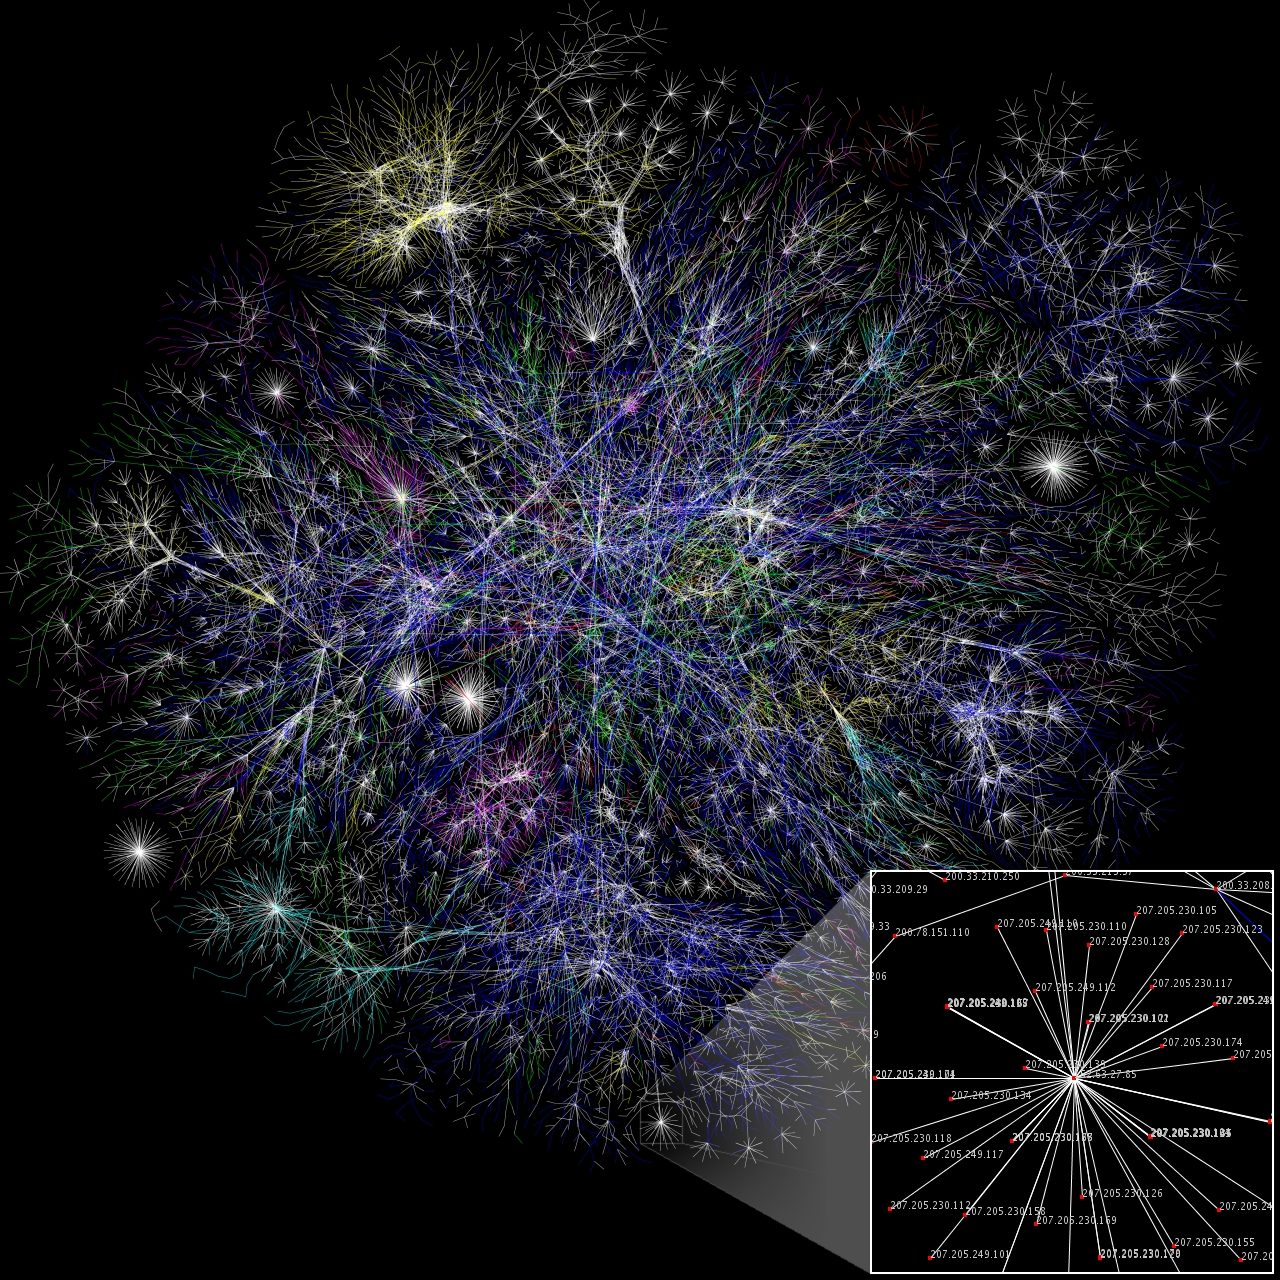
    인터넷은 네트워크들의 네트워크입니다. 데이터는 패킷(packet)으로 분리되어 개별적으로 전송되며, 수신 측에서 다시 합쳐집니다. TCP/IP와 같은 프로토콜(protocol)이라는 공유 규칙이 이를 가능하게 합니다. 한 경로가 끊어지면 패킷은 다른 경로를 이용합니다 — 이는 리던던시(redundancy)이며, Fault tolerance(내결함성)를 제공합니다.

    인터넷 지도: 각 선은 두 네트워크 간의 경로입니다
    인터넷 지도: 각 선은 두 네트워크 간의 경로입니다
    레이어 역할
    HTTP 웹 페이지 요청 및 전송
    TCP 신뢰 가능한 전달, 순서 보장
    IP 주소 지정 및 라우팅
    16.3

    병렬 및 분산 컴퓨팅

    순차적 코드는 한 단계씩 수행합니다. 병렬 컴퓨팅은 여러 코어에서 여러 단계를 동시에 수행하여 속도를 높일 수 있습니다. 분산 컴퓨팅은 클라우드와 같은 여러 컴퓨터에 작업을 분산시킵니다.

    • 모든 것이 병렬로 실행되는 것은 아닙니다: 일부 단계는 이전 결과의 처리를 기다려야 합니다.
    16.4

    컴퓨팅의 영향

    컴퓨팅은 이점과 해로운 측면을 모두 가집니다. 디지털 격차는 모든 사람이 동등하게 접근할 수 있음을 의미하지 않습니다. 소프트웨어는 학습하는 데이터로부터 편향을 포함할 수 있습니다. 지적 재산권(라이선스)을 존중하고, 사람들의 개인정보 및 프라이버시를 보호하십시오.

    Common mistakes

    • 인터넷과 월드 와이드 웹은 다릅니다: 웹은 인터넷 위에서 작동하는 하나의 서비스입니다.
    • 더 많은 프로세서 코어가 도움이 되려면 작업이 동시에 실행되는 부분으로 나뉠 수 있어야 합니다.
  • 17 모아보기
    17.1

    엔드 투 엔드 미니 프로젝트

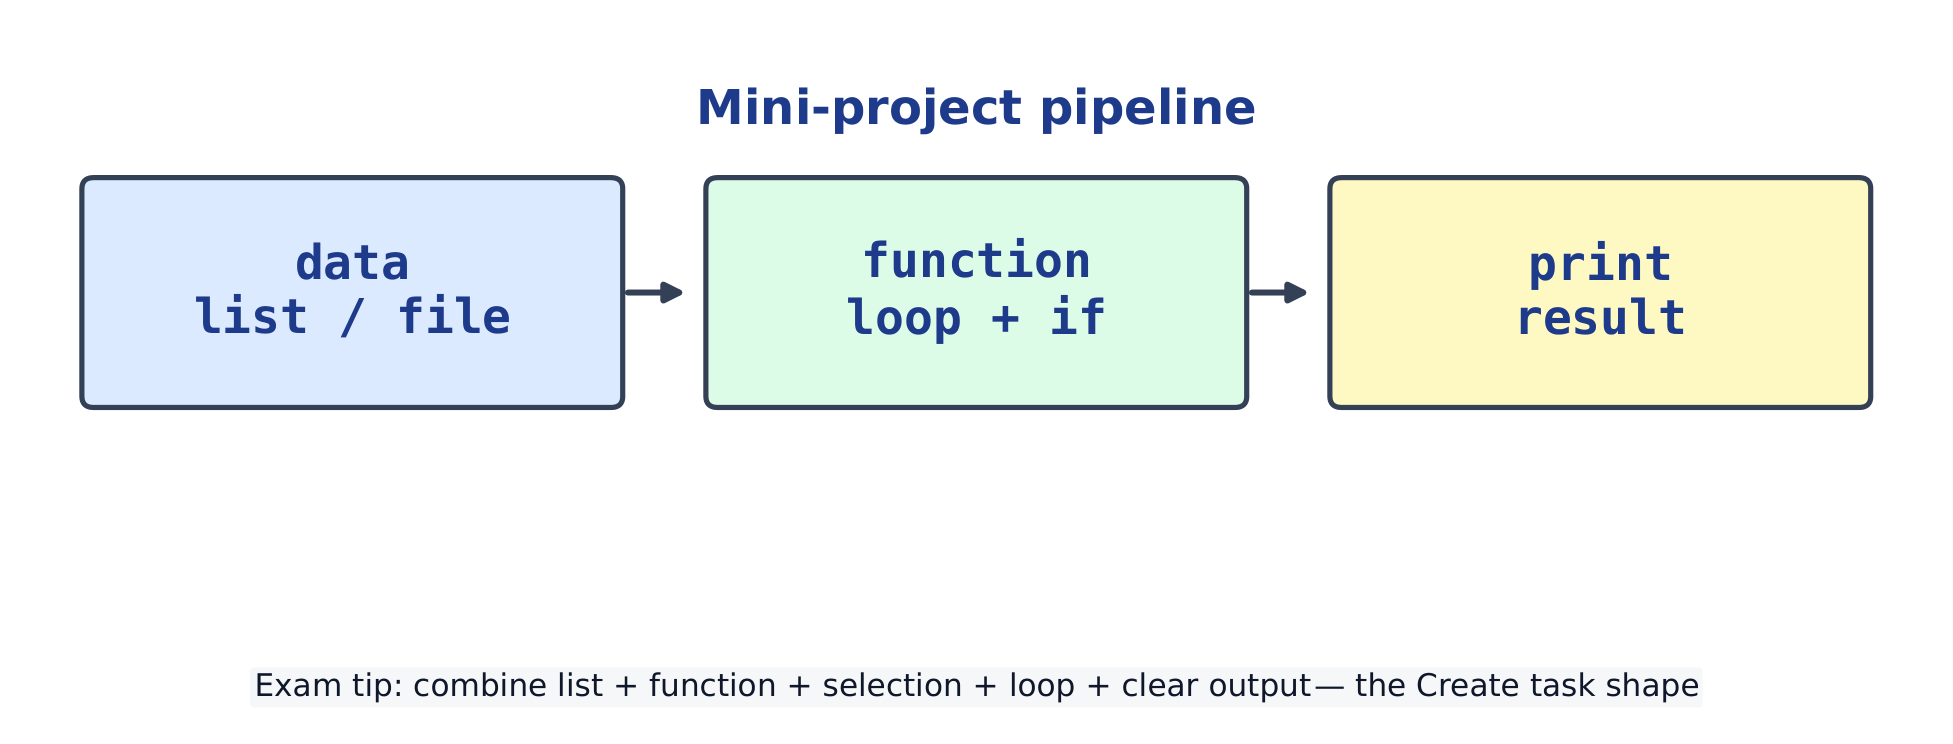
    미니 프로젝트는 이전 아이디어들을 결합합니다: 리스트 안의 데이터, 루프 내 선택 문이 있는 함수, 그리고 출력된 결과물입니다. 이는 AP Create Performance Task의 형태이기도 합니다.

    프로젝트: 평균 점수

    def average(marks):
        if len(marks) == 0:
            return 0
        return round(sum(marks) / len(marks), 1)
    
    print(average([88, 71, 95, 60]))   # 78.5
    

    프로젝트: 합격자 수 세기

    def count_passes(marks, pass_mark=60):
        passes = 0
        for m in marks:                 # iteration
            if m >= pass_mark:          # selection
                passes += 1
        return passes
    
    print(count_passes([88, 50, 95, 60]))   # 3
    

    프로젝트: 새 리스트로 필터링하기

    def merit(marks):
        return [m for m in marks if m >= 80]
    
    print(merit([88, 71, 95, 60]))     # [88, 95]
    

    AP Create Task는 리스트, 선택 및 반복을 사용하는 매개변수가 있는 프로시저, 그리고 일부 입력/출력을 요구합니다. 위의 각 프로젝트는 정확히 그 형태를 띱니다 — 작은 조각을 만들고, 이를 연결하십시오.

    Common mistakes

    • 작은 단계로 만들거나, 다음 단계로 넘어가기 전에 각 부분을 테스트하십시오 — 한 번에 모두 작성하지 마십시오.
    • 먼저 전체 과제를 읽고, 코딩하기 전에 입력 → 처리 → 출력을 계획하십시오.
    미니 프로젝트: 데이터 → 함수 → 출력된 결과
    미니 프로젝트: 데이터 → 함수 → 출력된 결과

로그인 또는 계정 만들기

IGCSE, A-Level & AP