
통계 2: 분포, 연속변수 및 가설검정
통계 2 (S2, 시험지 WST02/01, 1시간 30분, 75점, 첫 평가 6월 2020년) 적용 경로에서 S1를 따릅니다: P1–P2 및 S1가 가정됩니다. 이 책자에는 이항분포, 포아송 분포 및 정규 분포 표가 포함되어 있습니다. 이 참고 자료는 이항분포와 포아송 분포의 근사법, 연속 확률 변수, 균일 분포, 표본 추출 및 완전한 가설 검정 절차를 다룹니다. 이항분포와 포아송 분포의 근사법, 연속 확률 변수, 균일 분포, 표본 추출 및 완전한 가설 검정 절차를 포함합니다.
S2 필수 지식 (책자에 포함되지 않음):
| 계열 | 공식 |
|---|---|
| 이항분포 | $X\sim B(n, p)$: $E(X) = np$, $\mathrm{Var}(X) = np(1-p)$, $P(X = r) = \binom nr p^r(1-p)^{n-r}$ |
| 포아송분포 | $X\sim\mathrm{Po}(\lambda)$: $E(X) = \mathrm{Var}(X) = \lambda$; 속도는 시간에 비례하여scaled |
| 연속분포 | $P(a < X < b) = \int_a^b f(x)\,dx$, $f(x) = F'(x)$, $E(X) = \int xf(x)\,dx$, $E(X^2) = \int x^2f(x)\,dx$ |
| 균일분포 | $[a, b]$ 구간: 평균 $\tfrac{a+b}2$, 분산 $\tfrac{(b-a)^2}{12}$, 밀도 $\tfrac1{b-a}$ |
이항분포와 포아송분포
이항분포: $n$ 독립 시연, 일정 확률 $p$ — 문맥에서 명시해야 할 두 가정. 포아송분포: 사건은 단일, 독립적으로 발생하며 일정한 평균 속도를 가짐 — 이 속도는 스케일 ($\mathrm{Po}(\lambda)$ per minute gives $\mathrm{Po}(5\lambda)$ in 5 minutes). 모멘트 공식으로 제공됩니다: $np$과 $np(1-p)$; $\lambda$과 $\lambda$. 이항분포의 평균과 분산을 주었을 때, $n$과 $p$를 동시에 구하십시오. 포아송 근사는 이항분포에 대해 $n$이 크고 $p$이 작아야 합니다 ($\lambda = np$ 사용).
Worked example — moments then approximations (WST02 June 2025 Q3). Blue sweets per small bag have mean 3 and variance 2.55: $np = 3$ and $np(1-p) = 2.55$ give $1 - p = 0.85$, so $p = 0.15$과 $n = 20$입니다. 중봉투 40개에 초록색이 20% 포함됨: $X\sim B(40, 0.2)$, $E(X) = 8$, and $P(X > 8) = 1 - P(X \le 8) = 0.407$. A large bag of 80 with 10% yellow: with $n = 80$ large and $p = 0.1$ small, $X\approx\mathrm{Po}(8)$ and $P(X \ge 12) = 1 - P(X \le 11) = 0.112$.
연속 확률변수
연속 확률 변수는 확률 밀도 함수 $f$을 가지며, 전체 면적은 1이고 모든 점에서 $P(X = x) = 0$입니다. 누적 분포 함수 $F(x) = P(X \le x)$은 $f = F'$과 $F(a) = \int_{-\infty}^a f$를 만족합니다. 조각별 밀도: normalise $\int f = 1$ (which pins the unknown constant), then read off the median ($F = \tfrac12$), quartiles, and the mode from the peak of $f$ (set $f' = 0$, or inspect corners). $E(X) = \int xf\,dx$, $E(X^2) = \int x^2f\,dx$, $\mathrm{Var} = E(X^2) - [E(X)]^2$; 치우침 평균, 중위수 및 최우값을 비교합니다.

해설 예제 — CDF 해설 (WST02 6월 2025 Q1). $F(x) = k(6x^2 - x^4)$에 [0, 1]: $F(1) = 1$는 $5k = 1$을 ▶$P(X > 0.6) = 1 - \tfrac{6(0.36) - 0.1296}{5} = 0.594$. 중앙값: $\tfrac{6m^2 - m^4}{5} = \tfrac12$, 즉 $2m^4 - 12m^2 + 5 = 0$이므로, $m = 0.671$. 최빈값: $f(x) = \tfrac{12x - 4x^3}{5}$과 $f'(x) = \tfrac{12 - 12x^2}{5} = 0$ $x = 1$을 줌 ($-1$은 지지 범위 밖이므로 기각). 왜곡도: 평균 $0.64 <$, 중앙값 $0.671 <$ 최우치 $1$ — 음의 왜도.

해설 예제 — 조각선형 확률밀도함수, 계산기 사용 불가 (WST02 6월 2025 Q5). 다음과 같이, $f(x) = \tfrac{2x}{21}$이 $[0, k]$에, $f(x) = \tfrac{2(6-x)}{15}$이 $(k, 6]$에: 정규화하여,
따라서 $k = 3.5$ (여기서 확률밀도함수는 연속이며 두 부분 모두 $\tfrac13$와 같음). 따라서 $E(X) = \tfrac{2}{21}\cdot\tfrac{k^3}{3} + \tfrac{2}{15}\int_{3.5}^6(6x - x^2)dx = \tfrac{19}6$, 그리고 $E(X^2) = \tfrac{277}{24}$이 주어졌으므로, $\mathrm{Var}(X) = \tfrac{277}{24} - \tfrac{361}{36} = \tfrac{109}{72}$.
연속 균일 분포
$[a, b]$ 위의 연속 균일 분포 $[a, b]$ 위의 균일 분포: 밀도 $\tfrac1{b-a}$, 직선형 누적분포함수, 평균 $\tfrac{a+b}2$, 분산 $\tfrac{(b-a)^2}{12}$. 두 사실은 $a$과 $b$을 결정함(구간 확률은 $b - a$ 제공; 평균은 $a + b$ 제공). 코딩 스케일은 평균을 조정하고, 확률은 $b - a$ 길이에 대한 비율임.
해설 예제 — 넓은 구간에서 균등 분포 (WST02 June 2025 Q6). $a\le2$와 $b\ge5$라고 가정합니다. 그러면 $P(2 < X < 5) = \tfrac3{16}$ gives $b - a = 16$; $E(X) = 6$ gives $a + b = 12$: so $a = -2$, $b = 14$ 그런 지지 범위 가정이 없으면, $a=4.4$과 $b=7.6$도 두 가지 주어진 사실에 만족함; 아래 계산에서는 명시된 지지 범위 가정을 사용함. $E(cX + 1) = 3$은 $c = \tfrac13$을 ▶$\mathrm{Var} = \tfrac{256}{12} = \tfrac{64}3$; $E(X^2) = \tfrac{64}3 + 36 = \tfrac{172}3$; and $P(\tfrac32X - b > a) = P(X > \tfrac{2(a+b)}3) = P(X > 8) = \tfrac{14-8}{16} = \tfrac38$.
모집단, 표본 및 통계량
전원 조사는 모든 사람을 측정하는 것을 목표로 함(완전하지만 비용이 많이 들고, 느리며, 파괴적일 수 있음). 표본 추출은 인구 중 선정한 일부만 측정하는 것이며, 선택된 단위는 표본이라고도 함(더 저렴하고 빠르지만 표본 오차가 있음). 표본 프레임은 표본 단위를 나열한 목록임. 통계량은 표본 값만을 함수로 하는 것임(알 수 없는 모수는 포함하지 않음) — $\bar X$은 통계량이지만, $\bar X - \mu$은 그렇지 않다. 반복적인 표본에서 이 통계량의 분포를 **표본 분포(sampling distribution)**라고 한다.
해설 예제 — 표본 분포 (WST02 6월 2025 Q4). 2:5 black:white bag, scoring 4 per black and 1 per white: with $P(\text{black}) = \tfrac27$, the score $X$ takes 3, 6, 9, 12 with probabilities $\tfrac{125}{343}, \tfrac{150}{343}, \tfrac{60}{343}, \tfrac{8}{343}$ (binomial weights $\binom30(\tfrac57)^3$ etc.). If $Y$는 9점을 얻는 집합이 $n$개의 독립적 실행 중 나타날 경우의 수이며, $Y\sim B(n, \tfrac{60}{343})$와 $1 - (\tfrac{283}{343})^n > 0.95$를 얻기 위해 $n > 15.6$이 필요하므로, $n = 16$.
가설 검정
가설 검정은 데이터를 영가설 모델과 비교합니다.
영가설 $H_0$(변화가 없음, 인용된 모수)과 $H_1$(질문에 따라 한쪽 또는 양쪽 꼬리)을 명시하십시오. 다음을 구하십시오: 명시된coding level에서 총 귀무확률이 $\alpha$을 초과하지 않는 꼬리를 선택하여 비판구(critical region) 를 설정하십시오. 실제 유의수준(significance level) 은 총 꼬리 확률로 보고하십시오. 단측검정 단측 검정은 전체 수준을 한 쪽 꼬리에 배치하고, 양측 검정은 이를 나눈다. 결론은 문맥 속에 명시해야 한다: "…이 변했다는 충분한 증거가 없다". 이항 분포의 정규 근사: 평균 $np$, 분산 $np(1-p)$이며, **연속성 보정(continuity correction)**을 적용할 때는 적어도 $t$을 의미하므로 $t - 0.5$로 처리한다.
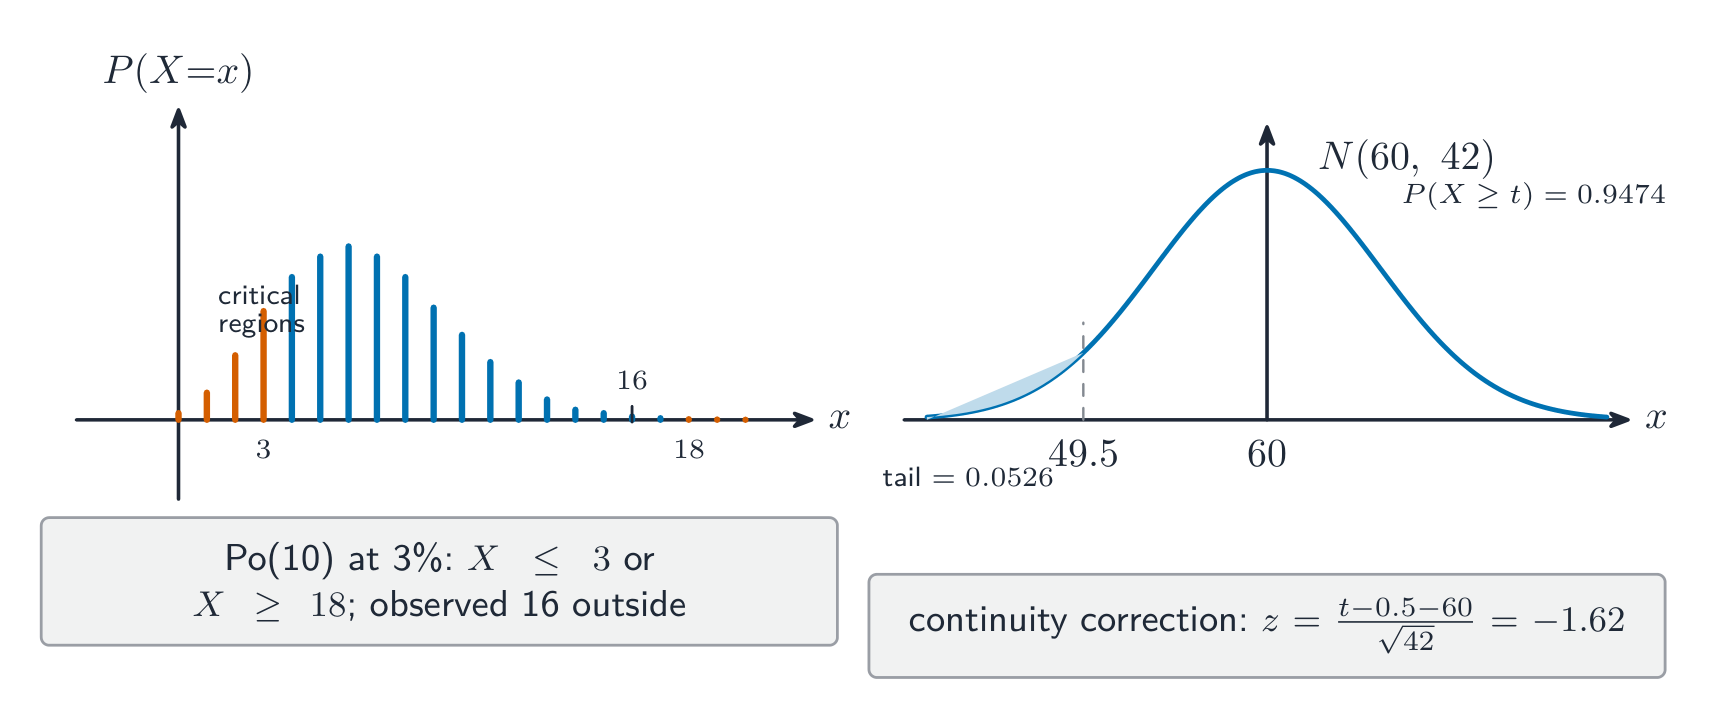
해설 예제 — 포아송 비율 검정 (WST02 6월 2025 Q2). 고객당 평균 20/시간; 변경 후 30분 간격이 관찰됨: $X\sim\mathrm{Po}(10)$, $H_0\colon\lambda = 10$, $H_1\colon\lambda \ne 10$. 3%에서: $P(X \le 3) = 0.0103$이지만 $P(X \le 4) = 0.0293$(너무 큼); $P(X \ge 17) = 0.0270$이지만 $P(X \ge 18) = 0.0143$ — 기각 영역 $X \le 3$ 또는 $X \ge 18$, 실제 수준 $0.0103 + 0.0143 = 2.46\%$. 관측된 16이 범위를 벗남 → $H_0$을 기각하지 않음.
해설 예시 — 정규 분포 중심 이항 검정 (WST02 6월 2025 Q7). 30%의 고객 중 보험 가입자는 표본 40명 중 $X\sim B(40, 0.3)$명임. $r$이 되는 최대 $P(X < r) < 0.05$ (fewer than $r$): $P(X \le 6) = 0.0238 < 0.05$ but $P(X \le 7) = 0.0553 > 0.05$, so $r = 7$. 200 고객에게 대해, $B(200, 0.3)\approx N(60, 42)$: $P(X \ge t) = 0.9474$을 의미함 $\tfrac{t - 0.5 - 60}{\sqrt{42}} = -1.62$, $t = 50$; 11이므로 25을 기각함 — $H_0\colon p = 0.3$, $H_1\colon p > 0.3$; $P(X \ge 11) = 0.0978 < 0.10$이므로 $H_0$를 기각함 — 비율이 증가했음을 보여주는 증거입니다.
이 단원을 완료하기 전 체크리스트
- 문맥에 따른 이항분포/푸아송 분포 가정 서술; $n$, $p$에 대한 평균/분산 쌍 풀이; 시간 비례를 통한 푸아송 비율 확대.
- 분할 밀도 함수를 정규화(상수, 완전제곱수 형태); F를 미분하여 f 구하기; F로부터 중앙값/사분위 수, f' 또는 꼭지점에서 최빈값 구하기; E(X), E(X²), 분산 계산; 평균·중앙값·최빈값의 관계에서 왜도 판독.
- 균일 분포의 사실을 인용하고 유도함; a와 b를 구간과 평균을 통해 결정함; 확률을 길이의 형태로 유지함.
- 일측/양측 검정 수행; 기호 및 문구로 가설 설정; 누적에 의한 기각 영역, 실제 유의 수준, 문맥 내 결론; n이 클 때 continuity correction 적용 정규 근사법.
- 양측 및 단측 검정 수행: 기호 및 언어로 된 가설 설정; 적분으로 임계 영역 도출; 실제 유의수준 산출; 문맥 기반 결론 내리기; n이 클 때连续性 보정 적용 정량 근사법 사용.