정렬 및 열
이 페이지는 최신 브라우저(SharedArrayBuffer 지원)가 필요합니다. Chrome, Edge, Firefox 또는 Safari를 최신 버전으로 업데이트해 주세요.
줄 정렬하기
sort는 줄을 알파벳 순서로 배치합니다(또는-n을 사용하면 숫자 순서):
sort names.txt
sort -r는 순서를 반전시키고,sort -n은 숫자 목록에 적합합니다.
중복 제거
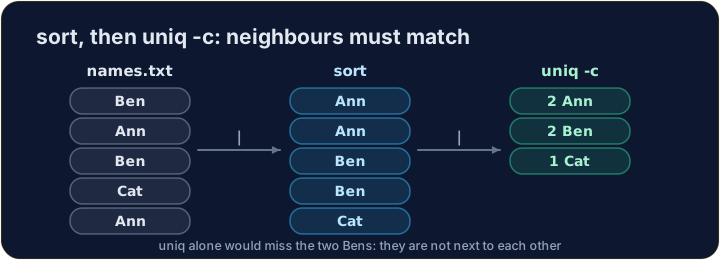
uniq는 인접한 반복되는 줄만 제거합니다. 인접한 것만 보기 때문에 보통sort을 먼저 실행해야 합니다:
sort names.txt | uniq
uniq -c를 추가하면 각 줄이 몇 번 나타났는지 세어 줄 수 있습니다.
탐색하기
sort, then uniq
uniq는 이웃만 보게 됩니다 — sort 먼저 하므로 중복된 것들이 함께 배치됩니다.
열 추출하기
- 많은 파일이 comma, colon, tab 같은 문자로 열이 분리되어 있습니다.
cut가 원하는 열을 추출합니다.-d은 delimiter(구분자)를 설정하고,-f은 field(필드)를 지정합니다:
cut -d : -f 1 people.txt
- 이는 각
name:age줄의 첫 번째 필드 — 이름들을 가져옵니다.
흔한 실수
sort는 알파벳순이며,sort -n은 숫자를 올바르게 정렬합니다.cut는 올바른 delimiter와 함께-d이 필요합니다.
난이도 3/5 · 200코인 + 오늘 첫 완료 시 작은 보너스 추가
정리되고 중복이 제거된 이름 목록을 얻으십시오. sort를 uniq로 파이프하세요: sort names.txt | uniq.
난이도 3/5 · 200코인 + 오늘 첫 완료 시 작은 보너스 추가
people.txt의 각 줄에는 name:age이 있습니다. cut -d : -f 1 people.txt를 사용하여 이름만 추출하세요.
난이도 3/5 · 200코인 + 오늘 첫 완료 시 작은 보너스 추가
각 이름이 names.txt에 몇 번 나타납니까? 각 이름을 한 번씩 표시하고, 앞에 개수를 붙이십시오.
난이도 3/5 · 200코인 + 오늘 첫 완료 시 작은 보너스 추가
sizes.txt에는 세 가지 파일 크기가 있습니다. 이들을 숫자로 정렬하여 크기 순서로 나열하십시오. (단순 sort -r은 9을 먼저 배치합니다: 문자열로 비교하기 때문입니다.)