ソースコードはインタープリタを経て出力を生成します
print() 関数は画面にテキストを表示します。これを出力(アウトプット)と呼びます。引用符内のテキストは文字列です。
print("Hello, world!")
print("I am learning Python")
- 各
print()は新しい行を開始する。 - 引用符は
"double"または'single'のどちらでも構いません — どちらも文字列を作ります。 - プログラムを実行するまでは何もしません。
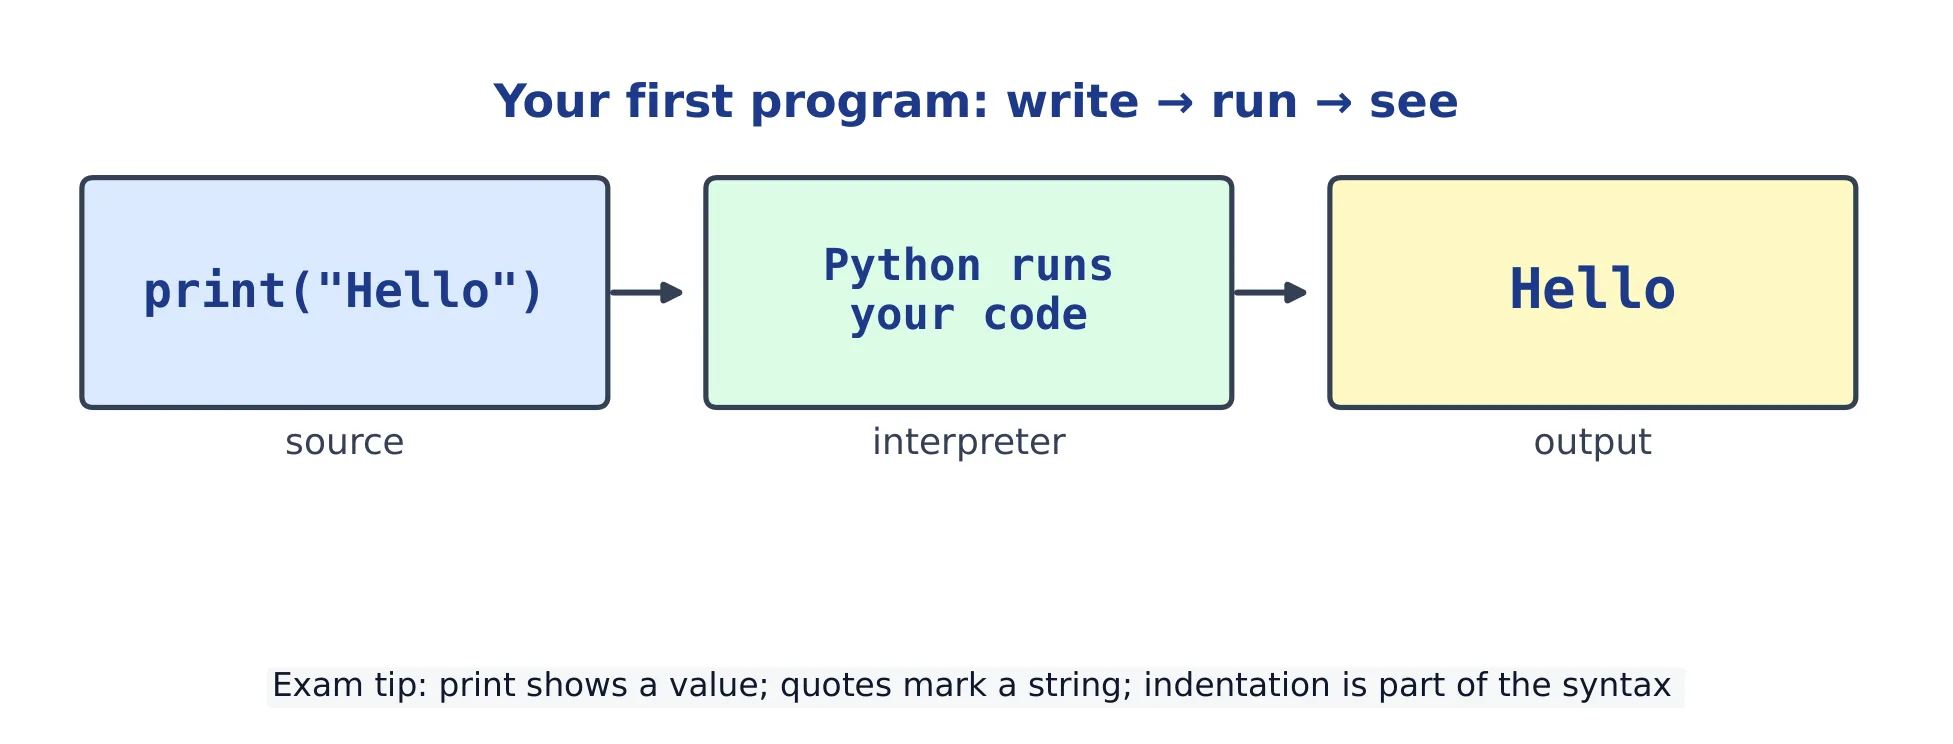
ソースコードはインタープリタを経て出力を生成します
print() 関数は画面にテキストを表示します。これを出力(アウトプット)と呼びます。引用符内のテキストは文字列です。
print("Hello, world!")
print("I am learning Python")
print()は新しい行を開始する。"double" または 'single' のどちらでも構いません — どちらも文字列を作ります。コメントは # で始まります。Python はその行の # の後のすべてのものを無視します。コメントは他の人がコードを理解するためにあり、コードの動作自体を変えるものではありません。
# This line is a note for humans
print("Hi")        # you can also comment at the end of a line
良いスタイルはコードを読みやすくします:
多くのプログラムは単純な手順に従う:入力 → 処理 → 出力。データを取得し、それに対して何らかの操作を行い、結果を表示する。
input()関数はユーザーが入力したテキストを読み込む。常に文字列を返す。
name = input("What is your name? ")
print("Hello, " + name)
input()はユーザーが入力してエンターキーを押すのを待つ。input()は文字列を返すので、数値が必要な場合はまずint(...)で変換する。** 一般的なミス **
print(Hello)はHelloという名の変数を検索しようとしてNameErrorを起こす。テキストには引用符が必要:print("Hello")。input()が数値を返すと仮定している。常に文字列を返すので、計算を行う前にint(...)で包む。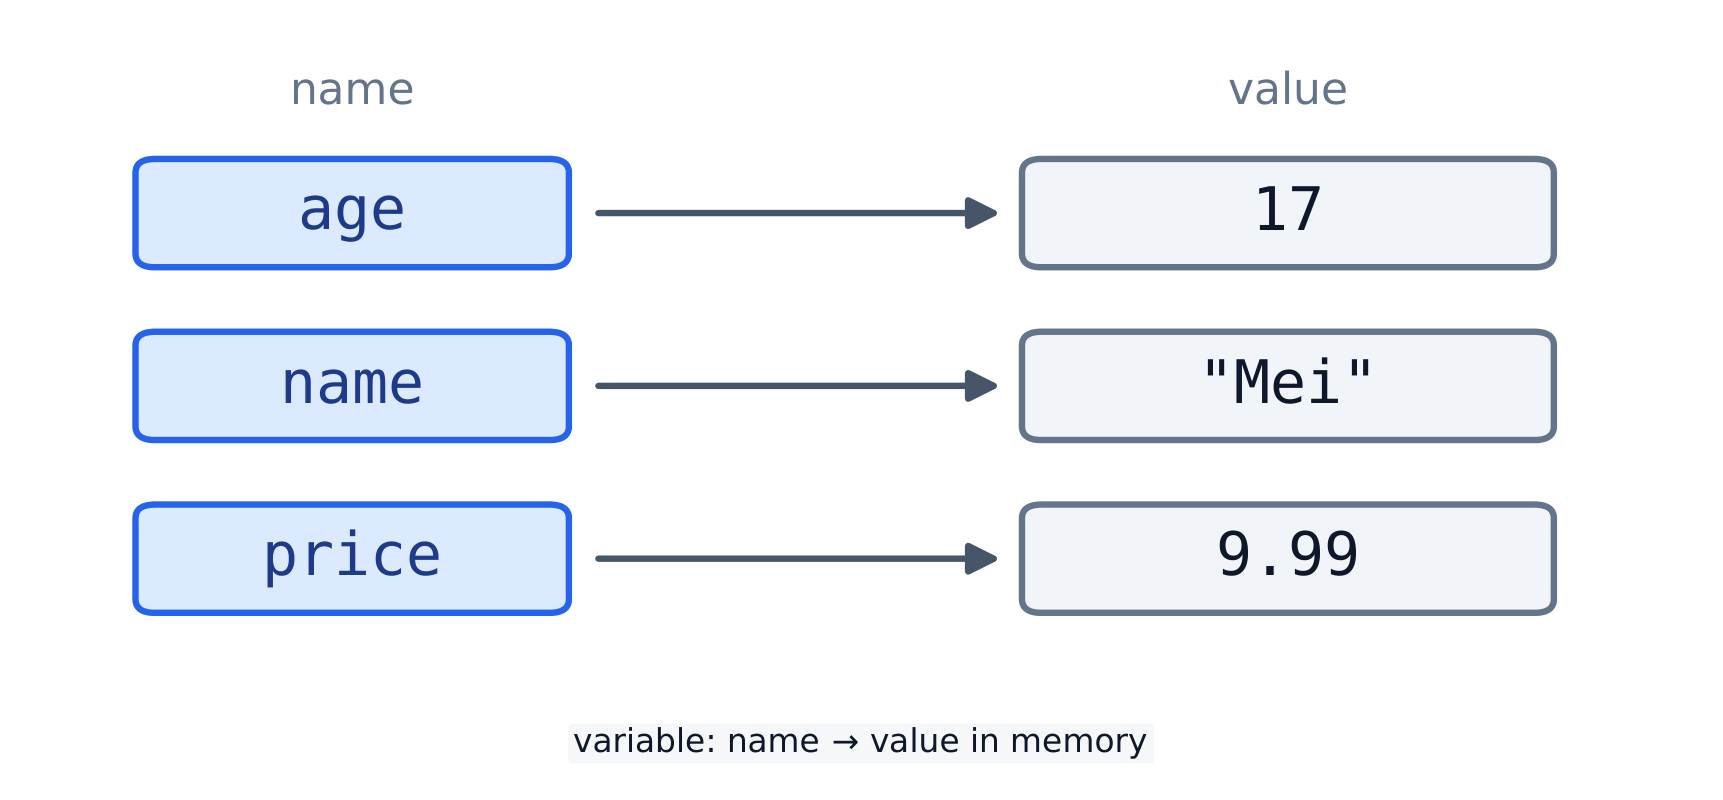
変数は値に対する名前のことである。=を使って作成し、これを代入と呼ぶ。左側に名前、右側に値を書く。
age = 17
name = "Mei"
price = 9.99
print(age, name, price)
今 age は 17 を保持しています。値が必要などこでもこの名前を使用し、後で変更できます:
age = 17
age = age + 1   # age is now 18
print(age)
=記号は「等しい」ではない。「左側の名の下に右側を格納する」ことを意味する。==を使う(以下参照)。Pythonには2つの主要な数値型がある。整数(int)は17のような全体数である。浮動小数点数(float)は9.99のような小数点を持つ。
これらの演算子は数値上で動作する:
| 演算子 | 意味 | 例 | 結果 |
|---|---|---|---|
+ |
加算 | 3 + 2 |
5 |
- |
減算 | 3 - 2 |
1 |
* |
乗算 | 3 * 2 |
6 |
/ |
除算(常にfloat) | 7 / 2 |
3.5 |
// |
整数除算 | 7 // 2 |
3 |
% |
剰余(モジュロ) | 7 % 2 |
1 |
** |
べき乗 | 2 ** 3 |
8 |
/は常にfloatを返すので、4 / 2は2.0である。//と%はセットで使われる:17 // 5は3であり、17 % 5は2である。式とは値を持つもののことであり、3 + 4 * 2のようなものがある。Pythonは通常の数学的な優先順位(*と/が+と-より先)を用いる;順序を明確にするために括弧を入れる。
input()は文字列を返すので、計算する前に変換する。ある型から別の型へ値を変えることを型変換と呼ぶ:
age = int("17")        # text "17" -> number 17
price = float("9.99")  # text -> 9.99
label = str(17)        # number -> text "17"
print(age, price, label)
int("abc")は失敗するため、数字のように見えるテキストのみを変換する。"age: " + 17はエラーです;"age: " + str(17)と書く。ブール値は2つの値のいずれか:TrueまたはFalse。比較演算の結果はブール値を返す。
| 演算子 | 意味 |
|---|---|
== |
等しい |
!= |
等しくない |
< > |
未満 / 超える |
<= >= |
以下 / 以上 |
print(7 > 2)        # True
print(3 == 3.0)     # True
age = 20
print(age >= 18)    # True
and、or、notで比較を結合する:
age = 20
print(age >= 13 and age <= 19)   # True only for a teenager
** 一般的なミス **
/は常にfloatを返す。4 / 2が2.0であっても同様である。全体数が欲しい場合は//を使う。=の代わりに==を使う:=は値を割り当て、==は2つの値が等しいかをテストする。"age: " + 5はTypeErrorを起こす。str(5)で変換してから行う。0.1 + 0.2は0.3と厳密に等しくなく、floatの結果に対して==を使うのは避けるべきである。文字列は引用符内のテキストである。各文字には位置があり、これをインデックスと呼ぶ。最初のインデックスは0であり、1ではない。
角括弧で1文字を読む:
word = "Python"
print(word[0])    # P  (the first character)
print(word[2])    # t
print(len(word))  # 6  (how many characters)
0から始まるので、最後のインデックスはlen(word) - 1である。word[-1]は最後の文字である。word = "Python"
print(word[-1]) # n
print(word[-2]) # o
IndexError)を発生させる。
スライスでは文字列の一部を取得する。word[start:end]と書く。スライスはstartを含み、endの手前で終わる。
word = "Python"
print(word[0:3])   # Pyt   (positions 0, 1, 2)
print(word[2:5])   # tho
start を省略して 0 から始め、end を省略して末尾まで進めます。word = "Python"
print(word[:3]) # Pyt
print(word[3:]) # hon
word[::-1]は文字列を反転する。print("Python"[::-1]) # nohtyP
メソッドは値に属する関数である。ドットを使って呼び出す:
name = "mei chen"
print(name.upper())     # MEI CHEN
print(name.title())     # Mei Chen
print(len(name))        # 8
文字列は不変である:メソッドは新しい文字列を返し、元のものは変更しない。
name = "mei"
print(name.upper())     # MEI  (the returned value)
print(name)             # mei  (the original is unchanged)
一般的なメソッド(すべて新しい値を返す):
| メソッド | 意味 | 例 | 結果 |
|---|---|---|---|
.upper() / .lower() |
大文字・小文字の変換 | "Hi".lower() |
hi |
.strip() |
両端のスペースを削除 | " hi ".strip() |
hi |
.replace(a, b) |
文字の入れ替え | "cat".replace("c", "b") |
bat |
.split(sep) |
リストに分割 | "a,b".split(",") |
['a', 'b'] |
+で文字列を結合する。これを連結と呼ぶ:
first = "Mei"
last = "Chen"
print(first + " " + last)   # Mei Chen
f-文字列は値からテキストを構築する。引用符の前にfを置き、値の周りに{...}を書く。
name = "Mei"
age = 17
print(f"{name} is {age} years old")   # Mei is 17 years old
{value:.2f}は小数点第2位に丸める。price = 9.5
print(f"Two cost {price * 2}") # Two cost 19.0
print(f"Pi is about {3.14159:.2f}") # Pi is about 3.14
** 一般的なミス **
s[0] = "x"はエラーを起こす。新しい文字列を構築する。0から始まり、最後の文字はs[-1]であり、s[len(s)]は範囲外である。s[a:b]はaを含み、bの手前で終わる。s.upper()は結果を格納しない限り何もしない。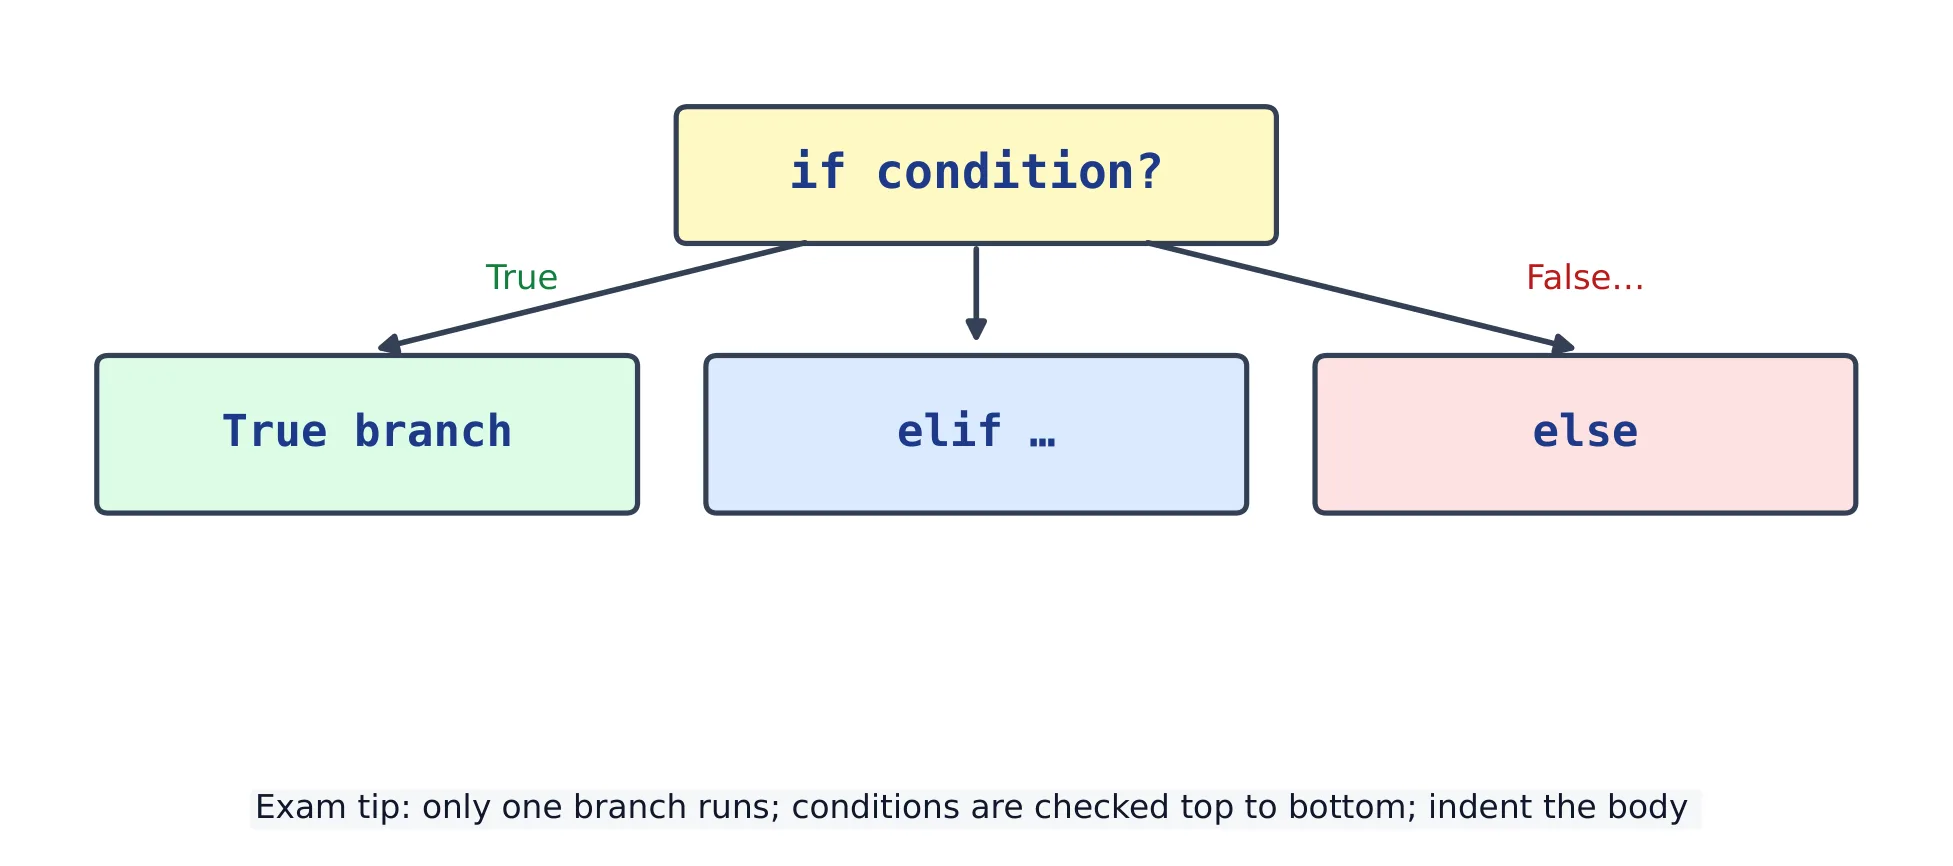
プログラムはifに何をさせるかを選択します。条件が真である場合にのみ、インデントされたブロックを実行します。if行はコロンで終わります。
score = 72
if score >= 60:
    print("pass")
# pass
追加のケースにはelif (elif) を、「それ以外」の場合にはelse を使用します。Python は最初の真の分岐のみを実行し、残りをスキップします。
score = 72
if score >= 80:
    print("A")
elif score >= 60:
    print("B")
else:
    print("fail")
# B
== (等しい)、!= (等しくない)、<、>、<=、>= を使用します。True かFalse のどちらかです。条件をand、or、not で結合します。and は両方の側が真である必要があります;or は片方でも真であれば十分です;not はブール値を反転させます。
age = 16
has_ticket = True
if age >= 18 and has_ticket:
    print("entry allowed")
else:
    print("entry refused")
# entry refused
(a or b) and c 。temp = 30
if temp > 25 and not temp > 35:
print("warm but ok")
# warm but ok
** 一般的なミス **
elif を書き、else if とは書かないでください。if / elif / else の各行はコロン : で終わり、その本文はインデントする必要がある。if x = 5: はエラーです — 比較するには== を使用してください。else は条件を受け取らず、if とelif のみが条件を受け取ります。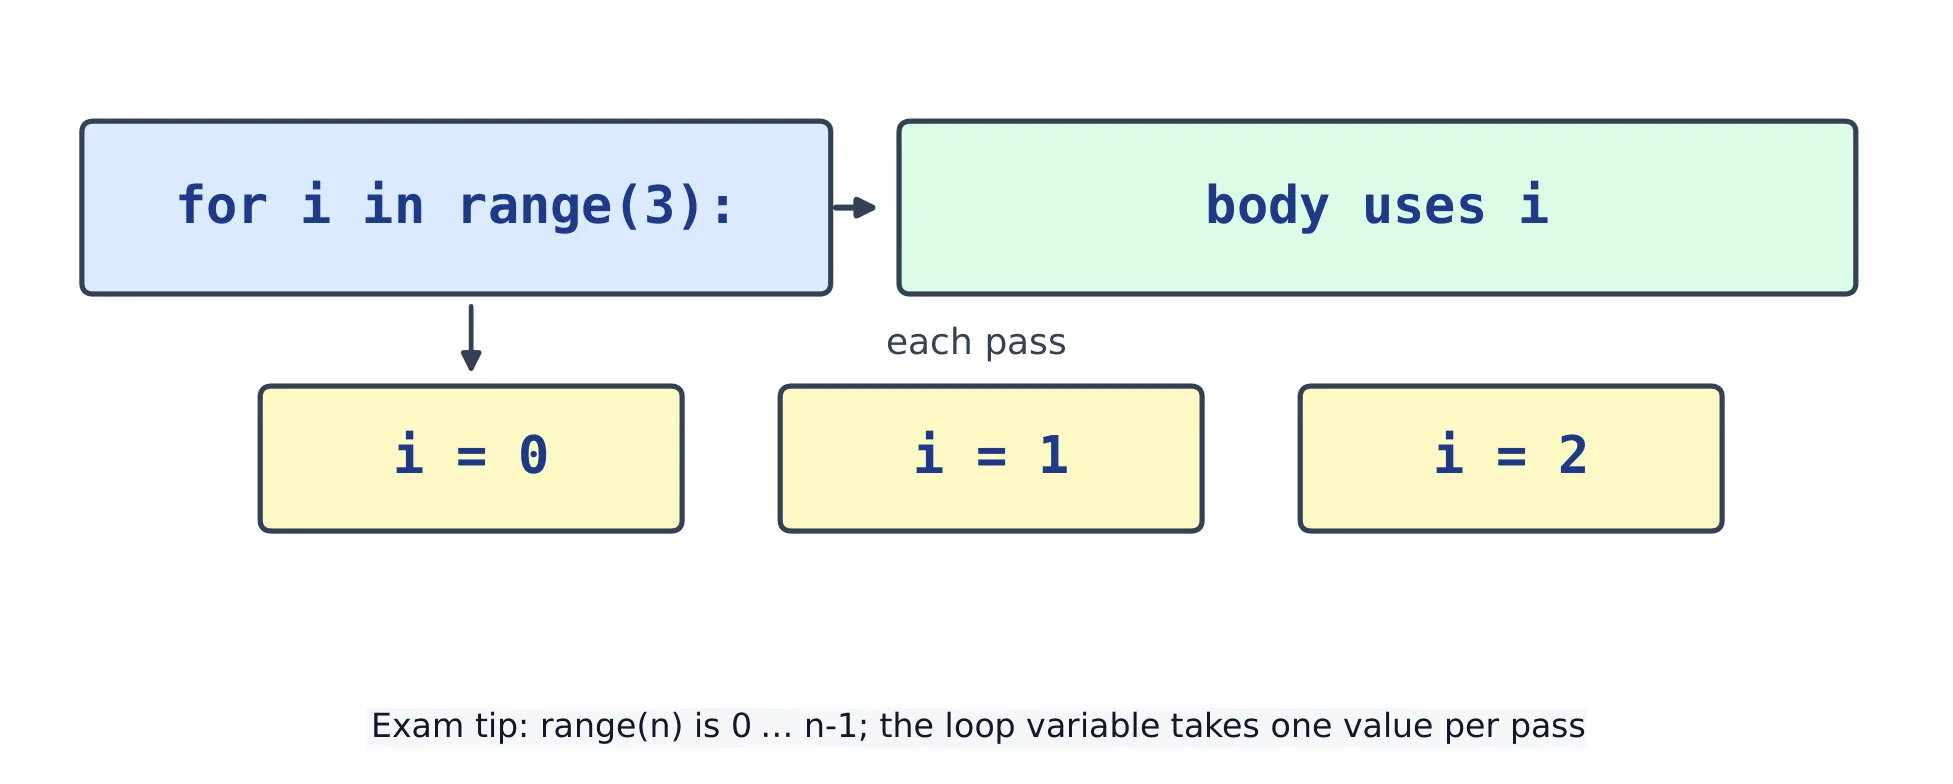
ループはコードを繰り返します。for ループはシーケンス内の各アイテムに対して一度だけ繰り返します。range(n) は0 からn - 1 までの数字を生成します。
for i in range(5):
    print(i)
# 0, then 1, 2, 3, 4 (each on its own line)
range(a, b) はa からb (ただし含まない)まで進みます。range(a, b, step) は毎回ステップを追加します。for n in range(2, 11, 2):
print(n) # 2 4 6 8 10
ループを通じて結果を構築するには、ループの前に変数を初期化し、その後各ターンで更新します。これがアキュムレーターパターンです。
total = 0
for n in range(1, 6):
    total = total + n
print(total)        # 15
count = 0
for letter in "banana":
    if letter == "a":
        count = count + 1
print(count)        # 3
while ループは条件が真である限り繰り返されます。内部で何かを変えない場合、止まらずに無限ループになります。
n = 1
while n <= 3:
    print(n)
    n = n + 1
# 1 2 3
break はループから即座に脱出します。total = 0
while True:
total = total + 10
if total >= 30:
break
print(total) # 30
ループ内のループはネストループと呼ばれます。内側のループは外側のループの各ターンに対して完全に実行されます。
for row in range(3):
    line = ""
    for col in range(3):
        line = line + "*"
    print(line)
# ***
# ***
# ***
** 一般的なミス **
range(n) は0 からn - 1 まで進み、1 からn までではありません — 典型的なオフバイワンエラーです。while のループ変数を変更しないことを忘れると、永遠に実行されます。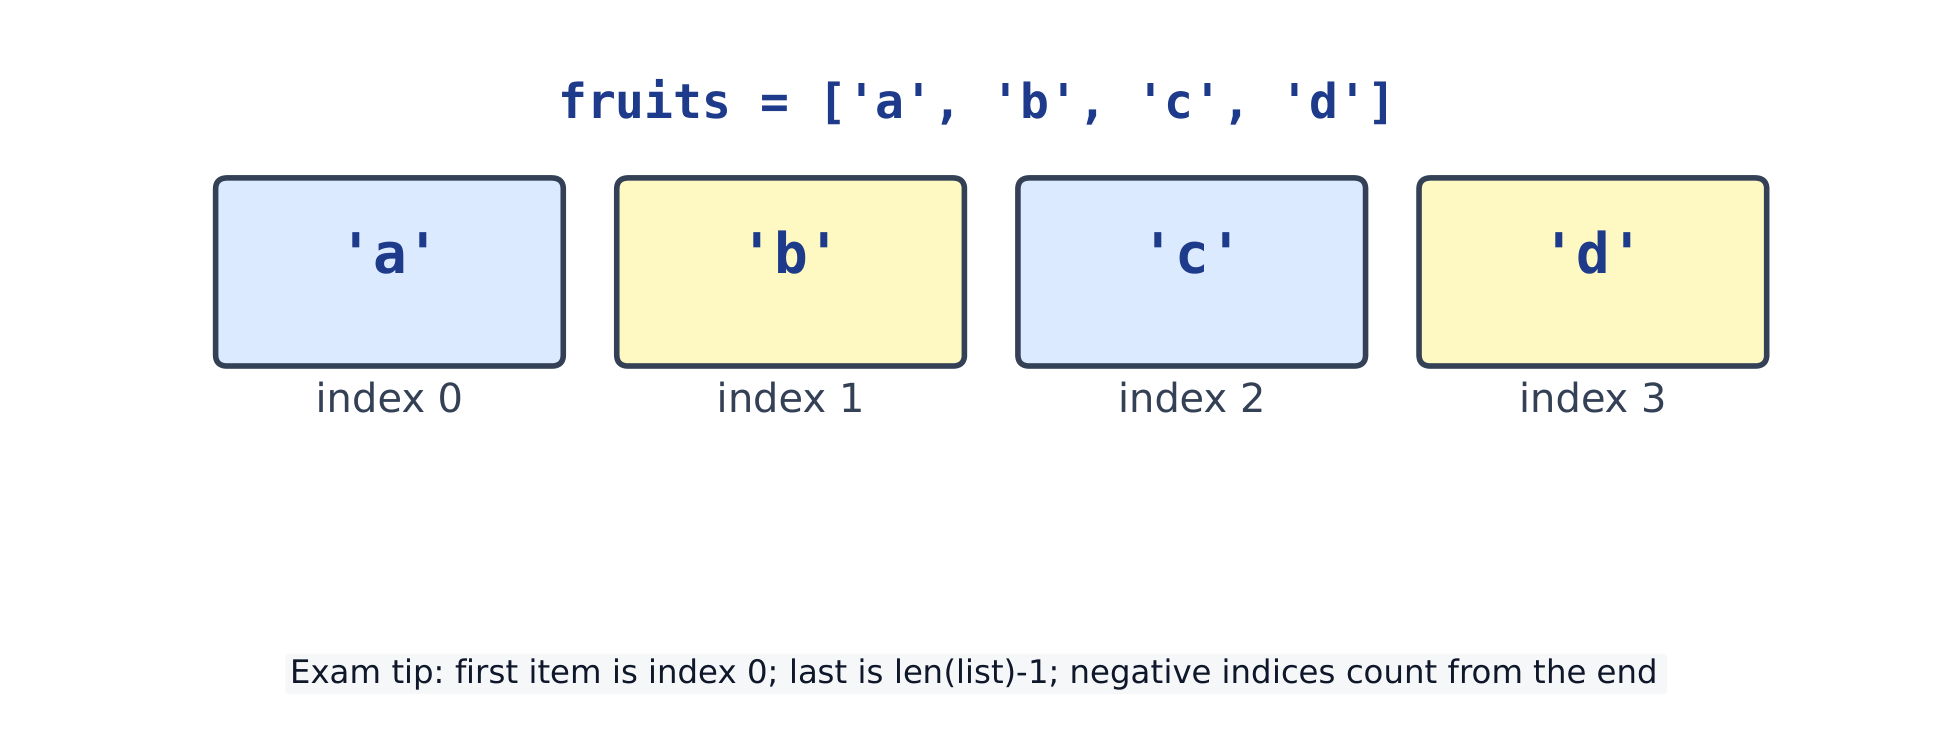
リストは[] 内に順序を持って多くの値を保持します。各アイテムにはインデックス(0 から)があります。
scores = [88, 71, 95]
print(scores[0])      # 88
print(len(scores))    # 3
scores.append(60)     # add to the end
print(scores)         # [88, 71, 95, 60]
scores[1] = 100 。一般的なリストツール:
| ツール | 機能 |
|---|---|
a.append(x) |
x を末尾に追加 |
a.insert(i, x) |
x を位置i に挿入 |
a.remove(x) |
最初のx を削除 |
a.pop() / a.pop(i) |
最後のアイテム / アイテムi を削除して返す |
a.sort() |
リストをインプレースでソート |
sorted(a) |
新しいソート済みリストを返す |
x in a |
リスト内に x が含まれていますか? |
len(a), sum(a), max(a), min(a) |
サイズと簡易計算 |
リストを走査することは各アイテムを訪問することです。for ループはインデックスなしで行います。
scores = [88, 71, 95]
total = 0
for s in scores:
    total = total + s
print(total)          # 254
enumerate を使用します。for i, name in enumerate(["a", "b"]):
print(i, name) # 0 a / 1 b
2次元リストはリストのリストであり、行と列のグリッドです。2つのインデックスを使用します:grid[row][col] 。
grid = [[1, 2, 3],
        [4, 5, 6]]
print(grid[0][2])     # 3
print(grid[1][0])     # 4
grid = [[1, 2], [3, 4]]
for row in grid:
    for value in row:
        print(value, end=" ")
print()               # 1 2 3 4
リスト圧縮は1行で新しいリストを構築します:[expression for item in sequence] 。
squares = [x * x for x in range(5)]
print(squares)        # [0, 1, 4, 9, 16]
if を追加して、特定の項目のみを保持する。evens = [n for n in range(10) if n % 2 == 0]
print(evens) # [0, 2, 4, 6, 8]
タプルは丸括弧内の固定シーケンスです。作成後に変更できません — 一緒に扱う値に使用し、名前にアンパッキングしてください。
point = (3, 4)
x, y = point            # unpacking
print(x, y)             # 3 4
2つの結果を返す必要がある関数はタプルを返します:
def min_max(nums):
    return min(nums), max(nums)

lo, hi = min_max([5, 2, 9])
print(lo, hi)           # 2 9
セットは各値を一度ずつ、順序なく格納します。重複の除去や高速な所属テストに最適です。
votes = ["red", "blue", "red", "green", "red"]
colours = set(votes)
print(len(colours))         # 3  (duplicates removed)
print("blue" in colours)    # True
** 一般的なミス **
b = aは1つのリストを共有する。a.copy()またはa[:]は新しい外側リストを作成するが、ネストされた可変要素は共有され続ける(浅いコピー)。a[-1] で、a[len(a)] は範囲外です。append は1つのアイテムのみを追加します。別のリストを結合するにはextend または+ を使用してください。[[0]*3]*3 でグリッドを構築すると、同一の行の3つのコピーを作成してしまいます。代わりにループ内で行を構築してください。(5,) 、(5) とは書かないでください。s[0] でインデックスすることはできません。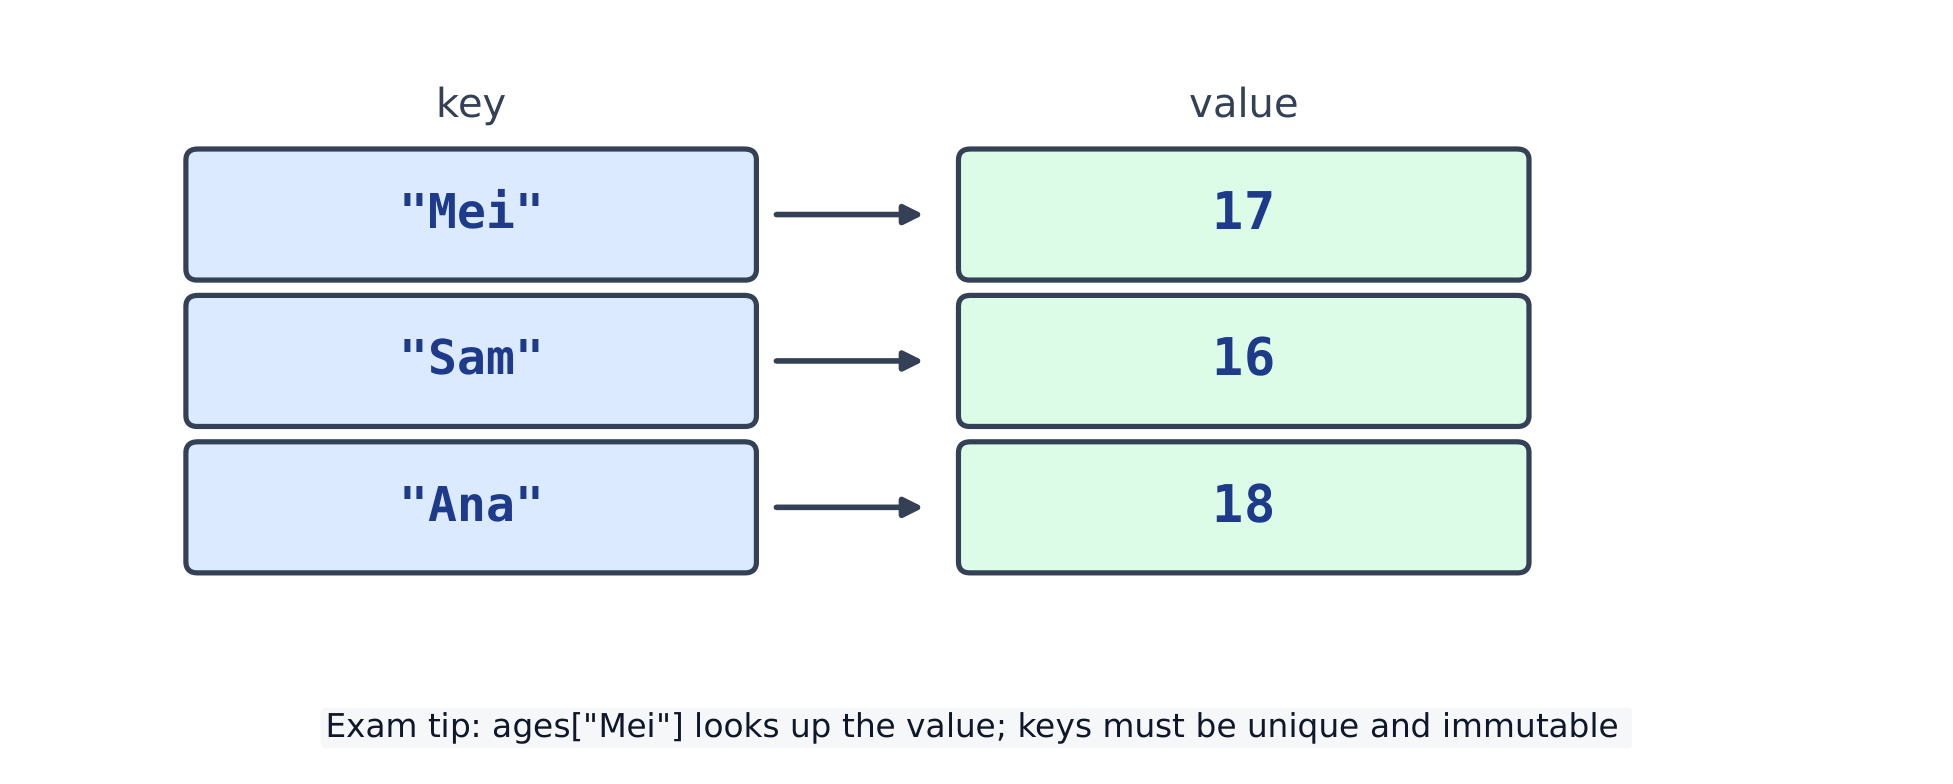
ディクショナリ(dict )はキー→値のペアを格納します。数値インデックスではなくキーで値を検索します。
student = {"name": "Mei", "score": 88}
print(student["name"])     # Mei
print(student["score"])    # 88
キーに割り当てて追加するか、既存のものを更新します。
student = {"name": "Mei"}
student["score"] = 88      # add a new key
student["score"] = 90      # update the value
print(student)             # {'name': 'Mei', 'score': 90}
キーの存在をテストするにはin を使用します。キーをループするか、.items() をループしてキーと値の両方を取得します。
student = {"name": "Mei", "score": 90}
print("score" in student)  # True
for key, value in student.items():
    print(key, "=", value)
# name = Mei
# score = 90
.get(key, default) はキーが存在しない場合にデフォルトを返すので、エラーになりません。student = {"name": "Mei"}
print(student.get("age", 0)) # 0
典型試験パターン — 各値が出現した回数をカウントします:
word = "banana"
counts = {}
for letter in word:
    counts[letter] = counts.get(letter, 0) + 1
print(counts)   # {'b': 1, 'a': 3, 'n': 2}
.get(letter, 0) はキーが初めて見た時に0 を提供するため、KeyErrorになりません。** 一般的なミス **
d[key] で欠落しているキーを読むとKeyErrorが発生します;d.get(key) を使用するか、先にif key in d をテストしてください。d[key] を再度割り当てると古い値が上書きされます — キーは一意です。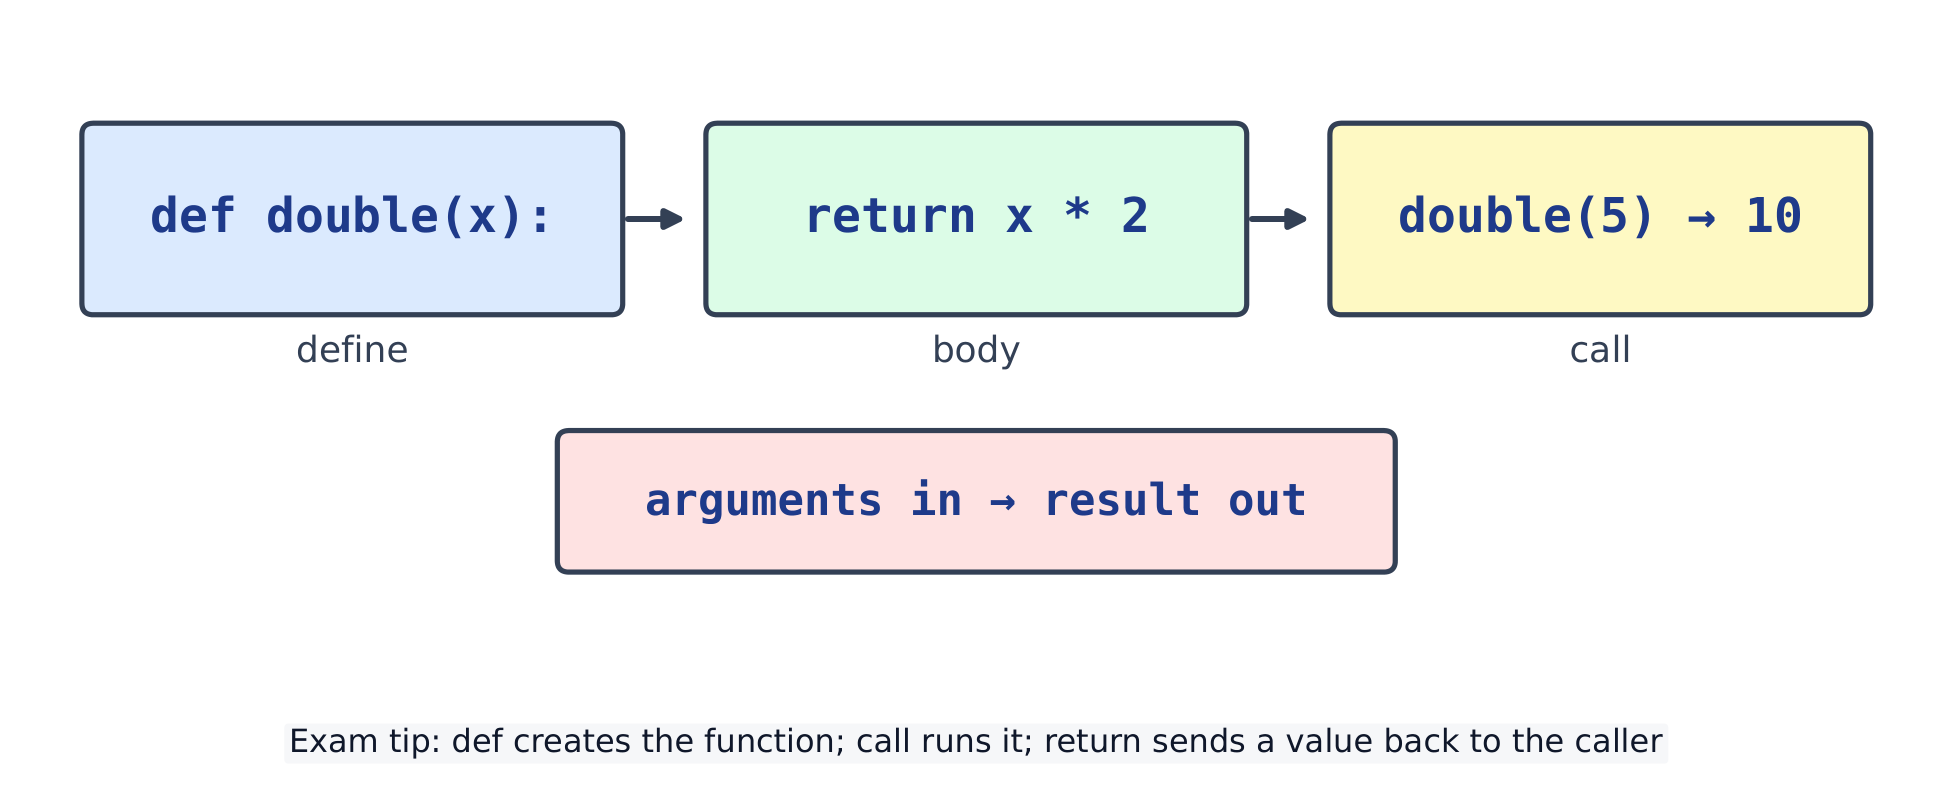
関数は再利用可能な名付けられたコードブロックです。def で定義し、名前を指定して呼び出します。
def greet():
    print("Hello!")

greet()        # Hello!
greet()        # Hello!
関数は return を使って値を返すことができます。then(その結果)はその値を表します。
def square(n):
    return n * n

print(square(5))          # 25
print(square(3) + 1)      # 10
return は関数を即座に終了させます。return を持たない関数は None を返します。パラメータは def 内の名前です。引数は渡す値です。
def power(base, exp):         # base, exp are parameters
    return base ** exp

print(power(2, 3))            # 8  (2 and 3 are arguments)
関数内で作成された変数はローカルです — そこでのみ存在します。その領域がスコープです。
def f():
    x = 10            # local to f
    return x

print(f())            # 10
# print(x) here would be an error: x is not defined outside f
パラメータにはデフォルト値を設定でき、呼び出し側で省略した際に使われます:
def greet(name, greeting="Hello"):
    return greeting + ", " + name

print(greet("Mei"))              # Hello, Mei
print(greet("Sam", "Welcome"))   # Welcome, Sam
手続的抽象とは、名前 behind に詳細を隠すことです。関数はその名前と役割を使って使い、内部の仕組みではなく使います。
def area_of_rectangle(w, h):
    return w * h

print(area_of_rectangle(4, 5))   # 20
モジュールは用意された関数のファイルです。import で読み込みます。
import random
random.seed(0)               # makes the result repeatable
print(random.randint(1, 6))  # a dice roll

import math
print(math.sqrt(16))         # 4.0
** 一般的なミス **
None を返すが、return を記述しない限りである。印刷(printing)と返す(returning)は異なる。def f(x=[]) のような可変型のデフォルト値は絶対に使わないでください — 全呼び出し間で同じリストが共有されます。f() で関数を呼び出します。f だけを単に書くだけでは、それは名前に過ぎません。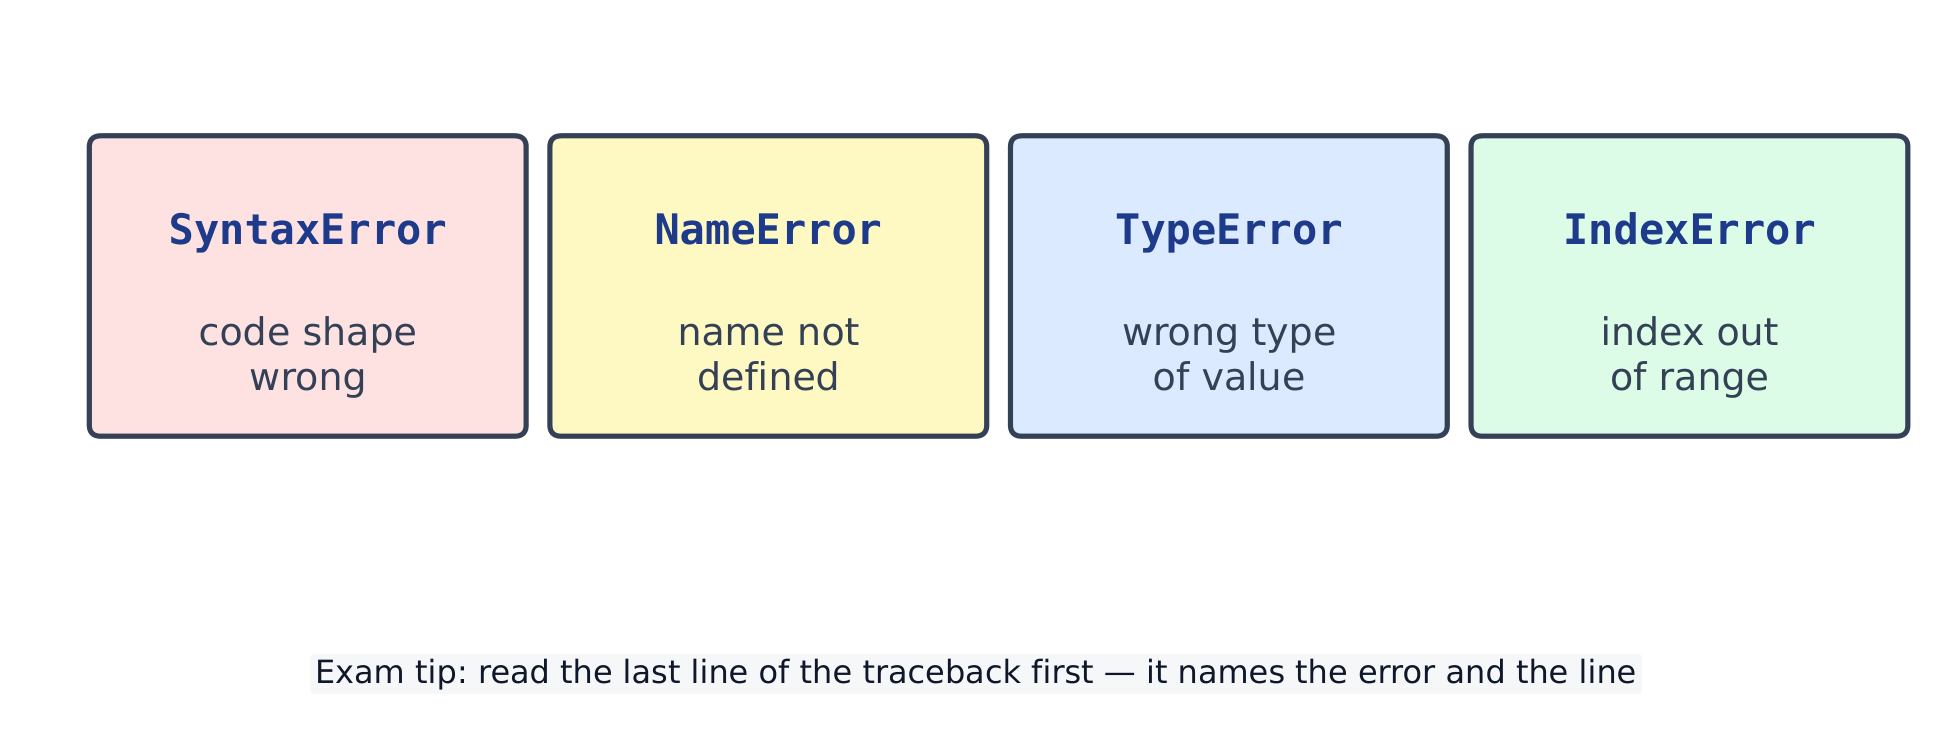
コードは3つの方法で失敗します。構文エラーはPythonのルールを破るため、全く実行されません。ランタイムエラーは実行中に発生し、ゼロで割った場合などが該当します。ロジックエラーは実行されますが、正しくない答えを返します。
# A runtime error, caught so this block still finishes:
try:
    print(10 / 0)
except ZeroDivisionError:
    print("cannot divide by zero")
# cannot divide by zero
危険なコードを try に配置し、失敗した場合に except が例外をキャッチしてクラッシュを防ぎます。
def to_int(text):
    try:
        return int(text)
    except ValueError:
        return 0
print(to_int("abc"))   # 0
ValueError, ZeroDivisionError, …)。raise は意図的に独自のエラーを作ります。def set_age(age):
if age < 0:
raise ValueError("age cannot be negative")
return age
try:
set_age(-1)
except ValueError as err:
print("error:", err)
# error: age cannot be negative
テストは、コードが正しい答えを返すか確認します。通常ケース および エッジケース(空の入力、ゼロ、非常に大きい値)を試してください。
def average(nums):
    if len(nums) == 0:        # edge case: empty list
        return 0
    return sum(nums) / len(nums)

print(average([2, 4, 6]))     # 4.0
print(average([]))            # 0
** 一般的なミス **
except: を使わないでください — 特定のエラーをキャッチし、例:except ValueError: 。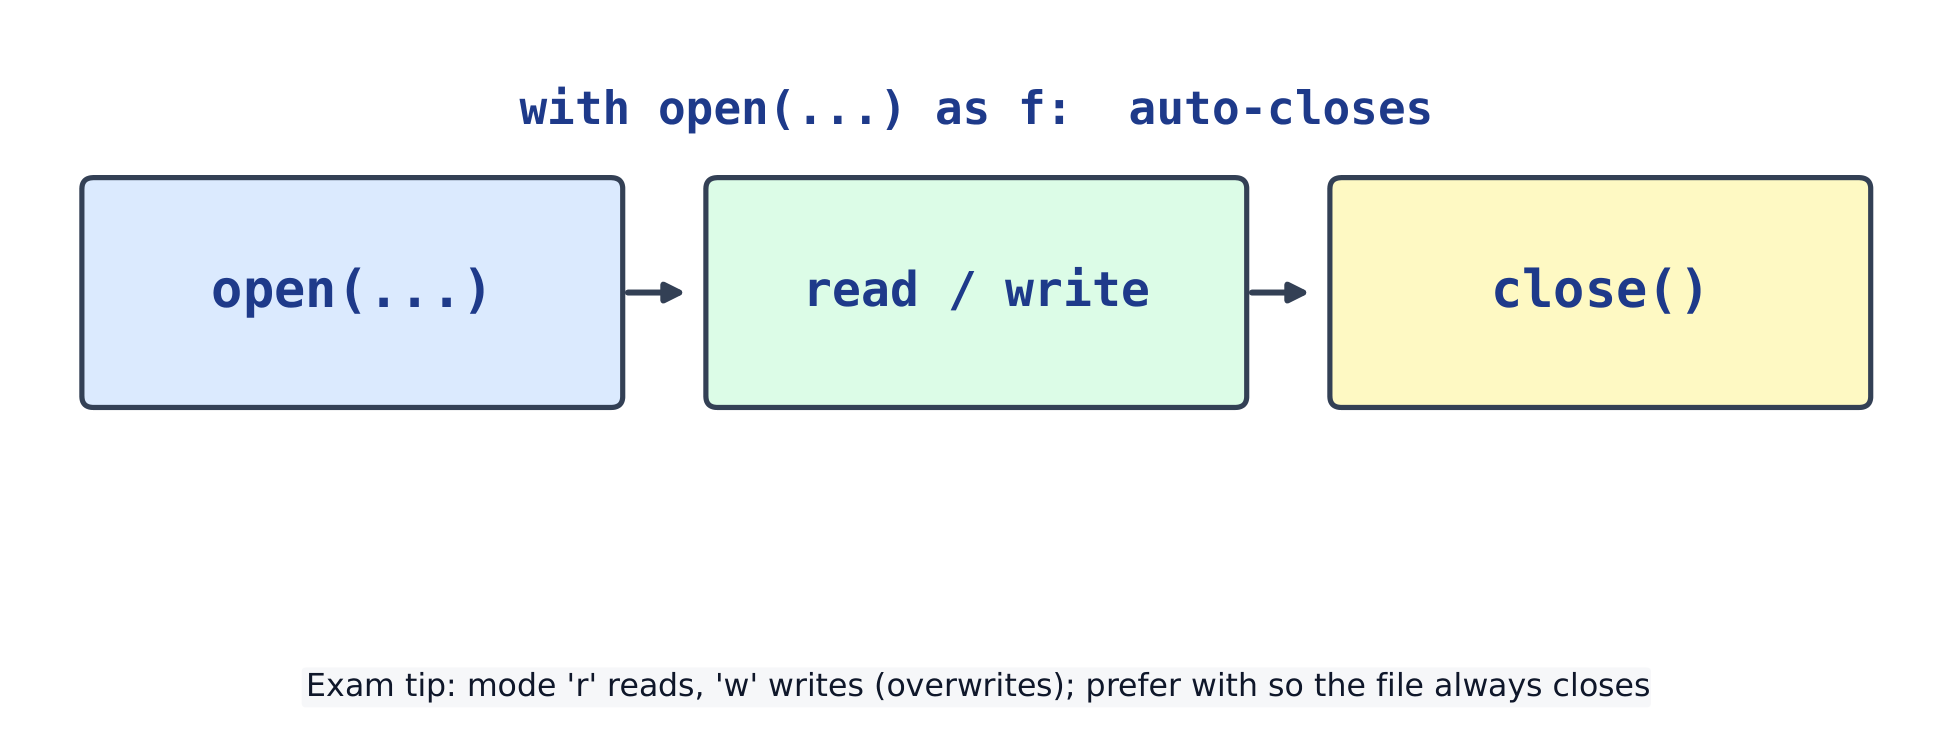
テキストファイルはディスク上にテキストを保存します。モードが read または write の open(name, mode) で開きます。with を常に使い、これがファイルを自動的に閉じてくれます。
モード "w" は新しいファイルを作成し、古いものを消去します。
with open("notes.txt", "w") as f:
    f.write("first line\n")
    f.write("second line\n")
print("saved")            # saved
モード "r" (デフォルト)は読み込みます。.read() はファイル全体を1つの文字列として返します。
with open("notes.txt", "w") as f:
    f.write("hello\nworld\n")
with open("notes.txt") as f:
    print(f.read().strip())   # hello / world
ファイルに対してループしてラインごとに取得します。.strip() は末尾の改行を削除します。
with open("data.txt", "w") as f:
    f.write("Mei,88\nSam,71\n")
with open("data.txt") as f:
    for line in f:
        name, score = line.strip().split(",")
        print(name, "scored", score)
# Mei scored 88
# Sam scored 71
モード "a" は追加 — 消去せずに末尾に追加します。
with open("log.txt", "w") as f:
    f.write("line 1\n")
with open("log.txt", "a") as f:
    f.write("line 2\n")
with open("log.txt") as f:
    print(f.read().strip())   # line 1 / line 2
| モード | 意味 |
|---|---|
"r" |
read (デフォルト) |
"w" |
write (先に消去) |
"a" |
append (末尾に追加) |
** 一般的なミス **
with open(...) as f: を使うと自動的に閉じます。read() はファイル全体を1つの文字列として返し、各ラインは依然として \n で終わります。"w" で開くと先にファイルを消去します;末尾に追加するには "a" を使ってください。アルゴリズムは問題を解決する明確な手順のリストです。分解とは、大きな問題を一度に解ける小さな部分に分割することです。
# Algorithm: find the largest number in a list
def largest(nums):
    best = nums[0]
    for n in nums:
        if n > best:
            best = n
    return best

print(largest([3, 9, 2, 7]))   # 9
largest(...) を使う際、再びその仕組みを読む必要はありません。擬似コードは、実際のコードより先に書かれる、アルゴリズムのための平明で構造化された英語です。実行することはできません。
SET best TO first number
FOR Each number n
    IF n > best
      THEN
        SET best TO n
OUTPUT best
フローチャートは同じ計画を描きます:各ステップにボックス、各判断にダイヤモンド、順序に矢印を使います。
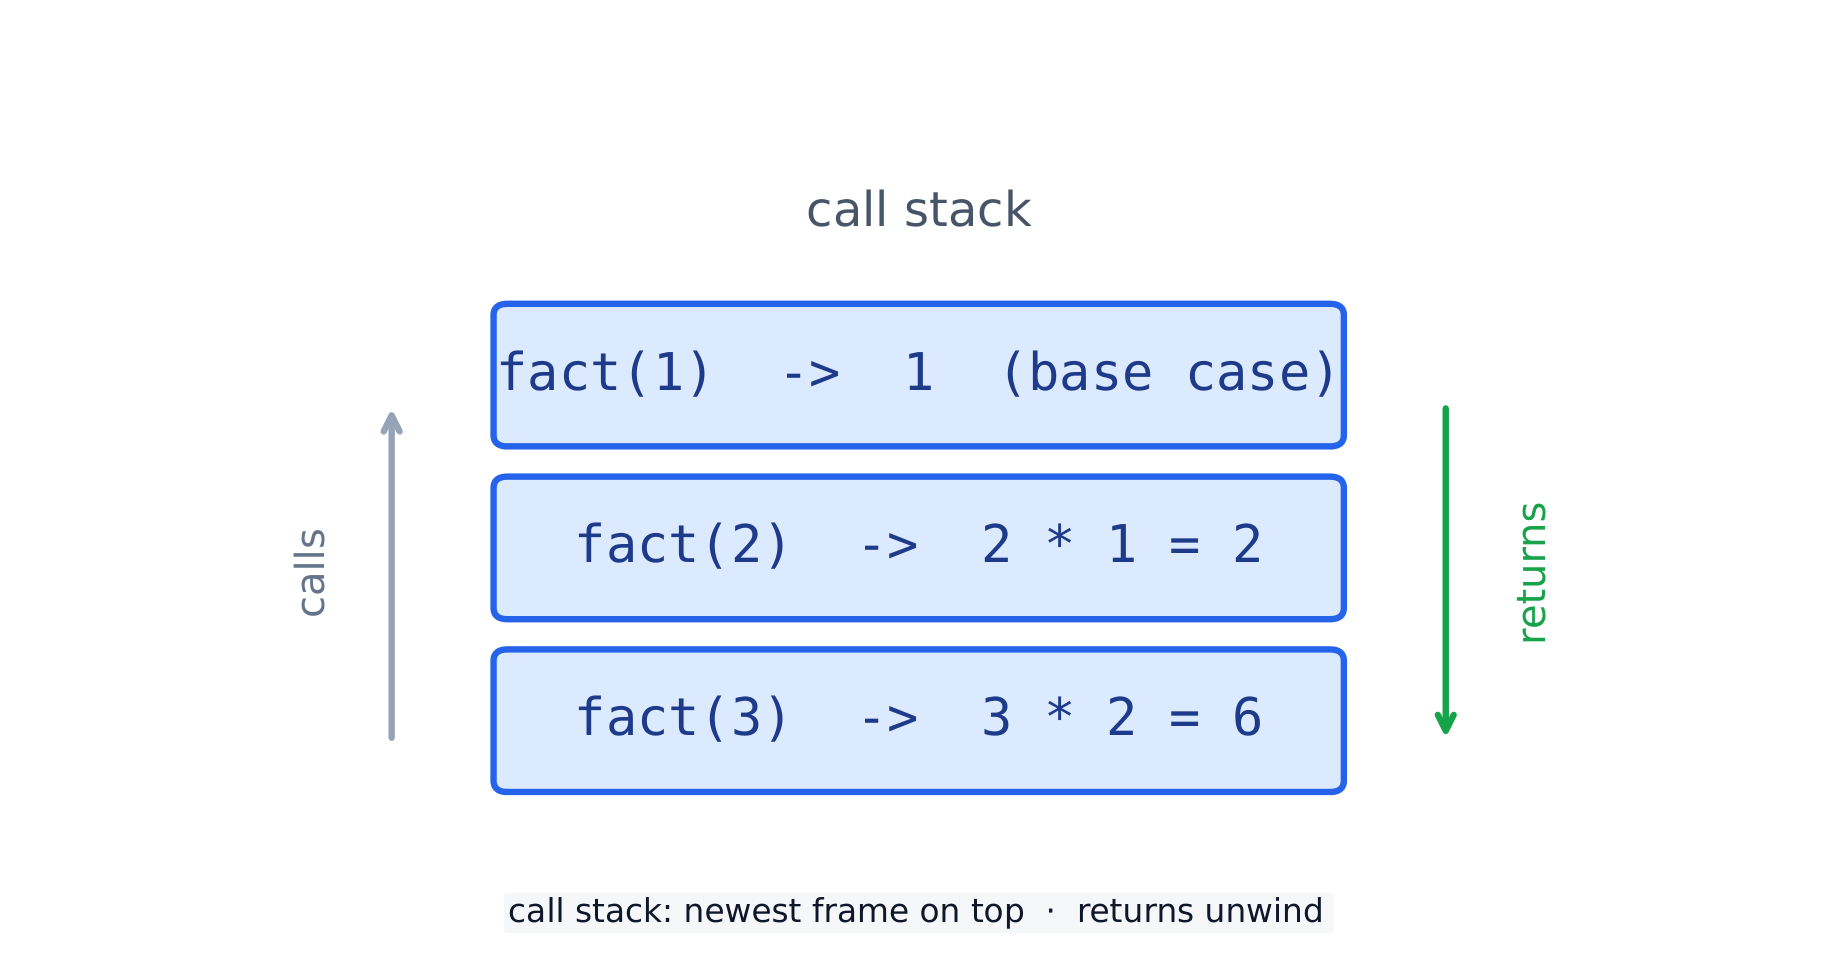
再帰とは、関数が自分自身を呼び出すことです。ベースケース(すぐに返される単純な入力)と再帰ケース(より小さい入力で自分自身を呼び出す)が必要です。
def fact(n):
    return 1 if n <= 1 else n * fact(n - 1)

print(fact(5))     # 120
** 一般的なミス **
抽象データ型(ADT)は、データの組み込み方とは別々に、データとその操作を記述します。内部ストレージではなく、操作を通じて使います。
# A stack ADT, built on a list
s = []
s.append(1)        # add
s.append(2)
print(s.pop())     # 2  (remove the most recent)
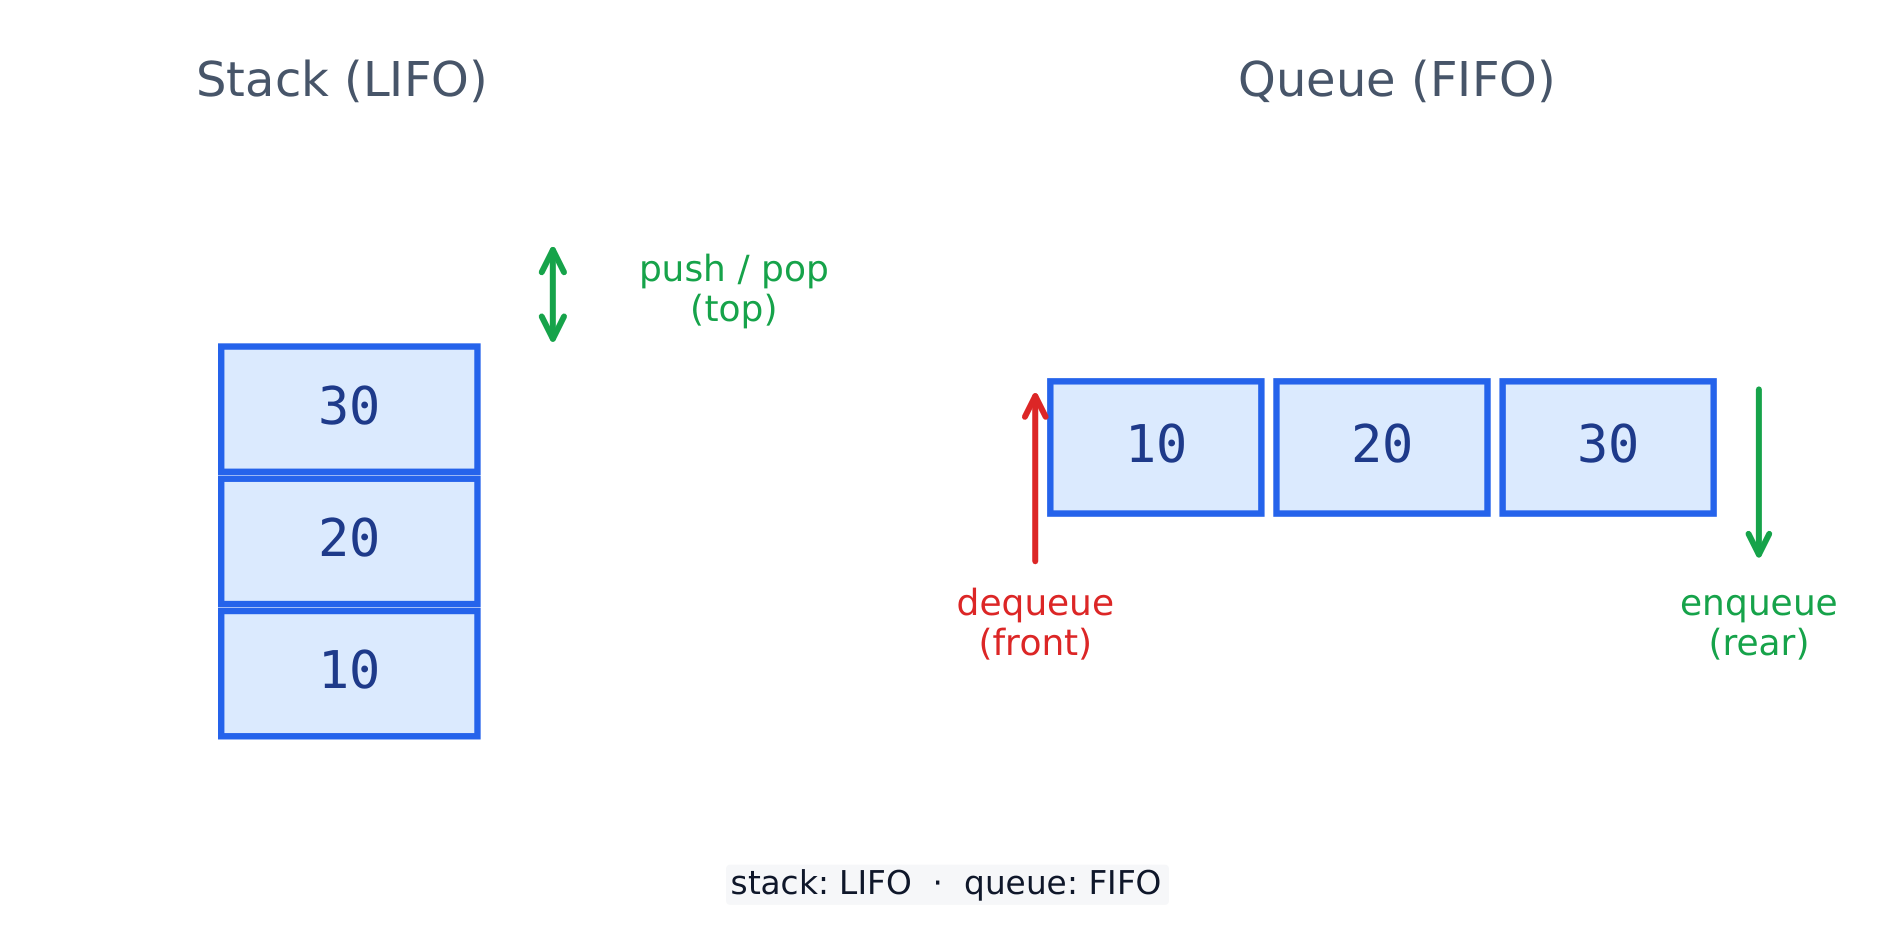
スタックは後入れ先出し(LIFO)です。トップにpushし、トップからpopします。
stack = []
stack.append("a")
stack.append("b")
print(stack.pop())   # b
print(stack.pop())   # a
キューは先入れ先出し(FIFO)です。後ろにenqueueし、先頭からdequeueします。
queue = []
queue.append("a")     # enqueue
queue.append("b")
print(queue.pop(0))   # a  (dequeue the front)
print(queue.pop(0))   # b
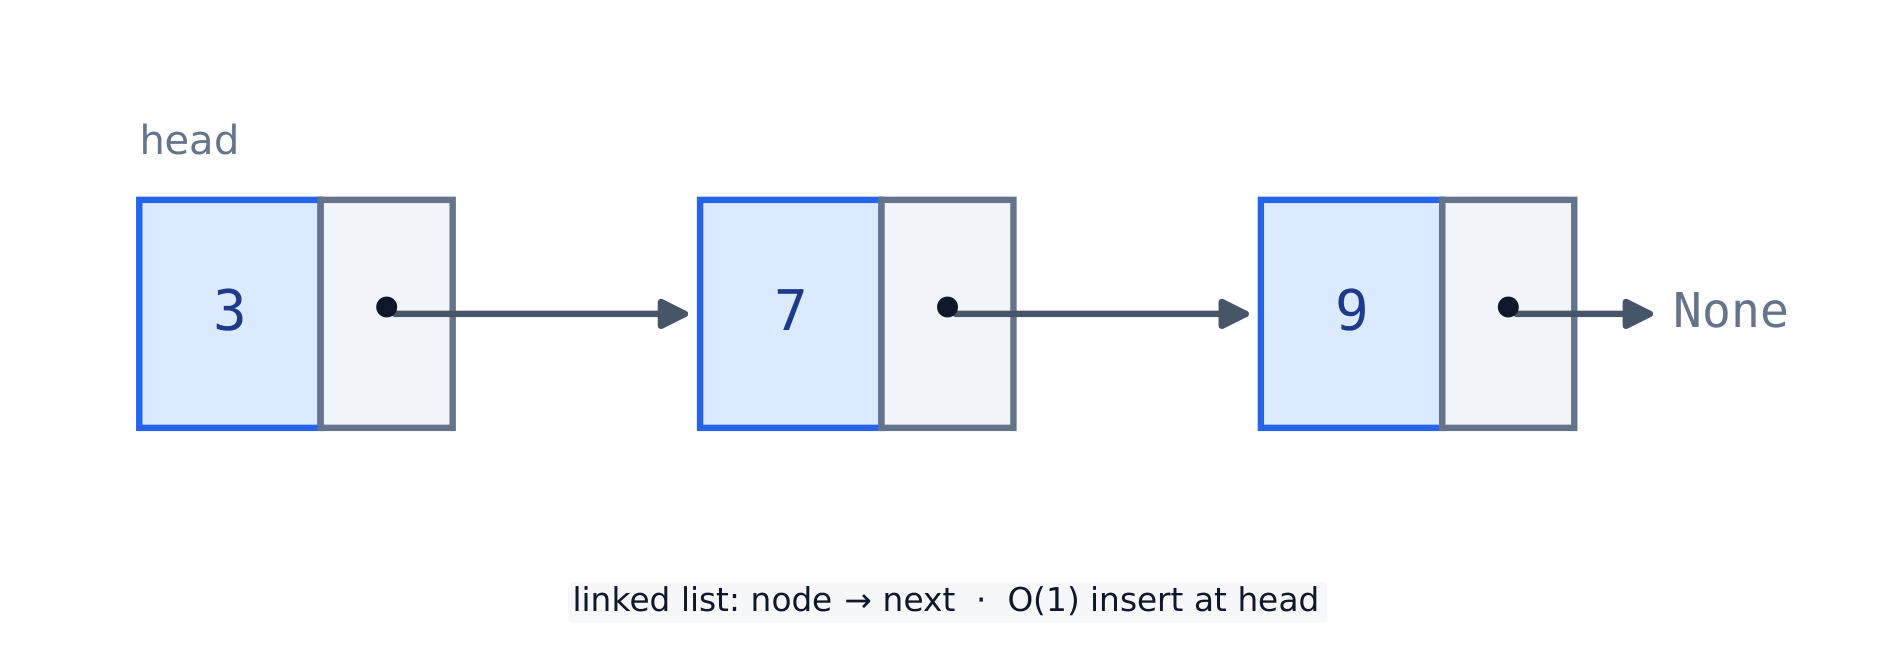
リンクドリストはノードの連鎖です。各ノードはデータと次のノードへのポインタを持ち、最後は None を指します。
n3 = {"data": 3, "next": None}
n2 = {"data": 2, "next": n3}
n1 = {"data": 1, "next": n2}
node = n1
while node is not None:      # traverse to the end
    print(node["data"])
    node = node["next"]
# 1 2 3
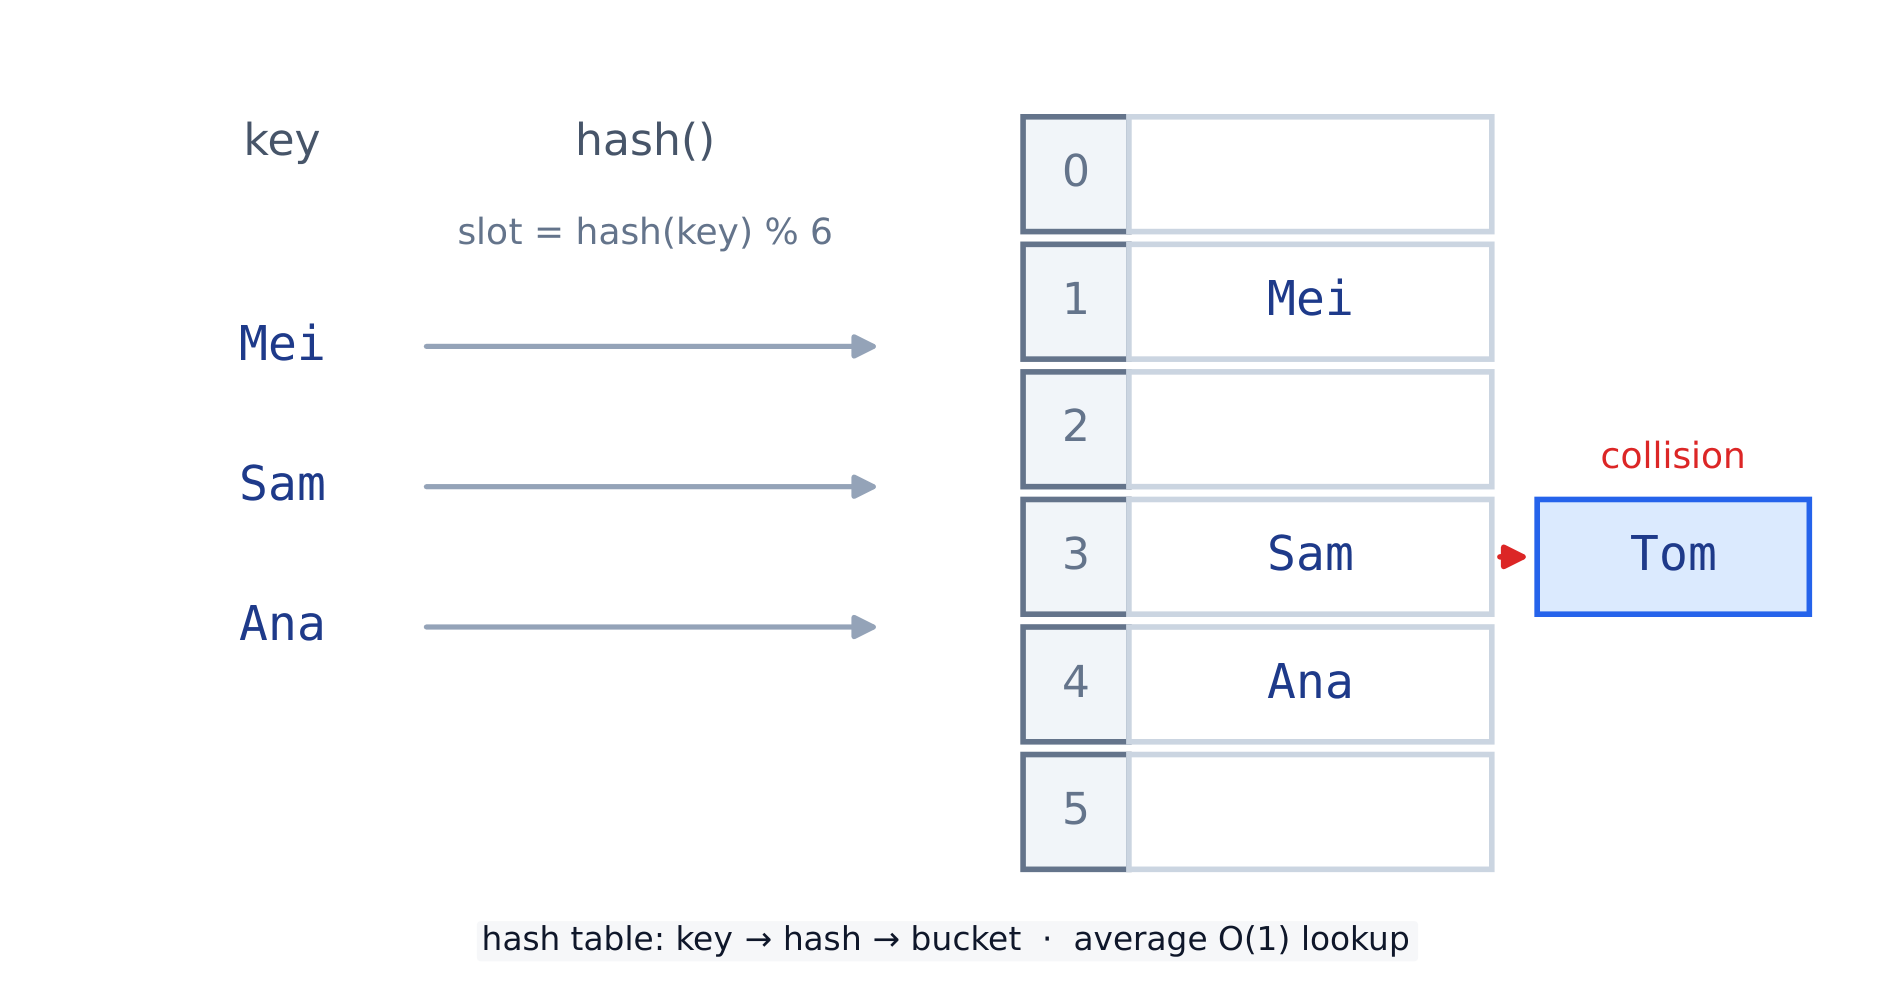
ハッシュテーブルはハッシュ関数を使ってキーをスロットにマッピングします。2つのキーが同じスロットに入ることがあります — これは衝突です。Pythonの dict はハッシュテーブルなので、検索が速いです。
table = {}
table["Mei"] = 88
table["Sam"] = 71
print(table["Mei"])   # 88  (fast lookup by key)
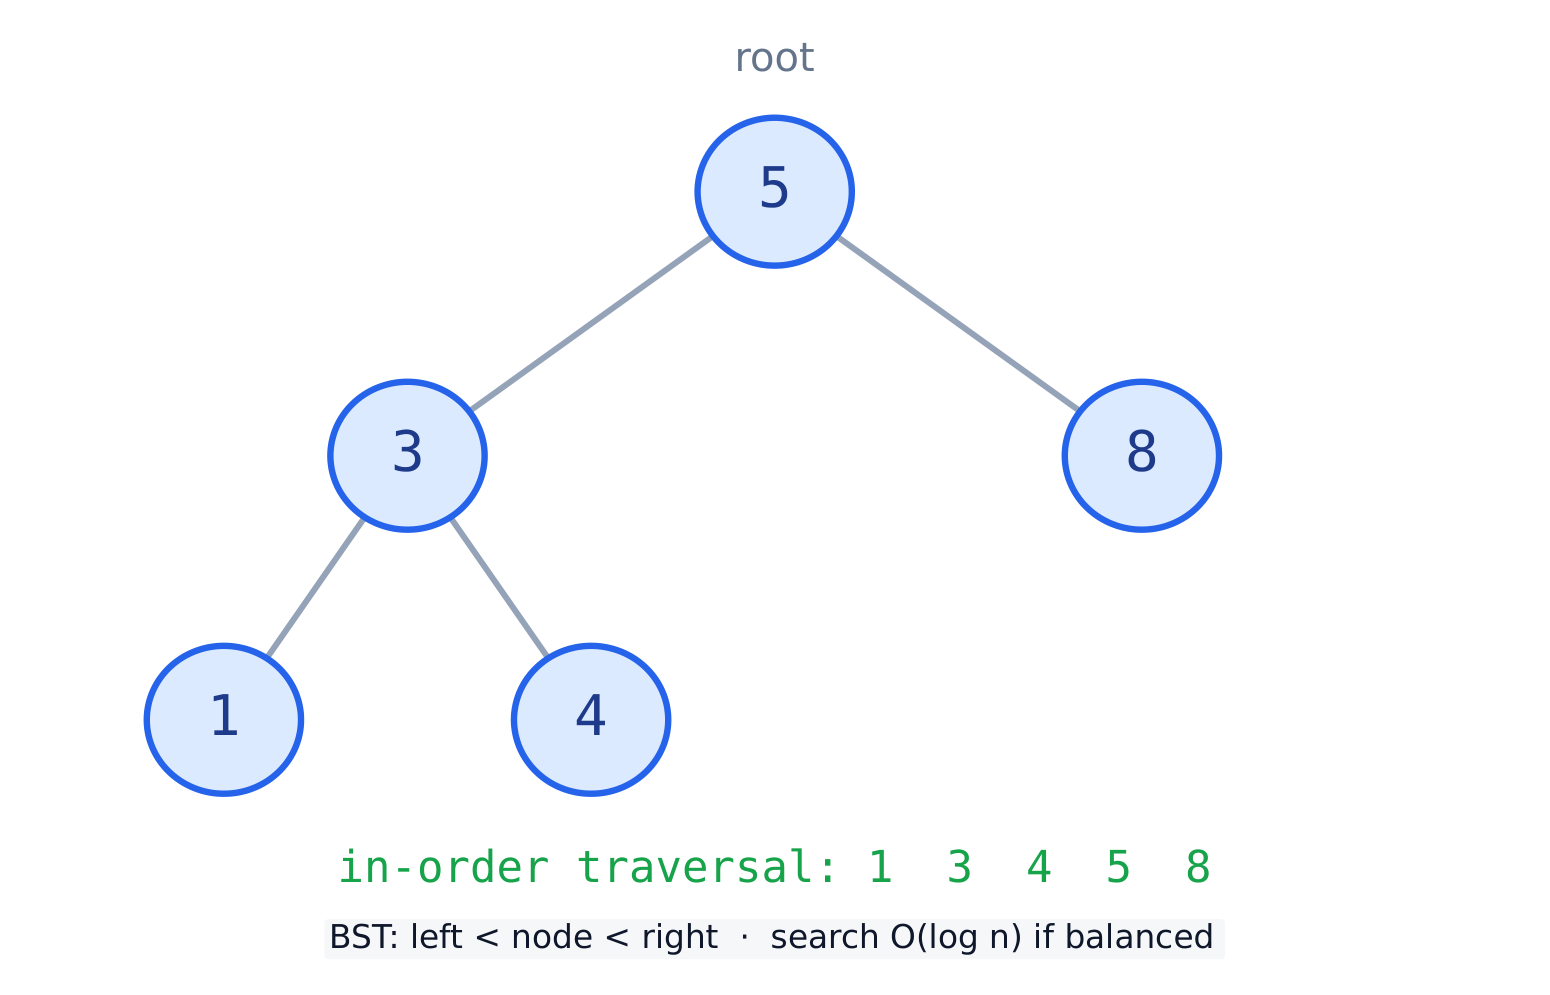
二項探索木(BST)は順序を維持します:すべての左の子ノードは親より小さく、すべての右の子ノードは親より大きいです。検索は高速です。
def insert(root, val):
    if root is None:
        return {"val": val, "left": None, "right": None}
    if val < root["val"]:
        root["left"] = insert(root["left"], val)
    else:
        root["right"] = insert(root["right"], val)
    return root

def inorder(root):
    if root is None:
        return []
    return inorder(root["left"]) + [root["val"]] + inorder(root["right"])

tree = None
for v in [5, 3, 8, 1, 4]:
    tree = insert(tree, v)
print(inorder(tree))   # [1, 3, 4, 5, 8]
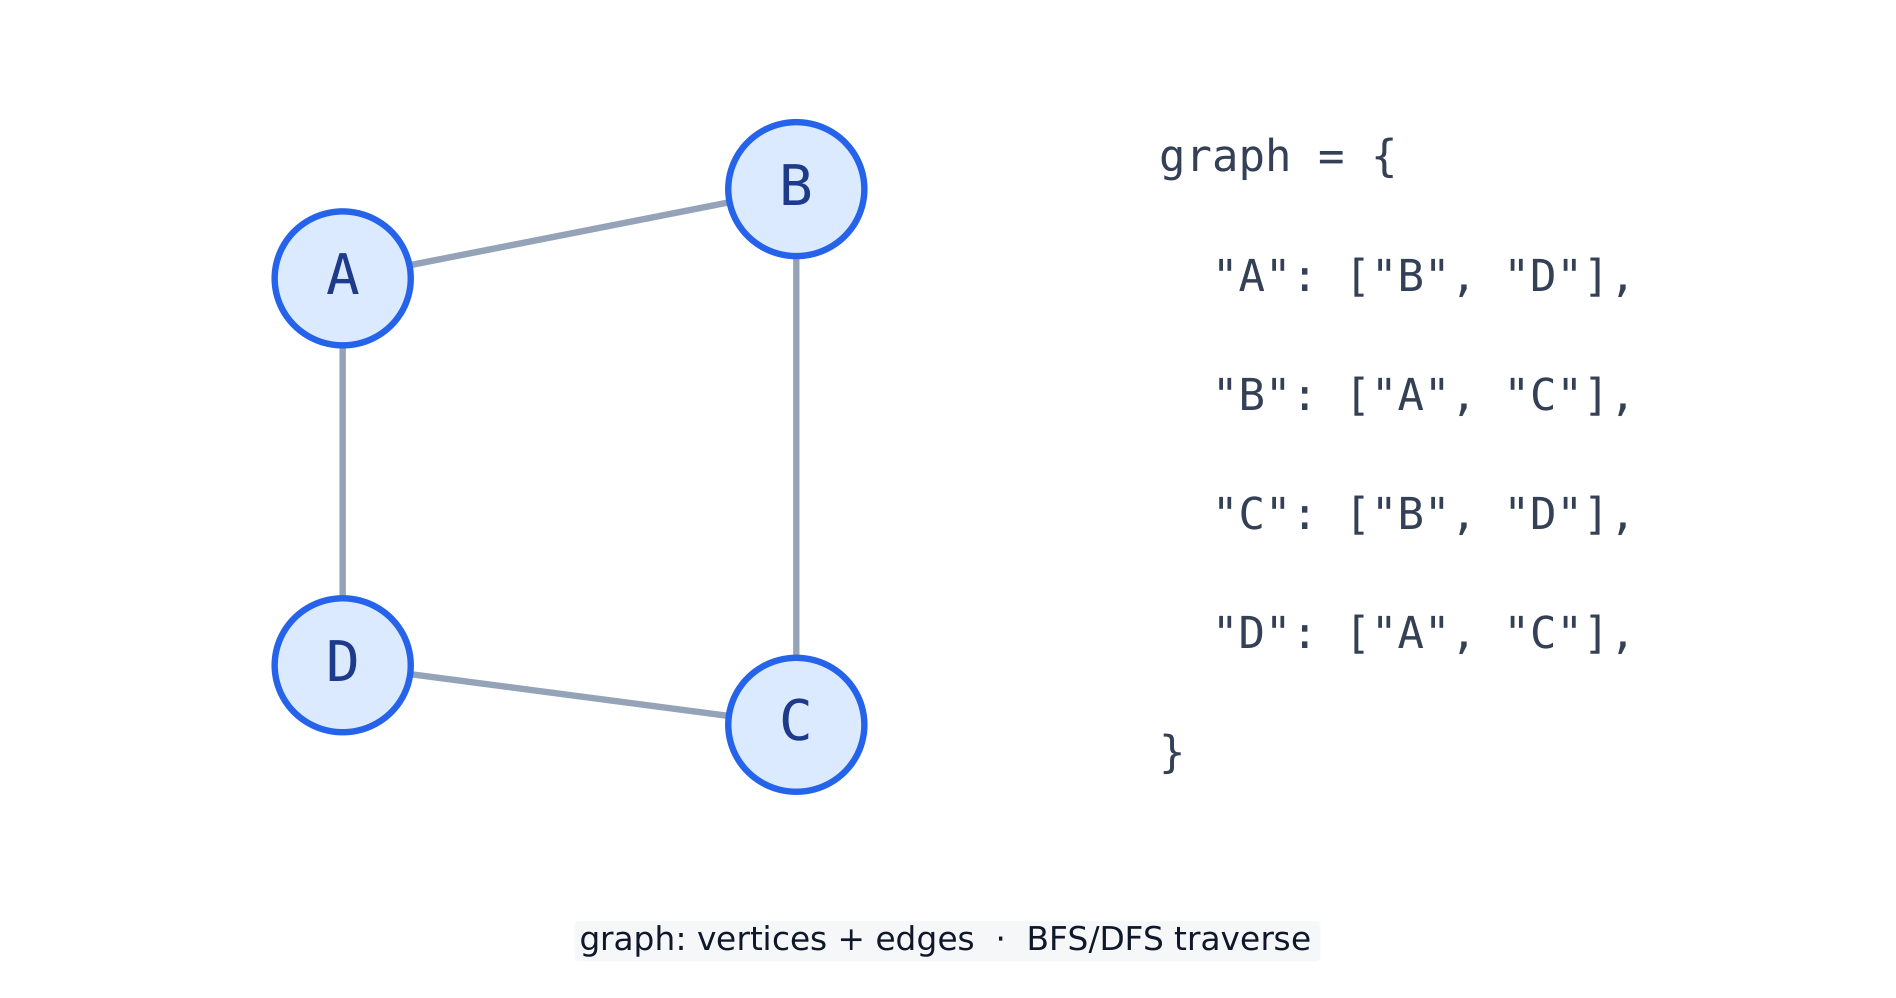
グラフは、辺で結ばれた頂点の集合です。隣接リスト(近傍リストの辞書)は、それを格納する一般的な方法です。
graph = {"A": ["B", "D"], "B": ["A", "C"], "C": ["B", "D"], "D": ["A", "C"]}
for vertex in graph:
    print(vertex, "->", graph[vertex])
# A -> ['B', 'D']  (and so on for B, C, D)
** 一般的なミス **
headポインタを失うと、リスト全体を失います。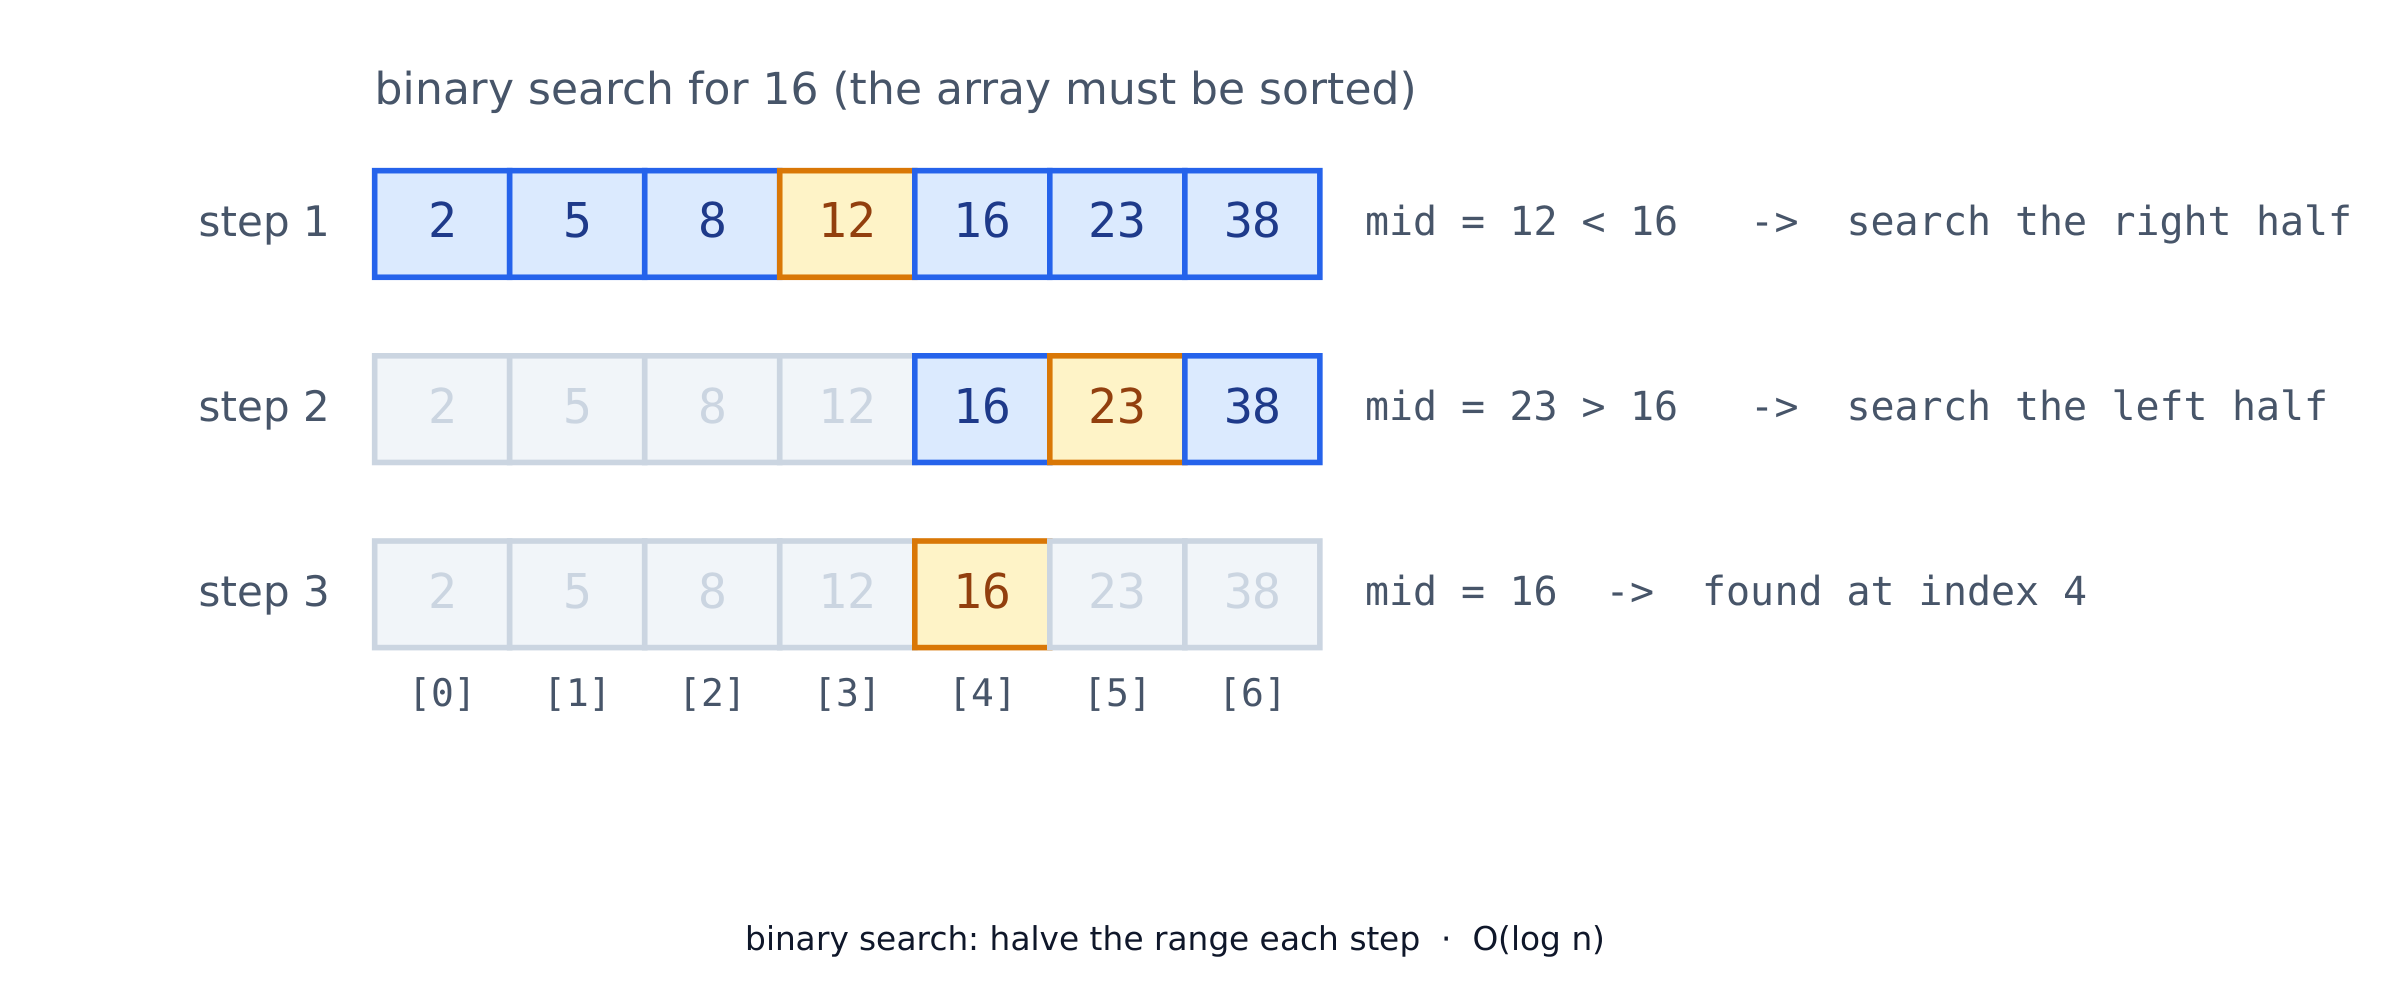
探索は値がある場所を探します。線形探索は順に各アイテムを確認するため、どんなリストでも機能します。
def linear_search(items, target):
    for i in range(len(items)):
        if items[i] == target:
            return i
    return -1     # not found

print(linear_search([4, 8, 2, 9], 2))   # 2
二項探索は遥かに速いですが、ソート済みリストが必要です。各ステップで範囲を半分にします。
def binary_search(items, target):
    lo, hi = 0, len(items) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if items[mid] == target:
            return mid
        elif items[mid] < target:
            lo = mid + 1
        else:
            hi = mid - 1
    return -1

print(binary_search([1, 3, 5, 7, 9], 7))   # 3
ソートとはアイテムを並べ替えることです。バブルソートは、順番の異なる隣り合う要素を繰り返し交換します。
def bubble_sort(a):
    a = a[:]                          # work on a copy
    for i in range(len(a)):
        for j in range(len(a) - 1 - i):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
    return a

print(bubble_sort([5, 2, 4, 1]))      # [1, 2, 4, 5]
挿入ソートは、アイテムを1つずつソート済みの部分に積み上げ、新しいアイテムを正しい位置までスライドさせていきます:
def insertion_sort(a):
    a = a[:]                           # work on a copy
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:   # shift bigger values right
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key                 # drop key into the gap
    return a

print(insertion_sort([5, 2, 4, 1]))   # [1, 2, 4, 5]
sorted() を使用します:print(sorted([5, 2, 4, 1])) # [1, 2, 4, 5]
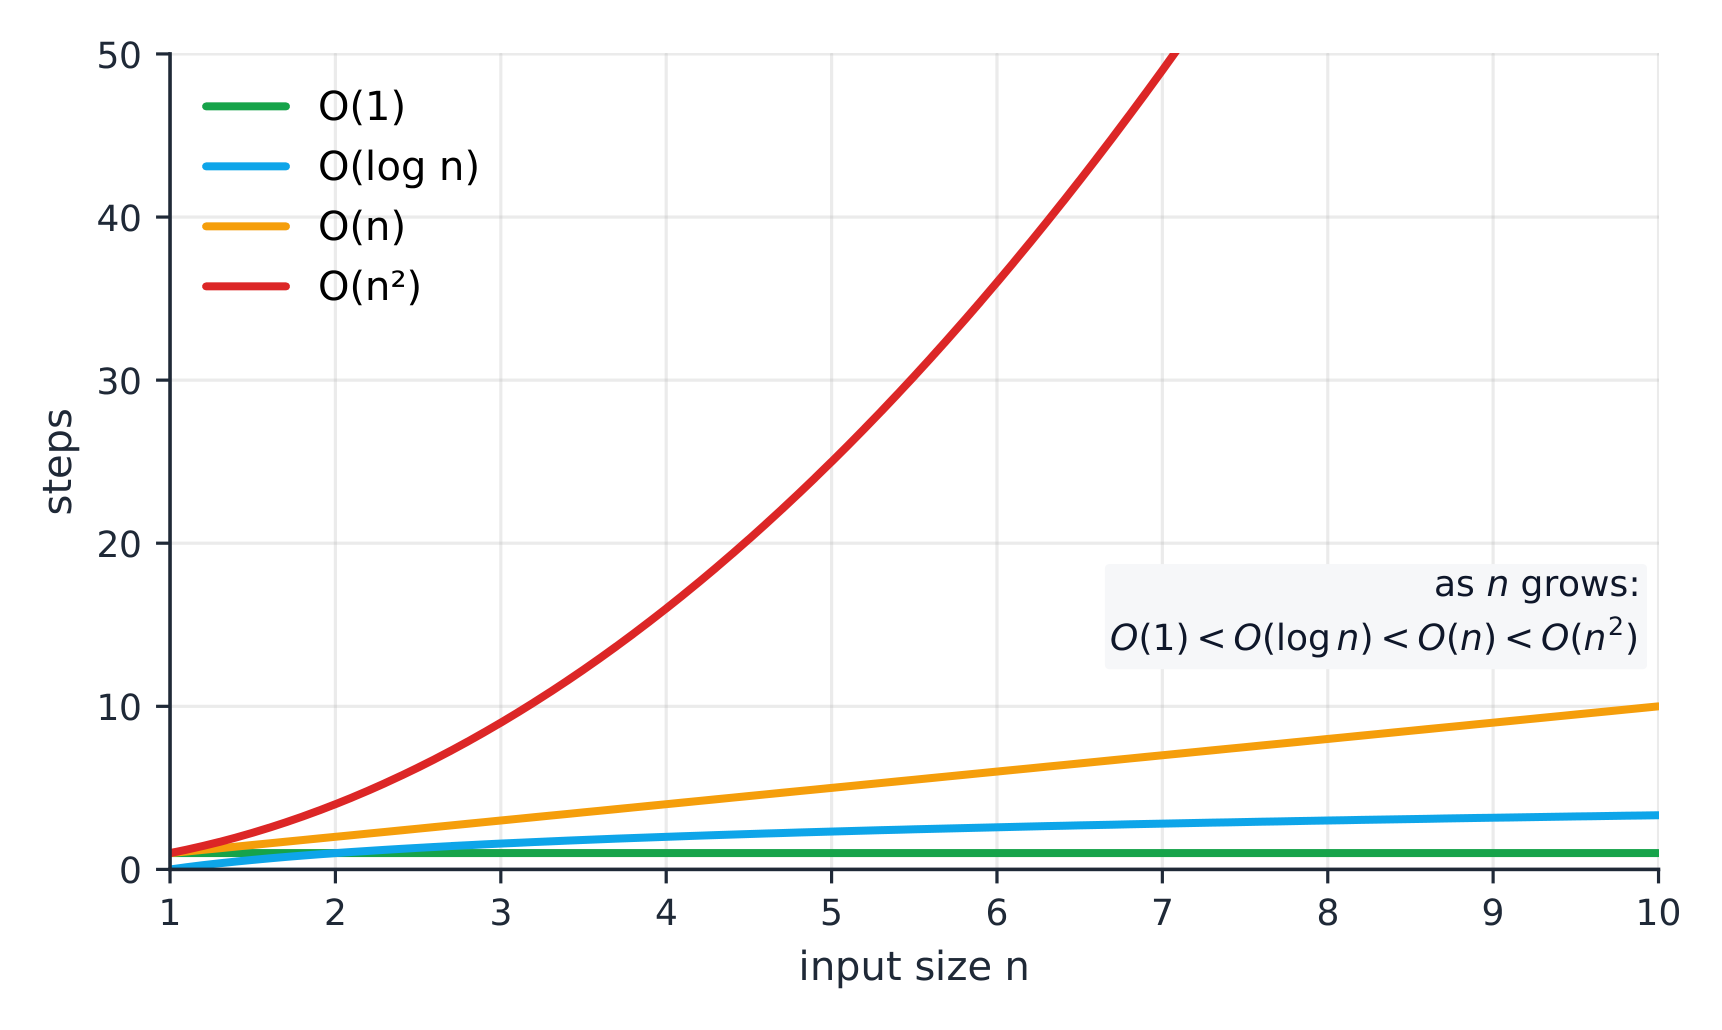
効率は、入力が増加した際に作業量がいかに増えるかを問うものです。Big-OOを用いて記述します。
| Big-O | 名称 | 例 |
|---|---|---|
| $O(1)$ | 定数 | 辞書のキーを参照 |
| $O(\log n)$ | 対数 | 二項探索 |
| $O(n)$ | 線形 | 線形探索 |
| $O(n^2)$ | 二次 | バブルソート |
def steps(n):           # how many steps a linear scan takes
    count = 0
    for i in range(n):
        count = count + 1
    return count

print(steps(100))       # 100  -> O(n)
randomモジュールは乱数を生成します。結果を再現可能にするためにシードを使用します。シミュレーションは多くの乱数試行を実行して答えを推定します。
import random
random.seed(0)
rolls = [random.randint(1, 6) for _ in range(1000)]
print(rolls.count(6))   # about 1/6 of 1000
** 一般的なミス **
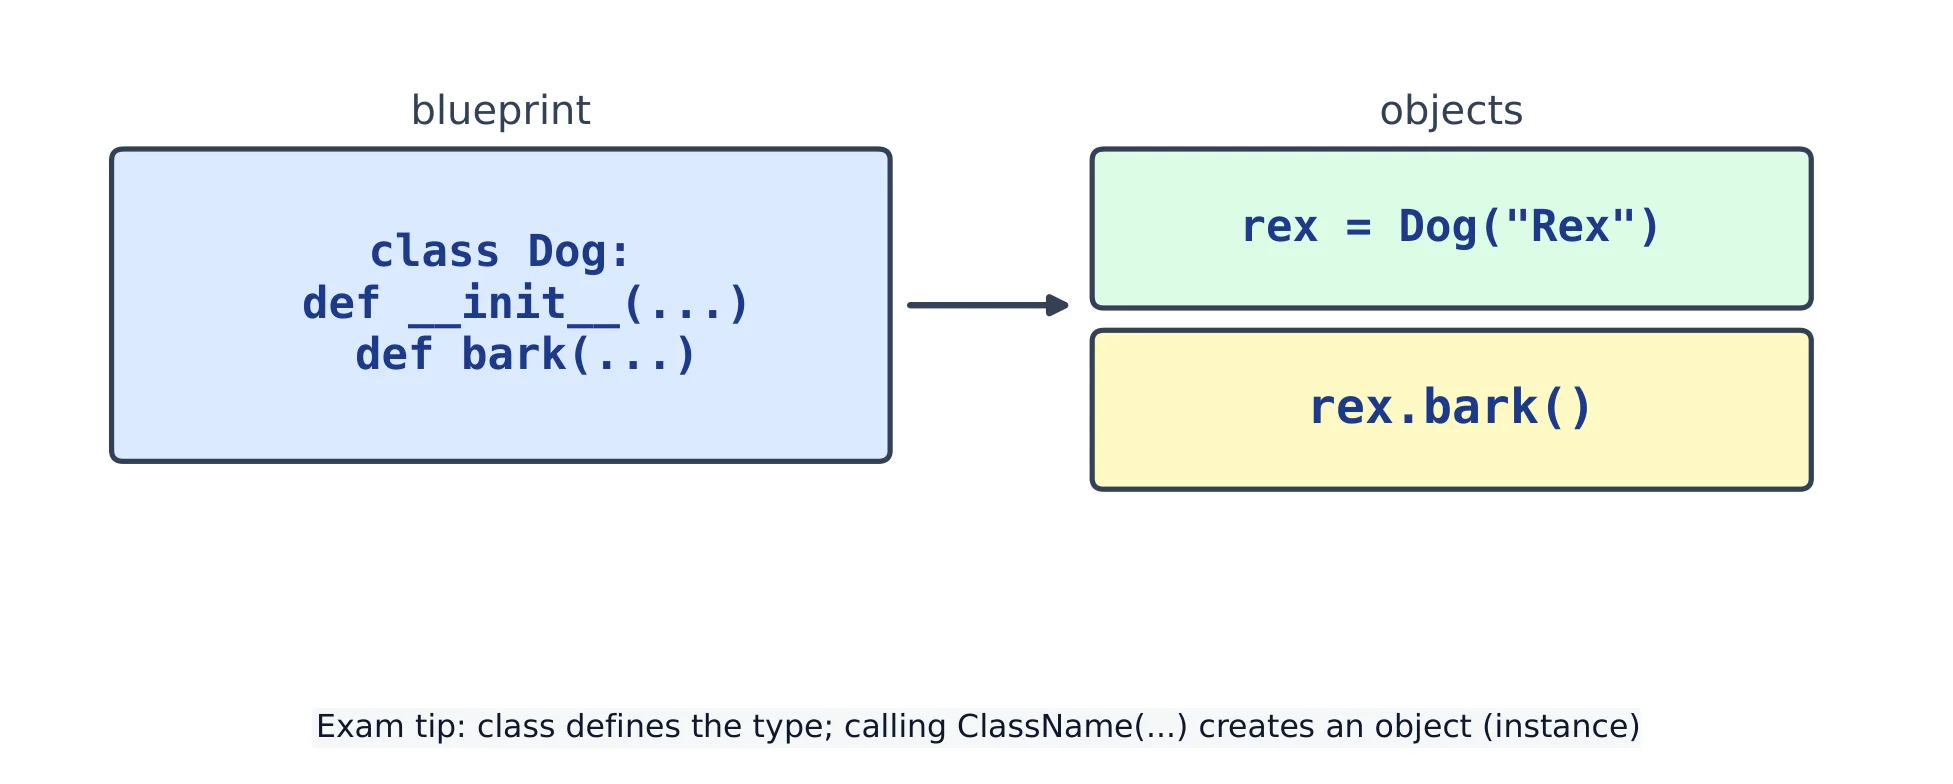
クラスは設計図です。オブジェクトはそれから作られた1つの事物(インスタンス)です。__init__ は各オブジェクトを初期化するコンストラクタであり、self はオブジェクト自体です。
class Dog:
    def __init__(self, name):
        self.name = name            # an attribute
    def speak(self):
        return self.name + " says woof"

d = Dog("Rex")
print(d.speak())     # Rex says woof
name は属性(オブジェクト上のデータ)であり、speak はメソッド(アクション)です。__str__ を追加して、print(obj) の表示を制御します:
class Dog:
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return f"Dog named {self.name}"

print(Dog("Rex"))    # Dog named Rex
継承によりサブクラスはスーパークラスの機能を再利用できます。親を呼び出すにはsuper() を使用し、メソッドをオーバーライドして変更します。
class Animal:
    def speak(self):
        return "some sound"

class Cat(Animal):
    def speak(self):                # override
        return "meow"

print(Cat().speak())   # meow
エンカプスレーションはデータとメソッドをグループ化し、意図されたインターフェースを曝露します。Pythonでは、先頭にアンダーバーがある名前は、慣習的に非公開(しばしばプライベートと呼ばれる)であることを示しますが、外部コードによるアクセスを阻止するものではありません。ダブルレディングアンダーバーネームマンギングは、セキュリティの強制ではなく、予期せぬ subclass ネーム衝突の回避に役立ちます。
class Account:
    def __init__(self):
        self._balance = 0           # non-public by convention
    def deposit(self, n):
        self._balance += n
    def balance(self):
        return self._balance

a = Account()
a.deposit(50)
print(a.balance())     # 50
多様性とは、1つの名前で多くの振る舞いがあることを意味し、各オブジェクトに対して適切なspeak が実行されます。
class Cat:
    def speak(self):
        return "meow"

class Cow:
    def speak(self):
        return "moo"

for animal in [Cat(), Cow()]:
    print(animal.speak())   # meow, then moo
パラダイムはプログラムを書くスタイルです。手続的コードは一連の手順と関数の列です。オブジェクト指向コードはデータとメソッドをオブジェクトにまとめます。宣言的コードは「どうやるか」ではなく「何をするか」を指定します(リスト内包表記やSQLなど)。
def total(nums):           # procedural
    t = 0
    for n in nums:
        t += n
    return t
print(total([1, 2, 3]))    # 6

print(sum([1, 2, 3]))      # 6  (declarative: same result)
** 一般的なミス **
self を必要とします。__init__ は新しいオブジェクトを初期化し、作成時に自動的に実行されます。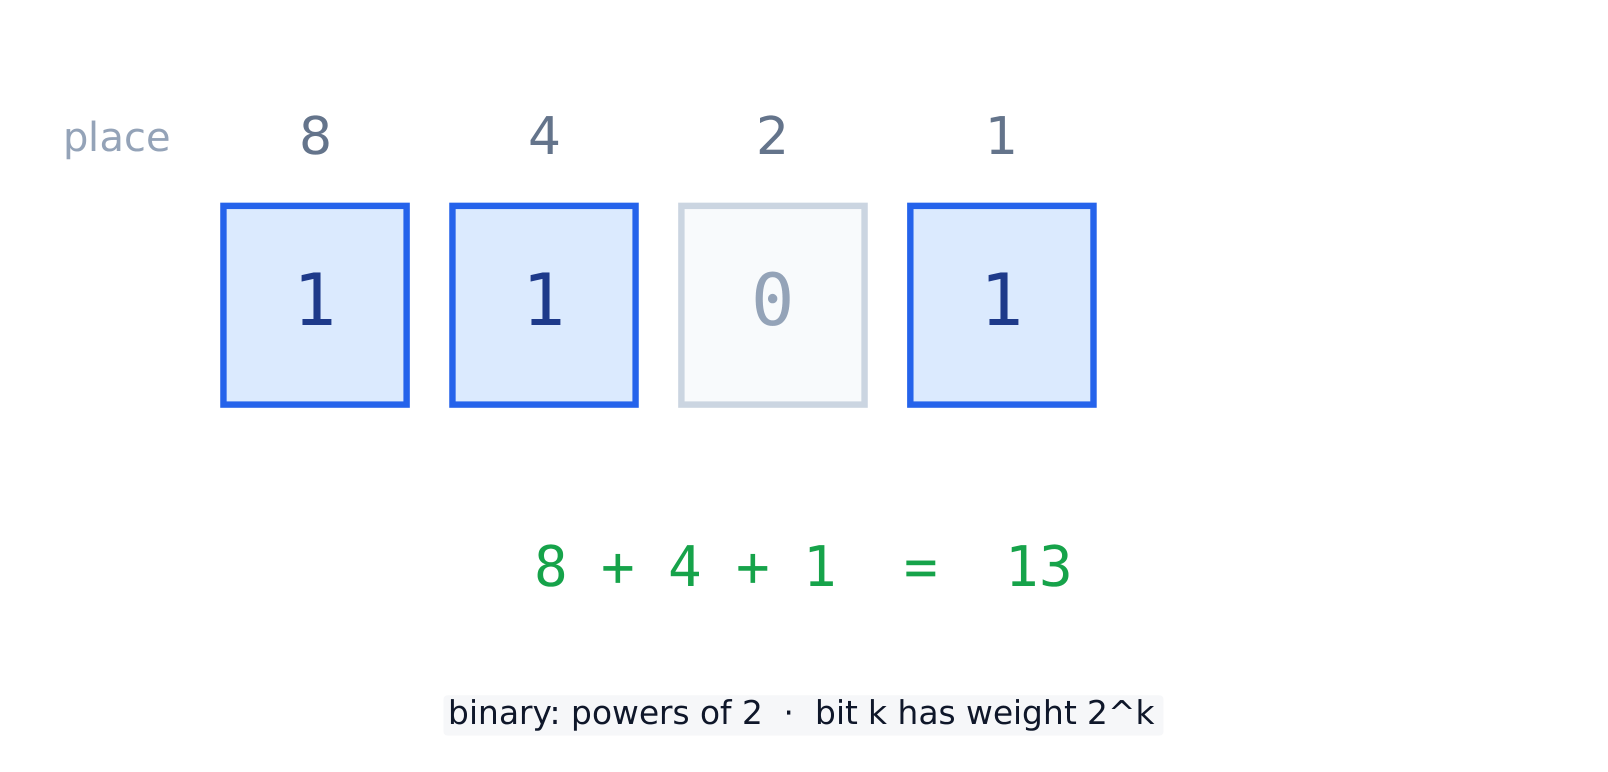
A bit is a single 0 or 1. Binary is the base-2 number system: each place is worth twice the one to its right (1, 2, 4, 8, …). Denary (base-10) is our normal numbers.
print(bin(13))         # 0b1101
print(int("1101", 2))  # 13
x = 250
x = (x + 10) % 256     # one byte wraps at 256
print(x)               # 4
十六進法(16進法)はバイナリをコンパクトに読むための方法で、1桁の十六進数字はちょうど4ビットを表します。Pythonでは0x で十六進数を出力します:
print(hex(255))        # 0xff
print(0xFF)            # 255
print(int("ff", 16))   # 255
圧縮はデータを小さくします。可逆圧縮はすべてのビットを保持するため、元のデータを正確に再構築できます。可逆圧縮(ロス圧縮)は詳細を捨てて小さくしますが完全ではありませんが、写真や音楽に使用されます。
ランレングス符号化は簡単な可逆圧縮法で、連続する同じ値(run)をカウントと値のセットとして保存します。
def rle(text):
    out = ""
    i = 0
    while i < len(text):
        run = 1
        while i + run < len(text) and text[i + run] == text[i]:
            run += 1
        out += str(run) + text[i]
        i += run
    return out

print(rle("AAAABBBCCD"))   # 4A3B2C1D
** 一般的なミス **
n ビットで、0 から2**n - 1 までの2**n 種類の値を格納できます。コンピューティングとは、コンピュータを用いて問題を解決することです:入力、処理、出力。良質なソフトウェアは、計画・作成・テスト・改善を繰り返すデザインサイクルによって構築されます。
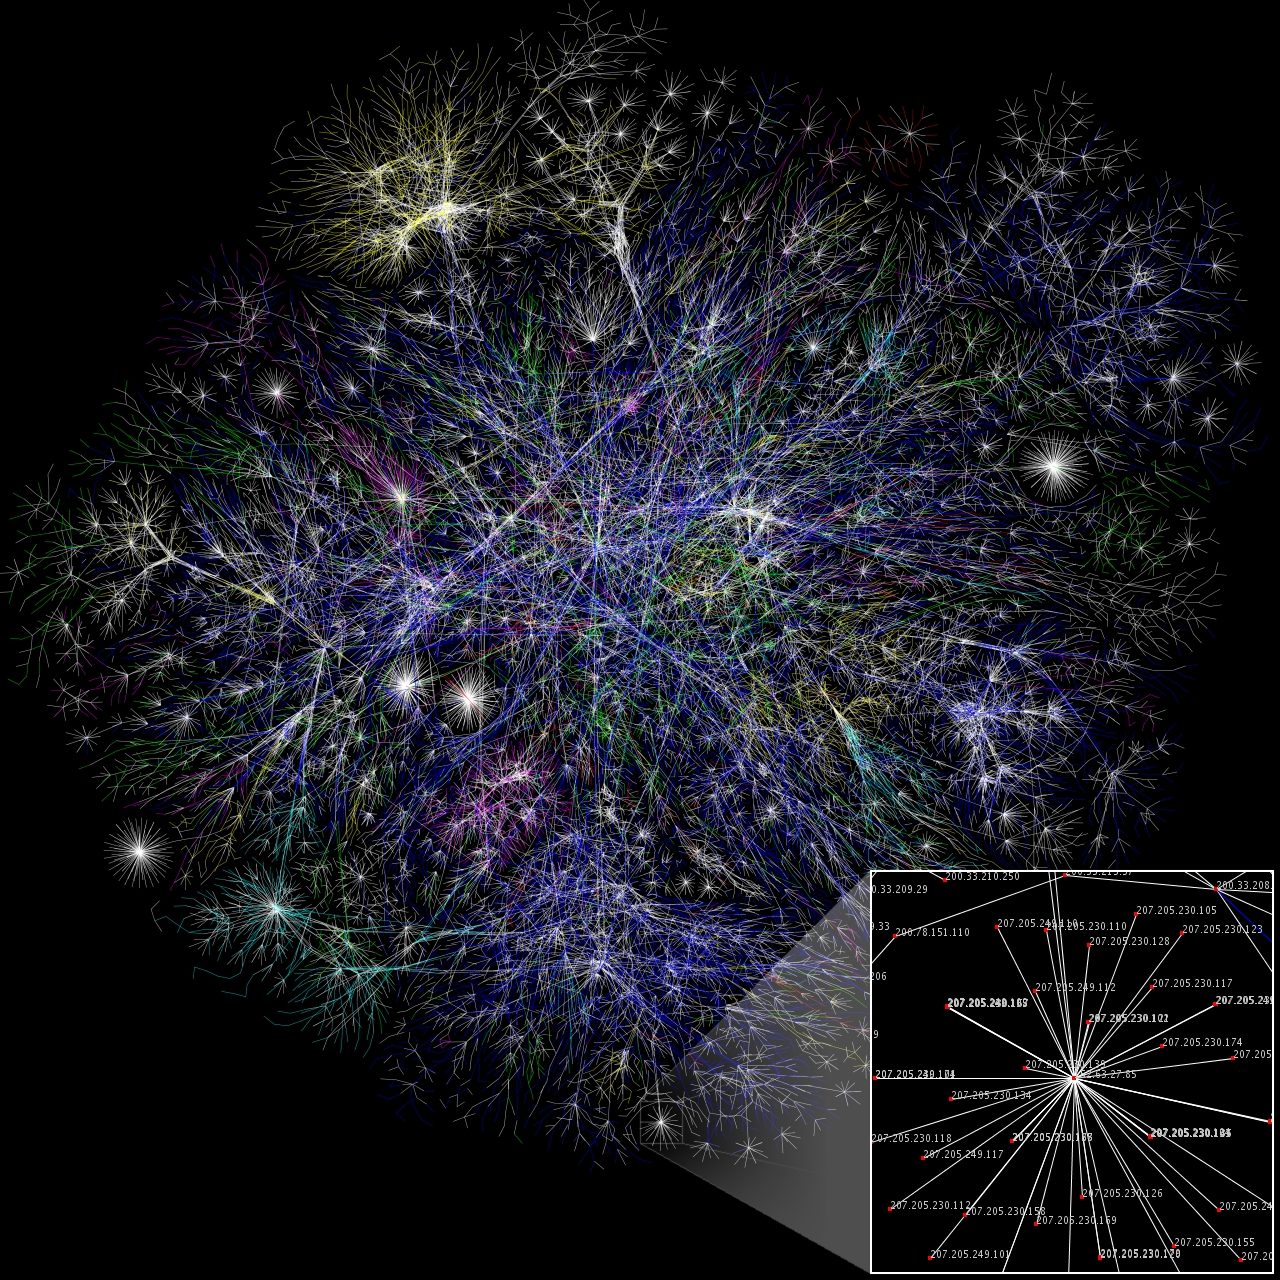
インターネットはネットワークのネットワークです。データはパケットに分割され、個別に送信されて相手が側で統合されます。TCP/IPのようなプロトコルと呼ばれる共有ルールがこの動作を可能にしています。あるパスが切断された場合、パケットは別の経路を取ります — これは冗長性であり、耐故障性を提供します。
| レイヤー | 役割 |
|---|---|
| HTTP | ウェブページの要求と送信 |
| TCP | 信頼性のある配送、順序通り |
| IP | アドレッシングとルーティング |
順次処理のコードは一度に1ステップしか実行しません。パラレルコンピューティングは多数のコアで複数のステップを同時に実行し、速度向上をもたらします。分散コンピューティングは、クラウドなど、多数のコンピュータに作業を分配します。
コンピューティングには利点も害もあります。デジタル・ディバイドとは、すべての人が平等にアクセスできるわけではないことを意味します。ソフトウェアは、学習データから偏見を含んでしまうことがあります。知的財産権(ライセンス)を尊重し、個人の個人情報やプライバシーを保護してください。
** 一般的なミス **
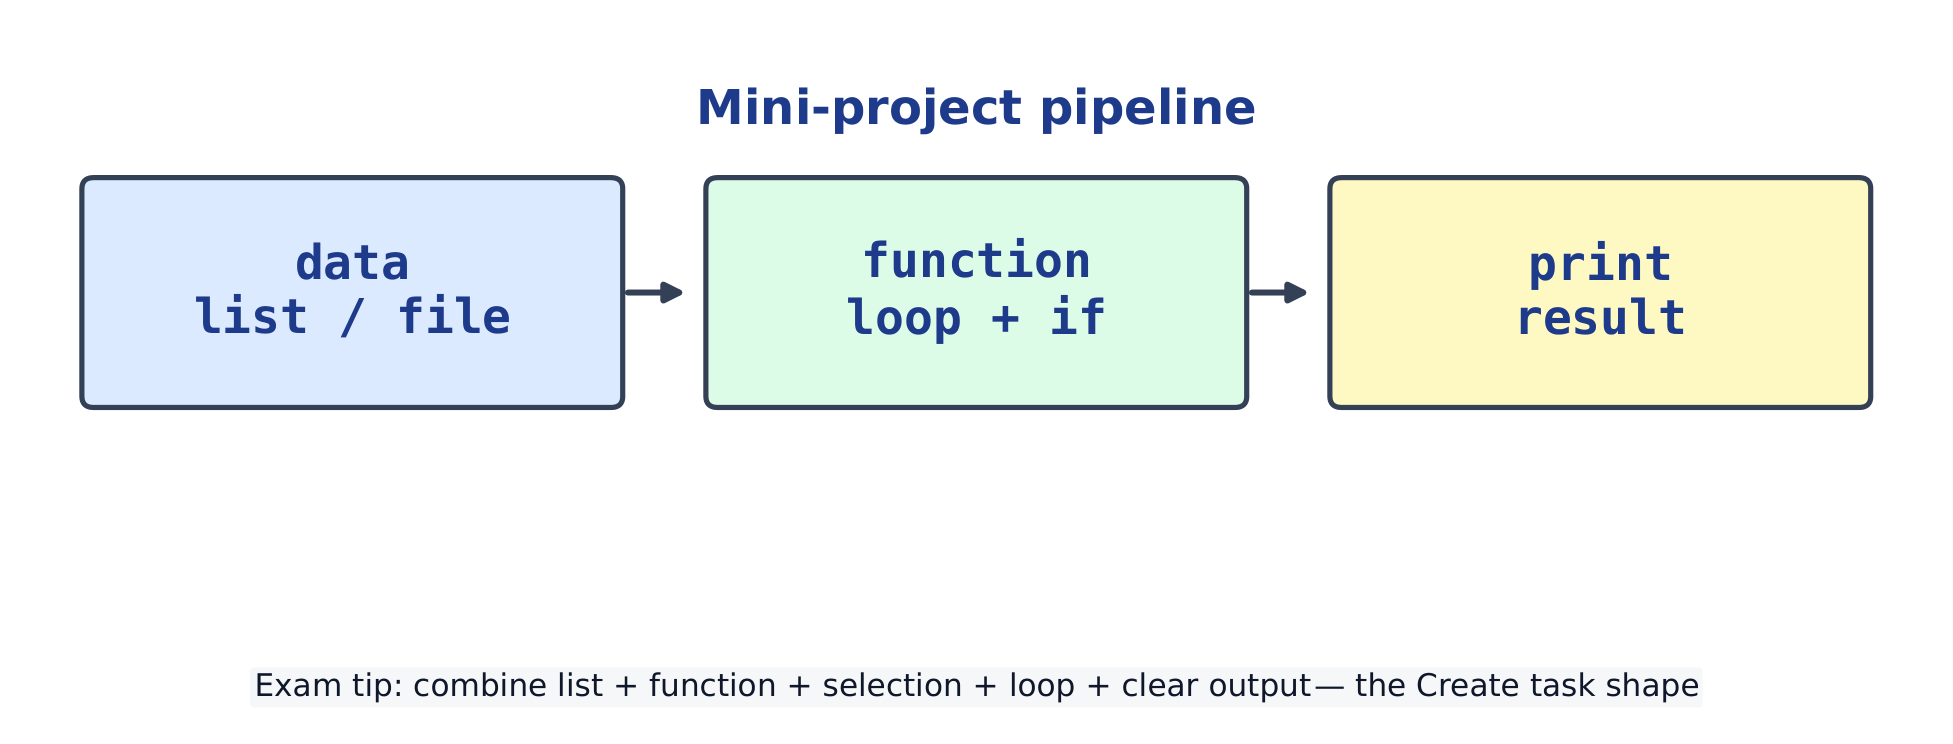
ミニプロジェクトは、リスト内のデータ、ループ内の選択文を含む関数、そして印刷出力といったそれまでのアイデアを統合したものです。これはAP Create Performance Taskの形式そのものです。
def average(marks):
    if len(marks) == 0:
        return 0
    return round(sum(marks) / len(marks), 1)

print(average([88, 71, 95, 60]))   # 78.5
def count_passes(marks, pass_mark=60):
    passes = 0
    for m in marks:                 # iteration
        if m >= pass_mark:          # selection
            passes += 1
    return passes

print(count_passes([88, 50, 95, 60]))   # 3
def merit(marks):
    return [m for m in marks if m >= 80]

print(merit([88, 71, 95, 60]))     # [88, 95]
AP Createタスクでは、リスト、選択と反復を使用するパラメータ付きプロシージャ、および入出力が必要です。上記の各プロジェクトはこの構造に完全に対応しています——小さな部品を組み立て、最後に結合してください。
** 一般的なミス **