Sorting and columns
このページには最新のブラウザ(SharedArrayBuffer対応)が必要です。Chrome、Edge、Firefox、Safariを最新バージョンに更新してください。
行を並べる
sortは行をアルファベット順に並べ替えます(-nを使うと数字として):
sort names.txt
sort -rは順序を逆転させ、sort -nは数字のリストに適しています。
重複を削除する
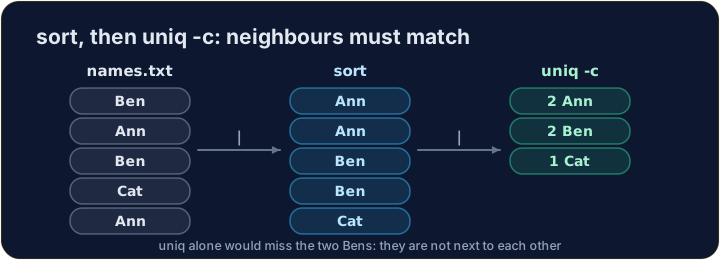
uniqは隣り合う重複した行を削除します。隣同士しか見ないため、通常はsortを先に行います:
sort names.txt | uniq
uniq -cを加えると、各行が何回出現したかも数え上げて表示します。
探索
sort, then uniq
uniq only sees neighbours — sort first, so the duplicates sit together.
カラムを抽出する
- 多くのファイルは、コンマ、コロン、タブなどの文字でカラムが区切られています。
cutは目的のカラムを抽出します。-dはdelimiter(区切り文字)を、-fはfield(フィールド)を設定します:
cut -d : -f 1 people.txt
- これは
name:ageの各行の最初のフィールド — 名前 — を取り出します。
よくあるミス
sortはアルファベット順、sort -nは数字を正しくソートします。cutには-dとセットの正しい区切り文字が必要です。
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
Get a tidy, de-duplicated list of names. Pipe sort 内へ uniq: sort names.txt | uniq.
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
people.txt has name:age on each line. Pull out just the names with cut -d : -f 1 people.txt.
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
How many times does each name appear in names.txt? Show each name once, with its 個体数 in front.
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
sizes.txt holds three file sizes. Sort them as numbers, largest first. (Plain sort -r puts 9 first: it compares text.)