行うこと
- 2つのプログラムがどちらも正解であっても、要する時間が全く異なることがあります。
- このレッスンは効率性についてです:入力の増加に伴って作業量がいかに増えるかです。
- 考え read して考え、その後、短いタスクで自身が手順を数えることができます。
作業量の計測
- アルゴリズムを測るのは秒数ではなく、何步骤行うかです。
- 秒単位のステップ数はコンピュータに依存しますが、ステップ数の計測はそうではありません。
- 入力が増えると通常、ステップ数も増えます。問題は、どれだけ増えるかです。
妥当な実行時間 vs 不適切な実行時間
- 妥当な時間とは、処理ステップ数が多項式関数、またはそれより緩やかに増加する場合を指す。一定、線形、二乗、三乗などである。
- 単一のループは線形成長である。ループの中にループがある場合、それは二乗成長(n × n)となる。二乗成長は線形成長よりも速いが、依然として妥当な時間の範囲内である。
- 不適切な時間とは、指数関数や階乗関数的に増大する場合を指す。入力量にわずかな増加があっただけで、処理時間が爆発的に膨らむ。
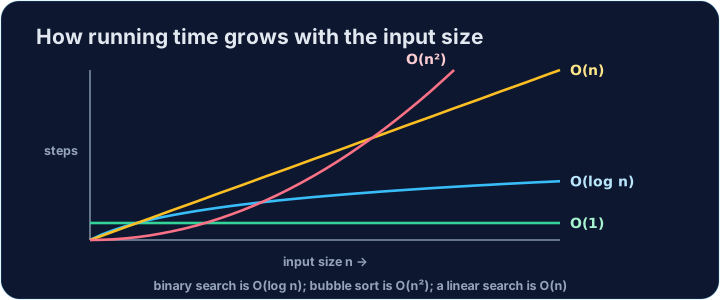
Input size:      10          20          40
Search a list:   10          20          40          (linear - reasonable)
Nested loops:    100         400         1,600       (square - still reasonable)
Try all orders:  3,628,800   ...         48 digits   (factorial - unreasonable)
小さなデモ:ステップ数のカウント
- 以下では、リニア検索が行う比較回数カウントします。
- カウントはリストサイズに比例して増大します — ゆっくり、着実に成長します。
- サイズを変えてみてください。カウントがそれに追従することを確認できます。
def count_steps(n):
    steps = 0
    data = list(range(n))
    target = -1            # not in the list, so we scan everything
    for item in data:
        steps = steps + 1
        if item == target:
            break
    return steps

print(count_steps(10))
print(count_steps(20))
print(count_steps(40))
速さが十分でない場合
- 妥当な時間で解けるアルゴリズムが存在しない問題もある。
- 厳密解法ではすべての順序を試すことがある。これは階乗成長であり、入力が大きい場合は不適切な時間となる。
- ヒューリスティックとは、十分良好な解答を与えるための近道である。必ず最良解になる保証はない。特定のヒューリスティックを暗記する必要はない。
決定不可能な問題
- 遅いよりも酷い:どのようなアルゴリズムでも解決できない問題があります。
- これらは決定不可能な問題と呼ばれます。
- コンピュータがいくら速くなっても、常に正しい答えを与えるプログラムは存在しません。
Reasonable   : constant, linear, square or cube growth
Unreasonable : exponential or factorial growth
Undecidable  : no algorithm can solve it for every input
覚えておくべき重要ポイント
- 効率性とは、コンピュータ1台あたりの秒数ではなく、入力サイズに対してステップ数がどのように増大するかに関するものである。
- 多項式成長以下であれば妥当な時間である。二重ループ(n × n)であっても妥当な時間である。
- 指数関数や階乗関数的な成長は不適切な時間である。また、一部の問題は判定不能である。
よくあるミス
- 二重ループを不適切な時間と見なすことはない。二乗成長や三乗成長は妥当な時間の範囲内である。
- 試験では形式的なBig-O表記を用いることを原則とする。ただし、Big-O自体が直接出題されるわけではない。線形以下の多項式成長と、指数関数・階乗成長との区別が問われる。
あなたも試してみよう
- ステップ数をカウントする小さな関数を書いて、作業量がどう成長するかを実感してください。
- 単一ループ、二重ループ、「すべての順序を試す」を比較する。二重ループは妥当な時間である。答えを確認ボタンを押す。
How algorithms scale
Square growth rises faster than a straight line, and it is still reasonable time. Factorial growth is unreasonable.
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
Write scan_compares(data, target) that returns how many comparisons a linear search makes. Compare each item to target, counting one each time, and stop as soon as you find it. If it is not in the list, you compared every item. Example: scan_compares([5, 8, 2], 8) → 2.
実行ボタンをクリックして出力を確認してください。
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
Write pair_count(n) that uses a loop inside a loop (both over range(n)) and returns how many times the inner step runs. This is n × n. Example: pair_count(3) → 9. This grows much faster than a single loop.
実行ボタンをクリックして出力を確認してください。
難易度 3/5 · 200 コイン + 今日初回達成時の小ボーナス
Write count_orderings(n) that returns how many different orders n items can be placed in — that is 1 × 2 × ... × n (n factorial). count_orderings(0) is 1. Example: count_orderings(3) → 6. Notice how fast it explodes: count_orderings(10) is over 3 million.
実行ボタンをクリックして出力を確認してください。