Qué es este curso y cómo usarlo
Este es el tercer curso de Ciencias de la Computación Universitaria: fundamentos de sistemas informáticos — desde un bit hasta un programa en ejecución: cómo viven los números en los cables, cómo deciden las puertas lógicas, cómo avanza el procesador, y cómo el SO y la cadena de herramientas entregan su programa al silicio. Límite de alcance, enunciado una vez: un curso de estudio, no un grado; cada
Límite de alcance, declarado una sola vez: un curso de estudio, no un grado; cada El fragmento de programa es original y autocontenido.
- Las unidades 3.1–3.2 son el alfabeto de la máquina: bits, codificación, puertas lógicas.
- Las unidades 3.3–3.4 son la propia máquina: procesador, memoria, instrucciones.
- Las unidades 3.5–3.6 son la maquinaria que lo rodea: servicios del SO, el flujo de compilación.
La costumbre sistémica: toda abstracción es un contrato con la capa inferior** — cada unidad nombra el contrato, y toda conversión es algo que puedes verificar mediante script.
Binario y codificación de datos
Por qué importa. Todo debajo del código fuente son bits; conocer cómo se codifican números, fracciones y texto explica cada sorpresa desde contadores desbordados hasta 0.1 + 0.2 ≠ 0.3.
La idea, con una imagen. Notación posicional base-2; bits $n$ sin signo para signed: invierte todos los bits, suma $0$ — rango de $2^n - 1$ a para signo: invertir todos los bits, sumar 1 — rango $-2^{n-1}$ a $2^{n-1} - 1$ ✓. El acarreo fuera del bit superior siempre se descarta; desbordamiento ocurre solo cuando dos operandos del mismo signo dan un signo, exponente (sesgado), fracción ✓; texto: ASCII ASCII (754 bits, 754 signo, exponente (sesgado), fracción ✓; texto: ASCII ASCII (7 bits, 128 códigos) y Unicode (puntos de código, UTF-8 ancho variable).
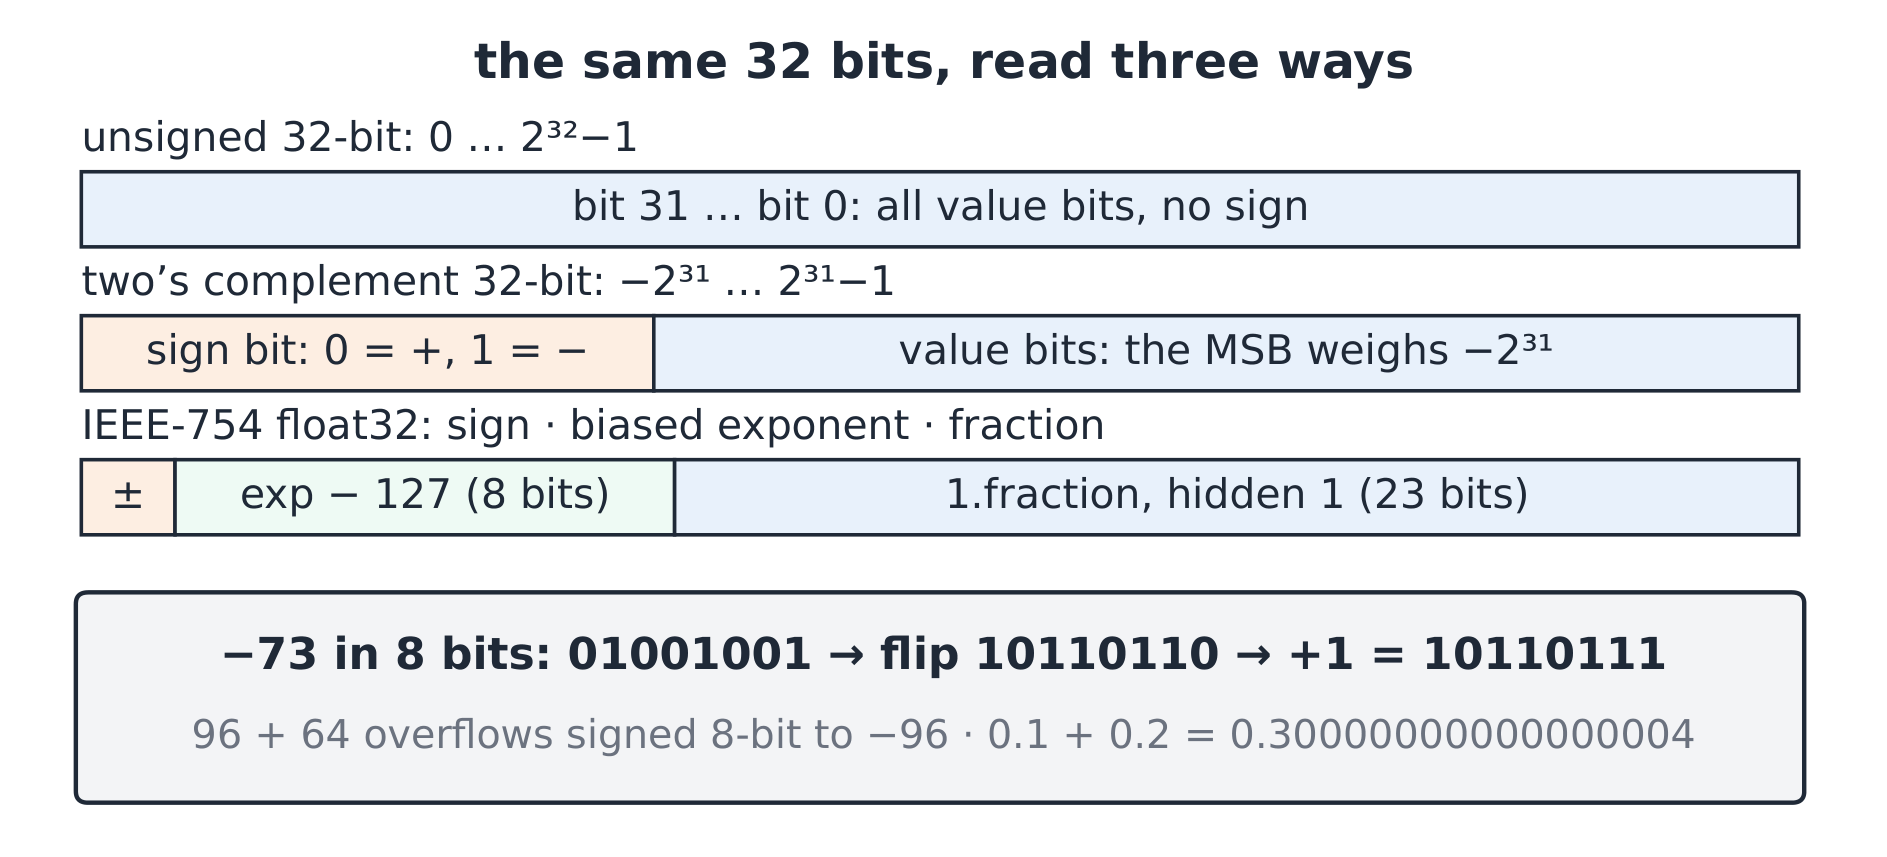
La derivación (por qué gana el complemento a dos). El complemento a dos convierte la resta en una suma: $a - b = a + (-b)$ con un solo sumador. La prueba es modular: $-b \equiv 2^n - b \pmod{2^n}$, e invertir-más-uno calcula exactamente $2^n - b$ ✓. Un circuito para + y −; esa economía es por lo que se hizo universal.
Ejercicio resuelto 1 — conversiones y desbordamiento. Complemento a dos de 8 bits: ¿$-73$? $73 = 01001001_2$; invierta $\to 10110110$; agregue 1 $\to 10110111 = -73$ ✓. Sumar $96 + 64 = 160$: bien como unsigned ($10100000_2$), pero como signed el máximo de 8 bits es $127$ — desbordamiento, y el patrón almacenado se lee como $-96$ ✓.
Ejercicio resuelto 2 — sorpresas del flotante. $0.1$ en binario es infinito ($0.000110011\ldots$); IEEE redondea — así que $0.1 + 0.2$ produce $0.30000000000000004$: un error de redondeo, no un error del lenguaje ✓. También: porque el exponente escala la separación, los flotantes adyacentes NO están uniformemente espaciados — densos cerca de cero, dispersos lejos.
Errores comunes. Asumir que un patrón de bits tiene un único valor: $10110111$ es $183$ sin signo pero $-73$ con signo (los bits son los bits; el tipo los interpreta). Esperar igualdad de flotantes tras operaciones aritméticas. Confundir código de carácter con número (el carácter 1 almacena el código $49$, no $1$).
Resumen. Entero sin signo $0..2^n-1$; complemento a dos: invertir y sumar 1, un sumador para + y −; descartar el acarreo de signo; IEEE: signo-exponente-fracción con redondeo; ASCII 7-bit, puntos de código Unicode, UTF-8 ancho variable; $0.1 + 0.2 \ne 0.3$ por redondeo.
Puertas lógicas y bloques digitales básicos
Por qué es importante. Las puertas son la frontera entre física y lógica: todo programa se reduce a ANDs, ORs y NOTs al final, y el álgebra booleana es el optimizador.
La idea, con una imagen. AND, OR, NOT; combinarlos en NAND (universal — toda puerta puede construirse a partir de ella ✓). Bloques básicos: el sumador medio (XOR = suma, AND = acarreo), sumador completo (dos sumadores medios + OR, acarreos encadenados en un sumador de propagación) multiplexor (la línea de selección elige una entrada) ✓.
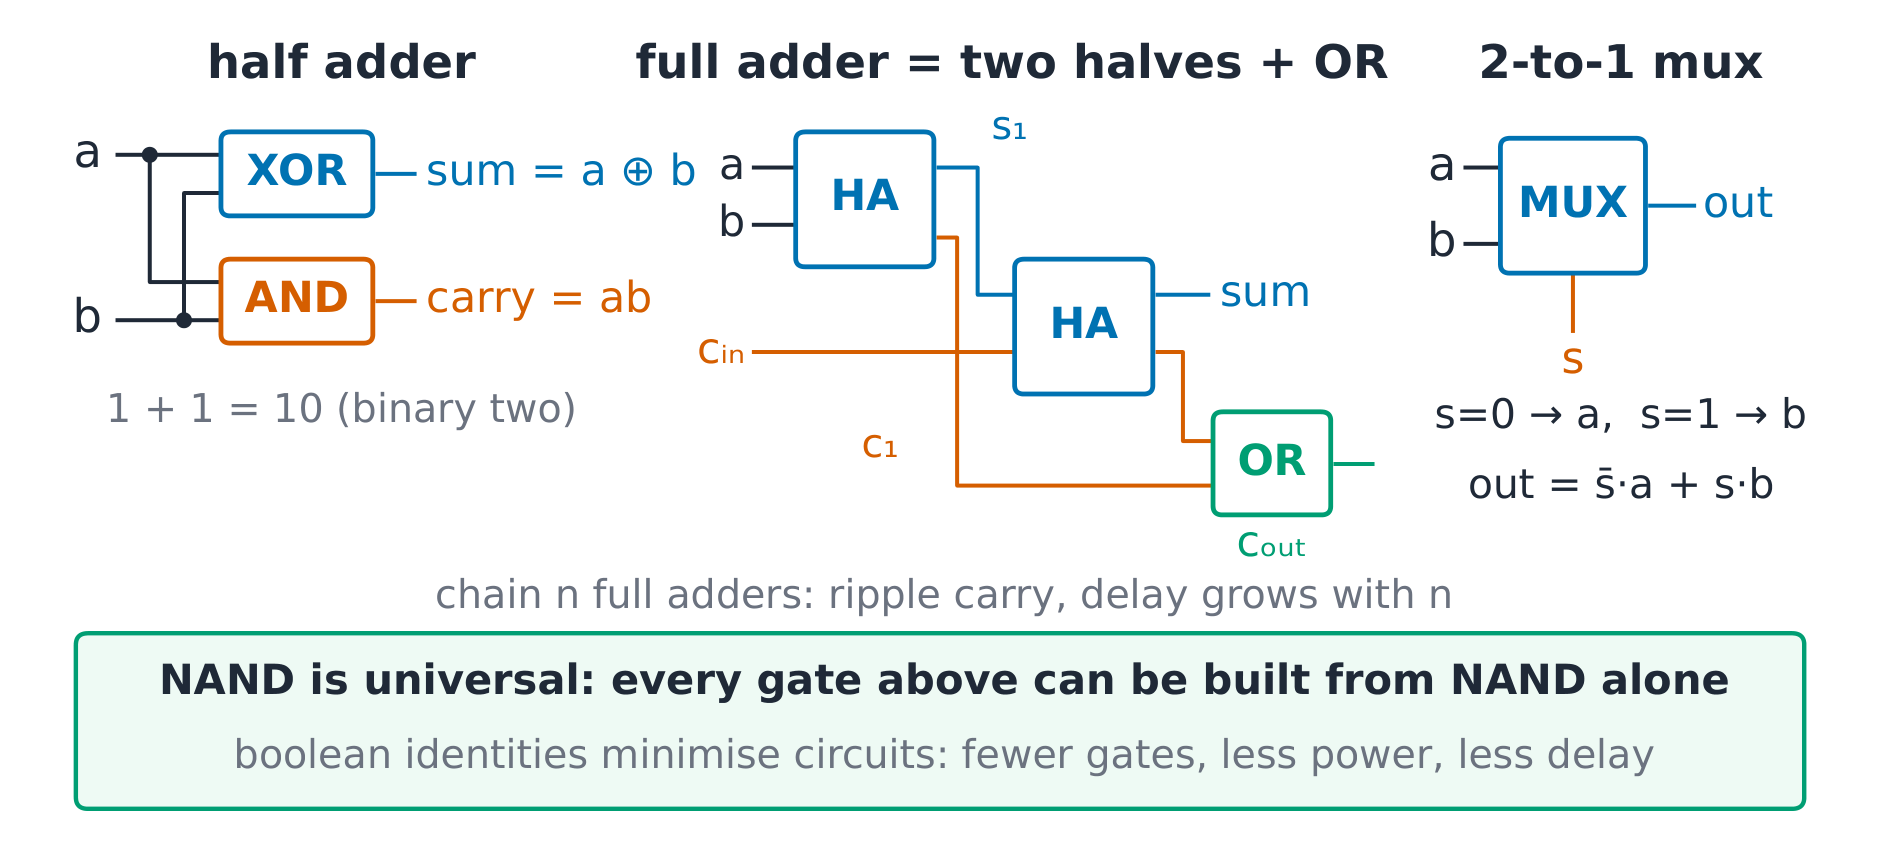
La deducción (por qué el álgebra booleana optimiza circuitos). Identidades ($x + x = x$, $x \cdot x = x$, $x + \bar{x} = 1$) permiten que dos expresiones con una misma tabla de verdad colapsen en un solo circuito — p. ej., la expresión del mux $x = \bar{s}\,a + s\,b$ ya es mínima, mientras que una La OR ingenua de las cuatro filas donde la salida es 1 no es ✓. Menos puertas, menos energía, menor retardo.
Ejemplo resuelto 1 — suma de un bit. Suma $s = a \oplus b$, acarreo $c = ab$: filas $1+0 \to s=1, c=0$; $1+1 \to s=0, c=1$ (binario 10) ✓ — dos puertas, aritmética correcta. Enlaza cuatro para 0101 + 0011.
Ejemplo resuelto 2 — multiplexor de 2 a 1 en puertas. Salida $= \bar{s}a + sb$: cuando $s = 0$, pasa $a$; cuando $s = 1$, pasa $b$ ✓. Luego 4-a-1 = tres etapas de 2-a-1. Un multiplexor de 32-a-1 usa la misma idea, cinco capas de profundidad.
Errores comunes. Escribir XOR como OR (la fila $1+1$). Olvidar el retardo de propagación de la cadena de acarreos (el acarreo en cascada añade retardo de puerta por bit). Creer que las puertas son instantáneas (el retardo es lo que limita la velocidad del reloj).
Resumen. NAND universal; sumador medio XOR+AND; sumador completo encadenado; el retardo de acarreo en cascada aumenta con el ancho; multiplexor $\bar{s}a + sb$; identidades booleanas minimizan los circuitos.
Visión general del procesador y la memoria
Por qué importa. La CPU es un bucle y la memoria es una pirámide: ambas imágenes explican la velocidad, el coste y por qué la caché determina el rendimiento más que el reloj.
La idea, con una imagen. Ciclo de búsqueda-decodificación-ejecución --: búsqueda (PC $\to$ memoria $\to$ IR), decodificación (instrucción $\to$ señales de control), ejecutar (ALU / memoria / actualización del PC), PC $\to$ PC + 4 ✓. La jerarquía de memoria: registros (ns) $\to$ L1/L2/L3 caché $\to$ DRAM ($\sim$100 ns) $\to$ SSD $\to$ disco — cada capa más grande y más lenta ✓.
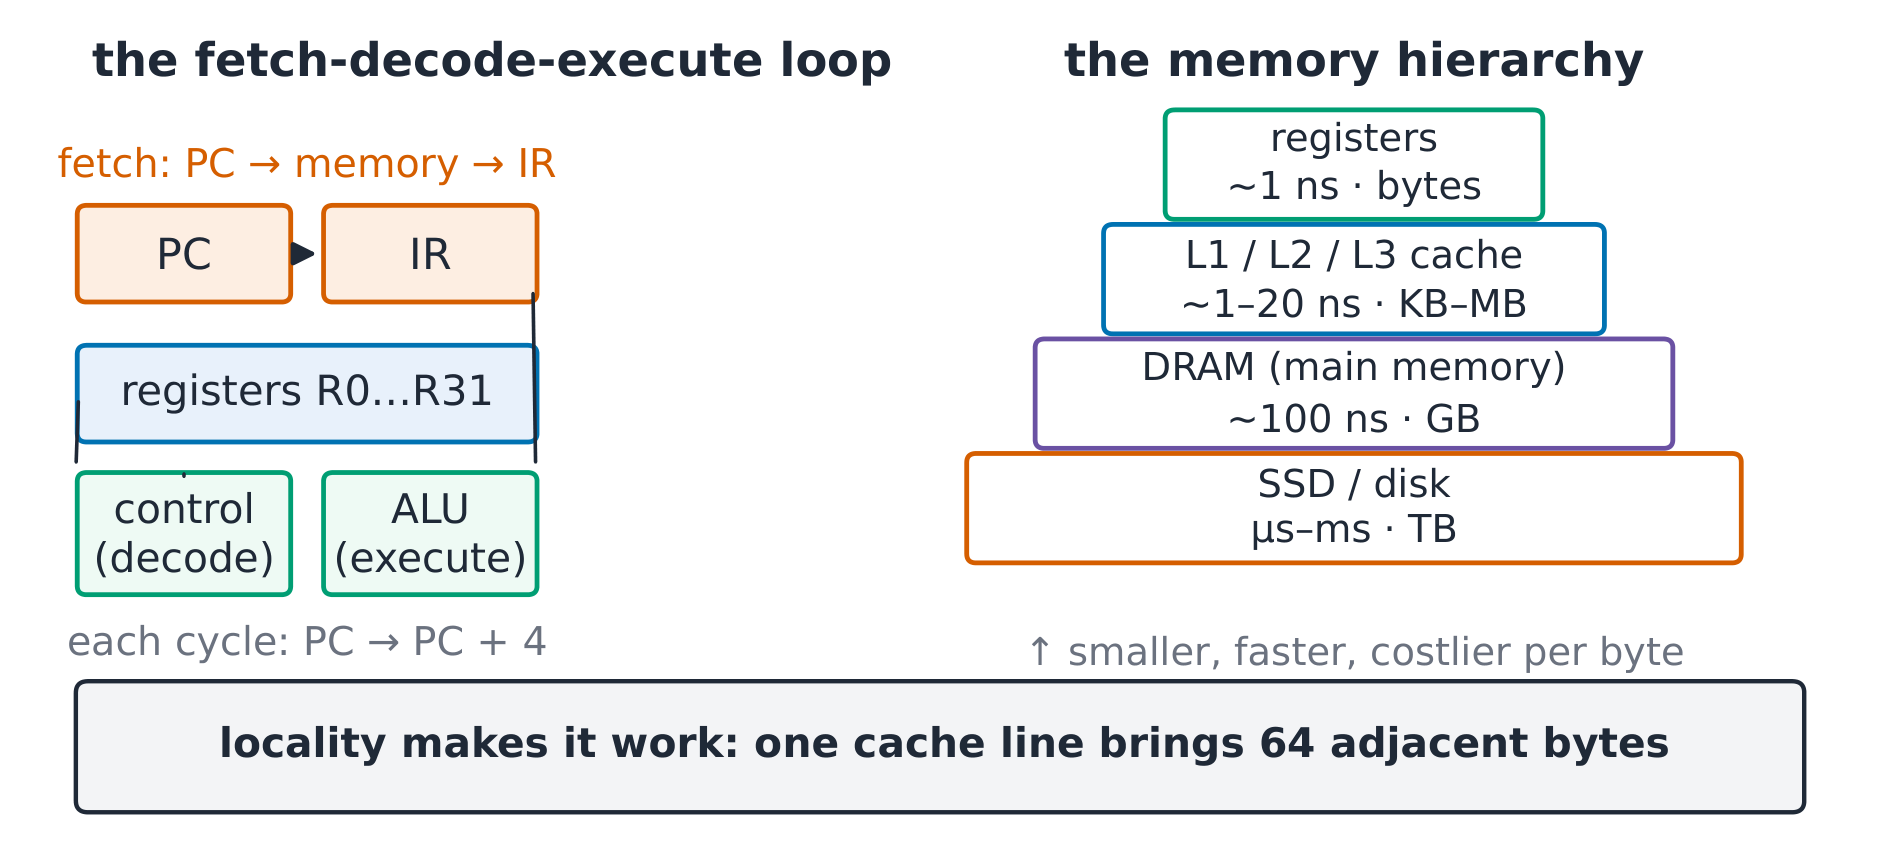
La derivación (por qué existe la jerarquía). Velocidad vs. costo vs. tamaño es un compromiso físico: la memoria rápida es costosa por byte, la memoria grande es lenta. La jerarquía explota la localidad — los programas acceden repetidamente a un conjunto de trabajo pequeño (temporal) y direcciones cercanas (espacial) — para que una caché pequeña y rápida contenga la mayoría de las referencias ✓.
Ejemplo resuelto 1 — trazando tres instrucciones. LOAD R1, 0(R2) /
ADD R3, R1, R1 / STORE R3, 0(R2): cada paso cambia los registros
(R1, luego R3, luego memoria) ✓; el PC avanza en 4 después de cada
instrucción; una ramificación escribe una nueva dirección en el PC.
Ejemplo resuelto 2 — por qué importa el diseño de datos. Una suma de matriz está limitada por la memoria, no por la aritmética: leer una línea de caché trae 64 bytes adyacentes, por lo que el acceso en orden de filas es rápido; un bucle transpuesto es muchas veces más lento con el mismo número de operaciones ✓. La jerarquía, no el reloj, decide.
Errores comunes. Confundir IR (registro de instrucción) y PC. Leer la latencia DRAM en ciclos como si fuera constante (los aciertos y fallos de caché difieren en órdenes de magnitud). Asumir que la visión de memoria de la CPU es la física (la virtual de 3.5 interviene).
Resumen. Obtener $\to$ decodificar $\to$ ejecutar, PC+4; registro-IR-ALU alrededor del bucle; jerarquía: registros-caché-DRAM-SSD; la localidad lo hace funcionar; el diseño de datos puede dominar a la aritmética.
Instrucciones de máquina
Por qué importa. El ensamblador es el contrato al que apunta cada compilador y cada pregunta de rendimiento se reduce finalmente a: registros, valores inmediatos y transferencias de memoria.
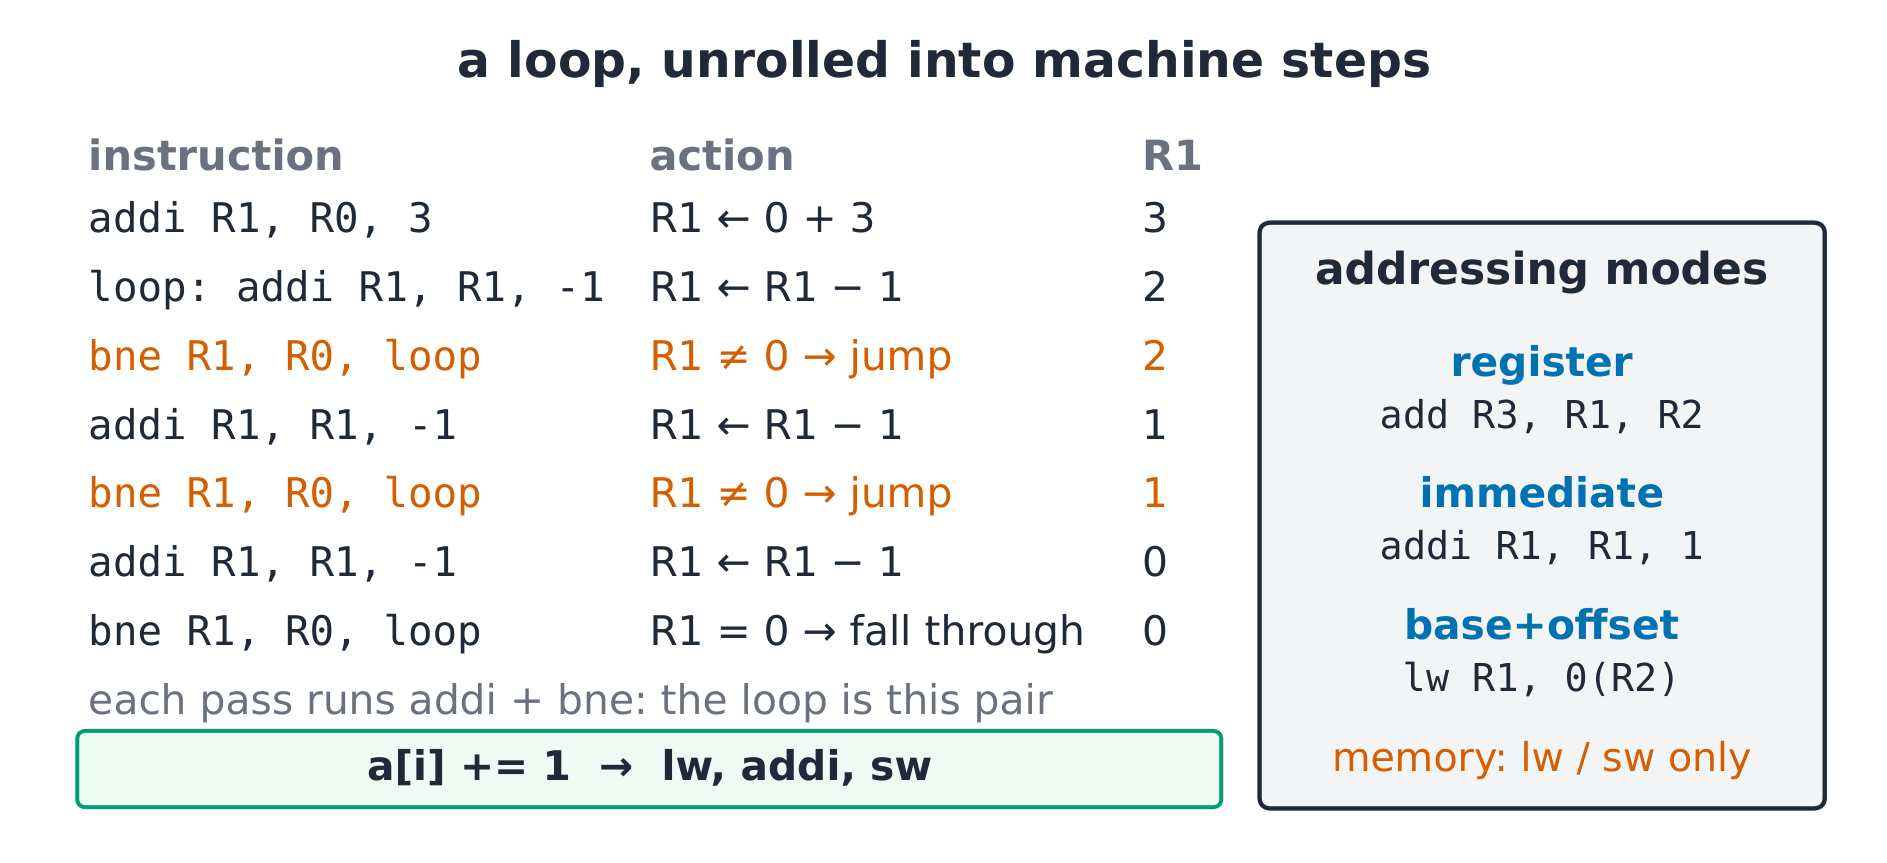
La idea, con una imagen. Instrucciones RISC: add rd, rs1, rs2
(solo registros), addi (inmediato), lw/sw (memoria, direccionamiento
como 0(R2)), beq/bne (comparar y saltar) ✓. Modos de direccionamiento
: registro, inmediato, base + desplazamiento — solo memoria vía
carga/almacenamiento.
La derivación (por qué RISC es solo carga/almacenamiento). Una sola forma de instrucción
se decodifica rápido y se adapta bien al pipeline: cada acceso a memoria es explícito
lw/sw; la aritmética es de registro a registro. CISC empaqueta el acceso a memoria
en la aritmética: más compacto, más difícil dexDar ✓. El compromiso
es entre el número de instrucciones y la velocidad por instrucción.
Ejemplo resuelto 1 — un bucle en pasos de máquina.
loop: addi R1, R1, -1; bne R1, R0, loop: resta, comparación con cero,
salto hacia atrás — dos instrucciones por iteración; un bucle C while se mapea a
exactamente este par más el cuerpo ✓.
Ejemplo resuelto 2 — mapeo de C a instrucciones. a[i] = a[i] + 1
se compila como lw (carga), addi, sw (almacenamiento) con el índice escalado
hacia el desplazamiento ✓. El indexado de arrays es aritmética de direcciones; los punteros son
registros base; ese es todo el secreto.
Errores comunes. Leer 0(R2) como el valor 0 (es el
desplazamiento 0 sobre R2). Olvidar inicializar el registro del contador de bucle
usar el índice $i$ como desplazamiento en bytes sin escalarlo por
el ancho del elemento ($4i$ para palabras de 4 bytes).
Resumen. add/addi/lw/sw/beq; la memoria solo mediante carga/almacenamiento base+desplazamiento; mientras que $\to$ decremento y salto; el indexado de arrays es aritmética de direcciones escalada; a[i]+1 es lw-addi-sw.
La interfaz del sistema operativo
Por qué importa. Ningún programa accede directamente al hardware: el SO comparte el máquina segura: los procesos, la memoria virtual y los archivos son los servicios que consume cada programa.
La idea, con una imagen. Un proceso = programa + ejecución
estado (espacio de direcciones, registros, archivos abiertos); un cambio de contexto
guarda y restaura ese estado ✓. Memoria virtual:
cada proceso ve sus propias direcciones; el SO + hardware (TLB, tablas
de páginas) mapean la virtual $\to$ a la física. Archivos son flujos
de bytes nombrados; las llamadas al sistema (open, read, write, fork, execve) son
el límite donde su código solicita al kernel ✓.
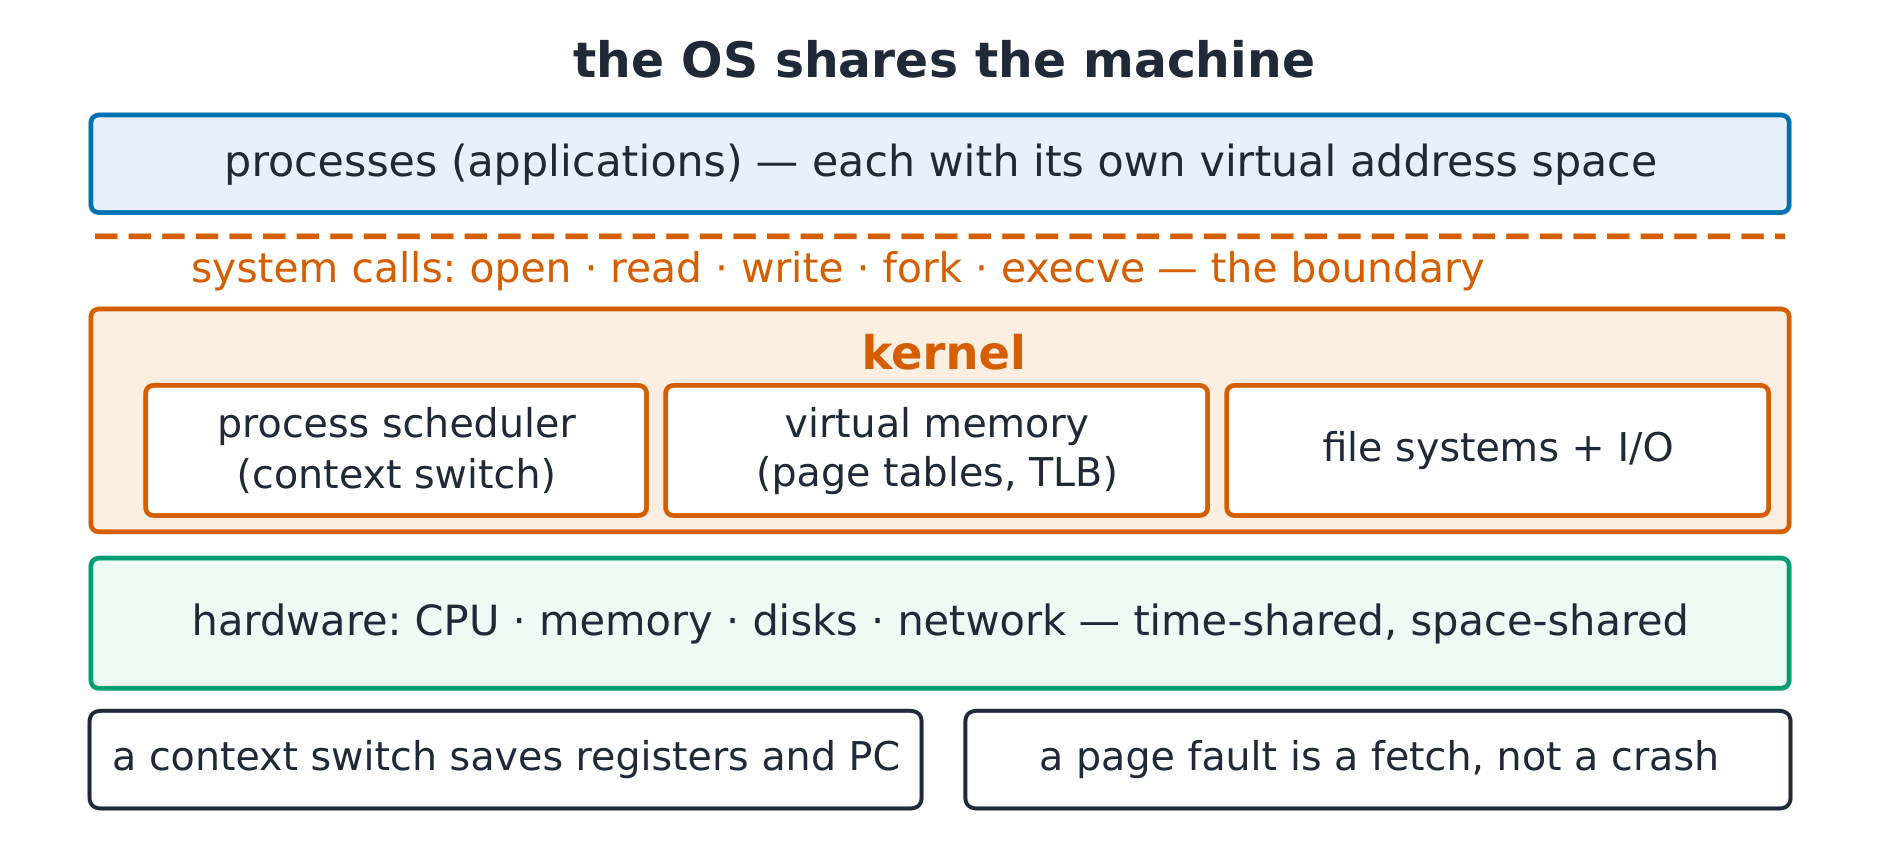
La derivación (por qué la memoria virtual). Aislamiento (un proceso no puede leer las páginas de otro), ilusión (más memoria que la física, mediante paginación al disco), y conveniencia (los programas se vinculan a direcciones fijas) — tres necesidades que cumple una sola abstracción ✓. Una falla de página ocurre cuando un acceso no puede proceder con el mapeo o permisos actuales de la página. El SO puede cargar o asignar una página válida; un acceso inválido en cambio puede terminar el proceso.
Ejemplo resuelto 1 — qué preserva un cambio de contexto. Registros, PC, mapeos de memoria, tabla de archivos abiertos: todo lo que necesita la siguiente instrucción de ese proceso; lo que NO se conserva: cachés de CPU (compartidas, simplemente (frío) ✓. El área de guardado por proceso es exactamente esta lista.
Ejemplo resuelto 2 — una llamada al sistema en C.
int fd = open(path, O_RDONLY); read(fd, buf, 4096); —
cada llamada provoca una interrupción en el kernel, se ejecuta con privilegios de kernel y retorna ✓.
El mismo trío de Python: open, read — la interfaz es el
contrato, el lenguaje lo envuelve.
Errores comunes. Mezclar procesos (memoria propia) e hilos (comparten memoria). Creer que malloc accede a disco (memoria, no archivos). Leer un fallo de página como siempre un error o siempre una consulta de disco (muchos fallos válidos son recuperables, mientras que los accesos inválidos pueden fallar).
Resumen. Proceso = programa + estado; el cambio guarda/carga; virtual $\to$ físico mediante tablas de páginas; los fallos de página requieren manejo del SO; las llamadas al sistema son la frontera; open/read/write/fork/execve.
Ruta de compilación y ejecución
Por qué importa. El código fuente no es un programa: el flujo desde .c hasta
un proceso en ejecución tiene cuatro etapas, cada una con su propia clase de errores — y
la salida de cada etapa es inspeccionable.
La idea, con una imagen. Preprocesador (expande #include
y #define — solo texto) $\to$ compilador (C $\to$ ensamblador)
$\to$ ensamblador (ensamblador $\to$ código objeto, relocalizaciones
sin resolver) $\to$ enlazador (resolver símbolos entre objetos +
bibliotecas $\to$ ejecutables) ✓; el cargador lo inicia como un proceso (3.5).
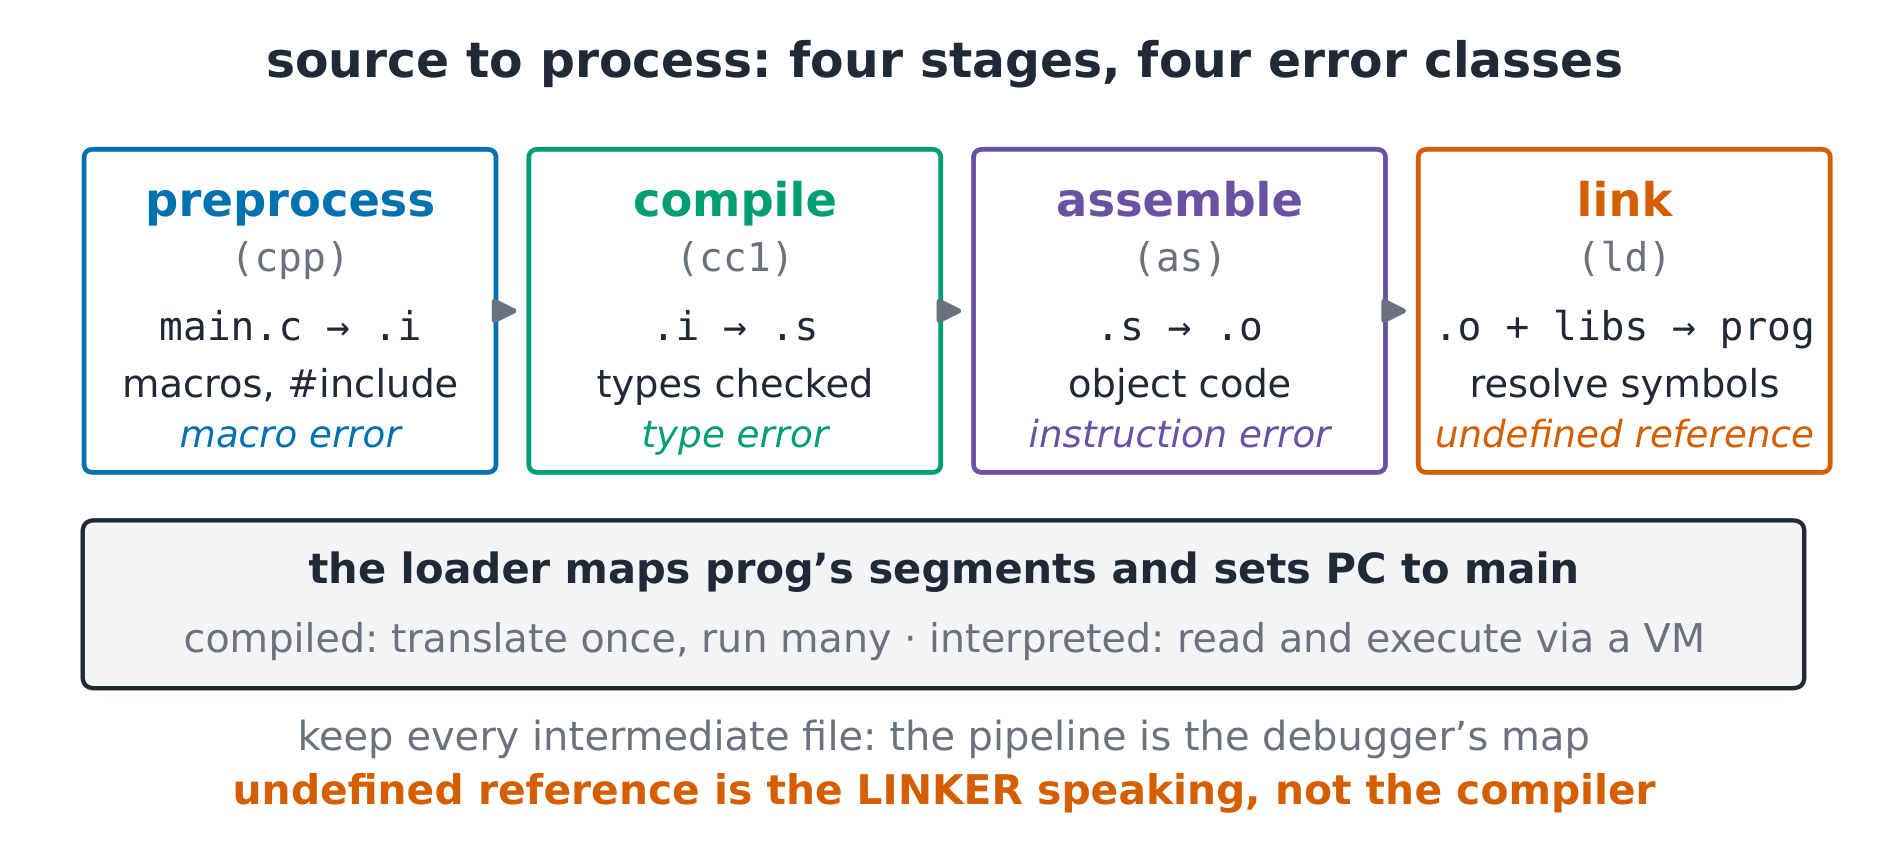
La derivación (por qué las etapas están separadas). Compilación separada: un programa de un millón de líneas recompila solo un archivo modificado; las bibliotecas se distribuyen como objetos/archivos .so; cada error se localiza en una etapa — errores de macro, errores de tipo, errores de instrucción, errores de símbolo ✓. El pipeline es una economía de ingeniería, no una formalidad.
Ejemplo resuelto 1 — los cuatro archivos. main.c $\to$ (cpp) main.i
$\to$ (cc1) main.s $\to$ (as) main.o $\to$ (ld) prog; el
extensiones nombran las etapas ✓. Cualquier archivo intermedio puede inspeccionarse con
el flag adecuado.
Ejemplo resuelto 2 — compilado vs interpretado. C: las cuatro etapas antes de ejecutar (binario rápido y específico de la máquina). Python: el código fuente se lee y se ejecuta por un intérprete (CPython compila a bytecode, la VM lo ejecuta) ✓. Compilar una vez-ejecutar muchas veces vs leer-ejecutar cada ejecución: el compromiso en una línea.
Errores comunes. Llamar a cada fallo un error de compilación (referencia no definida es del LINKER). Olvidar que los encabezados son texto (las macros no tienen tipo). Asumir que la optimización no puede cambiar resultados de punto flotante (reasociación tipo). Asumiendo que la optimización no puede cambiar los resultados de punto flotante (reasociación puede).
Resumen. cpp (texto) $\to$ cc (tipos) $\to$ as (instrucciones) $\to$ ld (símbolos); referencia no definida = enlazador; compilado vs interpretado es cuándo ocurre la traducción.