O que este curso é e como usá-lo
Este é o sexto curso de Ciência da Computação Universitária: arquitetura de computadores** — a máquina abaixo do programa: como um conjunto de instruções é especificado, como uma unidade de dado a executa, como um pipeline sobrepõe instruções e como memória e E/S mantêm o núcleo alimentado.
Limite de escopo, declarado uma vez: curso de estudo, não diploma; a máquina didática é um design original de carga e armazenamento de 16 registradores (R0 hardwired para zero), e cada afirmação de temporização neste material é calculada a partir dos parâmetros declarados e re-derivada pela suíte do curso.
- Unidades 6.1–6.2 são o contrato e a máquina que o honra.
- As unidades 6.3–6.4 tornam-no rápido: pipeline e hierarquia de memória.
- Unidades 6.5–6.6 conectam: entrada/saída e aceleração paralela.
O hábito do arquiteto: desempenho é aritmética, não adjetivos — todo ganho de velocidade neste curso é um número que pode ser recomputado.
Arquitetura de conjunto de instruções
Por que importa. A arquitetura de conjunto de instruções (ISA) é o contrato entre compilador e hardware: tudo o que o software pode depender, nada sobre como foi construído. Duas máquinas com uma ISA executam os mesmos binários.
A ideia, com uma imagem. Nossa ISA didática é RISC
no espírito: instruções fixas de 32 bits, arquitetura load-store
(apenas lw/sw acessam memória), 16 registradores com R0
sempre zero. Dois formatos cobrem o curso:
- Tipo-R R:
opcode(4) | rd(4) | rs(4) | rt(4) | shift(4) | funct(8)— ex.:add rd, rs, rt. - Tipo-I I:
opcode(4) | rt(4) | rs(4) | pad(4) | immediate(16)— ex.:lw rt, imm(rs); o campo de preenchimento não é usado, mantendo a palavra com 32 bits.
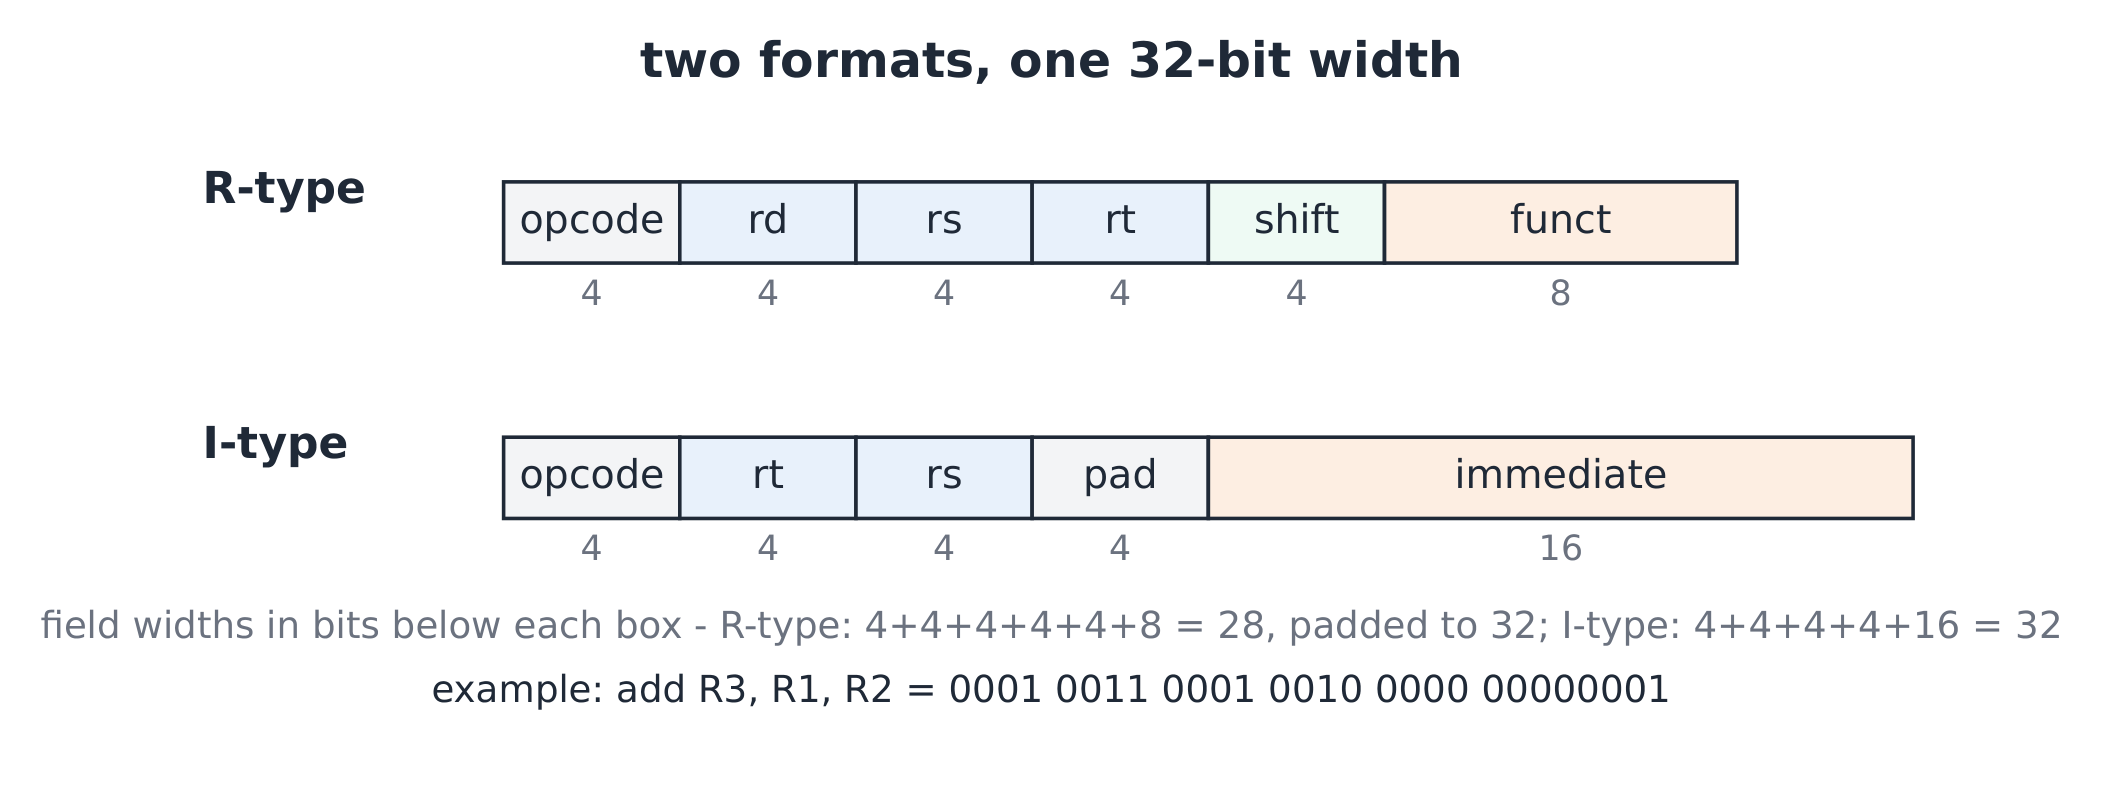
A derivação (o custo do imediato). Um imediato de 16 bits complemento a dois
alcança de $-2^{15}$ a $2^{15} - 1$, ou seja,
de $-32\,768$ a $32\,767$ — logo addi R2, R0, 40000 não pode codificar e
o ensamblador exige duas instruções (metade alta estilo lui, seguida
adição). Endereçamento de palavra: com memória endereçável por byte e
palavras de 32 bits, offsets de lw são múltiplos de $4$ — um offset de 16 bits
atinge $2^{16}$ bytes = $64$ KiB a partir do registro base.
Exemplo resolvido 1 — codificar e decodificar. Campos: opcode add = 1,
addi = 2, lw = 3, sw = 4, beq = 5. Codifique add R3, R1, R2:
opcode $0001$, rd $0011$, rs $0001$, rt $0010$, deslocamento $0000$, funct
$00000001$ — seis campos, 28 de 32 bits usados, os 4 bits superiores da
palavra final com preenchimento em zero. Decodifique
0010 0100 0001 0000 000001111111 (opcode 2, rt = 4, rs = 1, padding =
0, imediato $01111111_2 = 127$): addi R4, R1, 127.
Exemplo resolvido 2 — o que R0 compra. addi R0, R0, 0 é o
no-op canônico; add R5, R0, R0 zera R5 em um ciclo; comparar com
zero (beq R1, R0, loop) não precisa de operando constante. Um registro zero dedicado
remove uma classe inteira de instruções de movimento imediato — CISC
mantém MOV reg, 0; RISC mantém um fio.
Erros comuns. Ler um imediato de 16-bits como sem sinal (ramos
e aritmética de offset são com sinal). Esperar que add acesse memória
(carga/armazenamento: ele não pode). Assumir que o opcode sozinho seleciona a operação
(R-type também exige o campo funct).
Resumo. ISA = o contrato estável; formatos fixos de largura para R/I; imediatos assinados de 16-bits atingem $\pm 32$ K e 64 KiB de memória; R0 é um fio, não um registro que você escreve.
Caminho de dados e controle
Por que importa. A ISA são promessas; o caminho de dados é a tubulação que as mantém — e controle é a chave de configurações por instrução.
A ideia, com uma imagem. A máquina de ciclo único: o PC alimenta a memória de instruções (IM); arquivo de registradores (RF) lê duas fontes registradores; a ALU calcula; memória de dados (DM) lê ou grava; o resultado escreve de volta; PC + 4 ou um alvo de desvio carrega o PC. O controle define: RegWrite, MemRead, MemWrite, MemToReg, ALUSrc, Branch.

A derivação (tempo de ciclo = caminho mais lento). Todo o trabalho ocorre
dentro de um clock, então o clock deve esperar pela instrução mais longa:
leitura de memória + leitura de registrador + ALU + memória novamente + escrita de volta —
caminho do lw. Com nossos parâmetros (IM 200 ps, leitura do RF 100 ps, ALU 200
ps, DM 250 ps, fiação total de $150$ ps; escritas de registrador sobrepostas ao
bordo final do ciclo): o caminho do lw
$= 200 + 100 + 200 + 250 + 150 = 900$ ps, logo o ciclo é $900$ ps
e um programa de 100 instruções leva $90\,000$ ps. Acelerar add
não ajudaria — a máquina opera na velocidade do seu componente mais lento.
Exemplo resolvido 1 — sinais para uma carga. lw R4, 8(R1):
RegWrite = 1 (escrever R4), MemRead = 1, MemToReg = 1 (memória de dados para
registrador), ALUSrc = 1 (imediato para a soma de endereços), Branch = 0,
MemWrite = 0. Seis bits contam toda a história — o mesmo caminho de dados
executa cada instrução; apenas as configurações diferem.
Exemplo resolvido 2 — a exceção do store. sw R5, 12(R1): a
porta de escrita vai para a memória, não para o arquivo de registradores: RegWrite = 0,
MemWrite = 1, MemRead = 0, MemToReg = x (indiferente — nada escreve
de volta). Configurações indiferentes são liberdade do projetista: qualquer que seja o
bit, a instrução se comporta idênticamente.
Erros comuns. Esquecer PC + 4 acontece até em branches (o alvo é calculado a partir de PC + 4). Misturar polaridade de MemToReg entre desenhos. Acreditar que o controle é sequencial — é pura lógica combinacional sobre o opcode e funct.
Resumo. Um único caminho de dados compartilhado, bits de controle por instrução; o
tempo do ciclo é o caminho da instrução mais lenta; lw geralmente o define.
Pipeline
Por que importa. A máquina de ciclo único fica ociosa na maior parte de suas partes na maior parte do tempo. Pipelining sobrepõe instruções como uma linha de montagem — mais instruções concluídas por segundo, com custo de hardware quase o mesmo.
A ideia, com uma imagem. Cinco estágios: IF busca, ID decodificação/leitura de registrador, EX execução, MEM memória, WB escrita back. A instrução $i+1$ é buscada enquanto $i$ é decodificada: após o enchimento do pipeline, uma instrução é concluída por ciclo.

A derivação (fórmula de ganho de velocidade). $n$ instruções, $k$ estágios, tempo por estágio $t$; tempo sem pipeline $= n k t$; com pipeline $= (n + k - 1) t$ (fill $k - 1$, depois um por ciclo). Cinco instruções, cinco estágios: $25t$ torna-se $9t$; em $n = 100$: $500t$ torna-se $104t$ — o ganho de velocidade aproxima-se de $k$ à medida que $n$ aumenta, e o CPI ideal é $1$. Nosso tempo por estágio é definido pelo estágio mais lento: com IF 250, ID 150, EX 200, MEM 250, WB 100 ps, cada estágio custa $250$ ps — o pipeline opera a $250$ ps por instrução contra o único ciclo de $900$ ps.
Exemplo resolvido 1 — dependência RAW.
add R1, R2, R3     # R1 written in WB (cycle 6)
sub R4, R1, R1     # needs R1 in ID (cycle 5) — too early
O subtrai lê o arquivo de registradores um ciclo antes do adição escrevê-lo — uma
dependência read-after-write. O forwarding roteia a
saída da ALU do adição diretamente para as entradas da ALU do subtrai, ocultando
o espera completamente — exceto quando o produtor é um load: lw R1, …; add R3, R1, R2 ainda precisa fazer um ciclo de espera, pois os dados
existe apenas após MEM.
Exemplo resolvido 2 — CPI com estall. Um programa executa $1000$ instruções em um pipeline de 5 estágios com forwarding; $25\%$ são loads e metade dessas é seguida imediatamente por uso (par load-use), cada um custando um estall: estalls $= 1000 \times 0.25 \times 0.5 = 125$. Ciclos totais $= 1000 + 125 + 4 = 1129$; CPI $= 1129 / 1000 = 1.129$ — o custo de enchimento ($4$ ciclos) diminui conforme $n$ cresce.
Erros comuns. Somar contagens de estágios em vez de usar $n + k - 1$. Acreditar que o forwarding corrige load-use (um bubble permanece). Esquecer que branches alteram PC tarde — um branch tomado já buscou a instrução errada seguinte (nosso design: 1 bubble, resolvido em EX).
Resumo. $n + k - 1$ ciclos para $n$ instruções; CPI ideal 1; o forwarding elimina hazards ALU, load-use custa um estall, branch tomado custa um bubble; o speedup tende ao número de estágios.
Hierarquia de memória
Por que importa. O núcleo quer bytes em nanosegundos; memória barata responde em centenas. A hierarquia de memória empilha pequeno-rápido sobre grande-lento e permite que a localidade pague as contas.
A ideia, com uma figura. Um cache mapeado diretamente coloca cada bloco de memória em exatamente um slot: um endereço de 32 bits divide em etiqueta | índice | deslocamento. Nosso curso cache: $4$ KiB, linhas de $16$ bytes, $\Rightarrow 256$ linhas, $\Rightarrow$ deslocamento de $4$ bits, índice de $8$ bits, etiqueta de $32 - 12 = 20$ bits.

A dedução (AMAT). Tempo médio de acesso à memória $= t_{\text{hit}} + p_{\text{miss}} \times t_{\text{penalty}}$. Com acerto L1 em $1$ ciclo, taxa de erro $2\%$, penalidade de $100$ ciclos: AMAT de $= 1 + 0.02 \times 100 = 3$ ciclos — um atraso de $3\times$ em relação a uma taxa de erro de $2\%$, razão pela qual a hierarquia vive ou morre na localidade. Reduza a taxa de erro para $1\%$ e AMAT ⬇️ $= 2$: a sensibilidade é linear nos erros, não nos acertos.
Exemplo resolvido 1 — para onde vai um endereço? Endereço $0x000004A8$: os 12 bits mais baixos são $0100\,1010\,1000$ — deslocamento $1000_2 = 8$ (byte 8 da sua linha), índice $0100\,1010_2 = 74$ (linha 74 de 256), etiqueta = os 20 bits mais altos. Uma linha candidata por endereço: qualquer outro bloco mapeado para a linha 74 expulsa-o — a velocidade de mapeamento direto tem um comparador, seu preço são as falhas por conflito.
Exemplo resolvido 2 — localidade espacial e temporal. Varredura em escaneamento de um array de integers de $64 \times 64$ com linhas de 16 bytes ($4$ ints por linha): o primeiro acesso falha, os três seguintes têm sucesso — taxa de falhas $1/4 = 25\%$ mais apenas erros compulsórios; acesso com stride-16 (um int por linha, por coluna em uma matriz larga) falha em cada acesso — $100\%$. Mesmo array, mesmo cache, quatro vezes a AMAT: o layout é um recurso de desempenho.
Erros comuns. Calcular a largura do índice a partir do tamanho do cache sem dividir pelo tamanho da linha (conta linhas, não bytes). Esperar que um cache maior corrija um passo ruim (a largura de banda ainda transfere uma linha de cada vez). Confundir taxa de falhas com razão de falhas (dependendo se a formulação é por acesso ou por instrução, variando conforme o número de acessos).
Resumo. Dividir o endereço pela geometria (tag | índice | deslocamento); AMAT $= 1 + m \times p$; mapeamento direto troca conflitos por velocidade; localidade — reutilização e adjacência — é a moeda.
Entrada/saída
Por que importa. Uma máquina que não pode comunicar é apenas um aquecedor. E/S é onde microssegundos encontram milissegundos, e os três estilos de transferência trocam atenção da CPU por vazão. A ideia, com uma imagem. E/S programada I/O
(polling): o núcleo verifica continuamente um registro de status. **Impulsionado por interrupções (polling): o núcleo gira em um registro de status. **Interrupções E/S: o dispositivo sinaliza, o núcleo salva estado e executa um manipulador. DMA: um motor DMA transfere o bloco e interrompe apenas uma vez no final.

A dedução (o custo do polling). Um flag de dispositivo atualiza a cada $2$ µs; uma leitura custa $50$ ciclos a $250$ ps por ciclo $= 12.5$ ns. Latência de pior caso exige polling contínuo: $2\,\mathrm{µs} / 12.5\,\mathrm{ns} = 160$ leituras por evento, todas exceto uma desperdiçadas — o núcleo gasta $160 \times 50 = 8\,000$ ciclos por palavra de atenção. Interrupções reduzem isso ao custo do manipulador: $200$ ciclos de salvamento, leitura, restauração por palavra. O DMA move $1024$ palavras com uma configuração de $500$-ciclo mais uma interrupção de conclusão de $200$-ciclo: $0.68$ ciclos por palavra contra $200$ — três ordens de magnitude de atenção da CPU economizada.
Exemplo resolvido 1 — escolha o estilo. Um teclado (um humano digita $\approx 5$ caracteres por segundo): o polling nessa taxa desperdiça o núcleo inteiro; interrupções encaixam — um evento por tecla pressionada, $200$ ciclos cada, desprezível. Um bloco de disco de $4$ MiB a $2$ GB/s: mesmo interrupção por palavra sobrecarrega o núcleo; o DMA assume o controle. Um sensor amostrado exatamente a cada $2$ µs: o polling em loop apertado é honesto e simples — a taxa de amostragem é a taxa de consulta.
Exemplo resolvido 2 — o custo das interrupções. Cada interrupção custa $200$ ciclos de sobrecarga (salvamento de estado, vetor, restauração). Receber $1024$ palavras com uma interrupção por palavra: $204\,800$ ciclos de pura sobrecarga; o mesmo bloco via DMA: $700$ ciclos no total — os dados são movidos de forma idêntica, mas o custo da CPU difere em $292\times$. O loteamento não é uma otimização; é a diferença entre arquiteturas.
Erros comuns. Consultar dentro de um manipulador de interrupção (invertendo os dois estilos). Esquecer que o DMA ainda exige cuidado com coerência de cache (o motor DMA e o núcleo veem a memória). Confundir latência de interrupção (tempo para iniciar o manipulador) com throughput (palavras por segundo).
Resumo. Consulta: simples, hostil ao núcleo. Intercupções: custeadas por evento, sobrecarga do manipulador por palavra. DMA: custeado por bloco, uma interrupção por bloco — e a atenção da CPU por palavra cai em ordens de grandeza.
Paralelismo e desempenho
Por que importa. Os clocks pararam de ficar mais rápidos; a máquina tornou-se mais larga e com mais núcleos em vez disso. Ler sobre ganho de velocidade agora significa ler Amdahl.
A ideia, com uma imagem. Um programa tem uma fração serial e um fração paralelizável $f$. Em $p$ processadores: $\text{Speedup} = \dfrac{1}{(1 - f) + f / p}$ — a parte serial nunca diminui.

A dedução (o teto). À medida que $p \to \infty$, aceleração $\to 1 / (1 - f)$ — the serial fraction alone. With $f = 0.9$: ilimitado hardware compra no máximo $10\times$; em $p = 8$: $1 / (0.1 + 0.1125) = 4.71×$; at $p = 16$: $1 / (0.1 + 0.0563) = 6.40×$ — o segundo conjunto de oito processadores adiciona $1.7\times$ onde os primeiros oito adicionaram $4.7\times$. Com $f = 0.99$, o teto é $100\times$, mas alcançar $50\times$ exige $p = 99$: exatamente $1/(0.01 + 0.99/99) = 50.0$. Rendimentos decrescentes são estruturais, não incidentais.
Exemplo resolvido 1 — avalie um ganho de velocidade. Uma renderização gasta $36$ s compositando (serial) e $64$ s sombreado (paralelo) em um núcleo: $f = 64/100 = 0.64$. On $p = 4$: speedup $= 1/(0.36 + 0.16) = 1.92\times$; tempo de execução $= 100 \times 0.52 = 52.0$ s. Dobrar os núcleos para $8$: $1/(0.36 + 0.08) = 2.27\times$, $44.0$ s — a cauda de composição agora domina. A próxima aquisição é um algoritmo, não uma máquina.
Exemplo resolvido 2 — paralelismo ao nível de instrução. Antes dos núcleos, a própria pipeline é paralelismo: a máquina de 5 estágios sobrepõe cinco instruções (ILP). Adicionar threads de hardware (SMT) permite que um núcleo preencha buracos de pipeline com outra thread de instruções — a matemática de perigo de 6.3 ainda se aplica por thread. O pilha: ILP dentro de um núcleo, threads por núcleo, núcleos por chip — três níveis, uma disciplina de Amdahl.
Erros comuns. Reportar ganho de velocidade máximo em vez de medido (ganho nominal $p$ assume $f = 1$). Tratar uma fração serial de $10\%$ como inofensiva — ela limita toda máquina que você comprará a $10\times$. Comparar ganhos entre diferentes bases (o tempo de um único núcleo deve ser o mesmo programa, mesma máquina, um núcleo ativo).
Resumo. Ganho de velocidade $= 1/((1-f) + f/p)$, teto $1/(1-f)$; fração serial domina em escala; ILP, threads e núcleos são uma escada — e a escada apoia-se em Amdahl.